K8s HPA 是依 CPU 用量自動增減 Pod 的機制;搭配 Probe 判斷 Pod 能不能接客、資源限制決定用量怎麼算。
前幾篇的 Deployment 會「維持固定幾個 Pod」,但兩個問題還沒解決:Pod 在跑不代表程式正常(可能卡死、可能還在開機),以及流量忽大忽小,固定幾個不是太多就是太少。這篇在 Cloud Shell 實際做三件事:
- 用 Probe(健康檢查) 讓 Kubernetes 自己發現「還沒準備好」和「已經壞掉」的容器
- 設定 資源要求與上限(
200m、500m這種單位到底是多少) - 開 HPA(水平自動擴展),用壓力測試讓它真的從 1 個 Pod 擴到 7 個,停止壓力後再看它約 5 分鐘縮回 1 個
這是「容器系列」的第 17 篇。全部在 Cloud Shell 實際跑過,輸出都是真實結果(2026 年 11 月實測,Minikube v1.38.1、Kubernetes v1.35.1)。
為什麼你需要知道
- 程式卡死,Kubernetes 不會自己發現:程式沒結束、只是不回應,Pod 的狀態還是 Running。沒有 livenessProbe,它就一直卡著
- 剛啟動就收流量會出錯:程式要先連資料庫、載入設定,這段時間收到請求會回錯誤。readinessProbe 讓它準備好才接客
- 流量高峰要能自動加人手:活動、促銷、上新聞時流量可能翻好幾倍,靠人半夜手動擴容來不及
- 在雲端,資源設定就是帳單:GKE Autopilot 照 Pod 要求的資源計費(2026 年 11 月查 GKE 定價頁),
requests寫多少就付多少 - 面試和證照常考:「liveness 和 readiness 差在哪」「HPA 怎麼算」是經典題;CKAD 會考 Probe 的寫法
Probe 是什麼
Probe(探針、健康檢查)是 kubelet 定期對容器做的檢查,可以是打一個 HTTP 網址、連一個 Port,或在容器裡執行一個指令,用結果判斷容器的狀態(Kubernetes 官方說明:Liveness、Readiness、Startup Probes)。
- 比喻:餐廳店長巡場:先看新來的廚師「準備好了沒」(readiness),還沒好就先不派單;再看在線上的廚師「是不是累倒了」(liveness),倒了就請他回去休息、換人上場
- 來龍去脈:probe 是「探測」。第 9 篇講過 kubelet 是節點上的組長,Probe 就是它巡查用的工具
- 為什麼要學:Pod 的
READY欄、RESTARTS欄會變,很多時候就是 Probe 造成的;第 18 篇排錯一定會遇到
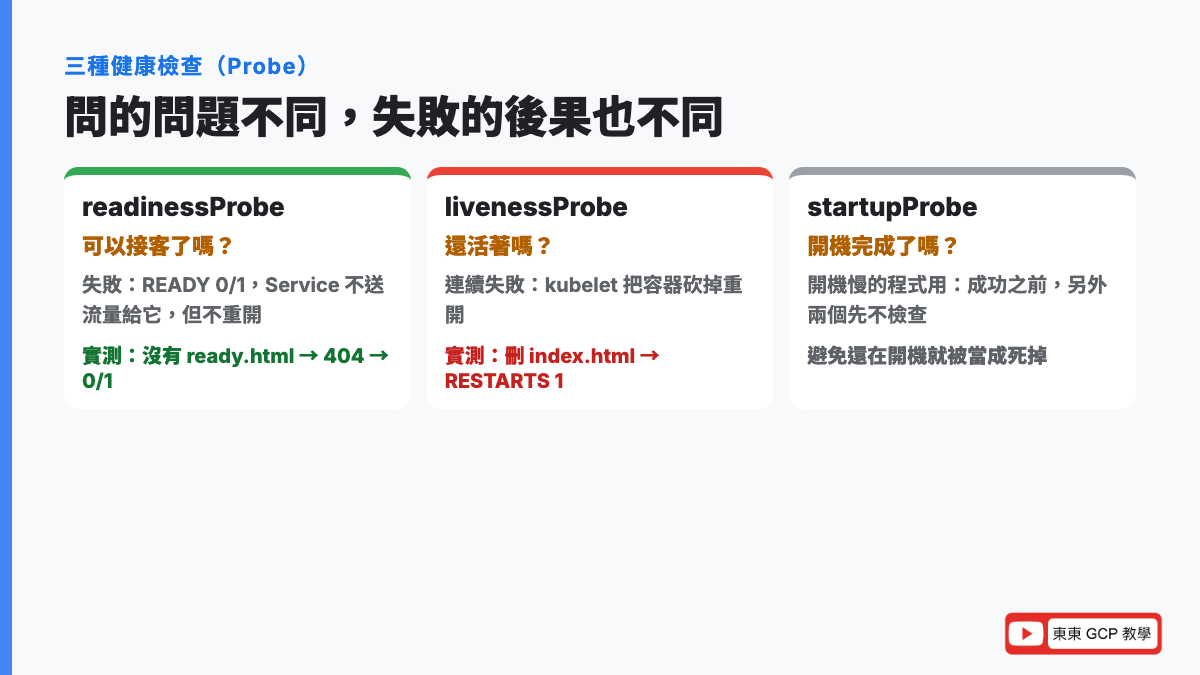
| Probe | 問什麼 | 失敗會怎樣 |
|---|---|---|
readinessProbe | 可以接客了嗎? | READY 變 0/1,Service 不把流量送給它,不會重開 |
livenessProbe | 還活著嗎? | 連續失敗達到門檻,kubelet 把容器砍掉重開,RESTARTS 加 1 |
startupProbe | 開機完成了嗎? | 成功之前另外兩種先不檢查,避免開機慢的程式被誤殺 |
常用的設定:periodSeconds(幾秒檢查一次,預設 10)、failureThreshold(連續失敗幾次才算失敗,預設 3)。算一次:這篇的 livenessProbe 設每 5 秒檢查、連續 3 次失敗才重開,所以壞掉之後大約 5 × 3=15 秒會被重開。
資源要求(requests)與上限(limits)
requests 是「這個容器至少需要多少資源」,limits 是「最多只能用多少」。
- 比喻:requests 是訂位時說「我們 4 個人」,餐廳照這個數字安排桌子;limits 是「最多只能坐 6 個人」,再多就不讓進
- 來龍去脈:排程器(第 9 篇)就是看
requests決定 Pod 放哪個節點;CPU 超過limits會被降速,記憶體超過limits容器會被強制關掉(OOMKilled,第 18 篇會遇到) - 為什麼要學:沒寫 requests,排程器不知道 Pod 要多少,可能把太多 Pod 擠在同一台;HPA 的「CPU 使用率」也是用 requests 當分母
CPU 和記憶體的單位
| 寫法 | 意思 | 例子 |
|---|---|---|
1 或 1000m | 1 顆 CPU | m 是 milli(千分之一) |
500m | 0.5 顆 CPU | 半顆 |
200m | 0.2 顆 CPU | 這篇 php-apache 的 requests |
256Mi | 256 × 1024 × 1024=268,435,456 位元組 | Mi 是 2 的次方 |
256M | 256,000,000 位元組 | 比 256Mi 少約 4.6% |
算一次 CPU 使用率:php-apache 的 requests 是 200m、limits 是 500m。它用到 500m 時,使用率是 500 ÷ 200=250%;而且因為上限是 500m,單一個 Pod 最多就是 250%。實作看到的 250% 就是這樣來的。
HPA 是什麼
HPA(Horizontal Pod Autoscaler,水平 Pod 自動擴展)是依照 CPU、記憶體這類指標,自動調整 Deployment 的 Pod 數量(Kubernetes 官方說明:Horizontal Pod Autoscaling)。
- 比喻:餐廳的排班系統看現場排隊人數:人多就多叫幾位廚師上班,人少就讓幾位先下班
- 來龍去脈:horizontal(水平)是「加台數」;相對的 vertical(垂直)是「每台加大」,叫 VPA。HPA 是控制平面裡的一個控制器(第 9 篇的 controller-manager),預設每 15 秒看一次指標
- 為什麼要學:自動擴展是上雲最大的好處之一;但設定不好,不是來不及擴、就是多付錢
HPA 要有指標才能動。 指標由 metrics-server 收集,它每隔一段時間問每個節點的 kubelet「各容器用了多少 CPU 和記憶體」。Minikube 預設沒裝,要開外掛;kubectl top 也是靠它。
HPA 的公式
期望 Pod 數 = 無條件進位(目前 Pod 數 × 目前 CPU 使用率 ÷ 目標 CPU 使用率)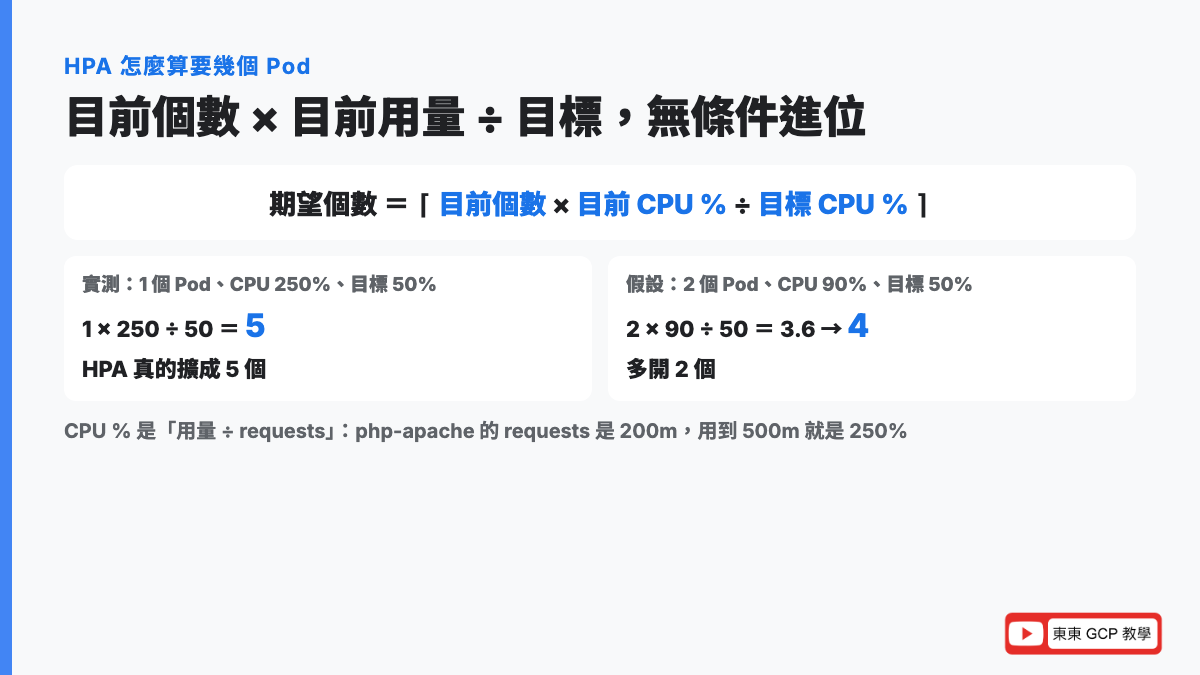
帶實測數字算一次:1 個 Pod、CPU 250%、目標 50% → 1 × 250 ÷ 50=5,HPA 真的擴成 5 個。
再算一個假設的:2 個 Pod、CPU 90%、目標 50% → 2 × 90 ÷ 50=3.6,進位成 4。
數字變大變小代表什麼:目前使用率比目標高,算出來就會比現在多(擴);比目標低就會變少(縮)。官方另外有 10% 的容許範圍:算出來的比例在 0.9~1.1 之間就不動,避免一直跳來跳去。
動手做:Probe、資源、HPA 各做一次
這段在 Cloud Shell(不用設專案) 做,不會花錢,大約 30 分鐘(等擴展和縮回要比較久)。怎麼打開 Cloud Shell 請看第 1 篇的步驟,跳出「授權 Cloud Shell」按「拒絕」就好。截圖裡的提示字元有縮短,你的畫面會是「你的帳號@cloudshell:~$」。
步驟 1:開叢集,打開 metrics-server
mkdir -p ~/k8s-hpa && cd ~/k8s-hpa; minikube start --cni=kindnet | tail -1; minikube addons enable metrics-server | tail -1(前面省略:版本提醒和硬碟空間警告)
🏄 Done! kubectl is now configured to use "minikube" cluster and "default" namespace by default
🌟 The 'metrics-server' addon is enabled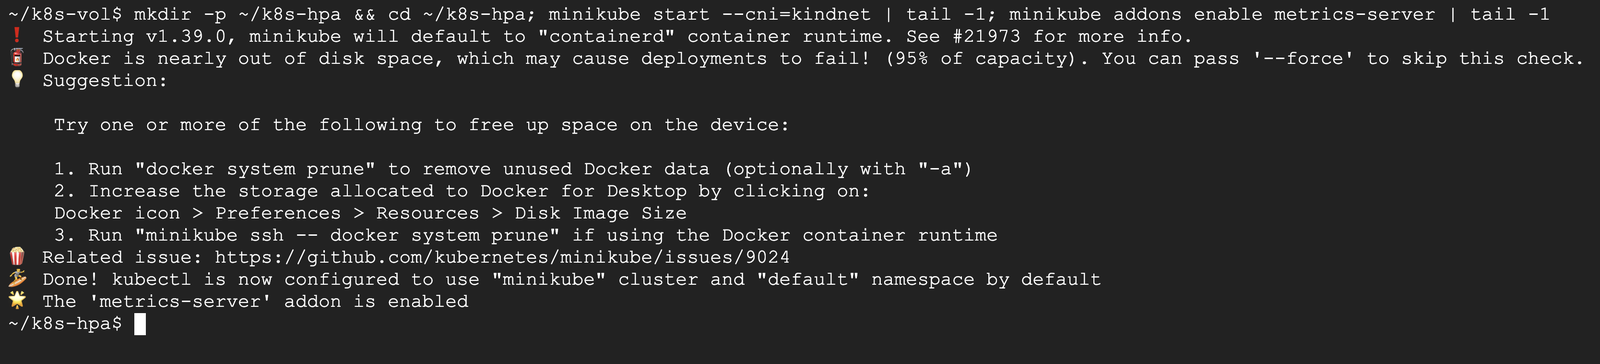
--cni=kindnet 一定要加,等一下壓力測試的 Pod 要透過 Service 連 php-apache,預設網路設定在 Cloud Shell 會不通(第 13 篇的「實測時的意外」)。
步驟 2:readinessProbe,還沒準備好就不接客
這個 nginx 的 readinessProbe 檢查 /ready.html,但這個檔案一開始不存在:
cat > probe.yaml <<'EOF'
apiVersion: apps/v1
kind: Deployment
metadata:
  name: probe-demo
spec:
  replicas: 1
  selector:
    matchLabels:
      app: probe-demo
  template:
    metadata:
      labels:
        app: probe-demo
    spec:
      containers:
      - name: nginx
        image: nginx:1.31
        readinessProbe:
          httpGet:
            path: /ready.html
            port: 80
          periodSeconds: 5
        livenessProbe:
          httpGet:
            path: /index.html
            port: 80
          periodSeconds: 5
          failureThreshold: 3
EOF
kubectl apply -f probe.yaml; sleep 15; kubectl get pods -l app=probe-demo; kubectl get events --field-selector reason=Unhealthy -o custom-columns=MESSAGE:.message | tail -2
deployment.apps/probe-demo created
NAME READY STATUS RESTARTS AGE
probe-demo-9d4f64f8c-wkbm2 0/1 Running 0 15s
Readiness probe failed: HTTP probe failed with statuscode: 404
Liveness probe failed: HTTP probe failed with statuscode: 404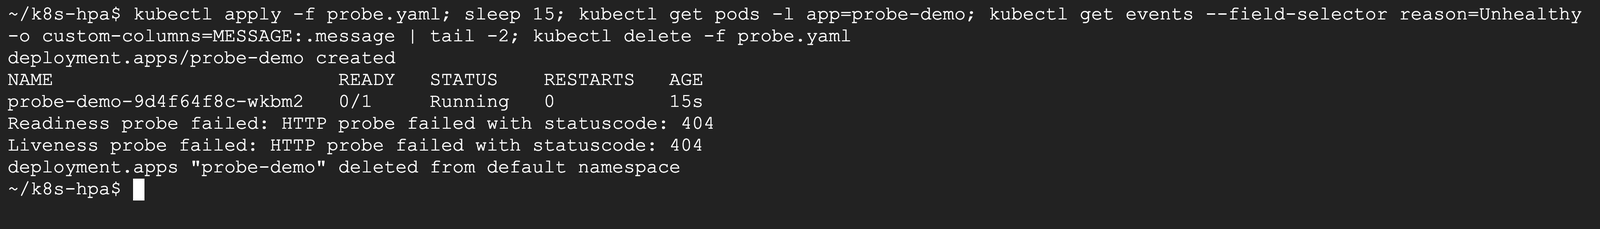
httpGet: path: /ready.html, port: 80:用 HTTP 打這個網址,回 200~399 算成功STATUS Running、READY 0/1:容器在跑,但還沒通過 readinessProbe- 事件寫
Readiness probe failed: ... statuscode: 404:/ready.html不存在,回 404
第二行 Liveness probe failed 是同一個實驗前一次跑時、步驟 4 那個舊 Pod 留下的紀錄(這張截圖是重拍的,事件會保留一陣子),跟這個新 Pod 無關。
步驟 3:補上檔案,變成 Ready
P=$(kubectl get pods -l app=probe-demo -o name); kubectl exec $P -- sh -c 'echo ok > /usr/share/nginx/html/ready.html'; sleep 10; kubectl get pods -l app=probe-demoNAME READY STATUS RESTARTS AGE
probe-demo-9d4f64f8c-wvm57 1/1 Running 0 38s
建了 ready.html,下一次檢查就成功,READY 1/1,這時 Service 才會把流量送進來。真實的程式會提供一個 /healthz 或 /ready 之類的網址,等資料庫連好、設定載入完才回 200。
(步驟 3、4 是第一次跑時拍的,所以 Pod 名字是 wvm57,跟步驟 2 重拍的 wkbm2 不同。)
步驟 4:livenessProbe,壞掉就重開
把 livenessProbe 檢查的 index.html 刪掉,模擬「程式壞了」:
kubectl exec $P -- rm /usr/share/nginx/html/index.html; sleep 30; kubectl get pods -l app=probe-demo; kubectl get events --field-selector reason=Killing -o custom-columns=MESSAGE:.message | tail -1NAME READY STATUS RESTARTS AGE
probe-demo-9d4f64f8c-wvm57 0/1 Running 1 (18s ago) 73s
Container nginx failed liveness probe, will be restarted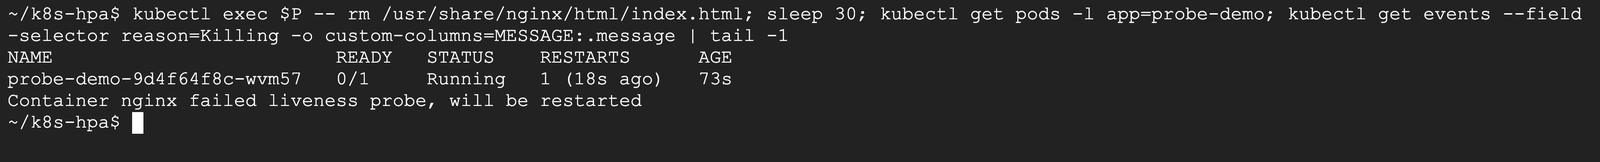
- 事件
Container nginx failed liveness probe, will be restarted:kubelet 判定它死了,砍掉重開 RESTARTS 1 (18s ago):刪檔後 30 秒內就重開了一次,跟前面算的「約 15 秒」對得上- 注意
READY又變回0/1,原因在下一步
步驟 5:重開後,自己建的檔案不見了
kubectl exec $P -- ls /usr/share/nginx/html; kubectl delete -f probe.yaml50x.html
index.html
deployment.apps "probe-demo" deleted from default namespace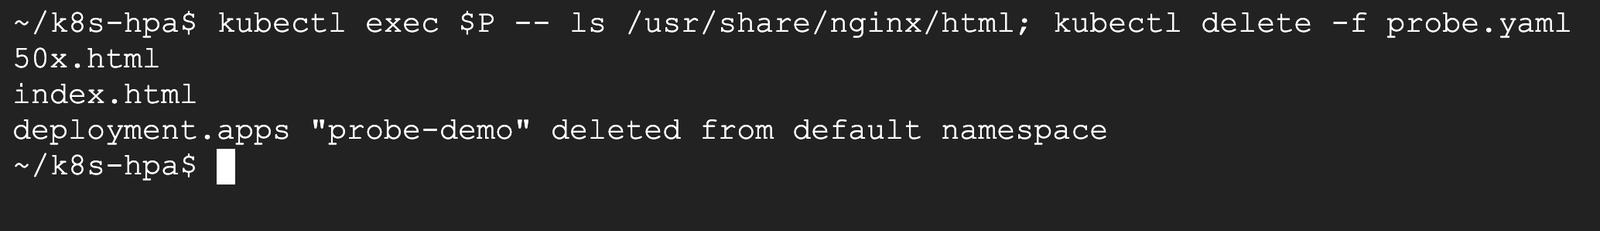
重開的容器是從映像檔重新開始:index.html 回來了(映像檔裡就有),但步驟 3 手動建的 ready.html 不見了,所以 readiness 又失敗。這跟第 16 篇講的一樣:容器裡沒存到 Volume 的檔案,重開就沒了。
步驟 6:部署官方的 HPA 範例程式
Kubernetes 官方教學有一個 php-apache 範例,每次被連都會做一點計算,很適合用來吃 CPU:
kubectl apply -f https://k8s.io/examples/application/php-apache.yaml; kubectl rollout status deployment php-apache; kubectl get deployment php-apache -o jsonpath='{.spec.template.spec.containers[0].resources}{"\n"}'deployment.apps/php-apache created
service/php-apache created
Waiting for deployment "php-apache" rollout to finish: 0 of 1 updated replicas are available...
deployment "php-apache" successfully rolled out
{"limits":{"cpu":"500m"},"requests":{"cpu":"200m"}}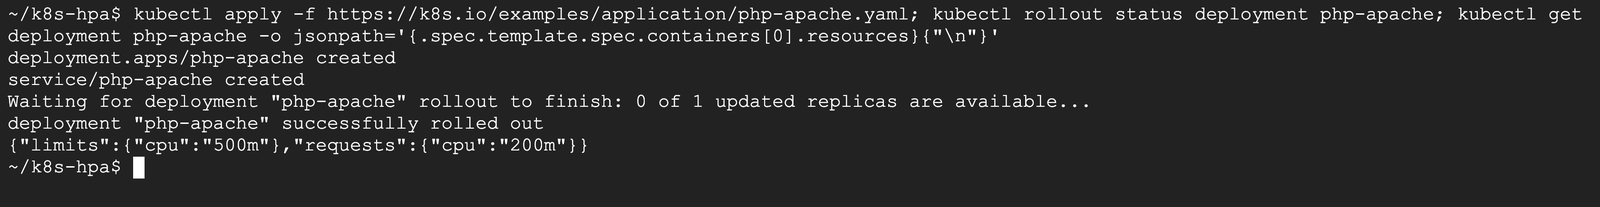
這份官方 YAML 建了一個 Deployment 和一個同名的 Service,資源設定是 requests: 200m、limits: 500m(官方 HPA 實作教學)。
步驟 7:kubectl top 看用量
kubectl top nodes; kubectl top podsNAME CPU(cores) CPU(%) MEMORY(bytes) MEMORY(%)
minikube 375m 18% 731Mi 9%
error: metrics not available yet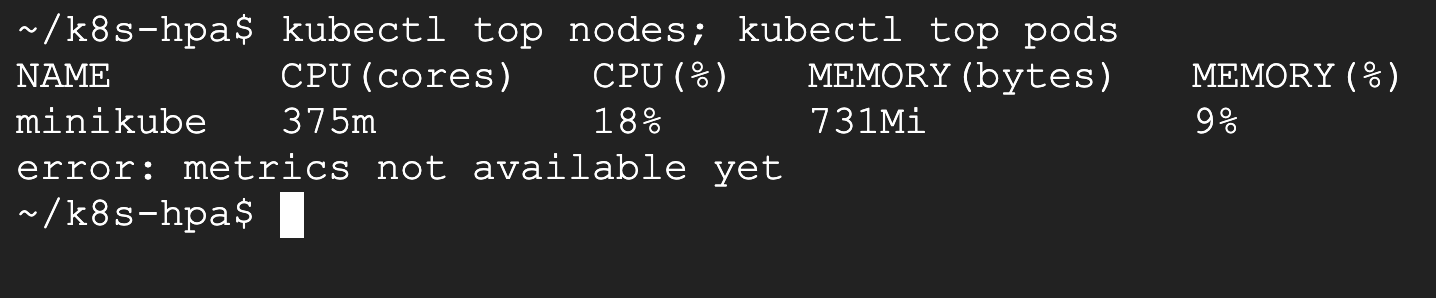
節點的數字已經有了:用了 375m(0.375 顆 CPU)、731Mi 記憶體。但 Pod 的數字還是 metrics not available yet:metrics-server 要收集一段時間才有 Pod 的數字,剛建好的 Pod 等一下就會有。
步驟 8:開 HPA
kubectl autoscale deployment php-apache --cpu-percent=50 --min=1 --max=10; sleep 30; kubectl get hpaFlag --cpu-percent has been deprecated, Use --cpu with percentage or resource quantity format (e.g., '70%' for utilization or '500m' for milliCPU).
horizontalpodautoscaler.autoscaling/php-apache autoscaled
NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGE
php-apache Deployment/php-apache cpu: <unknown>/50% 1 10 1 30s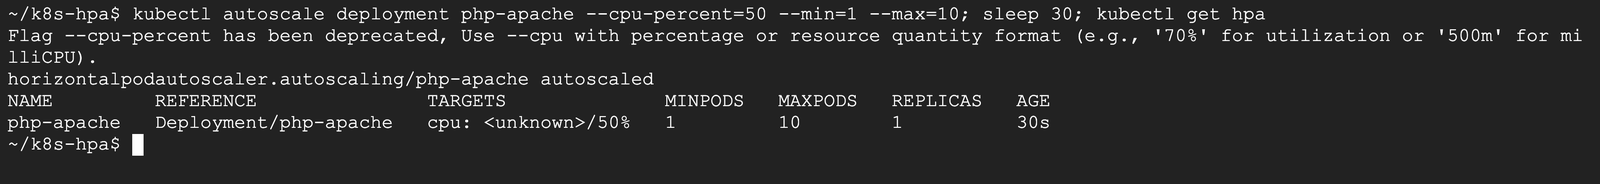
--cpu-percent=50:目標 CPU 使用率 50%(以 requests 200m 計算,也就是平均每個 Pod 用 100m)--min=1 --max=10:最少 1 個、最多 10 個Flag --cpu-percent has been deprecated:這個參數已經棄用,新寫法是--cpu=50%。網路上的教學幾乎都還用舊的TARGETS cpu: <unknown>/50%:指標還沒到,HPA 先不動
步驟 9:加壓,看 HPA 擴展
開一個 busybox Pod 不停地連 php-apache(每 0.01 秒一次),然後每 30 秒印一次 HPA 狀態:
kubectl run load-generator --image=busybox:1.37 --restart=Never -- /bin/sh -c 'while sleep 0.01; do wget -q -O- http://php-apache; done'; for i in 1 2 3 4 5 6 7; do sleep 30; echo "$(date +%T) $(kubectl get hpa php-apache --no-headers)"; donepod/load-generator created
16:19:15 php-apache Deployment/php-apache cpu: 37%/50% 1 10 1 66s
16:19:45 php-apache Deployment/php-apache cpu: 37%/50% 1 10 1 96s
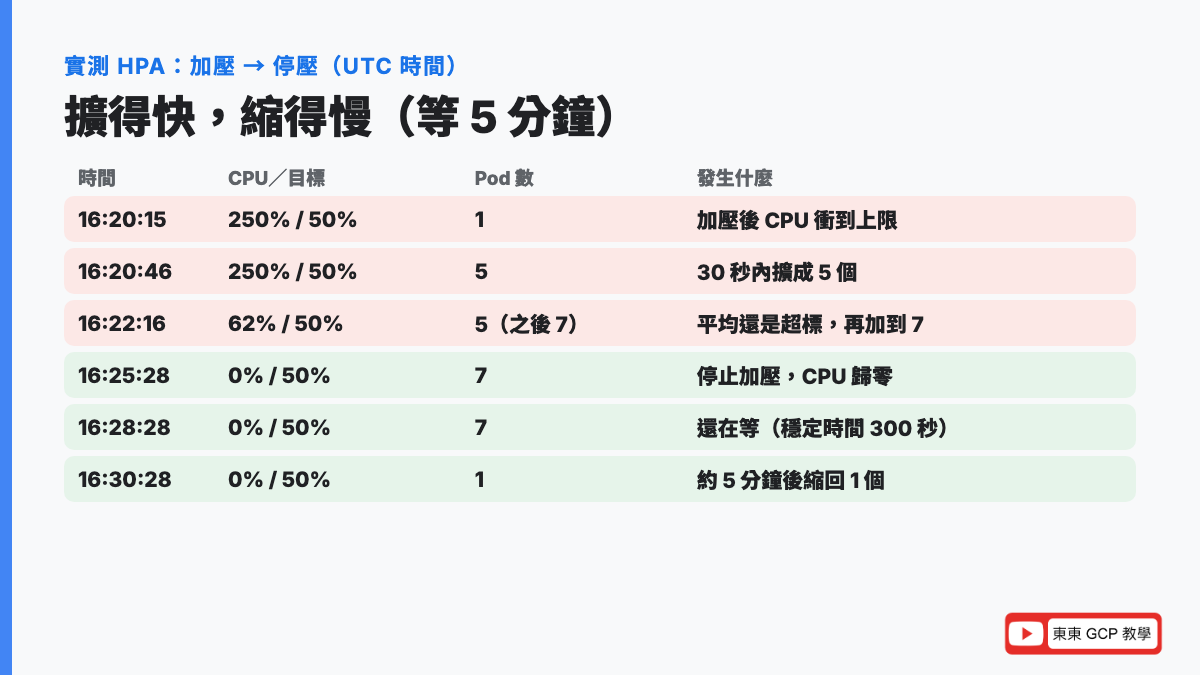
16:20:15 php-apache Deployment/php-apache cpu: 250%/50% 1 10 1 2m7s
16:20:46 php-apache Deployment/php-apache cpu: 250%/50% 1 10 5 2m37s
16:21:16 php-apache Deployment/php-apache cpu: 106%/50% 1 10 5 3m7s
16:21:46 php-apache Deployment/php-apache cpu: 106%/50% 1 10 5 3m37s
16:22:16 php-apache Deployment/php-apache cpu: 62%/50% 1 10 5 4m7s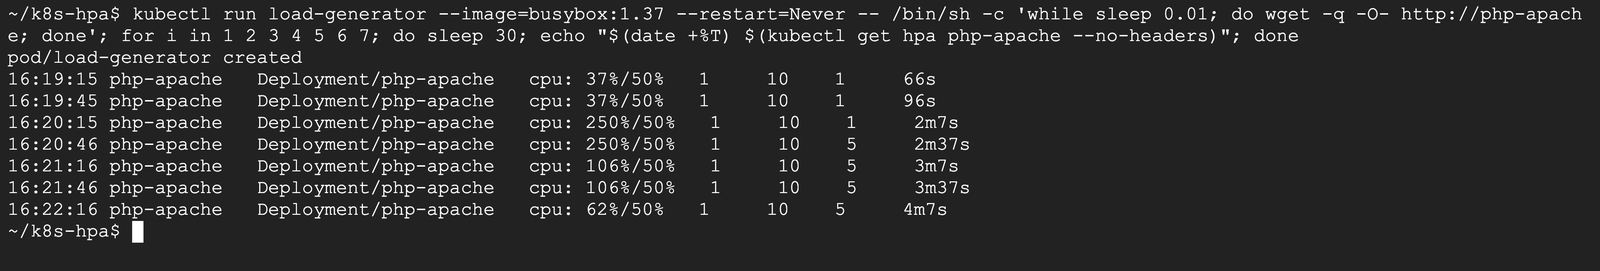
一行一行看(時間是 UTC,台灣要加 8 小時):
- 16:19:15 的 37%:指標還在跟上,加壓才剛開始
- 16:20:15,CPU 衝到 250%:1 個 Pod 已經用到上限 500m
- 16:20:46,擴成 5 個:1 × 250 ÷ 50=5,跟公式一樣
- 16:21:16 平均降到 106%:5 個 Pod 分攤,但新的 Pod 還在熱身
- 16:22:16 降到 62%:還是高於 50%,HPA 會再加
步驟 10:看每個 Pod 的用量和擴展紀錄
kubectl top pods; kubectl get events --field-selector involvedObject.kind=HorizontalPodAutoscaler -o custom-columns=MESSAGE:.message | tail -3NAME CPU(cores) MEMORY(bytes)
load-generator 25m 0Mi
php-apache-7ff755b4cb-5vdjk 127m 11Mi
php-apache-7ff755b4cb-7htcr 120m 11Mi
php-apache-7ff755b4cb-97cjw 118m 11Mi
php-apache-7ff755b4cb-qr5fd 132m 11Mi
php-apache-7ff755b4cb-xx6kj 124m 11Mi
New size: 4; reason: cpu resource utilization (percentage of request) above target
New size: 5; reason: cpu resource utilization (percentage of request) above target
New size: 7; reason: cpu resource utilization (percentage of request) above target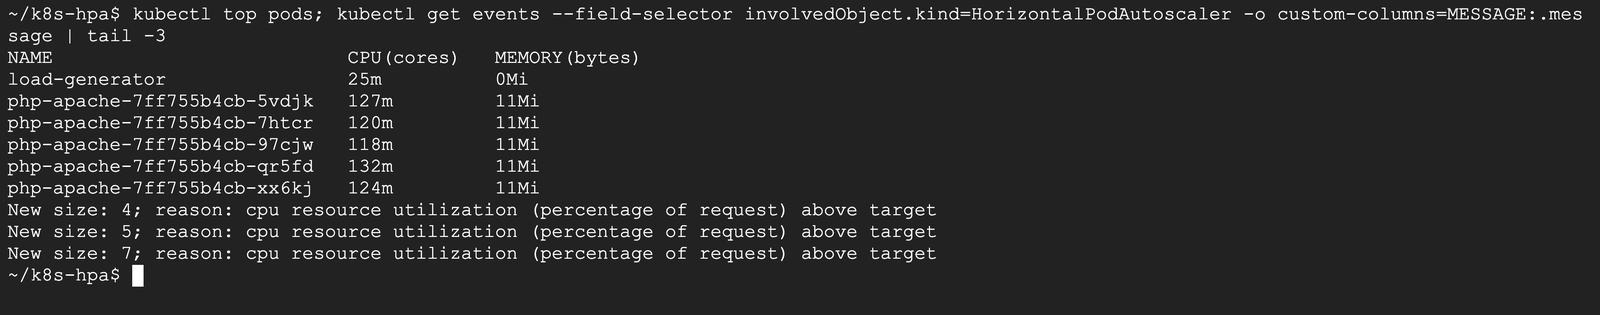
- 5 個 php-apache 各用 118m~132m,平均約 124m,除以 requests 200m ≈ 62%,跟 HPA 顯示的一樣
- 事件記錄了每次調整:4 → 5 → 7,原因都是
cpu resource utilization (percentage of request) above target(CPU 使用率,以 requests 計,超過目標)
算一次 7 怎麼來的:5 個、62%、目標 50% → 5 × 62 ÷ 50=6.2,進位成 7。
事件裡還有一個 4,表示 HPA 在兩次取樣之間先擴到 4、再到 5。新開的 Pod 還沒有指標時,HPA 會保守估計,所以不一定一步到位。
步驟 11:停止加壓,看多久縮回
刪掉壓力測試的 Pod,每分鐘看一次:
kubectl delete pod load-generator; for i in 1 2 3 4 5 6 7; do sleep 60; echo "$(date +%T) $(kubectl get hpa php-apache --no-headers)"; donepod "load-generator" deleted from default namespace
16:24:28 php-apache Deployment/php-apache cpu: 30%/50% 1 10 7 6m19s
16:25:28 php-apache Deployment/php-apache cpu: 0%/50% 1 10 7 7m19s
16:26:28 php-apache Deployment/php-apache cpu: 0%/50% 1 10 7 8m19s
16:27:28 php-apache Deployment/php-apache cpu: 0%/50% 1 10 7 9m19s
16:28:28 php-apache Deployment/php-apache cpu: 0%/50% 1 10 7 10m
16:29:28 php-apache Deployment/php-apache cpu: 0%/50% 1 10 3 11m
16:30:28 php-apache Deployment/php-apache cpu: 0%/50% 1 10 1 12m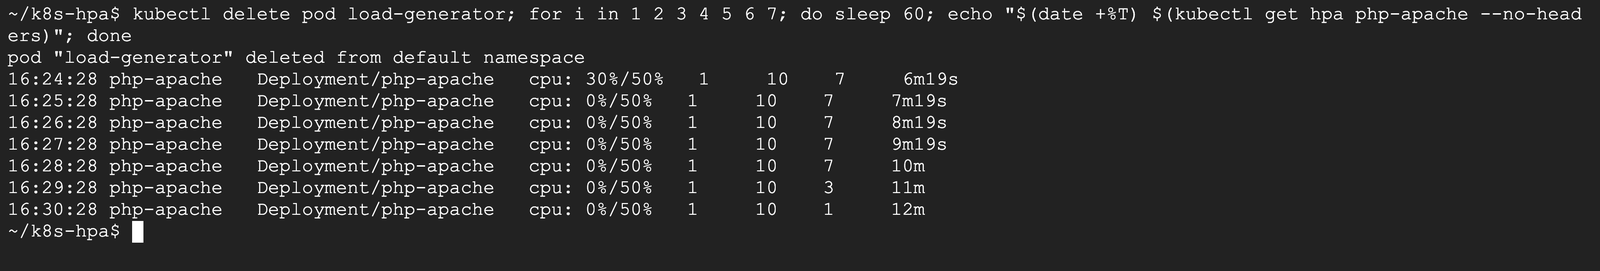
CPU 在 16:25:28 就降到 0%,但 Pod 一直維持 7 個,直到 16:29:28 才縮成 3、16:30:28 回到 1,大約等了 5 分鐘。
這是故意的:HPA 縮減時有一個穩定時間(stabilization window),預設 300 秒,會看過去 5 分鐘裡算出來的最大值,避免流量一下高一下低時 Pod 被反覆加減(官方文件,2026 年 11 月查)。擴展則沒有這個等待,所以是擴得快、縮得慢。
實測時的意外
1. 第一次拍 readiness 失敗,拍到的是 ContainerCreating
第一次跑時,kubectl apply 後等 20 秒,Pod 還在 ContainerCreating(新叢集要先下載 nginx 映像檔),根本還沒開始做 Probe。READY 0/1 的原因有很多種,要看 STATUS 和事件才知道是哪一種。步驟 2 是映像檔下載好之後重拍的。
2. livenessProbe 重開,readiness 跟著失敗
步驟 4 的容器被重開後,手動建的 ready.html 不見了,readiness 又失敗。正式環境的健康檢查網址要由程式本身提供,不要依賴手動建的檔案;而且 liveness 和 readiness 最好檢查不同的東西:liveness 只檢查「程式還有沒有反應」,readiness 才檢查「資料庫連好了沒」這類相依服務。不然資料庫一斷,所有 Pod 都會被當成死掉一直重開。
3. –cpu-percent 已經棄用
kubectl autoscale --cpu-percent=50 跳出棄用警告,新寫法是 --cpu=50%(也可以寫 --cpu=500m 用絕對值)。舊參數現在還能用,但官方教學和網路文章大多還沒改,看到警告不用緊張。
4. kubectl top 一開始沒有 Pod 的數字
metrics-server 剛開、Pod 剛建時,kubectl top pods 回 metrics not available yet,HPA 的 TARGETS 也是 <unknown>。要等一兩分鐘收集到資料。
用完記得刪
kubectl delete hpa php-apache; kubectl delete -f https://k8s.io/examples/application/php-apache.yaml; minikube delete | tail -1horizontalpodautoscaler.autoscaling "php-apache" deleted from default namespace
deployment.apps "php-apache" deleted from default namespace
service "php-apache" deleted from default namespace
💀 Removed all traces of the "minikube" cluster.
Cloud Shell 和 Minikube 都不收費。在 GKE 上壓力測試要特別小心:HPA 擴出來的 Pod 都要資源,Autopilot 照 Pod 的 requests 計費,Standard 可能觸發節點自動擴展多開 VM,測完要刪,--max 也不要設太大。
到了 GCP 上叫什麼
- GKE:Probe、requests/limits、HPA 寫法完全一樣。另外還有兩層自動擴展:VPA(自動建議或調整每個 Pod 的 requests)、叢集自動擴展(Pod 排不下時自動加節點,第 18 篇的 Pending 就可能被它解決)。Autopilot 模式下節點由 Google 管,照 Pod 的 requests 收費,所以 requests 寫太大會直接多付錢
- Cloud Run:不用設 HPA,內建自動擴展,看的是同時處理中的請求數(並行數),沒流量時可以縮到 0 個、不收錢。第 22 篇:Cloud Run 收費怎麼算?Cloud Run pricing、冷啟動、最小執行個體一次看懂 會帶數字算
| Minikube/GKE 的 HPA | Cloud Run | |
|---|---|---|
| 看什麼指標 | CPU、記憶體或自訂指標 | 並行請求數、CPU |
| 最少幾個 | --min,至少 1 | 可以 0(沒流量不收錢) |
| 縮回速度 | 預設等 300 秒 | 由 Cloud Run 自己決定 |
| 要自己設 | 要寫 HPA | 只要設最小、最大執行個體數 |
面試/證照會怎麼問
面試常見題
- 「liveness 和 readiness 差在哪?」:readiness 失敗只是不接流量、不重開;liveness 連續失敗會重開容器。開機慢的程式加 startupProbe
- 「livenessProbe 可以檢查資料庫嗎?」:不建議,資料庫一斷所有 Pod 會被反覆重開;資料庫相依放 readiness
- 「requests 和 limits 差在哪?」:requests 是排程依據和 HPA 的分母;limits 是上限,CPU 超過降速、記憶體超過被 OOMKilled
- 「HPA 怎麼算?」:無條件進位(目前個數 × 目前使用率 ÷ 目標),實測 1 × 250 ÷ 50=5
- 「為什麼流量下來了 Pod 還不縮?」:縮減有 300 秒穩定時間,避免反覆加減
- 「HPA 沒反應,TARGETS 是 unknown?」:沒有 metrics-server,或容器沒設 requests(沒有分母算不出百分比)
Kubernetes 證照(CKAD、CKA)
上機實作考(445 美元、2 小時,2026 年 11 月查 Linux Foundation 官方頁)。常見題型:
- 幫容器加 livenessProbe、readinessProbe(httpGet、tcpSocket、exec 三種寫法)
- 設定 requests、limits
- 用
kubectl autoscale或 YAML 建 HPA,指定最小、最大個數和目標使用率 - 用
kubectl top找出最耗 CPU 的 Pod
看到這些字,就想到這個
| 題目關鍵字 | 想到 |
|---|---|
| 「準備好才接流量」 | readinessProbe |
| 「卡死自動重開」 | livenessProbe |
| 「開機很慢被誤殺」 | startupProbe |
| 「依 CPU 自動加減 Pod」 | HPA |
| 「調整每個 Pod 的資源大小」 | VPA |
| 「Pod 排不下自動加節點」 | 叢集自動擴展(Cluster Autoscaler) |
| 「kubectl top 沒資料」 | metrics-server |
常見問答
HPA 是什麼?怎麼運作?
HPA(水平 Pod 自動擴展)依照 CPU 等指標自動調整 Pod 數量,公式是無條件進位(目前個數 × 目前使用率 ÷ 目標使用率),預設每 15 秒算一次。實測 1 個 Pod 的 CPU 衝到 250%、目標 50%,30 秒內擴成 5 個,之後再加到 7 個。指標要靠 metrics-server 提供。
liveness 和 readiness 有什麼不同?
readinessProbe 判斷「能不能接客」,失敗時 READY 變 0/1、Service 不送流量,但不會重開;livenessProbe 判斷「還活著嗎」,連續失敗就把容器重開。實測 readiness 回 404 時 Pod 是 Running 但 0/1;刪掉 liveness 檢查的檔案後,30 秒內 RESTARTS 變 1。
流量下降後,HPA 為什麼不馬上縮?
HPA 縮減有預設 300 秒的穩定時間,會參考過去 5 分鐘內算出的最大值,避免流量忽高忽低時 Pod 被反覆加減。實測 CPU 降到 0% 後,Pod 維持 7 個約 4 分鐘,約 5 分鐘後才回到 1 個。擴展沒有這個等待。
HPA 的 TARGETS 一直是 unknown 怎麼辦?
先確認有沒有 metrics-server(kubectl top nodes 有沒有數字),Minikube 要 minikube addons enable metrics-server;再確認容器有沒有設 requests.cpu,CPU 使用率是用 requests 當分母,沒設就算不出來。實測剛建好時會短暫顯示 unknown,一兩分鐘後就有數字。
500m 和 256Mi 是什麼意思?
CPU 的 m 是千分之一,500m 是 0.5 顆 CPU、200m 是 0.2 顆。記憶體的 Mi 是 2 的次方,256Mi 是 268,435,456 位元組;256M 是 256,000,000 位元組,少了約 4.6%。實測 php-apache 的 requests 是 200m,用到上限 500m 時使用率就是 250%。
kubectl autoscale 的 –cpu-percent 不能用了嗎?
還能用,但已經棄用。實測會跳出 Flag --cpu-percent has been deprecated 警告,新寫法是 --cpu=50%,也可以用 --cpu=500m 這種絕對值。正式環境建議直接寫 HPA 的 YAML(autoscaling/v2),放進 Git 管理。
重點整理
- 三種 Probe:readiness 失敗不接流量、liveness 連續失敗重開容器、startup 保護開機慢的程式;實測 readiness 404 → 0/1,刪檔 → RESTARTS 1
- requests/limits:requests 是排程和 HPA 的分母,limits 是上限;200m=0.2 顆 CPU,用到 500m=250%
- HPA 公式:無條件進位(個數 × 使用率 ÷ 目標);實測 1 × 250 ÷ 50=5,再 5 × 62 ÷ 50 → 7
- 擴得快、縮得慢:縮減預設等 300 秒,實測約 5 分鐘才從 7 回到 1
- 新寫法:
--cpu-percent已棄用,改--cpu=50%;GKE 多了 VPA 和叢集自動擴展,Cloud Run 內建擴展、可縮到 0
延伸閱讀
本系列
- 第 9 篇:K8s 架構白話:Kubernetes 控制平面、節點、Pod 怎麼分工
- 第 12 篇:Deployment 教學:自動補位、擴縮、滾動更新與回滾
- 第 13 篇:K8s Service 怎麼選?ClusterIP、NodePort、LoadBalancer 差在哪
- 上一篇:第 16 篇:K8s 資料怎麼保存?Volume、PV、PVC 一次看懂
- 下一篇:第 18 篇:Pod 起不來怎麼辦?CrashLoopBackOff、ImagePullBackOff、Pending 排錯
站上相關文章
- GKE 是什麼?Google Kubernetes Engine 教學:Autopilot 和 Standard 怎麼選
- GCP 帳單爆炸防護
- 雲端職缺大解析:雲端工程師、架構師、SRE、DevOps、資料工程師差在哪?
會自己檢查、會自己擴展之後,最後一塊是 Pod 真的起不來時怎麼查。如果你想有系統地從容器一路學到在 Google Cloud 上部署服務,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。