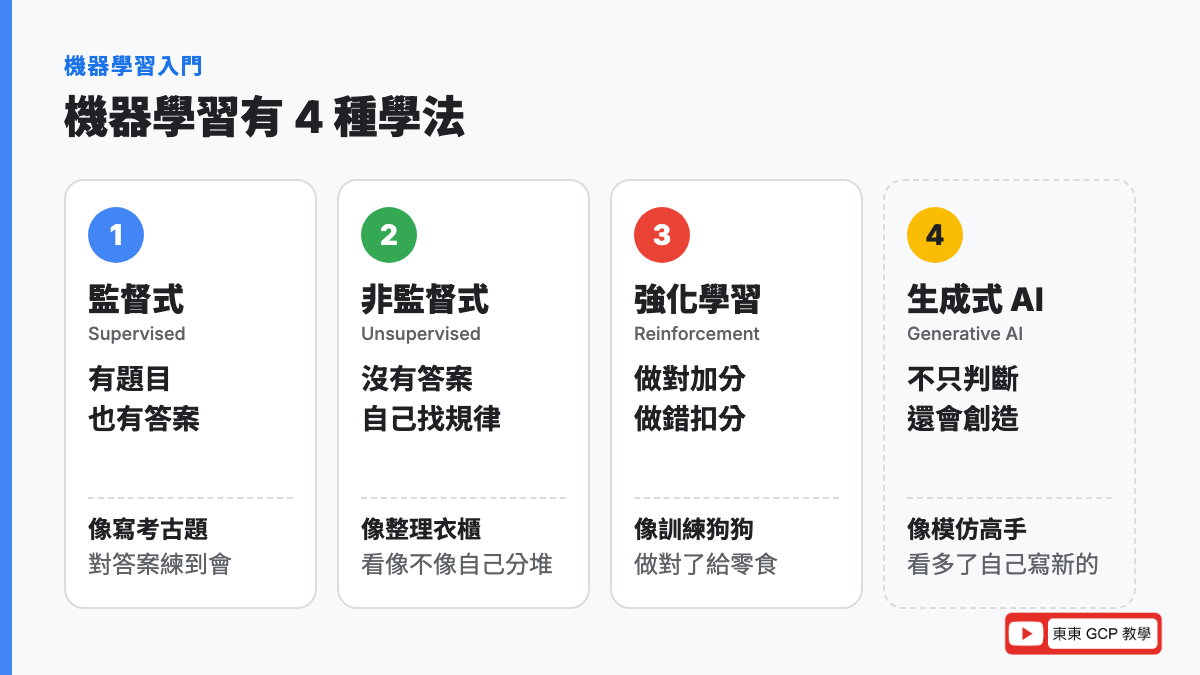
機器學習有哪幾種?主要分三種:有標準答案的「監督式」、沒有答案自己找規律的「非監督式」、靠試錯拿獎勵的「強化學習」。
Google 官方教材現在還把「生成式 AI」列成第四種。這篇用一間手搖飲料店當例子,從頭到尾帶你把機器學習的類型分清楚,最後再告訴你在 Google Cloud 上怎麼做、證照考試會怎麼考。
先搞懂:機器學習到底在「學」什麼?
在分種類之前,先把三個最基本的名詞講清楚。後面每一篇都會用到。
傳統寫程式 vs 機器學習
傳統寫程式,是人把規則一條一條寫好,電腦照做。
例如:「如果客人一次買 3 杯以上,就送 1 點。」規則是人想的。
機器學習,是人不寫規則,而是丟一大堆過去的紀錄給電腦,讓它自己找出規則。
例如:把飲料店過去 1 萬筆會員消費紀錄給電腦,讓它自己發現「哪種客人下個月比較可能再回來」。
會需要機器學習,是因為很多規則人根本寫不出來。你很難用幾條「如果……就……」寫出「怎麼從照片看出這是貓」,但給電腦看 10 萬張貓的照片,它可以自己學會。
三個一定會遇到的名詞
| 名詞 | 白話是什麼 | 飲料店比喻 |
|---|---|---|
| 模型(Model) | 電腦從資料裡整理出來的「經驗法則」 | 做了十年的老店員,看一眼就知道這客人會點什麼的那種直覺 |
| 訓練(Training) | 讓電腦看資料、整理出經驗法則的過程 | 新店員實習,一直看前輩怎麼做、慢慢累積經驗 |
| 預測(Prediction) | 拿學好的經驗法則,去回答一個新問題 | 新客人走進來,店員猜他會點什麼 |
「模型」這個詞很容易讓人以為是什麼實體的東西,像模型車。其實它就是一組從資料學出來的判斷方式,存成一個檔案,可以重複拿來用。
為什麼要分種類?
因為手上有的資料不一樣、想解決的問題不一樣,適合的學法就不一樣。
這就像學做菜:有食譜照著做是一種學法,沒食譜自己亂試是另一種。如果一開始就選錯學法,後面花再多時間調整都是白費。這也是為什麼證照考試很多題目的第一步,就是要你判斷「這該用哪一種」。
為什麼你需要知道
如果你想轉職雲端或 AI,或正在準備 Google Cloud 的機器學習工程師證照,這篇是所有東西的地基:
- 看不懂後面的名詞:分類、迴歸、分群、標籤、過度擬合……這些詞全都是建在「監督式/非監督式」這個分法上
- 選錯工具:Google Cloud 的機器學習服務,第一步幾乎都是要你選「模型類型」。類型選錯,模型根本訓練不出你要的東西
- 考試第一關就卡住:考題常常是一段商業情境,要你判斷該用哪一類模型、哪個服務。分不清楚,連選項都看不懂
監督式學習:有考古題、有答案可以對
白話是什麼
監督式學習(Supervised Learning),就是給電腦一堆「題目+正確答案」,讓它從裡面學會怎麼答題。
比喻
Google 官方教材用的比喻很好懂:就像學生拿有附解答的考古題來練習。練得夠多,遇到沒看過的新題目也答得出來。
為什麼叫「監督」?
「監督」指的是:有人事先準備好正確答案,在旁邊幫忙對答案。就像老師在旁邊批改作業,錯了會被糾正,所以叫「有監督」。
這個「正確答案」有個專有名詞,叫標籤(Label)。
標籤:每一筆資料的「正確答案」。
飲料店例子:過去 1 萬筆會員紀錄,每筆都記了「這位客人下個月有沒有再回來」。這一欄「有回來/沒回來」就是標籤。
監督式學習的兩大類:分類 vs 迴歸
監督式學習又分成兩種,差別只在「答案長什麼樣子」:
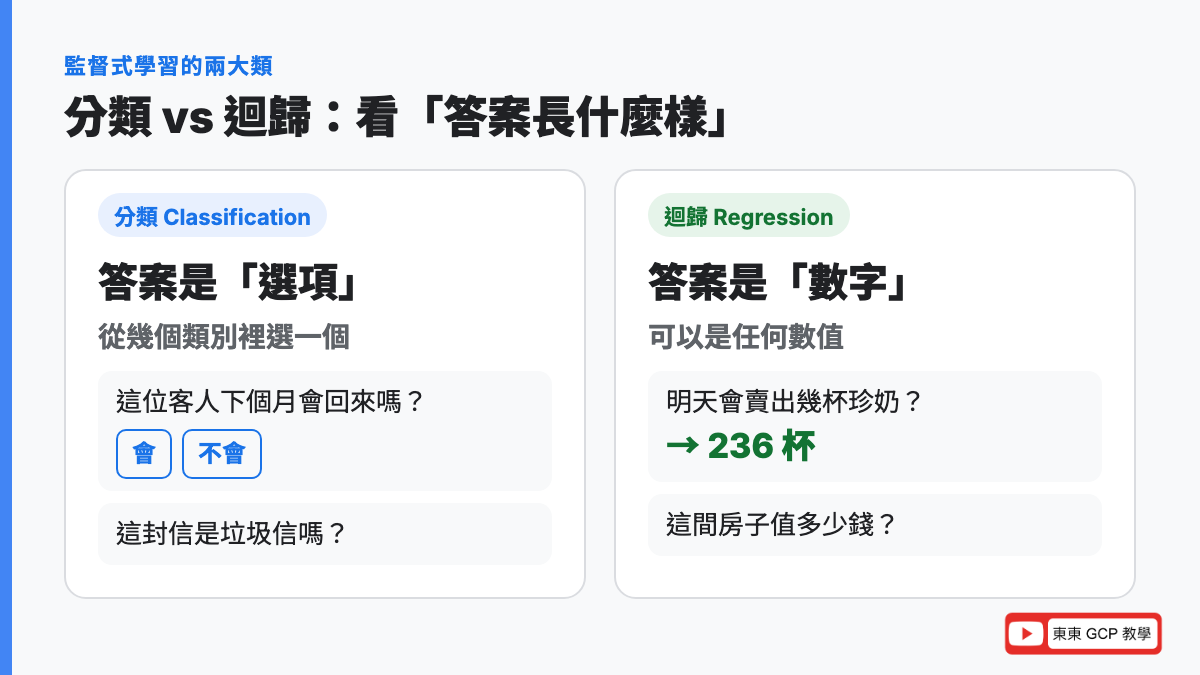
| 分類(Classification) | 迴歸(Regression) | |
|---|---|---|
| 答案長怎樣 | 選項(從幾個類別裡選一個) | 數字(可以是任何數值) |
| 飲料店例子 | 這位客人下個月「會回來」還是「不會回來」? | 明天會賣出「幾杯」珍珠奶茶? |
| 其他例子 | 這封信是不是垃圾信?這筆刷卡是不是盜刷? | 這間房子值多少錢?這趟車程要幾分鐘? |
分類很好理解,就是「分到哪一類」。只有兩個選項(會/不會)叫二元分類,超過兩個選項(例如天氣是晴、雨、雪、冰雹)叫多元分類。
迴歸這個名字就比較怪了,為什麼「預測數字」要叫迴歸?
來龍去脈:19 世紀英國學者高爾頓(Francis Galton)研究父母和子女的身高,發現很高的父母,小孩通常也高,但會比父母「矮回來一點」,往大家的平均值靠近。他把這個現象叫做「均值回歸」(regression toward the mean)。後來研究這種「用一個數字預測另一個數字」的方法,就一直沿用「迴歸」這個名字。
所以你不用從字面去理解它,記住「迴歸=預測數字」就好。
分類和迴歸怎麼評分、各有哪些常見模型,下一篇會用更多例子拆開講。
一個超常見的陷阱:邏輯迴歸是拿來「分類」的
監督式學習常見的模型有這幾個(現在先認得名字就好,後面的文章會一個一個講):
- 線性迴歸(Linear Regression):預測數字,例如預測銷量
- 邏輯迴歸(Logistic Regression):名字有「迴歸」,但它是拿來做分類的,例如預測客人會不會回來
- 決策樹、提升樹(Decision Tree、Boosted Tree):像一連串「是/否」問答題,分類和迴歸都能做
- 深度神經網路(DNN):模仿人腦神經元連結的模型,適合圖片、聲音這類複雜資料,分類和迴歸都能做
邏輯迴歸會叫「迴歸」,是因為它內部其實先算出一個 0 到 1 之間的機率(例如「這位客人有 80% 機率會回來」),再把機率換成「會/不會」。名字取自它的計算方式,不是它的用途。這是面試和考試很愛考的小陷阱。
監督式學習的難處:答案要有人準備
標籤不會自己長出來。要做「判斷照片裡有沒有貓」,就要有人一張一張看照片、標上「有貓/沒貓」。這個工作叫資料標註,又花時間又花錢。
所以實務上常見的狀況是:資料很多,但有答案的很少。這時候就輪到下一種學法上場。
非監督式學習:沒有答案,讓電腦自己找規律
白話是什麼
非監督式學習(Unsupervised Learning),就是只給電腦資料、不給答案,讓它自己找出資料裡隱藏的規律或分組。
比喻
想像你搬家,一大箱衣服倒在床上,沒有人告訴你要怎麼分。你自然會把它們分成上衣一堆、褲子一堆、外套一堆。沒人給你分類規則,你是看東西長得像不像,自己分出來的。 這就是非監督式學習在做的事。
為什麼叫「非監督」?
很直接:旁邊沒有老師對答案。資料裡沒有標籤,電腦只能自己摸索。
最常見的做法:分群(Clustering)
分群,就是把「彼此很像」的資料放在同一群。
最經典的分群方法叫 K-means,名字可以拆開看:
- K:你想分成幾群。K = 3 就是分 3 群
- means:平均值。每一群會算出一個「平均中心點」,離哪個中心點最近,就歸到哪一群
飲料店例子(以下數字是假設,用來說明):
飲料店有 1 萬名會員,你只有兩個資料:「一個月來幾次」和「平均每次花多少錢」。你不知道客人該怎麼分,所以叫電腦用 K-means 分 3 群,結果可能長這樣:
| 電腦分出來的群 | 一個月來幾次(平均) | 每次花多少(平均) | 人看了之後取的名字 |
|---|---|---|---|
| 第 1 群 | 12 次 | 60 元 | 每天一杯的上班族 |
| 第 2 群 | 1 次 | 450 元 | 幫辦公室團購的人 |
| 第 3 群 | 3 次 | 120 元 | 週末路過的散客 |
注意最後一欄:電腦只會給你「第 1 群、第 2 群、第 3 群」,群的名字是人看了數字之後自己取的。這就是分群和分類最大的不同。
- 分類:類別是你事先定好的(會回來/不會回來),電腦學怎麼分
- 分群:類別是電腦自己找出來的,你事後再去解讀
分完群有什麼用?行銷就可以針對上班族推「集點卡」,針對團購族推「滿 10 杯送 1 杯」,不用對所有人發一樣的優惠。
推薦系統放哪裡?
「買了這個的人也買了……」這種推薦功能,常被放在非監督式學習一起講。最常見的兩種做法:
- 協同過濾(Collaborative Filtering):「跟你口味很像的人,還喜歡什麼?」
例如你常點珍奶跟鮮奶茶,另外 500 個也常點這兩杯的人,很多都愛黑糖拿鐵,那就推黑糖拿鐵給你。
- 內容型推薦(Content-based):「你喜歡的東西,跟哪些東西長得像?」
例如你常點有奶的飲料,那就推其他有奶的新品。
老實說,推薦系統實務上監督式、非監督式的做法都有人用,它比較像一個「應用題型」,不是單純屬於哪一類。考試只要你認得「推薦」的情境,並知道 Google Cloud 上有對應的做法(後面「在 GCP 上怎麼做」會講)。
為什麼要學
非監督式學習最大的好處是:不用先花錢做標註。很多公司手上有一大堆沒整理過的資料,用分群可以先看出大概的樣貌,再決定下一步要做什麼。
強化學習:做對給糖、做錯扣分,自己試出最好的做法
白話是什麼
強化學習(Reinforcement Learning),是讓電腦在一個環境裡一直嘗試不同做法,做得好就加分、做不好就扣分,最後自己摸索出「怎麼做分數最高」。
比喻
就像訓練狗狗坐下:牠坐下了就給零食,亂跳就不給。試了幾十次之後,狗狗就學會「聽到坐下就坐下,會有零食」。沒有人跟牠講原理,牠是靠獎勵自己試出來的。
為什麼叫「強化」?
「強化」是心理學名詞,意思是:一個行為得到獎勵,下次就更容易再出現,這個行為被「強化」了。電腦的學法跟狗狗一樣,所以借用這個名字。
四個關鍵角色
| 角色 | 白話 | 外送例子 |
|---|---|---|
| 代理人(Agent) | 負責做決定的那一方 | 排外送路線的程式 |
| 環境(Environment) | 代理人所在的世界 | 城市的道路、紅綠燈、塞車狀況 |
| 獎勵(Reward) | 每次做完決定拿到的分數 | 準時送到加分,遲到扣分 |
| 策略(Policy) | 最後學會的「在什麼情況下該怎麼做」 | 「下午 5 點後避開某條路」這類規則 |
這裡的 Agent 跟最近很紅的「AI Agent」名字一樣,但在強化學習裡,它單純指「做決定的那一方」,不用想得太複雜。
算一次給你看:電腦怎麼知道哪條路比較好?
假設飲料店的外送系統這樣計分:每準時送到 1 單 +10 分,每遲到 1 分鐘 −1 分。
第一天,系統試了兩條路線,各送 5 單:
| 路線 A(走大馬路) | 路線 B(鑽小巷) | |
|---|---|---|
| 準時送到 | 5 單 × 10 分 = 50 分 | 5 單 × 10 分 = 50 分 |
| 遲到扣分 | 總共遲到 12 分鐘 = −12 分 | 總共遲到 3 分鐘 = −3 分 |
| 總分 | 50 − 12 = 38 分 | 50 − 3 = 47 分 |
路線 B 分數比較高,所以系統下次會比較常選路線 B。
但它不會從此只走 B,還是會偶爾試試新路線。因為說不定還有一條 C 更快,只是還沒試過。
探索 vs 利用:強化學習永遠在這兩件事之間取捨。
- 利用:走目前已知最好的路(B),穩穩拿分
- 探索:偶爾冒險試新路,可能找到更好的,也可能踩雷
就像你常去的那家午餐很好吃,但偶爾也會想試試新開的店。全部只吃同一家,可能錯過更好吃的;每天都試新的,又常常踩雷。
強化學習用在哪?
需要「做一連串決定」、而且可以大量試錯的地方:下棋(例如 Google DeepMind 的 AlphaGo)、機器人學走路、路線規劃、廣告出價。
它的門檻是:要有一個可以讓電腦反覆試錯的環境。現實世界很多事情不能亂試(例如醫療),所以強化學習在一般企業專案裡,比前兩種少見得多。
番外:生成式 AI 算哪一種?
ChatGPT、Gemini 這類會寫文章、畫圖的 AI,叫生成式 AI(Generative AI)。
機器學習是三種還是四種?
你在網路上、教科書或舊題庫看到的,大多寫「機器學習分三種」:監督式、非監督式、強化學習。這是過去十幾年的標準說法,沒有錯。但生成式 AI 這幾年變得太重要,Google 官方入門教材〈What is Machine Learning?〉現在把它獨立出來,列為機器學習的第四類。
所以兩種說法你都會看到。記法很簡單:三種是「學習方式」的老分法,四種是把生成式 AI 也算進來的新分法。考試或面試被問到時,先答三種,再補一句「Google 現在也把生成式 AI 列為第四類」,就是最完整的答案。
它跟前三種最大的不同是:
- 前三種是「判斷」:這是哪一類?會是多少?該怎麼做?
- 生成式 AI 是「創造」:寫一段新品文案、畫一張菜單插圖
有趣的是,它其實是三種學法混著用。根據 Google 官方教材的說明,生成式模型通常先用非監督式的方式大量模仿現有資料,再用監督式學習或強化學習針對特定任務調整。
生成式 AI 跟傳統機器學習的差別,站上有一篇專門在講:生成式 AI 是什麼?跟機器學習差在哪裡?
怎麼判斷該用哪一種?問自己三個問題
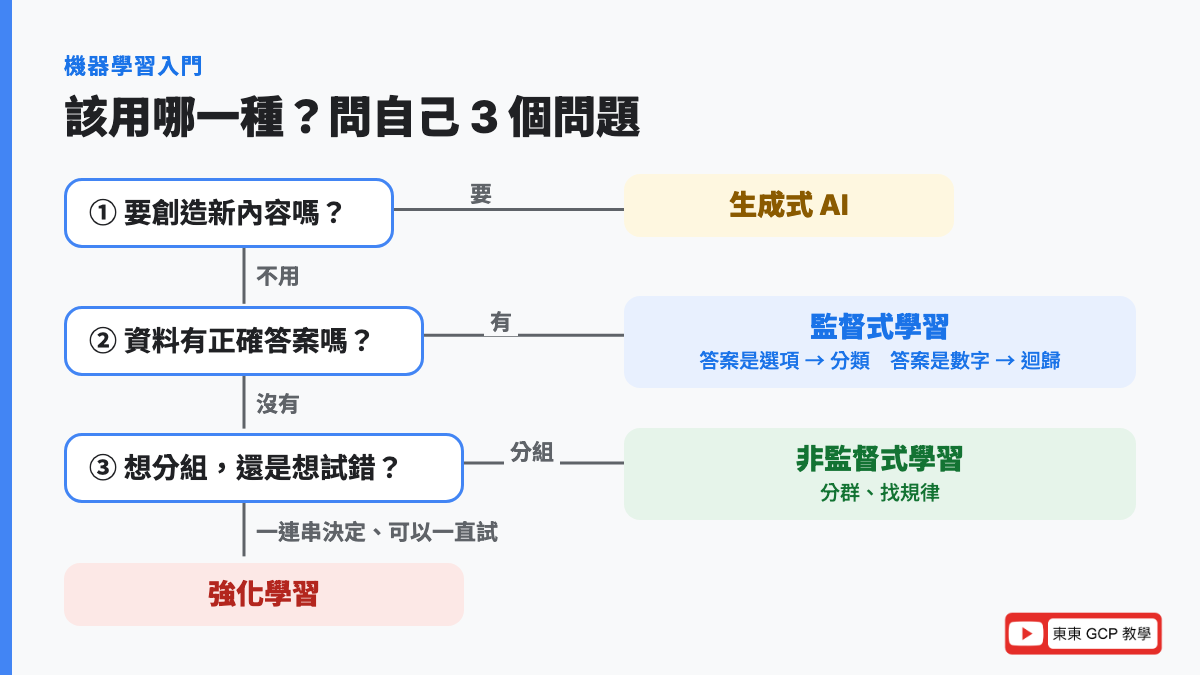
- 你要電腦「創造新內容」嗎? 要 → 生成式 AI
- 你手上的資料有沒有「正確答案」(標籤)?
- 有 → 監督式學習,再看答案是選項(分類)還是數字(迴歸)
- 沒有 → 往下看第 3 題
- 你是想「把東西分組、找規律」,還是要「做一連串決定、可以一直試」?
- 分組、找規律 → 非監督式學習
- 一連串決定、可以試錯 → 強化學習
用飲料店的情境練習一下:
| 你想解決的問題 | 該用哪一種 |
|---|---|
| 這位會員下個月會不會流失? | 監督式:分類 |
| 明天要準備幾公斤珍珠? | 監督式:迴歸 |
| 這則 Google 評論是正評還是負評? | 監督式:分類 |
| 會員可以分成哪幾種客群? | 非監督式:分群 |
| 要推薦哪一款新品給這位客人? | 推薦系統 |
| 外送員每天怎麼排路線最省時? | 強化學習 |
| 幫新品寫 5 種不同風格的文案 | 生成式 AI |
在 GCP 上怎麼做
GCP(Google Cloud Platform) 是 Google 的雲端服務。白話說,就是租用 Google 機房裡的電腦和工具,不用自己買主機。在 GCP 上做機器學習,最常用到兩個服務。
1. BigQuery ML:只會 SQL 也能訓練模型
- BigQuery:Google 的大型資料倉庫,專門存放、分析超大量的表格資料。想了解更多可以看 BigQuery 跟資料庫差在哪
- SQL:一種「跟資料庫說話」的語言,用來查詢、整理資料。很多行銷、財務人員也會用
- BigQuery ML:讓你用 SQL 指令直接在 BigQuery 裡訓練模型(官方介紹),資料不用搬出去,也不用會寫 Python
訓練時只要在指令裡指定 model_type(模型類型),就對應到這篇講的分類方式:
| 你要做的事 | 類型 | BigQuery ML 的 model_type(部分) |
|---|---|---|
| 預測數字 | 監督式:迴歸 | LINEAR_REG、BOOSTED_TREE_REGRESSOR |
| 預測類別 | 監督式:分類 | LOGISTIC_REG、BOOSTED_TREE_CLASSIFIER |
| 分群 | 非監督式 | KMEANS |
| 推薦 | 推薦系統 | MATRIX_FACTORIZATION(矩陣分解) |
| 預測未來趨勢(時間序列) | 預測 | ARIMA_PLUS |
矩陣分解:把「哪位會員買過哪款飲料」整理成一張超大表格,再把它拆解,找出隱藏的口味傾向(例如「愛喝奶」「愛喝果茶」)。協同過濾常用的就是這個方法。
前面飲料店分 3 群的例子,在 BigQuery ML 裡大概長這樣:
CREATE MODEL `shop.member_groups`
OPTIONS(model_type='KMEANS', num_clusters=3) AS
SELECT visits_per_month, avg_spend
FROM `shop.members`;
一行一行翻成白話:
CREATE MODEL shop.member_groups:建立一個模型,取名叫「會員分群」model_type='KMEANS':用 K-means 分群num_clusters=3:分成 3 群(就是 K = 3)SELECT visits_per_month, avg_spend FROM shop.members:拿會員資料表裡的「每月來店次數」和「平均消費」來分
注意這裡沒有標籤欄位,因為分群是非監督式學習,本來就不需要答案。
2. AutoML:不寫程式,上傳資料點一點
AutoML 是「自動化機器學習」的意思:你上傳資料、指定要預測哪一欄,它會自動幫你試很多種模型、挑表現最好的。適合不想寫程式、或想快速做出第一版的人。
AutoML 放在 Google 的機器學習平台裡。這個平台的名字最近改了,一定要知道:
舊題庫可能還會看到 Vertex AI,現在叫 Gemini Enterprise Agent Platform(簡稱 Agent Platform)。
Google Cloud 在 2026 年 4 月 22 日正式改名(官方改名對照表),2026 年 6 月 1 日起的 PMLE 考試指南也全面換成新名稱。
| 舊名稱(舊題庫、舊文章常見) | 現在的名稱 |
|---|---|
| Vertex AI | Gemini Enterprise Agent Platform(Agent Platform) |
| AutoML Tables/Vision/Natural Language | AutoML on Gemini Enterprise Agent Platform |
| Vertex AI Workbench | Gemini Enterprise Agent Platform Workbench |
| Vertex AI Model Garden | Gemini Enterprise Agent Platform Model Garden |
更早以前,AutoML 還分成 AutoML Tables、AutoML Vision 等好幾個獨立產品,後來先整合進 Vertex AI,現在又跟著平台一起改名。看到舊名稱不用緊張,它們講的是同一套東西。
想先認識這個平台有哪些功能,可以看 Vertex AI 核心功能 Agent Builder、Model Builder 和 Model Garden 介紹(文章寫於改名前,內容仍可參考)。
3. 強化學習呢?
BigQuery ML 和 AutoML 的模型清單裡都沒有強化學習。真的要做的話,通常要自己寫程式,再用平台的自訂訓練功能來跑。對初學者和考試來說,強化學習能認出情境就夠了。
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南,第一大區塊就是「用低程式碼方式打造 AI 方案」,約占考試 13%。其中明列:要能根據商業問題,在 BigQuery ML 或 AutoML 裡選擇模型類型(分類、迴歸、預測、分群)。
也就是說,這篇講的分類方式,是考試最基本的判斷能力。
看到這些字,就想到這個類型
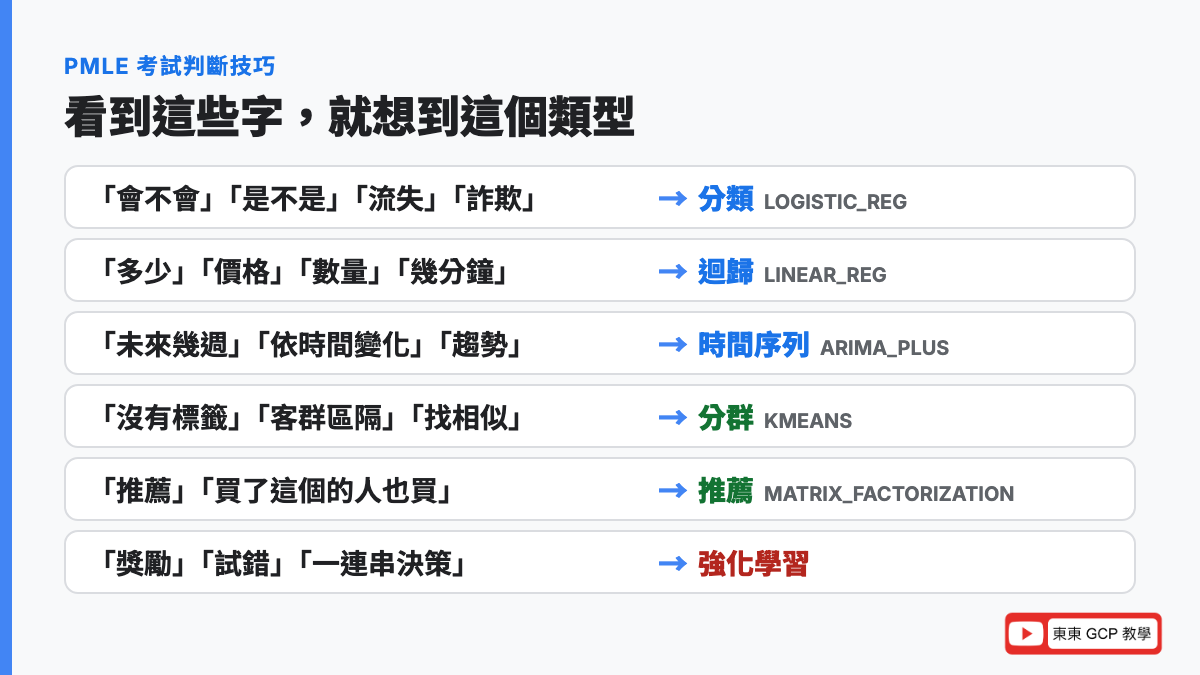
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「會不會」「是不是」「哪一類」「流失」「詐欺」「垃圾信」 | 監督式:分類 |
| 「多少」「價格」「金額」「數量」「時間長度」 | 監督式:迴歸 |
| 「未來幾天/幾週」「依時間變化」「銷量趨勢」 | 時間序列預測(BigQuery ML 的 ARIMA_PLUS) |
| 「沒有標籤」「客群區隔」「分組」「找出相似」 | 非監督式:分群(KMEANS) |
| 「推薦」「買了這個的人也買」「使用者評分」 | 推薦(MATRIX_FACTORIZATION) |
| 「獎勵」「試錯」「一連串決策」「最佳化路線」 | 強化學習 |
| 「產生文字/圖片」「摘要」「對話」 | 生成式 AI(Gemini、Model Garden) |
三個常見陷阱
- 邏輯迴歸是分類:選項寫「用 Logistic Regression 預測房價」,那是錯的,房價是數字,要用迴歸
- 預測「未來的數字」不一定只是迴歸:如果資料是照時間排的(每天的銷量),題目要的往往是時間序列預測
- 新舊名稱混用:舊題庫寫 Vertex AI,新考試寫 Agent Platform,指的是同一個平台
練習情境(自己出的練習,不是真實考題)
一間連鎖飲料店有 50 萬筆會員消費紀錄存在 BigQuery,行銷團隊想知道「會員大概可以分成哪幾種族群」,以便設計不同優惠。團隊只會 SQL。應該怎麼做?
判斷過程:
- 「分成哪幾種族群」→ 事先不知道有哪些類別,沒有標籤 → 非監督式:分群
- 資料已經在 BigQuery、團隊只會 SQL → BigQuery ML
- 答案:用 BigQuery ML 建立
KMEANS模型
如果題目改成「預測每位會員下個月會不會流失」,而且資料裡有過去「是否流失」的紀錄,那就是有標籤的分類,改用 LOGISTIC_REG 或 BOOSTED_TREE_CLASSIFIER。
常見問答
機器學習和 AI(人工智慧)差在哪?
AI 是一個大目標:讓電腦表現得像有智慧。機器學習是達成這個目標最主流的方法:讓電腦從資料中自己學規則。所以機器學習是 AI 的一部分,現在你聽到的 AI 產品,大多數背後都是機器學習。
機器學習到底是分三種還是四種?
兩種說法都對。傳統分法是三種:監督式、非監督式、強化學習。Google 官方入門教材現在把生成式 AI 也獨立列出來,變成四種。回答時先講三種,再補充 Google 現在把生成式 AI 列為第四類,最完整。
監督式和非監督式學習,最大的差別是什麼?
差在資料有沒有正確答案(標籤)。有答案、讓電腦學怎麼答題,是監督式;沒答案、讓電腦自己找規律或分群,是非監督式。
推薦系統是監督式還是非監督式?
兩種都有人用。常見的協同過濾是從大家的購買紀錄找出口味相似的人,常被歸在非監督式一起講;但也有做法是把「有沒有點擊」當標籤,用監督式學習來訓練。考試重點是認出「推薦」情境,知道 BigQuery ML 可以用 MATRIX_FACTORIZATION 來做。
Vertex AI 改名了嗎?現在叫什麼?
改了。Google Cloud 在 2026 年 4 月 22 日把 Vertex AI 改名為 Gemini Enterprise Agent Platform,簡稱 Agent Platform。底下的 AutoML、Workbench、Model Garden 等功能也跟著改名,但功能本身是延續的。
沒有數學或寫程式背景,可以準備 PMLE 嗎?
官方考試指南註明,這個考試不直接考寫程式,只要有基本的 Python 和 SQL 能力,看得懂題目裡的程式片段就可以。考試的重點是「判斷該用哪個方法和服務」。不過基本概念還是要真的懂,這也是這個系列從零開始寫的原因。
重點整理
- 監督式學習:資料有正確答案(標籤)。答案是選項叫分類,答案是數字叫迴歸
- 非監督式學習:資料沒有答案,讓電腦自己分群、找規律;群的名字是人事後取的
- 強化學習:靠「做對加分、做錯扣分」自己試出最好的策略,需要可以大量試錯的環境
- 生成式 AI:傳統說法是三種,Google 官方現在把生成式 AI 列為第四類;它負責「創造」新內容,背後混用前三種學法
- 在 GCP 上,BigQuery ML 用
model_type選類型;Vertex AI 已改名為 Gemini Enterprise Agent Platform
延伸閱讀
本系列下一篇
站上相關文章
- 生成式 AI 是什麼?跟機器學習差在哪裡?
- BigQuery 不就是查詢嗎?跟資料庫差在哪裡?能做什麼分析?
- Vertex AI 核心功能 Agent Builder、Model Builder 和 Model Garden 介紹
- End-to-end Training(端到端訓練)是什麼?
- GCP 學習路徑 Learning Roadmap 和八大關卡
搞懂這四種學法,你已經跨過機器學習最重要的第一步。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。