Cloud Run 收費怎麼算?預設是「以請求計費」:只在處理請求時算 CPU、記憶體的秒數,加上請求次數,每月有免費額度。
第 20 篇把網頁部署成 Cloud Run 服務,第 21 篇交給 Cloud Build 自動部署。這篇把 Cloud Run pricing(Cloud Run 的計費方式)拆開來看:錢是怎麼算出來的、兩種計費方式差在哪、什麼是冷啟動、開「最小執行個體」一個月要多付多少。
這篇會帶同一組數字算一次「一個月 300 萬次請求要付多少」,再到 Cloud Shell 實際量冷啟動:縮到零之後的第一個請求要等多久、開了最小執行個體之後差多少,以及「並行數」設 80 和設 1,同樣 10 個請求會用掉幾台機器。
這是「容器系列」第 22 篇。全部在 Cloud Shell 實際跑過,輸出都是真實結果(2026 年 11 月實測,Google Cloud SDK 592.0.0)。價格是 2026 年 11 月查官方定價頁的數字,以後可能調整,下單前請再看一次官方定價頁。
為什麼你需要知道
- 選錯計費方式,同一個服務可以差 4 倍:這篇算的例子,預設的以請求計費一個月約 10.48 美元,改成以執行個體計費約 44.03 美元
- 「Cloud Run 沒人用就不收錢」只對一半:開了最小執行個體,沒人用也會收閒置費;1 vCPU、512 MiB 留一台,一個月約 9.72 美元
- 冷啟動會讓第一個使用者等比較久:要不要花錢買「隨時有人顧店」,要先知道冷啟動實際多久(這篇實測)
- 面試和證照很愛考:「流量很少、不想沒人用還付錢」「要避免冷啟動」「背景要持續跑」這三種情境,對應的設定都不一樣
Cloud Run pricing 是什麼:先認識四個計費單位
Cloud Run pricing 是 Cloud Run 的計費規則:照你的服務實際用掉的 CPU 時間、記憶體時間、請求次數和對外網路流量收費,用多少算多少。
- 比喻:像路邊停車格的計時收費,不是月租。車子(你的程式)停多久算多久,停一次的時間以 100 毫秒為一格,不滿一格算一格
- 來龍去脈:以前租一台虛擬機器(VM),不管有沒有人用,一個月都要付整台的錢。Cloud Run 屬於無伺服器(Serverless)服務:機器由 Google 管,沒人用的時候可以縮到 0 台,所以改成照「真的在做事的時間」收費
- 為什麼要學:Cloud Run 便宜的前提是「大部分時間沒人用」。流量模式一變(例如一直有人連、或開了最小執行個體),帳單的算法就跟著變
| 計費單位 | 白話 | 例子 |
|---|---|---|
| vCPU 秒(vCPU-second) | 1 顆虛擬 CPU 用 1 秒 | 1 vCPU 的服務處理請求 0.2 秒,算 0.2 vCPU 秒 |
| GiB 秒(GiB-second) | 1 GiB 記憶體用 1 秒 | 512 MiB(0.5 GiB)的服務跑 0.2 秒,算 0.1 GiB 秒 |
| 請求數(Requests) | 有人連進來一次算一次 | 每 100 萬次 0.40 美元(以請求計費才收) |
| 對外網路流量(Egress) | 從 Cloud Run 傳到網路上的資料量 | 同區域傳給其他 Google Cloud 服務不收費 |
vCPU(虛擬 CPU)是雲端切給你的一份 CPU 運算能力,Cloud Run 預設每台 1 vCPU。GiB 是記憶體的單位,1 GiB = 1,024 MiB,跟硬碟常看到的 GB(1,000 MB)差一點點。記憶體是程式執行時暫放資料的地方,關機就清空。
所有計費時間都以 100 毫秒為單位無條件進位:一個請求處理 0.23 秒,算 0.3 秒(2026 年 11 月查官方定價頁)。
兩種計費方式:以請求計費、以執行個體計費
Cloud Run 服務有兩種計費設定(2026 年 11 月查官方計費設定說明):
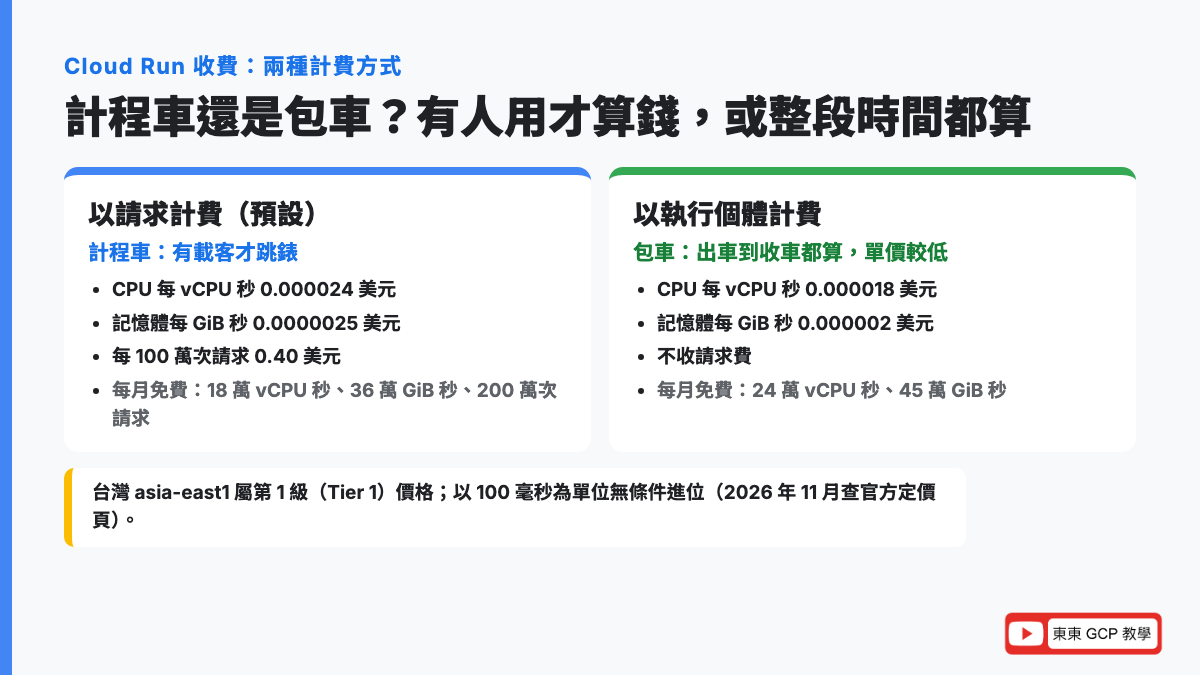
- 以請求計費(Request-based billing,預設):執行個體只有在「啟動中、正常關閉中、至少有一個請求在處理」的時候計費。沒有請求的空檔不收 CPU 和記憶體的錢,但每個請求另外收費
- 以執行個體計費(Instance-based billing):從執行個體啟動到關掉,整段時間都計費,最少算 1 分鐘。CPU 和記憶體單價比較低,而且不收請求費
執行個體(Instance)是 Cloud Run 幫你開起來跑容器的一台機器,第 20 篇看過它會自己增加、減少。比喻:以請求計費像搭計程車,有載客才跳錶,但每次上車有起跳價;以執行個體計費像包車,從出車到收車都算錢,但每小時的單價比較便宜。
| 以請求計費(預設) | 以執行個體計費 | |
|---|---|---|
| CPU(每 vCPU 秒) | 0.000024 美元 | 0.000018 美元 |
| 記憶體(每 GiB 秒) | 0.0000025 美元 | 0.000002 美元 |
| 請求(每 100 萬次) | 0.40 美元 | 不收 |
| 每月免費額度 | 18 萬 vCPU 秒、36 萬 GiB 秒、200 萬次請求 | 24 萬 vCPU 秒、45 萬 GiB 秒 |
| 沒有請求時 | 不收 CPU、記憶體(最小執行個體除外) | 照收 |
| 沒有請求時 CPU | 被限速,幾乎不能做事 | 一直有 CPU,可以跑背景工作 |
| 舊名稱 | CPU only allocated during request processing | CPU always allocated |
| gcloud 參數 | --cpu-throttling | --no-cpu-throttling |
價格是台灣 asia-east1 的牌價(2026 年 11 月查官方定價頁,並用 Cloud Billing Catalog API 交叉確認)。免費額度以帳單帳戶為單位,同一個帳單帳戶底下所有專案共用,每月重置。
新舊名稱對照:網路上的舊教學寫「CPU always allocated(CPU 一直分配)」「CPU only allocated during request processing(只在處理請求時分配 CPU)」,官方現在改叫「以執行個體計費」「以請求計費」,gcloud 的參數名稱沒改,還是 --no-cpu-throttling、--cpu-throttling。
台灣 asia-east1 是第 1 級價格
區域(Region)是 Google 資料中心所在的地區,asia-east1 在台灣彰化。Cloud Run 把區域分成兩級價格:
| 價格等級 | 例子 | 差別 |
|---|---|---|
| 第 1 級(Tier 1) | asia-east1 台灣、asia-northeast1 東京、us-central1 愛荷華 | 單價較低 |
| 第 2 級(Tier 2) | asia-east2 香港、asia-southeast1 新加坡、europe-west3 法蘭克福 | 單價較高 |
台灣的使用者選 asia-east1,離得近、又是比較便宜的第 1 級,兩個好處都拿到(2026 年 11 月查官方定價頁的區域分級)。
算一次:一個月 300 萬次請求要付多少
用同一組假設,兩種計費方式各算一次:
- 服務規格:1 vCPU、512 MiB(Cloud Run 的預設值)
- 一個月 300 萬次請求,每次處理 0.2 秒
- 假設請求不會同時進來(一次只處理一個),所以計費時間 = 300 萬 × 0.2 秒 = 60 萬秒
以請求計費(預設):
- CPU:60 萬秒 × 1 vCPU = 60 萬 vCPU 秒,扣掉免費 18 萬 = 42 萬 × 0.000024 = 10.08 美元
- 記憶體:60 萬秒 × 0.5 GiB = 30 萬 GiB 秒,還在免費的 36 萬以內 = 0 美元
- 請求:300 萬次扣掉免費 200 萬 = 100 萬次 × 0.40 = 0.40 美元
- 合計:約 10.48 美元
以執行個體計費:一直有人連,執行個體一整個月都開著(30 天 × 86,400 秒 = 259.2 萬秒):
- CPU:259.2 萬 vCPU 秒,扣掉免費 24 萬 = 235.2 萬 × 0.000018 = 42.34 美元
- 記憶體:259.2 萬 × 0.5 = 129.6 萬 GiB 秒,扣掉免費 45 萬 = 84.6 萬 × 0.000002 = 1.69 美元
- 請求:不收
- 合計:約 44.03 美元
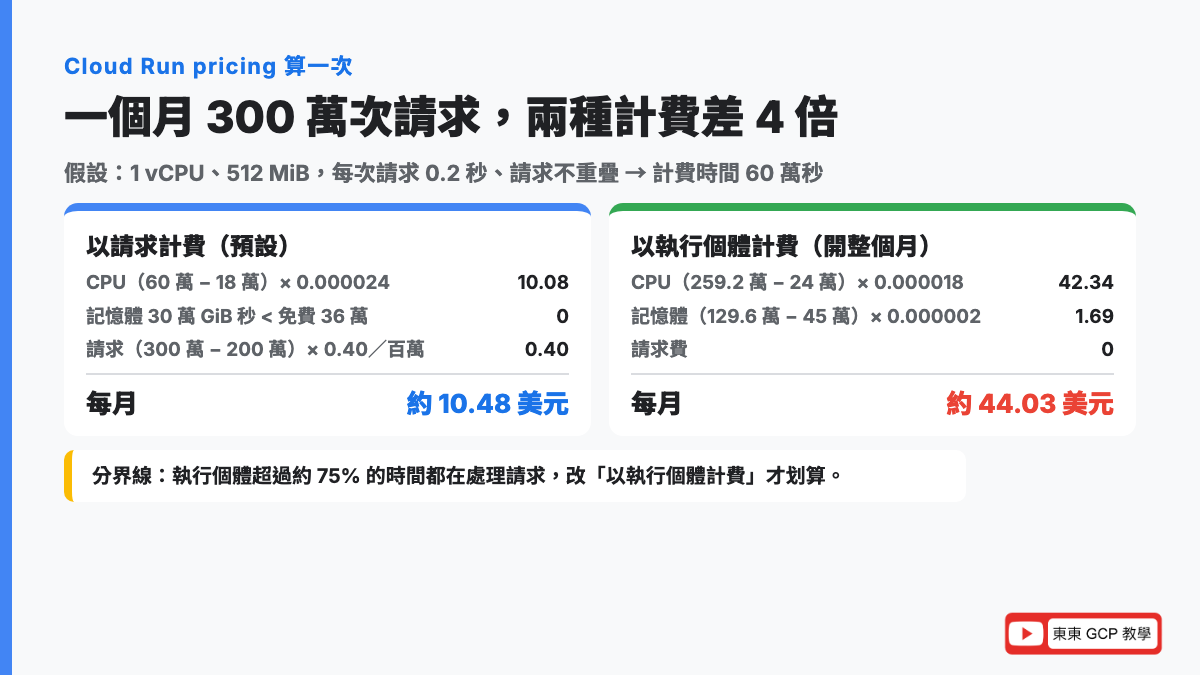
這個例子差了 4 倍,原因是 60 萬秒只佔一個月的 23%,其他 77% 的時間沒人用。以請求計費不收空檔的錢,以執行個體計費連空檔一起收。
什麼時候改「以執行個體計費」比較划算
把 1 vCPU、512 MiB 每秒的單價算出來比:
- 以請求計費,處理請求的每一秒:0.000024 + 0.5 × 0.0000025 = 0.00002525 美元
- 以執行個體計費,開著的每一秒:0.000018 + 0.5 × 0.000002 = 0.000019 美元
- 0.000019 ÷ 0.00002525 ≈ 75%
意思是:執行個體超過約 75% 的時間都在處理請求(流量穩定、一直有人連),以執行個體計費就比較便宜,再加上它不收請求費,差距會更大。流量忽高忽低、常常沒人,就留在預設的以請求計費。這個分界沒有算免費額度,實際帳單以 Cloud Run 的 Recommender 建議為準:它會看過去一個月的流量,以執行個體計費比較便宜時會提醒你。
數字變大會怎樣:請求從 300 萬次變 3,000 萬次、每次還是 0.2 秒,計費時間變成 600 萬秒,已經超過一個月的 259.2 萬秒。這代表請求一定會同時進來(並行),同一台執行個體同時處理好幾個請求,計費時間只算「至少有一個請求在處理」的時段,不會重複算。這時候執行個體幾乎一直在忙,就該考慮改以執行個體計費。
免費額度是整個帳單帳戶共用,練習用的專案通常整個月都在免費額度內。擔心帳單失控,先照GCP 帳單爆炸防護設好預算提醒。
冷啟動是什麼:縮到零之後,第一個人要多等一下
冷啟動(Cold Start)是 Cloud Run 沒有開著的執行個體時,收到請求才臨時開一台、把容器跑起來,第一個請求因此要多等的那段時間。
- 比喻:早上第一位客人走進還沒開燈的店,店員要先開燈、開咖啡機,才能幫他點餐;後面的客人就不用等
- 來龍去脈:Cloud Run 沒人用時會縮到 0 台,這是它省錢的原因。代價是下一個請求進來時,要重新下載映像檔、啟動容器、等程式開始聽 Port,官方說請求會先在佇列(排隊的隊伍)裡等執行個體開好(2026 年 11 月查官方開發建議)
- 為什麼要學:使用者只會覺得「網站第一次開很慢」。冷啟動實際多久、值不值得花錢消掉,要用數字判斷
Port 是一台機器上區分不同程式的門牌號碼,Cloud Run 預設把請求送到容器的 8080 號門。閒置的執行個體不會馬上關,官方寫最多保留 15 分鐘,以防流量突然回來(2026 年 11 月查自動擴展說明),所以實測要等超過 15 分鐘才量得到冷啟動。
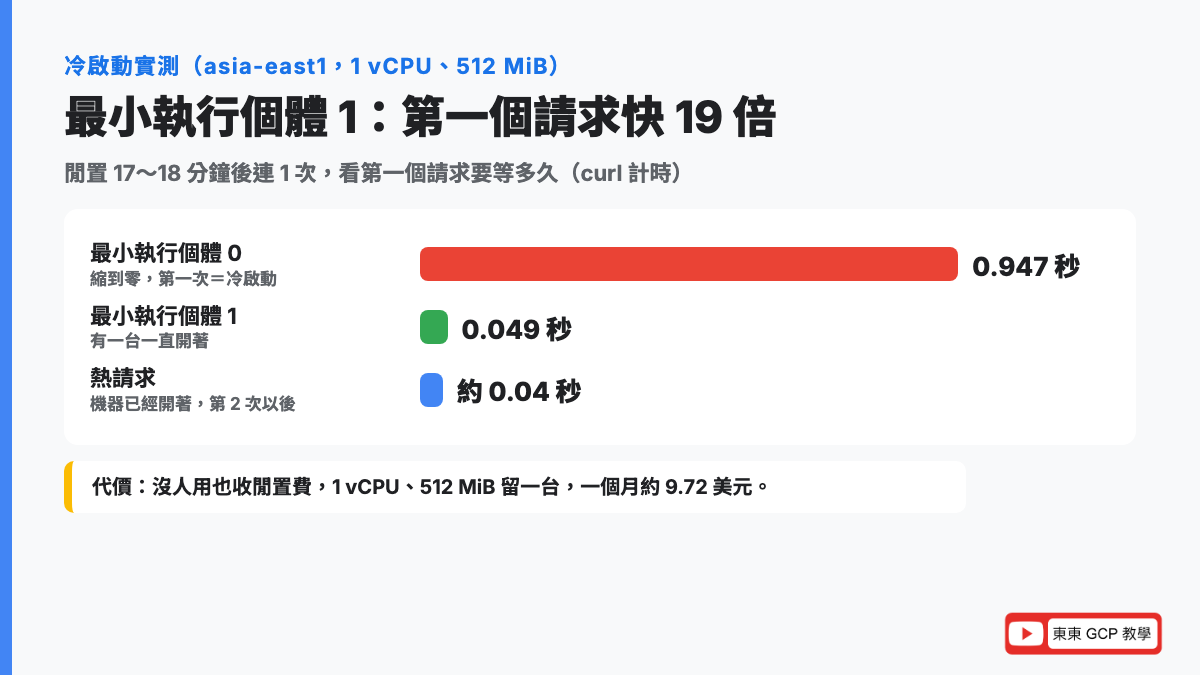
這篇實測:同一個 Python 網頁閒置約 18 分鐘後,第一個請求 0.947 秒,第二個開始約 0.04 秒,冷啟動多了約 0.9 秒。
減少冷啟動的做法(2026 年 11 月查官方文件):
| 做法 | 白話 | 要不要多花錢 |
|---|---|---|
| 最小執行個體 | 讓至少一台一直開著(下一段) | 要,沒人用也收閒置費 |
| 啟動時 CPU 加速(Startup CPU boost) | 開機那段時間暫時多給 CPU,新服務預設就開著 | 多給的 CPU 照啟動時間計費(CPU 設定說明) |
| 程式啟動時少做事 | 用到才連資料庫、才載入大檔案 | 不用 |
最小執行個體是什麼:花錢請一位店員一直顧店
最小執行個體(Minimum instances)是你要求 Cloud Run 不管有沒有人用,都至少保持開著的執行個體數量,設 1 就是永遠至少有一台。
- 比喻:計程車行在車站排一台車隨時待命,客人一到就能上車,不用等車從遠處開過來;但車停著等客人的時間,車行也要付司機錢
- 來龍去脈:Cloud Run 預設最小執行個體是 0,才做得到「沒人用不收錢」。有些服務不能接受第一個人等 1 秒(例如登入頁、付款頁),所以官方提供這個設定,用錢換掉冷啟動
- 為什麼要學:這是 Cloud Run 帳單「沒人用也在收錢」最常見的原因,面試和證照也常考「要避免冷啟動要設什麼」
留一台一個月要多少錢:算一次
以請求計費的服務開了最小執行個體,沒有請求的空檔照「閒置費率」收,比處理請求時便宜(2026 年 11 月查官方定價頁,asia-east1):
- 閒置 CPU:每 vCPU 秒 0.0000025 美元(處理請求時是 0.000024,約十分之一)
- 閒置記憶體:每 GiB 秒 0.0000025 美元
- 1 vCPU、512 MiB 閒置一秒:0.0000025 + 0.5 × 0.0000025 = 0.00000375 美元
- 一個月 30 天 = 259.2 萬秒,259.2 萬 × 0.00000375 = 約 9.72 美元(沒扣免費額度)
數字變大會怎樣:最小執行個體設 3,就是 3 × 9.72 = 約 29.16 美元;規格改成 2 vCPU、1 GiB,每秒閒置費變兩倍,一台一個月約 19.44 美元。如果服務改成「以執行個體計費」,最小執行個體一律照原價收,就是前面算的約 44.03 美元。
新舊設定方式:官方現在建議在服務層級設 gcloud run services update 服務名 --min 1,改了不會產生新的修訂版本。舊的 --min-instances 是修訂版本層級的設定,官方寫只開放給以前就設定過的服務(2026 年 11 月查最小執行個體說明)。
並行數是什麼:一個店員同時招呼幾位客人
並行數(Concurrency)是一台執行個體同時最多處理幾個請求,Cloud Run 用 gcloud 建的新服務預設 80,最多可以設到 1,000。
- 比喻:一個店員同時招呼幾位客人。設 80 是一位店員可以同時顧 80 桌;設 1 是一位店員一次只服務一桌,客人一多就要找更多店員
- 來龍去脈:早期很多無伺服器服務(例如舊版 Cloud Functions)一台只處理一個請求。Cloud Run 一開始就讓一台同時處理多個,等外部 API、等資料庫的空檔可以去接別的請求,機器開得少、錢就省
- 為什麼要學:以請求計費算的是「至少有一個請求在處理」的時間,同時處理 10 個請求,只算一份時間。並行數設太低,同樣的流量要開更多台,冷啟動也變多
並行數預設值:gcloud 和 Terraform 建的新服務是 80 × vCPU 數,Console 建的是 80(2026 年 11 月查並行數說明)。程式本身一次只能做一件事(例如有些舊程式不能同時處理兩個請求),才需要設成 1。
動手做:量冷啟動、最小執行個體和並行數
這段在 Cloud Shell,專案 dong-dong-gcp-3(換成你自己的專案)做。指令本身大約 15 分鐘,但中間要等兩次各 15 分鐘以上讓 Cloud Run 縮到零,整段約 1 小時。用量都在免費額度內;最小執行個體 1 只開 17.5 分鐘,閒置費約 1,053 秒 × 0.00000375 ≈ 0.004 美元,做完照「用完記得刪」清掉。
Cloud Shell 怎麼打開請看第 1 篇的步驟,畫面上方要先選好你的專案。截圖裡的提示字元有縮短,你的畫面會是「你的帳號@cloudshell:~ (你的專案ID)$」。
整篇請在同一個 Cloud Shell 分頁做完,步驟 3、4 存的變數(REPO、URL)關掉分頁就不見了。真的關掉了,重新跑步驟 3 的 REPO=... 那段,再跑一次 URL=$(gcloud run services describe ...) 就能接回來。
步驟 1:確認專案、開啟 API
gcloud config get-value project; gcloud services enable run.googleapis.com artifactregistry.googleapis.com && echo API OKYour active configuration is: [cloudshell-25648]
dong-dong-gcp-3
Operation "operations/acat.p2-600195576280-385046bc-3971-4cdd-976c-3cd673f478ab" finished successfully.
API OK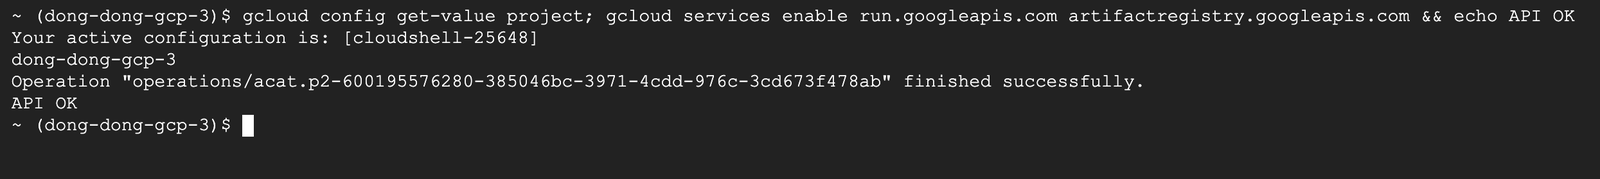
這篇只用兩個服務:Cloud Run(跑服務,第 20 篇)和 Artifact Registry(放映像檔,第 19 篇)。
步驟 2:準備一個會報出「我是哪一台」的程式
這次的程式每次回應都印出兩件事:這台執行個體的代號(啟動時隨機產生 6 個字)和這台已經開了幾秒(uptime)。看到 uptime=0.0s 就代表這個請求是剛開的新機器接的,也就是冷啟動。網址加 ?sleep=2 會讓程式故意等 2 秒再回,模擬比較慢的請求。
用 cat > 檔名 <<'EOF' 一次建好三個檔案(整段複製貼上,按 Enter):
mkdir -p ~/ct-price && cd ~/ct-price
cat > app.py <<'EOF'
import os
import time
import uuid
from flask import Flask, request

STARTED = time.time()
INSTANCE = uuid.uuid4().hex[:6]
app = Flask(__name__)

@app.route("/")
def home():
    time.sleep(float(request.args.get("sleep", "0")))
    uptime = time.time() - STARTED
    return f"instance={INSTANCE} uptime={uptime:.1f}s"

if __name__ == "__main__":
    port = int(os.environ.get("PORT", 8080))
    app.run(host="0.0.0.0", port=port)
EOF
cat > requirements.txt <<'EOF'
flask==3.1.3
EOF
cat > Dockerfile <<'EOF'
FROM python:3.14-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY app.py .
EXPOSE 8080
CMD ["python", "app.py"]
EOF
ls
app.py Dockerfile requirements.txt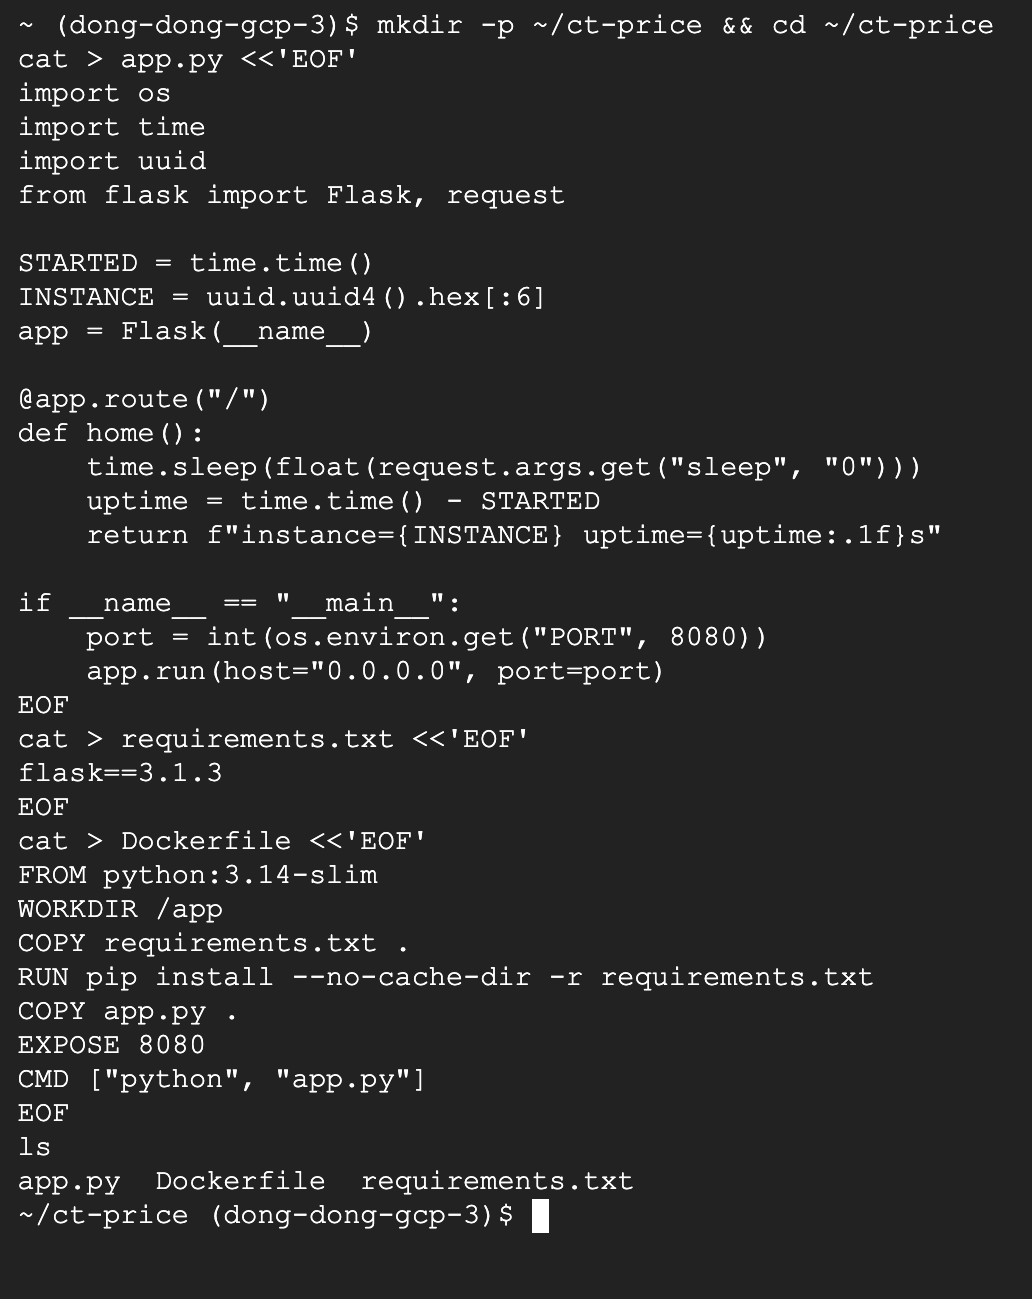
STARTED、INSTANCE寫在函式外面,只在容器啟動時執行一次,所以同一台機器的代號不會變- Dockerfile 跟第 4 篇一樣,只是程式換了
步驟 3:建存放區、建映像檔並推上去
gcloud artifacts repositories create ct-demo --repository-format=docker --location=asia-east1 2>&1 | tail -1; REPO=asia-east1-docker.pkg.dev/$(gcloud config get-value project 2>/dev/null)/ct-demo; docker build -q -t $REPO/ct-cold:v1 . && docker push -q $REPO/ct-cold:v1Created repository [ct-demo].
sha256:1dc700c115044481bf14d9af7040136e7e7743e671345a9e018a1a954c354ce9
asia-east1-docker.pkg.dev/dong-dong-gcp-3/ct-demo/ct-cold:v1
-q是安靜模式,只印出結果,不印每一層的進度- 存放區、
docker push的細節在第 19 篇 Artifact Registry
步驟 4:部署成 Cloud Run 服務,計時
time gcloud run deploy ct-cold --image=$REPO/ct-cold:v1 --region=asia-east1 --allow-unauthenticated; URL=$(gcloud run services describe ct-cold --region=asia-east1 --format='value(status.url)'); echo $URLDeploying container to Cloud Run service [ct-cold] in project [dong-dong-gcp-3] region [asia-east1]
Deploying new service...
Setting IAM Policy............done
Creating Revision................................................................done
Routing traffic.....done
Done.
Service [ct-cold] revision [ct-cold-00001-l9r] has been deployed and is serving 100 percent of traffic.
Service URL: https://ct-cold-600195576280.asia-east1.run.app
real 0m9.389s
user 0m0.985s
sys 0m0.127s
https://ct-cold-b5j2wtbgca-de.a.run.app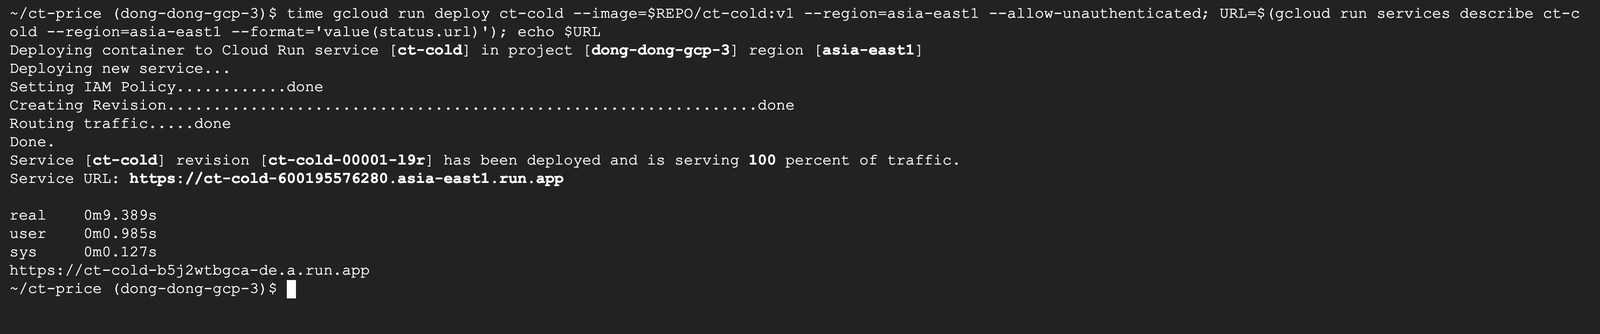
time放在指令前面,會在最後印出花了多久,real是實際經過的時間:9.4 秒--allow-unauthenticated讓任何人都能連,方便用curl測;練習完一定要刪- 同一個服務有兩個網址都能用,
URL存的是比較短的那個,第 20 篇有說明
步驟 5:看 Cloud Run 幫你設了哪些預設值
gcloud run services describe ct-cold --region=asia-east1 --format=export | grep -E 'Scale|throttling|cpu-boost|containerConcurrency|cpu:|memory:' run.googleapis.com/maxScale: '20'
run.googleapis.com/startup-cpu-boost: 'true'
containerConcurrency: 80
cpu: 1000m
memory: 512Mi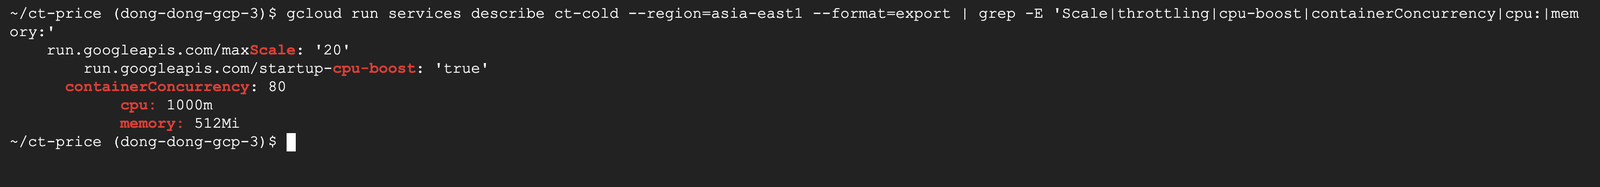
| 設定 | 值 | 白話 |
|---|---|---|
maxScale | 20 | 最多開到 20 台,也是帳單的上限保險 |
startup-cpu-boost | true | 啟動時 CPU 加速,預設就開著 |
containerConcurrency | 80 | 並行數,一台同時最多接 80 個請求 |
cpu | 1000m | 1 vCPU(1000m 就是 1,000 毫顆 = 1 顆) |
memory | 512Mi | 512 MiB 記憶體 |
沒有 cpu-throttling 那一行,代表用的是預設的以請求計費;官方文件寫,這個值是 false 才是以執行個體計費(2026 年 11 月查計費設定說明)。沒有 minScale 這一行,代表最小執行個體是 0。
步驟 6:剛部署完連 5 次
date +%T; for i in 1 2 3 4 5; do curl -s "$URL" -w " total=%{time_total}s\n"; done18:29:28
instance=150193 uptime=19.8s total=0.354006s
instance=150193 uptime=19.8s total=0.037959s
instance=150193 uptime=19.9s total=0.039439s
instance=150193 uptime=19.9s total=0.039722s
instance=150193 uptime=20.0s total=0.036656s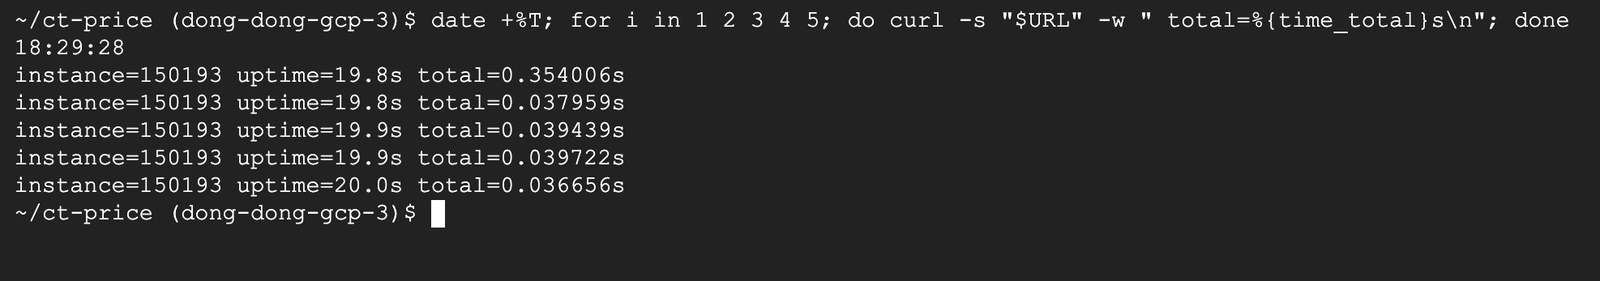
-w " total=%{time_total}s\n"讓 curl 印出這次請求從送出到收完花了幾秒- 第一個請求 0.354 秒,比後面慢,但不是冷啟動:
uptime=19.8s代表這台已經開了快 20 秒,是部署時開的那台還留著 - 第二次開始約 0.04 秒,這就是「熱請求」的速度
步驟 7:並行數 80,10 個請求同時進來
xargs -P10 讓 10 個 curl 同時送出,每個都帶 ?sleep=2(程式等 2 秒才回):
seq 10 | xargs -P10 -I{} sh -c 'r=$(curl -s "$0/?sleep=2" -w " total=%{time_total}s"); echo "$r"' "$URL" | tee burst.txt; echo "instances: $(cut -d' ' -f1 burst.txt | sort -u | wc -l)"instance=150193 uptime=31.4s total=2.063390s
instance=150193 uptime=31.4s total=2.059484s
instance=150193 uptime=31.4s total=2.072556s
instance=150193 uptime=31.4s total=2.082408s
instance=150193 uptime=31.4s total=2.098547s
instance=150193 uptime=31.4s total=2.087602s
instance=150193 uptime=31.4s total=2.089926s
instance=150193 uptime=36.4s total=7.057672s
instance=150193 uptime=36.4s total=7.056100s
instance=150193 uptime=41.4s total=12.050772s
instances: 1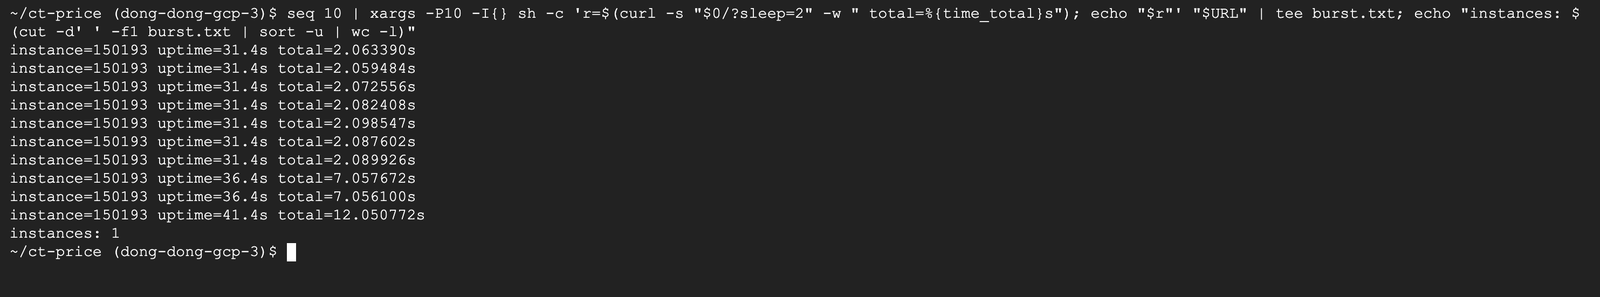
- 10 個請求全部由同一台(150193)處理,Cloud Run 沒有多開機器
- 以請求計費算的是「這台至少有一個請求在處理」的時間,大約 12 秒,不是 10 × 2 = 20 秒
- 有 3 個請求比預期多等了 5~10 秒,原因寫在後面的「實測時的意外」
步驟 8:把並行數改成 1
gcloud run services update ct-cold --region=asia-east1 --concurrency=1 2>&1 | tail -3Done.
Service [ct-cold] revision [ct-cold-00002-zzb] has been deployed and is serving 100 percent of traffic.
Service URL: https://ct-cold-600195576280.asia-east1.run.app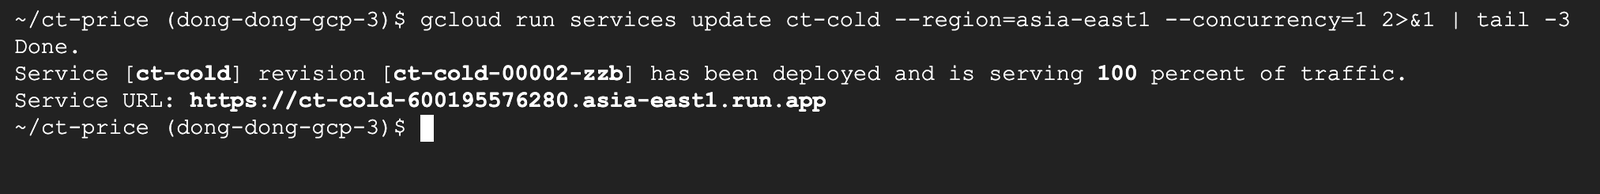
改並行數會產生新的修訂版本(revision,第 20 篇講過,每次改設定就存一個新版本),從 00001 變 00002。
步驟 9:等 15 分鐘以上,量冷啟動
先什麼都不要做,等 15 分鐘以上(這次等了約 18 分鐘),讓 Cloud Run 把閒置的執行個體全部關掉。時間到了再連 5 次:
date +%T; for i in 1 2 3 4 5; do curl -s "$URL" -w " total=%{time_total}s\n"; done18:49:05
instance=0028ad uptime=0.0s total=0.947167s
instance=0028ad uptime=0.1s total=0.041193s
instance=0028ad uptime=0.2s total=0.044459s
instance=0028ad uptime=0.2s total=0.043134s
instance=0028ad uptime=0.3s total=0.058635s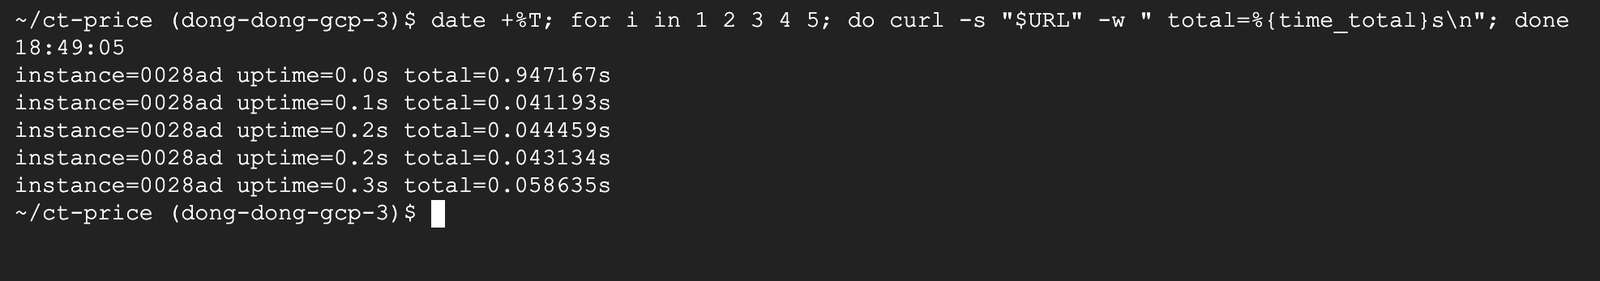
- 執行個體代號從 150193 變成 0028ad,而且
uptime=0.0s:這台是被第一個請求叫醒、剛開好的 - 第一個請求 0.947 秒,第二個 0.041 秒,冷啟動多花了約 0.9 秒
- 這個程式很小(Flask 一個檔案),程式越大、啟動時做的事越多,冷啟動越久
步驟 10:並行數 1,同樣 10 個請求同時進來
seq 10 | xargs -P10 -I{} sh -c 'r=$(curl -s "$0/?sleep=2" -w " code=%{http_code} total=%{time_total}s"); echo "$r"' "$URL" | tee burst.txt; echo "instances: $(grep -o 'instance=[0-9a-f]*' burst.txt | sort -u | wc -l)"instance=0028ad uptime=13.5s code=200 total=2.061942s
instance=75bf87 uptime=2.1s code=200 total=2.806530s
instance=81e502 uptime=2.0s code=200 total=3.281503s
instance=6efb57 uptime=2.0s code=200 total=3.291971s
instance=9dc8c3 uptime=2.1s code=200 total=3.303346s
instance=0028ad uptime=18.4s code=200 total=7.041029s
instance=81e502 uptime=5.8s code=200 total=7.044610s
code=000 total=9.787581s
instance=0028ad uptime=23.4s code=200 total=12.047013s
instance=0028ad uptime=28.5s code=200 total=17.054133s
instances: 5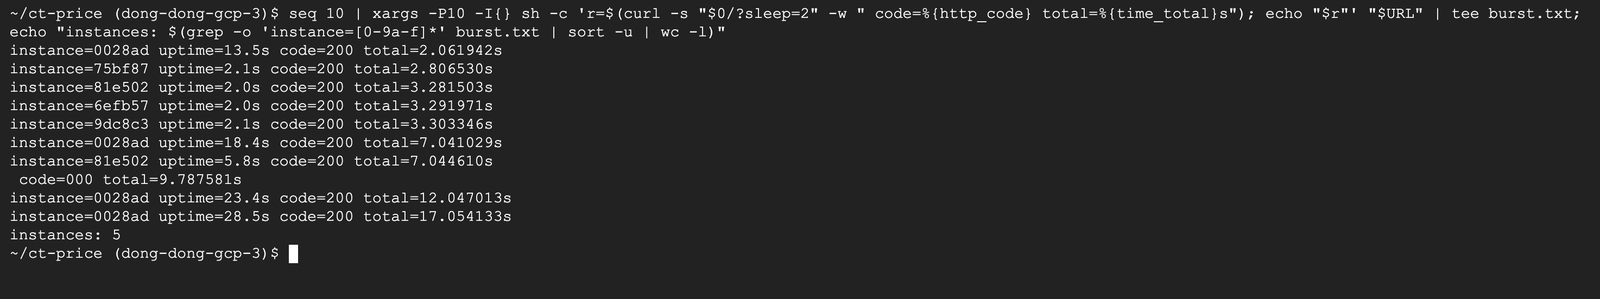
- 這次加了
code=%{http_code},印出 HTTP 狀態碼:200是成功 - 同樣 10 個請求,並行數 1 開了 5 台,並行數 80 只開 1 台。5 台各自計費,還多了 4 次冷啟動
- 新開的 4 台(uptime 約 2 秒)花 2.81~3.30 秒,扣掉程式本身的 2 秒,擴展時新開執行個體多花 0.81~1.30 秒
- 有 1 個請求
code=000:curl 在 9.8 秒時沒有收到任何回應,原因寫在「實測時的意外」
步驟 11:開最小執行個體 1
gcloud run services update ct-cold --region=asia-east1 --min=1 2>&1 | tail -3; gcloud run services describe ct-cold --region=asia-east1 --format=export | grep -E 'Scale'; date +%TUpdating...
Done.
Service [ct-cold] has been updated.
run.googleapis.com/maxScale: '20'
run.googleapis.com/minScale: '1'
18:49:44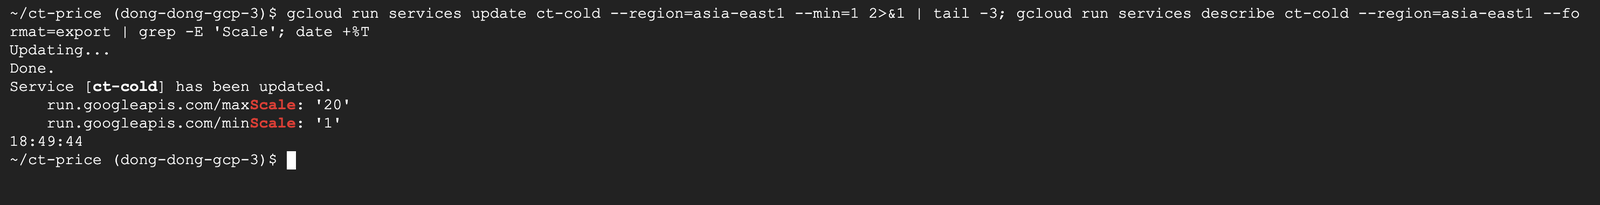
--min=1是服務層級的最小執行個體,輸出只有Service [ct-cold] has been updated.,沒有產生新的修訂版本(步驟 8 改並行數就有)- 設定裡多了
minScale: '1'。從這一刻起,沒人用也開始收閒置費,記下時間 18:49:44
步驟 12:再等 15 分鐘以上,看還有沒有冷啟動
一樣等 15 分鐘以上不要碰(這次等了約 17 分鐘),再連 5 次:
date +%T; for i in 1 2 3 4 5; do curl -s "$URL" -w " total=%{time_total}s\n"; done19:06:35
instance=0028ad uptime=1048.7s total=0.048645s
instance=0028ad uptime=1048.7s total=0.035909s
instance=0028ad uptime=1048.8s total=0.038860s
instance=0028ad uptime=1048.8s total=0.036699s
instance=0028ad uptime=1048.9s total=0.040774s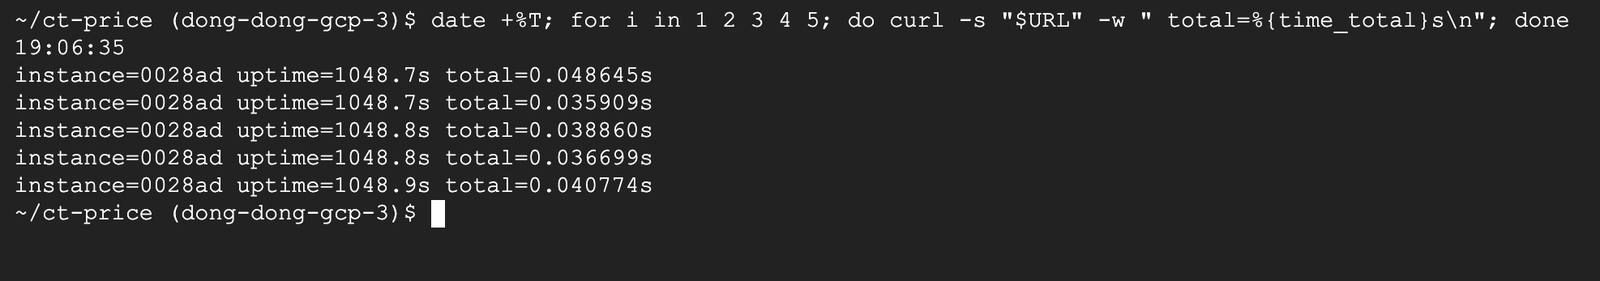
- 還是同一台 0028ad,
uptime=1048.7s(開了 17 分半),這段時間它沒被關掉 - 第一個請求 0.049 秒,跟熱請求差不多,冷啟動不見了
- 對照步驟 9:0.947 秒變 0.049 秒,快了約 19 倍;代價是這 17 分鐘都在收閒置費
步驟 13:最小執行個體改回 0
測完馬上改回來,不然會一直收閒置費:
gcloud run services update ct-cold --region=asia-east1 --min=0 2>&1 | tail -2; date +%TDone.
Service [ct-cold] has been updated.
19:07:17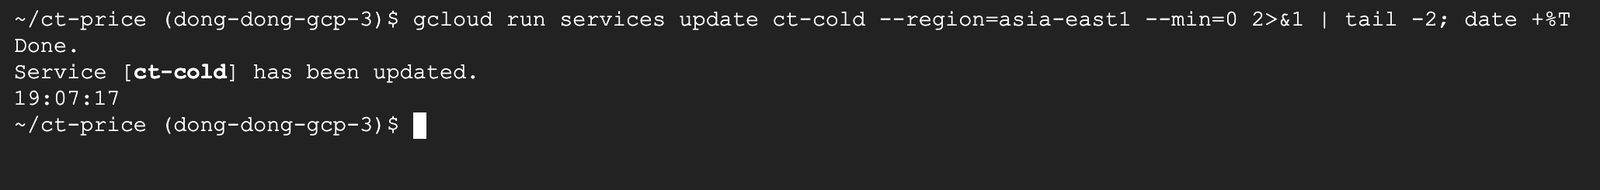
最小執行個體 1 從 18:49:44 開到 19:07:17,共 1,053 秒(約 17.5 分鐘),閒置費 1,053 × 0.00000375 ≈ 0.004 美元。照這個速度開一整個月,就是前面算的約 9.72 美元。
實測時的意外
1. 剛部署完的第一個請求不是冷啟動
一般以為「部署完第一個請求一定是冷啟動」,但步驟 6 的第一個請求 uptime=19.8s。官方文件寫,部署新修訂版本時,Cloud Run 會先開好足夠的執行個體,再把流量導過去(2026 年 11 月查自動擴展說明)。要量冷啟動,一定要等閒置超過 15 分鐘,並用 uptime=0.0s 確認是新機器。
2. 並行數 80,還是有 3 個請求多等了 5~10 秒
步驟 7 的 10 個請求都是同一台處理,7 個約 2.06 秒,但有 2 個 7.06 秒、1 個 12.05 秒。同一個映像檔在 Cloud Shell 本機用 docker run 跑,同時 10 個請求全部 2.01 秒,所以不是 Flask 程式本身排隊。
官方文件寫 Cloud Run 有「自動調整並行數」(Adaptive concurrency tuning),一台實際同時接的請求數會依 CPU 使用率動態調整,不一定等於設定的 80;系統也會先判斷「排隊等現有執行個體」會不會比開新機器快(2026 年 11 月查自動擴展說明)。這可能是原因之一,但官方沒有能直接對照的數字,這裡只記錄現象。
另外,Flask 官方文件寫內建伺服器只適合開發,正式上線建議改用 Gunicorn 這類正式的網頁伺服器;這篇為了程式簡單沿用內建伺服器。
3. 並行數 1 時,有請求在 9.8 秒時拿不到回應
步驟 10 有 1 個請求 code=000。在這之前還測過一次(那次沒印狀態碼),有 3 個請求在 9.8、14.8、19.8 秒結束時沒有回傳任何內容。官方文件寫:等執行個體開好的請求,最多在佇列裡等 10 秒或平均啟動時間的 3.5 倍(取比較大的)(2026 年 11 月查官方開發建議)。
9.8 秒跟 10 秒的上限對得上:並行數 1 時同時進來太多請求,有的排隊等不到機器就被放棄了。實務上的意思是:並行數不要隨便設 1,除非程式真的不能同時處理兩個請求;真的要設 1,就搭配最小執行個體,讓幾台先開著。
4. --min 改設定不會產生新修訂版本
步驟 8 改並行數,修訂版本從 00001 變 00002;步驟 11 用 --min=1,輸出只有 Service [ct-cold] has been updated.,沒有新版本。這是官方說的「服務層級」設定,跟舊教學常見的 --min-instances(修訂版本層級)不一樣。
用完記得刪
先刪 Cloud Run 服務(所有修訂版本一起刪):
gcloud run services delete ct-cold --region=asia-east1 --quietDeleting [ct-cold]...
..done.
Deleted service [ct-cold].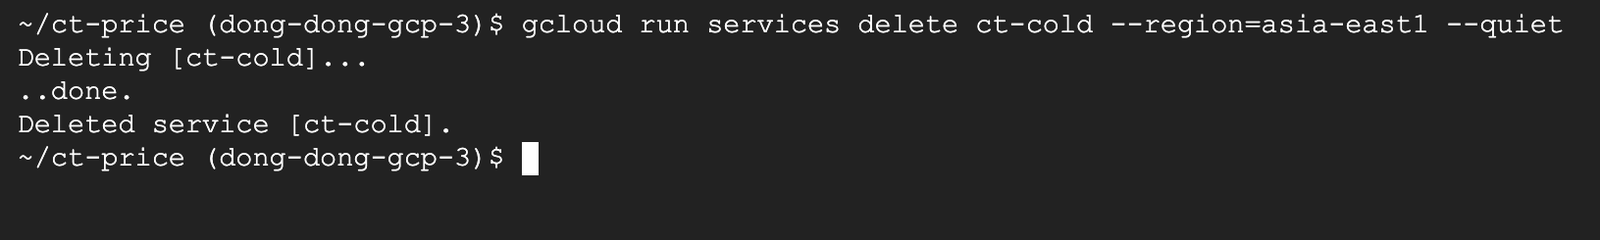
再刪存放區、Cloud Shell 裡的映像檔和資料夾:
gcloud artifacts repositories delete ct-demo --location=asia-east1 --quiet; docker rmi $REPO/ct-cold:v1 >/dev/null; cd ~ && rm -rf ~/ct-price; echo cleanedDelete request issued for: [ct-demo]
Waiting for operation [projects/dong-dong-gcp-3/locations/asia-east1/operations/65a6db27-c40d-4691-be34-1656bea70702] to complete...
.done.
Deleted repository [ct-demo].
cleaned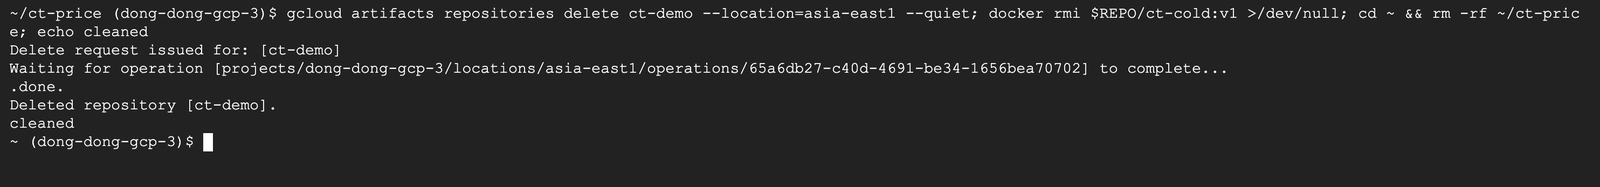
不刪會怎麼計費:最小執行個體改回 0 之後,Cloud Run 服務沒人連就不收運算費;存放區裡的映像檔在 Artifact Registry 每月 0.5 GiB 免費額度內。最要小心的是忘了把最小執行個體改回 0:1 vCPU、512 MiB 留一台,一個月約 9.72 美元,設了好幾台或規格比較大,就是好幾倍。
省錢檢查清單
| 檢查 | 怎麼看 | 為什麼 |
|---|---|---|
| 最小執行個體是不是 0 | describe 有沒有 minScale | 不是 0 就一直收閒置費 |
| 計費方式 | describe 有沒有 cpu-throttling: 'false' | 有的話是以執行個體計費,開著就收全額 |
| 最大執行個體 | maxScale | 被大量請求灌爆時,帳單的上限保險 |
| 並行數 | containerConcurrency | 設太低,同樣流量要多開好幾台 |
| 公開存取 | 有沒有用 --allow-unauthenticated | 被不認識的人一直打也會計費;官方說被 IAM 擋下的請求不收費 |
| 區域 | 選第 1 級(asia-east1) | 同樣用量,第 2 級比較貴 |
面試/證照會怎麼問
面試常見題
- 「Cloud Run 怎麼收費?」:預設以請求計費,只算處理請求時的 vCPU 秒、GiB 秒,加上每 100 萬次請求 0.40 美元,每月有免費額度;計費時間以 100 毫秒為單位
- 「流量很穩定,Cloud Run 要怎麼省?」:執行個體大部分時間都在處理請求時(約 75% 以上),改以執行個體計費(
--no-cpu-throttling),單價低又不收請求費;Cloud Run 的 Recommender 也會建議 - 「怎麼避免冷啟動?」:設最小執行個體(
--min 1),搭配啟動時 CPU 加速、程式啟動時少做事;要說得出代價:最小執行個體沒人用也收閒置費 - 「並行數是什麼?設 1 有什麼問題?」:一台同時處理幾個請求;設 1 同樣流量要開更多台、冷啟動更多,這篇實測 10 個請求從 1 台變 5 台,還有請求等不到
Google Cloud 證照(ACE、PCA)
Associate Cloud Engineer:報名費 125 美元、2 小時、50~60 題單選和複選、效期 3 年(2026 年 11 月查官方考試頁),是情境選擇題,不是上機考。Professional Cloud Architect 的準備方式可以看雲端架構師證照怎麼準備。
看到這些字,就想到這個
| 題目關鍵字 | 想到 |
|---|---|
| 「流量少、偶爾有人用」「沒人用不想付錢」 | Cloud Run 預設:以請求計費+最小執行個體 0 |
| 「第一個請求很慢」「要降低延遲」「不能有冷啟動」 | 最小執行個體(--min)、啟動時 CPU 加速 |
| 「沒有請求時也要在背景處理工作」 | 以執行個體計費(--no-cpu-throttling),或最小執行個體至少 1 |
| 「流量穩定、一直有人用」「成本最佳化」 | 以執行個體計費、承諾使用折扣 |
| 「避免流量暴增時帳單失控」 | 設最大執行個體數、預算提醒 |
| 「程式一次只能處理一個請求」 | 並行數設 1 |
常見問答
Cloud Run 收費怎麼算?
預設以請求計費:只在處理請求時算 vCPU 秒和 GiB 秒,台灣 asia-east1 每 vCPU 秒 0.000024 美元、每 GiB 秒 0.0000025 美元,另外每 100 萬次請求 0.40 美元,計費時間以 100 毫秒為單位無條件進位(2026 年 11 月查官方定價頁)。1 vCPU、512 MiB、一個月 300 萬次請求、每次 0.2 秒,約 10.48 美元。
Cloud Run 免費額度有多少?
以請求計費每月免費 18 萬 vCPU 秒、36 萬 GiB 秒、200 萬次請求;以執行個體計費每月免費 24 萬 vCPU 秒、45 萬 GiB 秒(2026 年 11 月查官方定價頁)。免費額度以帳單帳戶為單位,同一個帳單帳戶的所有專案共用,每月重置。
以請求計費和以執行個體計費怎麼選?
流量忽高忽低、常常沒人用,選預設的以請求計費;執行個體約 75% 以上的時間都在處理請求,或沒有請求時也要跑背景工作,選以執行個體計費。以 1 vCPU、512 MiB 算,以請求計費每秒 0.00002525 美元,以執行個體計費每秒 0.000019 美元且不收請求費。
CPU always allocated 是什麼?現在叫什麼?
CPU always allocated(CPU 一直分配)是以執行個體計費的舊名稱,CPU only allocated during request processing(只在處理請求時分配 CPU)是以請求計費的舊名稱。官方改名了,gcloud 參數沒改:以執行個體計費用 --no-cpu-throttling,以請求計費用 --cpu-throttling。
Cloud Run 冷啟動要多久?怎麼減少?
看程式大小和啟動時做的事。這篇的 Python Flask 小程式在 asia-east1 實測,閒置約 18 分鐘後第一個請求 0.947 秒、熱請求約 0.04 秒;擴展時新開的執行個體多花 0.81~1.30 秒。減少冷啟動可以設最小執行個體、開啟動時 CPU 加速(新服務預設已開)、讓程式啟動時少做事。
Cloud Run 最小執行個體一個月多少錢?
以請求計費時,最小執行個體沒有請求的時間照閒置費率收,asia-east1 每 vCPU 秒和每 GiB 秒都是 0.0000025 美元。1 vCPU、512 MiB 留一台,一個月約 259.2 萬秒 × 0.00000375 = 約 9.72 美元(2026 年 11 月單價,沒扣免費額度)。以執行個體計費時一律原價。
Cloud Run 並行數要設多少?
先用預設值:gcloud 建的服務是 80 × vCPU 數,最多可設 1,000。並行數越高,同樣流量開的機器越少、越省錢;只有程式真的不能同時處理兩個請求才設 1。實測 10 個同時請求,並行數 80 開 1 台,並行數 1 開 5 台,還有 1 個請求在 9.8 秒時拿不到回應。
重點整理
- Cloud Run pricing 預設是以請求計費:只算處理請求時的 vCPU 秒、GiB 秒,加每 100 萬次請求 0.40 美元,每月有免費額度;台灣 asia-east1 是比較便宜的第 1 級
- 兩種計費的分界約 75%:執行個體大部分時間都在忙,改以執行個體計費(舊名 CPU always allocated);例子中 300 萬次請求,以請求計費約 10.48 美元、以執行個體計費約 44.03 美元
- 冷啟動實測約 0.9 秒:縮到零後第一個請求 0.947 秒、熱請求約 0.04 秒;最小執行個體 1 時第一個請求 0.049 秒
- 最小執行個體是用錢換速度:1 vCPU、512 MiB 留一台一個月約 9.72 美元,用
--min在服務層級設定,測完記得改回 0 - 並行數不要隨便設 1:同樣 10 個請求,並行數 80 開 1 台,並行數 1 開 5 台,還有請求排隊超過 10 秒被放棄
延伸閱讀
本系列
- 第 1 篇:Docker 入門教學:不用安裝,用 Cloud Shell 跑出第一個容器
- 第 4 篇:Dockerfile 怎麼寫?從零打包你的第一個網頁映像檔
- 第 17 篇:健康檢查與自動擴展:Probe、資源限制、HPA
- 第 19 篇:Artifact Registry 是什麼?把 Docker 映像檔推上 GCP 教學
- 第 20 篇:Cloud Run 是什麼?Cloud Run 教學:部署容器、版本與流量分割
- 上一篇:第 21 篇:Cloud Build 是什麼?用 cloudbuild.yaml 自動建映像檔、部署到 Cloud Run
- 下一篇:第 23 篇:Cloud Run Jobs 是什麼?服務、Jobs、functions 差在哪、怎麼選
Cloud Run、收費相關
站上相關文章
帳單算清楚了,下一篇比較 Cloud Run 的服務、Jobs 和 functions,看什麼工作該交給哪一種。可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。