GKE 部署怎麼做?映像檔推上 Artifact Registry,寫好 requests 部署,Gateway 對外、HPA 擴展。
第 10~18 篇在 Cloud Shell 用 Minikube 把 Kubernetes(K8s)練了一輪,用的都是 Docker Hub 上現成的 nginx;第 24 篇建好了一個 GKE Autopilot 叢集。這篇把兩邊接起來,把自己寫的程式部署到 GKE:從原始碼一路走到「全世界打得到的網址」,再讓它在流量變大時自動多開 Pod。
這篇用的是第 4 篇那支 Flask 小網站。整條路線會實際跑一次並計時:Cloud Build 建映像檔、推上 Artifact Registry、Deployment 寫好資源要求、先用 LoadBalancer Service 對外、再換成 GKE 預裝的 Gateway API、最後開 HPA 用壓力測試讓它真的擴展。每一段都對照「在 Minikube 怎麼做、在 GKE 有什麼不一樣」。
這是「容器系列」第 25 篇。全部在 Cloud Shell 實際跑過,輸出都是真實結果(2026 年 11 月實測,GKE 1.36.4、Google Cloud SDK 592.0.0)。價格、版本是 2026 年 11 月查官方文件的數字,以後可能調整。
為什麼你需要知道
- 練習和上線中間差一段路:Minikube 篇用的是 Docker Hub 現成映像檔、
minikube tunnel臨時拿 IP;公司真的要上線,映像檔要放自己的私人倉庫、網址要真的對外、流量大時要自動加 Pod - 照抄 Minikube 的 YAML 會多付錢:GKE Autopilot 照 Pod 的資源要求(requests)收錢,第 24 篇實測沒寫會被補成 0.5 vCPU、2 GiB,這篇算給你看寫跟不寫差多少
- Ingress 正在換成 Gateway API:第 14 篇提過 ingress-nginx 在 2026 年 3 月退場、Ingress API 凍結;GKE 叢集一建好就預裝了 Gateway 要用的 GatewayClass,新專案直接用 Gateway
- 面試和證照常考:「怎麼把容器部署到 GKE」「怎麼讓它自動擴展」「LoadBalancer 和 Ingress、Gateway 怎麼選」,ACE、PCA 的情境題都會出
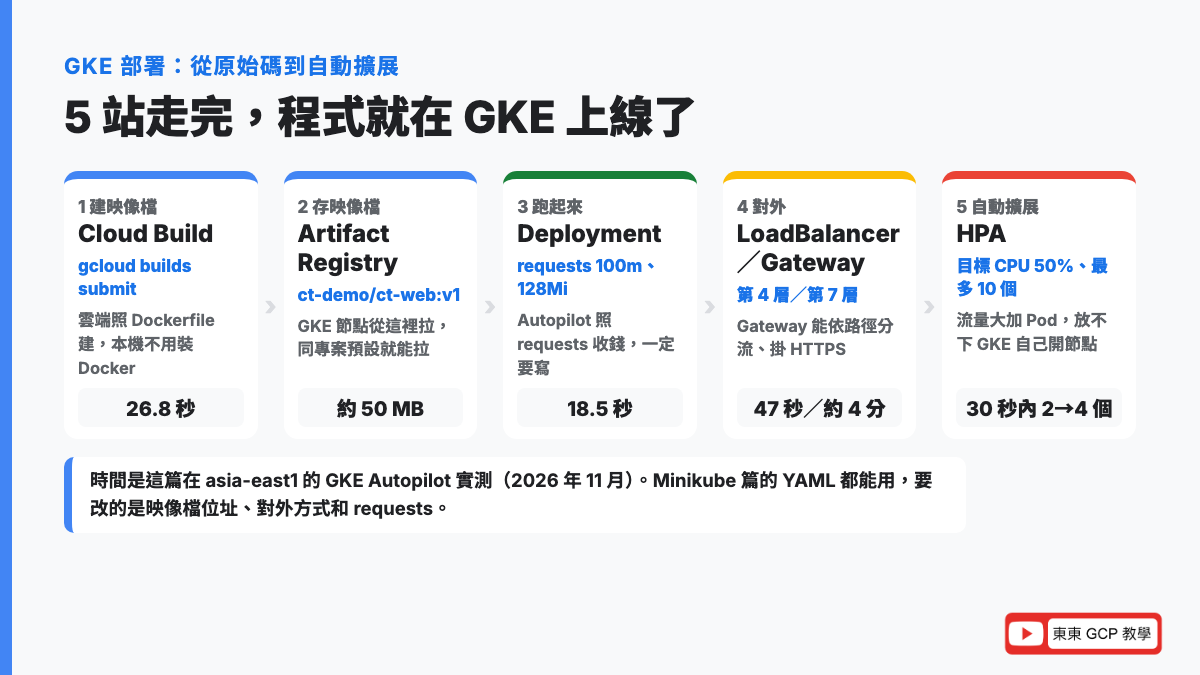
整條路線:從程式到 GKE 上線的 5 站
這 5 站在本系列第 12~21 篇都各自教過,這篇是第一次把它們串在同一個叢集上:
| 站 | 用什麼 | 哪一篇教過 | 搬到 GKE 要注意的 |
|---|---|---|---|
| 1. 建映像檔 | Cloud Build | 第 21 篇 | 不用在自己電腦裝 Docker,雲端建完直接推 |
| 2. 存映像檔 | Artifact Registry | 第 19 篇 | GKE 節點從這裡拉,同一個專案預設就有權限 |
| 3. 跑起來 | Deployment | 第 12 篇 | Autopilot 一定要寫 requests |
| 4. 對外 | LoadBalancer Service、Gateway | 第 13、14 篇 | 拿到真的公開 IP,不用 minikube tunnel |
| 5. 自動擴展 | HPA | 第 17 篇 | 指標內建;Pod 放不下時 GKE 自己開節點 |
映像檔(Image)是「把程式和它需要的環境打包好的檔案」,Pod 是 K8s 裡跑容器的最小單位,第 3、11 篇有完整說明。Artifact Registry 是 Google Cloud 的私人映像檔倉庫,第 19 篇建過;Cloud Build 是在雲端幫你執行 docker build 的服務,第 21 篇用過。
Gateway API 是什麼:K8s 新一代的「大門管理」
Gateway API 是 Kubernetes 用來描述「外面的流量怎麼進到叢集」的新標準,取代 Ingress;在 GKE 上建一個 Gateway,GKE 就幫你建一台 Google Cloud 的應用程式負載平衡器。
- 比喻:辦公大樓的大門。GatewayClass 是物業公司提供的「門的款式」(自動門、旋轉門),Gateway 是你實際裝在大樓的那一扇門(有自己的地址),HTTPRoute 是門口的指示牌(「找 ct-web 往這邊走」)
- 來龍去脈:舊的 Ingress 把「門」和「指示牌」寫在同一個 YAML,各家的特殊功能只能塞在註解(annotation)裡,越寫越亂。Gateway API 把它拆成三層,2023 年推出正式版 v1.0;第 14 篇提過 Ingress API 已經凍結、不再加新功能
- 為什麼要學:GKE 已經預裝好 GatewayClass,新專案要用網址、路徑分流、掛 HTTPS 憑證,都會走 Gateway。只會 Ingress 的話,看新文件和新專案會卡住
負載平衡器(Load Balancer)是把進來的流量分給後面好幾台機器的服務,像餐廳門口的帶位員。
GKE 預裝的 GatewayClass,這篇選哪一個
第 24 篇建叢集時,事件裡就出現了 gke-l7- 開頭的 GatewayClass。主要的 4 個(2026 年 11 月查官方 Gateway API 說明和部署 Gateway 說明):
| GatewayClass | 建出來的負載平衡器 | 要不要先建 proxy-only 子網路 |
|---|---|---|
gke-l7-global-external-managed | 全球外部應用程式負載平衡器 | 不用(這篇用這個) |
gke-l7-regional-external-managed | 區域外部應用程式負載平衡器 | 要 |
gke-l7-rilb | 內部應用程式負載平衡器(只給 VPC 裡面連) | 要 |
gke-l7-gxlb | 傳統版(classic)全球外部負載平衡器 | 不用,但官方建議改用第一個 |
proxy-only 子網路(Proxy-only subnet)是一段專門保留給負載平衡器代理程式用的內部 IP 範圍,要在 VPC 網路裡另外建,區域型的負載平衡器才有地方放代理(官方說明)。這篇的專案不動網路設定,所以選不用建子網路的全球型。
全球型用的是 Anycast IP:同一個 IP 在全世界的 Google 機房都有人接,使用者會被導到最近的入口,再走 Google 自己的網路到台灣的叢集。
LoadBalancer Service 和 Gateway 差在哪
| LoadBalancer Service(第 13 篇) | Gateway(這篇用 gke-l7-global-external-managed) | |
|---|---|---|
| 建出來的負載平衡器 | 外部直通式網路負載平衡器 | 全球外部應用程式負載平衡器 |
| 看什麼分流 | 第 4 層:只看 IP 和 Port | 第 7 層:看網址、路徑、Header |
| 對外 IP | 區域 IP(asia-east1) | 全球 Anycast IP |
| 一個 IP 掛幾個服務 | 一個 Service 一個 IP | 多個 HTTPRoute 共用一個 Gateway |
| HTTPS 憑證 | 要自己在容器裡處理 | 可以掛在 Gateway 上 |
| 這篇實測多久能連 | 46.7 秒拿到 IP,馬上能連 | 1 分 37 秒拿到 IP,再等 141 秒才回 200 |
第 4 層、第 7 層指的是網路分層模型的層數:第 4 層只知道「送到哪個 IP 的哪個 Port」,第 7 層看得懂 HTTP 的內容(網址、路徑),所以才能做「/api 給 A 服務、/shop 給 B 服務」這種分流。只有一個服務、不需要路徑分流時,LoadBalancer Service 最快最簡單。
算一次:requests 寫不寫,帳單差多少
Autopilot 一般用途的 Pod 照 Pod 宣告的資源要求(Resource requests)計費,CPU、記憶體、暫存空間各算各的。資源要求是 Pod 告訴 K8s「我至少需要多少」,100m 是 0.1 顆 vCPU,128Mi 是 128 MiB 記憶體(第 17 篇有單位換算)。台灣 asia-east1 的單價(2026 年 11 月用 Cloud Billing Catalog API 查,第 24 篇同一組):
| 項目 | 每小時單價(asia-east1) |
|---|---|
| CPU | 每 vCPU 0.0515 美元 |
| 記憶體 | 每 GiB 0.0056998 美元 |
| 暫存空間 | 每 GiB 0.0001608 美元 |
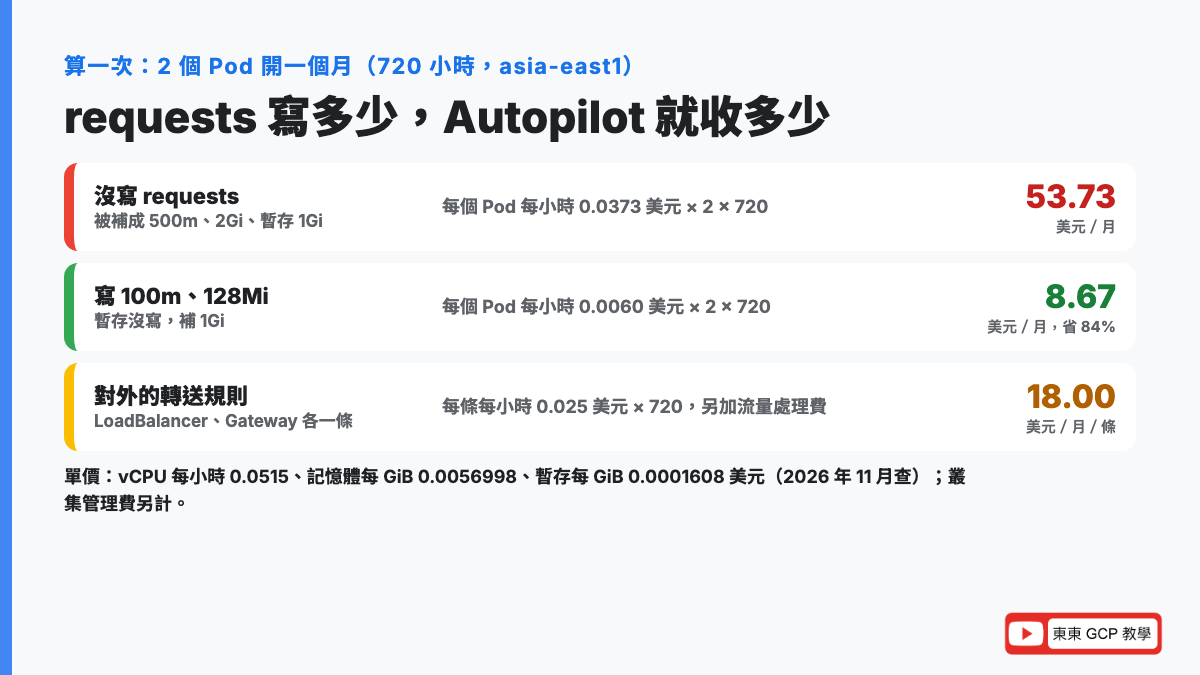
假設:跟這篇實作一樣,平常跑 2 個 Pod,一個月 30 天(720 小時)一直開著。
情況 A:沒寫 requests(Autopilot 補 0.5 vCPU、2 GiB、暫存 1 GiB)
- 每個 Pod 每小時:0.5 × 0.0515 + 2 × 0.0056998 + 1 × 0.0001608 = 0.0373104 美元
- 2 個 Pod 一個月:0.0373104 × 2 × 720 = 約 53.73 美元
情況 B:寫 100m CPU、128Mi 記憶體(這篇的設定;暫存沒寫,補 1 GiB)
- 每個 Pod 每小時:0.1 × 0.0515 + 0.125 × 0.0056998 + 1 × 0.0001608 = 0.00515 + 0.000712475 + 0.0001608 = 0.006023275 美元
- 2 個 Pod 一個月:0.006023275 × 2 × 720 = 約 8.67 美元,比情況 A 少約 84%
對外還要加轉送規則:負載平衡器的轉送規則(Forwarding rule,「這個 IP、這個 Port 的流量交給哪個負載平衡器」的設定)前 5 條每小時 0.025 美元,一條開一個月 0.025 × 720 = 18 美元,另加每 GiB 約 0.008 美元起的流量處理費;全球型和區域型的轉送規則分開計算(2026 年 11 月查官方負載平衡定價)。這篇同時開了 LoadBalancer 和 Gateway 兩個,實務上選一個就好。
這幾個數字代表什麼:
- requests 是帳單的開關:Pod 數不變,requests 從 500m、2Gi 改成 100m、128Mi,費用剩不到兩成。但寫太小,程式不夠用會變慢,後面的 HPA 也會太早擴展。實際工作要先用
kubectl top看真實用量再決定 - HPA 擴展時費用跟著 Pod 數走:尖峰時從 2 個擴到 6 個,那段時間的運算費就是 3 倍;流量退了縮回 2 個,費用也降回來。這正是 Autopilot 照 Pod 計費的好處
- 一個月的固定成本主要在負載平衡器:2 個小 Pod 才 8.67 美元,一條轉送規則就要 18 美元。只是內部用、不用對外的服務,不要隨手開 LoadBalancer
動手做:把第 4 篇的程式部署到 GKE
這段在 Cloud Shell,專案 dong-dong-gcp-3(換成你自己的專案)做,大約 40 分鐘,大部分時間在等負載平衡器和 HPA。
會花錢:沿用第 24 篇的 GKE Autopilot 叢集 ct-gke(管理費每小時 0.10 美元,帳單帳戶這個月沒用掉免費額度的話會被抵掉);2 個 Pod 照 requests 計費、壓力測試時會多幾個;LoadBalancer 和 Gateway 各一條轉送規則;Cloud Build 每月有 2,500 建置分鐘免費、Artifact Registry 每月前 0.5 GiB 免費。1 小時內做完刪掉,大約 0.2 美元以內。開始前建議先看GCP 帳單爆炸防護設好預算警示。
還沒有叢集:照第 24 篇的步驟 1、2 建一個(gcloud container clusters create-auto ct-gke --region=asia-east1,約 6~7 分鐘)。Cloud Shell 怎麼打開請看第 1 篇的步驟,截圖裡的提示字元有縮短,你的畫面會是「你的帳號@cloudshell:~ (你的專案ID)$」。
步驟 1:連上第 24 篇的 GKE 叢集
gcloud container clusters get-credentials ct-gke --region=asia-east1; kubectl get nodesFetching cluster endpoint and auth data.
kubeconfig entry generated for ct-gke.
NAME STATUS ROLES AGE VERSION
gk3-ct-gke-nap-1excmks3-f2c227a8-zqrb Ready <none> 42m v1.36.4-gke.2377000
gk3-ct-gke-nap-1excmks3-f6b8e9c7-lwlh Ready <none> 43m v1.36.4-gke.2377000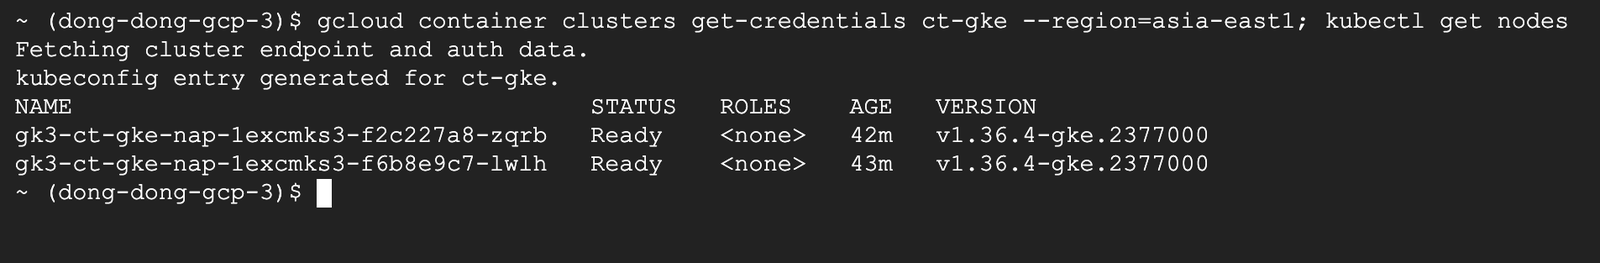
get-credentials把連到ct-gke的地址和鑰匙寫進~/.kube/config,之後的kubectl都是對這個叢集下指令(第 24 篇有說明)- 還有 2 個節點:第 24 篇的工作負載刪掉後,Autopilot 還沒把機器全部收回。節點的錢不用你付,Autopilot 只照 Pod 的 requests 收
步驟 2:建 Artifact Registry 存放區
REPO=asia-east1-docker.pkg.dev/$(gcloud config get-value project 2>/dev/null)/ct-demo; gcloud artifacts repositories create ct-demo --repository-format=docker --location=asia-east1 && echo $REPOCreate request issued for: [ct-demo]
Waiting for operation [projects/dong-dong-gcp-3/locations/asia-east1/operations/488c86d0-362e-42a8-af1a-4ad7c2c4ee1f] to complete...
....done.
Created repository [ct-demo].
asia-east1-docker.pkg.dev/dong-dong-gcp-3/ct-demo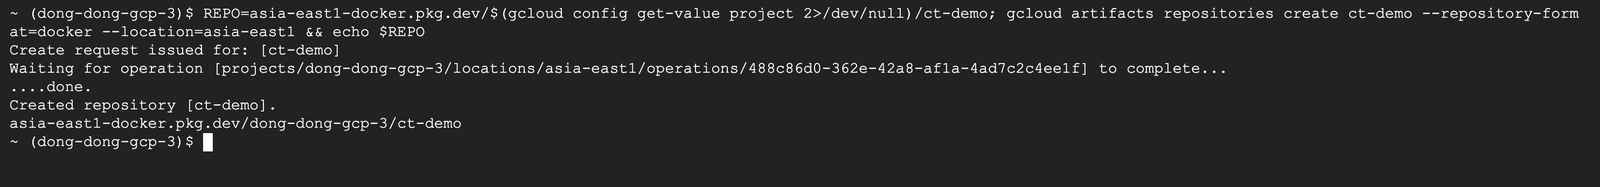
REPO=...把存放區的位址存進變數(Variable,給一段文字取名字,之後用$REPO代替),後面建映像檔、寫 YAML 都會用到。$(gcloud config get-value project 2>/dev/null)會自動換成你的專案 ID,2>/dev/null是把它多印的提示訊息丟掉- 映像檔的完整名字長這樣:
地區-docker.pkg.dev/專案ID/存放區/映像檔:標籤,第 19 篇有拆解說明
步驟 3:準備程式(第 4 篇的 Flask 小網站)
跟第 4 篇一模一樣的三個檔案,用 cat > 檔名 <<'EOF' 一次建好(整段複製貼上,按 Enter):
mkdir -p ~/ct-deploy && cd ~/ct-deploy
cat > app.py <<'EOF'
import os
import socket
from flask import Flask

app = Flask(__name__)

@app.route("/")
def home():
    hostname = socket.gethostname()
    app_env = os.environ.get("APP_ENV", "not set")
    return f"""
<h1>Hello from my first Docker image!</h1>
<p>Container ID (hostname): {hostname}</p>
<p>APP_ENV: {app_env}</p>
"""

if __name__ == "__main__":
    port = int(os.environ.get("PORT", 8080))
    app.run(host="0.0.0.0", port=port)
EOF
cat > requirements.txt <<'EOF'
flask==3.1.3
EOF
cat > Dockerfile <<'EOF'
FROM python:3.14-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY app.py .
EXPOSE 8080
CMD ["python", "app.py"]
EOF
ls; cat Dockerfile
app.py Dockerfile requirements.txt
FROM python:3.14-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY app.py .
EXPOSE 8080
CMD ["python", "app.py"]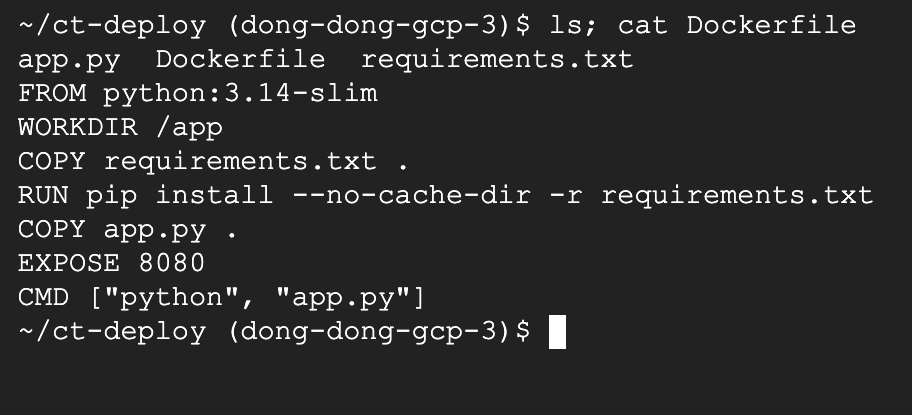
- 網頁會印出 hostname:在 K8s 裡 hostname 就是 Pod 的名字,等一下連線時可以看出是哪個 Pod 回應的
APP_ENV是環境變數(Environment variable,程式啟動時從外面讀進去的設定值),等一下在 Deployment 裡設成gke
步驟 4:用 Cloud Build 建映像檔、推上 Artifact Registry
在 Minikube 篇,映像檔不是用 Docker Hub 的現成品,就是要用 minikube image load 塞進叢集。GKE 的節點在 Google Cloud 上,要從網路上拿得到的倉庫拉映像檔,所以先建好推上 Artifact Registry:
time gcloud builds submit --region=asia-east1 --tag $REPO/ct-web:v1starting build "57381d2b-ae59-4ce7-9e6e-d65903b84049" using release legacy
(中間省略)
DEPRECATED: The legacy builder is deprecated and will be removed in a future release.
(中間省略)
Step 1/7 : FROM python:3.14-slim
(中間省略)
Successfully built 85265b91ddc4
Successfully tagged asia-east1-docker.pkg.dev/dong-dong-gcp-3/ct-demo/ct-web:v1
PUSH
(中間省略)
v1: digest: sha256:46f5799a4908bf28b480f6d0a6779696b2eba9a36e49a420907c661b9f81d48e size: 1991
DONE
ID: 57381d2b-ae59-4ce7-9e6e-d65903b84049
CREATE_TIME: 2026-11-21T04:09:27+00:00
DURATION: 21S
SOURCE: gs://dong-dong-gcp-3_cloudbuild/source/1795234166.275054-49df57e8d2b640cd8f5054eab727cd7a.tgz
IMAGES: asia-east1-docker.pkg.dev/dong-dong-gcp-3/ct-demo/ct-web:v1
STATUS: SUCCESS
real 0m26.800s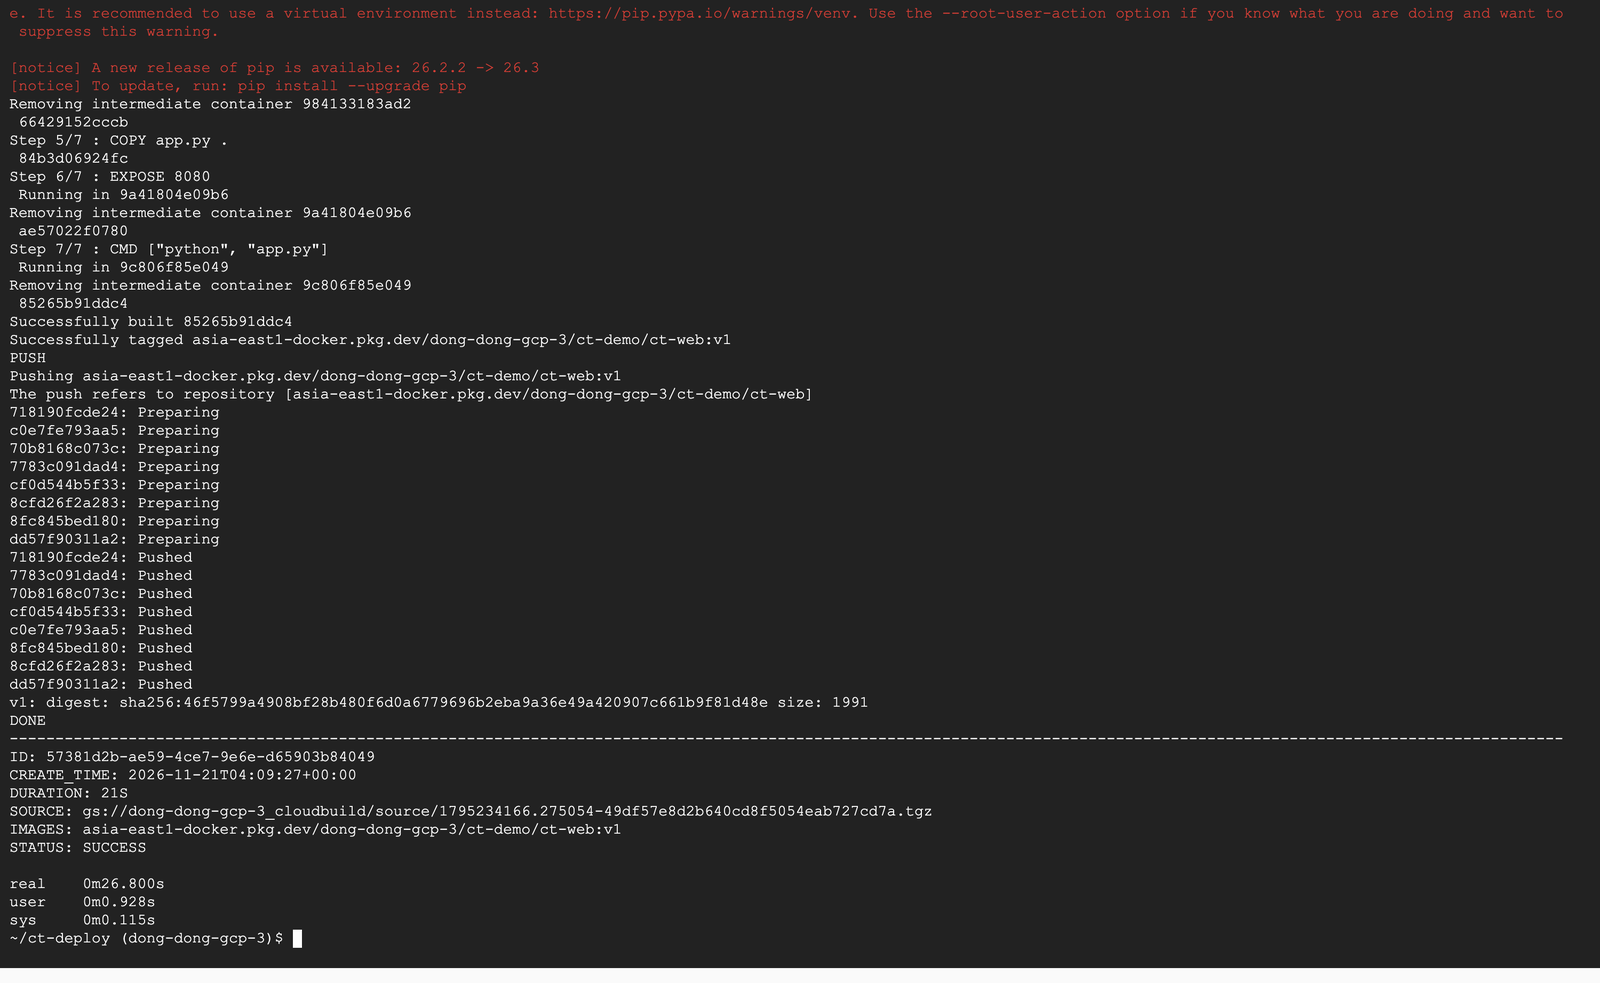
gcloud builds submit --tag把目前資料夾打包上傳,Cloud Build 在雲端照 Dockerfile 建映像檔,建好推到--tag指定的位址(第 21 篇的第一種做法)- 建置 21 秒、整個指令 26.8 秒,多的 5 秒是打包上傳原始碼。你的電腦不用裝 Docker,也不用自己
docker push using release legacy、DEPRECATED: The legacy builder:Cloud Build 的 docker 步驟還在用舊版建置器,不是 BuildKit(第 21 篇也遇到),目前不影響結果- 原始碼壓縮檔放在
gs://專案ID_cloudbuild/source/,「用完記得刪」會清掉
步驟 5:確認映像檔在存放區裡
gcloud artifacts docker images list $REPO --include-tagsListing items under project dong-dong-gcp-3, location asia-east1, repository ct-demo.
IMAGE: asia-east1-docker.pkg.dev/dong-dong-gcp-3/ct-demo/ct-web
DIGEST: sha256:46f5799a4908bf28b480f6d0a6779696b2eba9a36e49a420907c661b9f81d48e
TAGS: v1
CREATE_TIME: 2026-11-21T04:09:49
UPDATE_TIME: 2026-11-21T04:09:49
SIZE: 50003055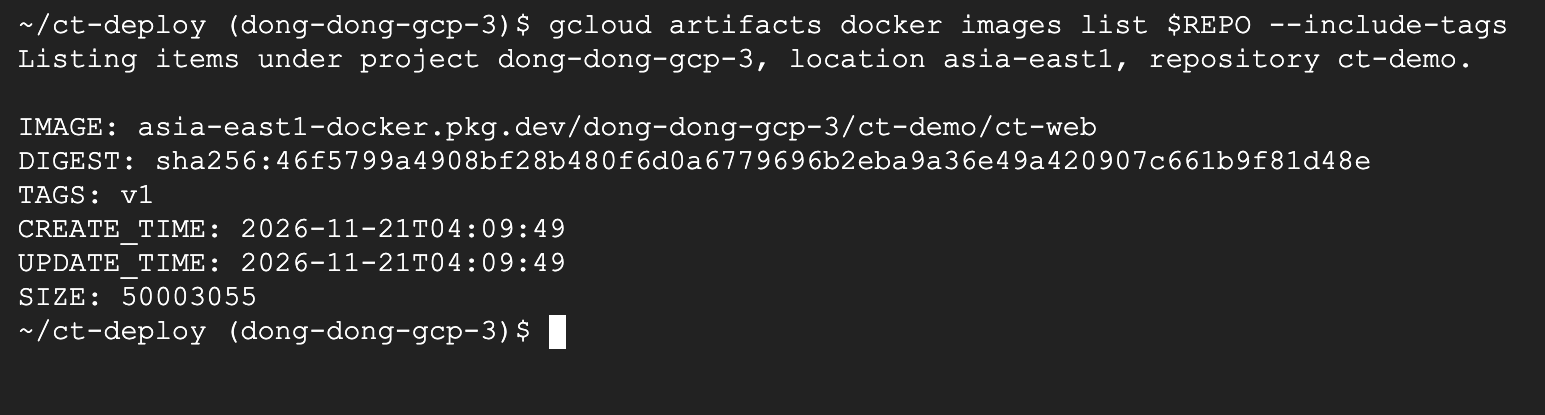
- 映像檔
ct-web、標籤v1,大小 50,003,055 位元組,約 50 MB(壓縮後的大小) - 只有 1 筆:第 19 篇在 Cloud Shell 用 Docker 29 推,會多出建置證明(attestation)那幾筆;Cloud Build 的舊版建置器不會附,所以只有映像檔本身
步驟 6:寫 Deployment,這次寫好 requests
跟第 12 篇的 Deployment 比,多了三樣東西:映像檔改成 Artifact Registry 的位址、加上 resources.requests、加上 readinessProbe。這次用 <<EOF(EOF 沒有加單引號),讓 ${REPO} 自動換成你的存放區位址:
cat > deployment.yaml <<EOF
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ct-web
spec:
  replicas: 2
  selector:
    matchLabels:
      app: ct-web
  template:
    metadata:
      labels:
        app: ct-web
    spec:
      containers:
      - name: web
        image: ${REPO}/ct-web:v1
        ports:
        - containerPort: 8080
        env:
        - name: APP_ENV
          value: gke
        resources:
          requests:
            cpu: 100m
            memory: 128Mi
        readinessProbe:
          httpGet:
            path: /
            port: 8080
EOF
grep image: deployment.yaml
image: asia-east1-docker.pkg.dev/dong-dong-gcp-3/ct-demo/ct-web:v1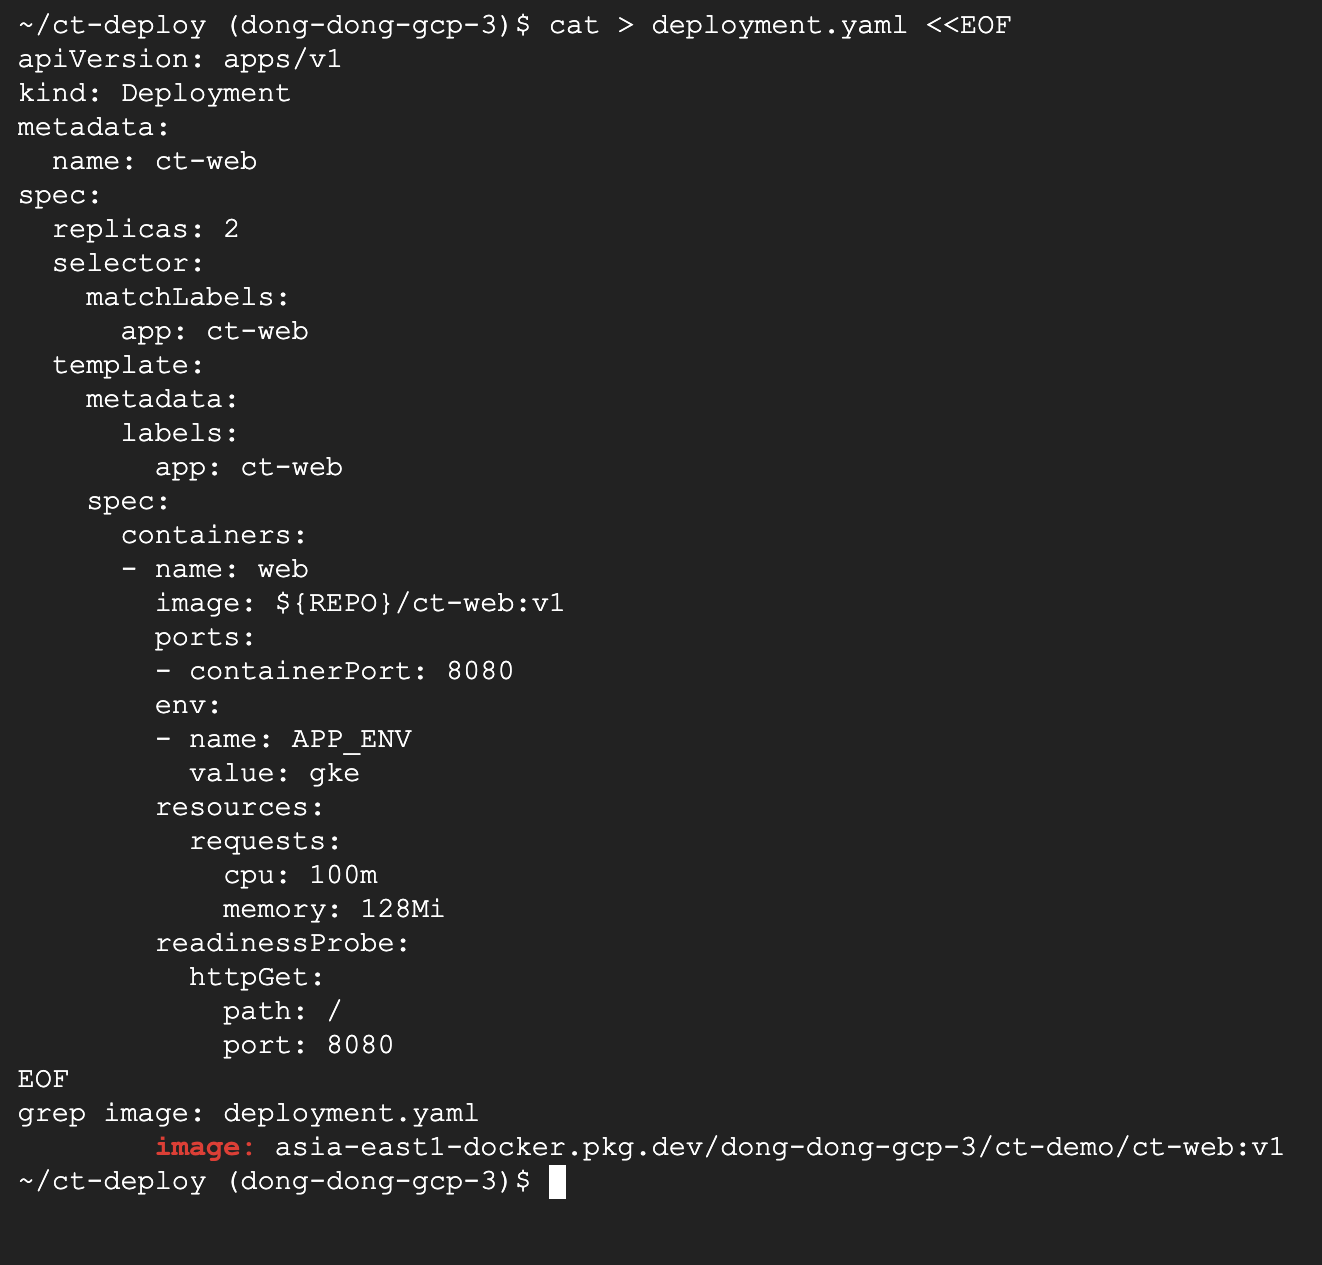
<<'EOF'(有單引號)裡的$會原封不動寫進檔案;<<EOF(沒單引號)會先把${REPO}換成變數的值。grep image:確認換成功了,沒換到的話這行會是image: /ct-web:v1requests: cpu: 100m, memory: 128Mi:每個 Pod 要 0.1 顆 vCPU、128 MiB 記憶體。Autopilot 的最小值是 50m、52 MiB,CPU 和記憶體的比例要在 1:1 到 1:6.5(以 vCPU:GiB 算)之間;0.1 vCPU 配 0.125 GiB 是 1:1.25,合規(2026 年 11 月查官方資源要求說明)readinessProbe:K8s 每隔幾秒打一次/,回 200 才把流量導給這個 Pod(第 17 篇的就緒探針)replicas: 2:先開 2 個,後面交給 HPA 決定要幾個
步驟 7:部署
kubectl apply -f deployment.yaml; time kubectl rollout status deployment/ct-web --timeout=10mdeployment.apps/ct-web created
Waiting for deployment "ct-web" rollout to finish: 0 out of 2 new replicas have been updated...
Waiting for deployment "ct-web" rollout to finish: 0 of 2 updated replicas are available...
Waiting for deployment "ct-web" rollout to finish: 1 of 2 updated replicas are available...
deployment "ct-web" successfully rolled out
real 0m18.485s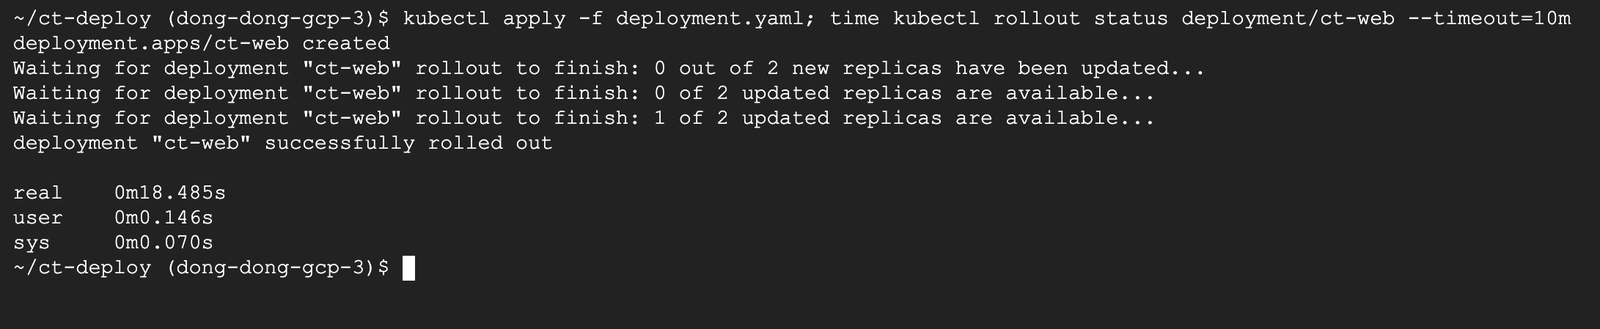
- 18.5 秒就好:第 24 篇第一次部署要等 GKE 開節點,花了 1 分多鐘;這次節點已經在了,只要拉映像檔、啟動容器
- 這次沒有黃色的
Warning: autopilot-default-resources-mutator:requests 自己寫了,Autopilot 不用幫你補 - 節點能直接拉 Artifact Registry 的映像檔,是因為 GKE 節點預設用 Compute Engine 預設服務帳戶,同一個專案裡有讀取權限;映像檔放在別的專案,要另外給節點的服務帳戶「Artifact Registry 讀取者」(
roles/artifactregistry.reader)角色(2026 年 11 月查官方說明)
步驟 8:確認 requests 沒被改
kubectl get pods -o custom-columns=NAME:.metadata.name,STATUS:.status.phase,CPU:.spec.containers[0].resources.requests.cpu,MEMORY:.spec.containers[0].resources.requests.memory,EPHEMERAL:.spec.containers[0].resources.requests.ephemeral-storage,CPU_LIMIT:.spec.containers[0].resources.limits.cpuNAME STATUS CPU MEMORY EPHEMERAL CPU_LIMIT
ct-web-6d979cf88f-cbzpk Running 100m 128Mi 1Gi <none>
ct-web-6d979cf88f-spbwm Running 100m 128Mi 1Gi <none>
- 100m、128Mi 原樣保留:這個叢集是 1.36 版,支援爆發(Bursting,Pod 可以暫時用到超過 requests 的資源),不再把 CPU 進位到 250m 的倍數(1.30.2 版以前的叢集會進位)
EPHEMERAL 1Gi:暫存空間沒寫,Autopilot 補 1 GiB,一個月約 0.12 美元,影響很小CPU_LIMIT <none>:沒寫上限(limits)。在 Autopilot,沒寫上限的 Pod 可以爆發到「同一個節點上所有 Pod 的 requests 加總裡,別人沒用到的部分」(2026 年 11 月查官方爆發說明)
步驟 9:先用 LoadBalancer Service 對外
第 13 篇在 Minikube 開 LoadBalancer 要另外跑 minikube tunnel;在 GKE 同一個指令會真的建一個 Google Cloud 的負載平衡器:
kubectl expose deployment ct-web --name=ct-web-lb --type=LoadBalancer --port=80 --target-port=8080; time (until kubectl get service ct-web-lb -o jsonpath='{.status.loadBalancer.ingress[0].ip}' | grep -q .; do sleep 5; done); kubectl get service ct-web-lbservice/ct-web-lb exposed
real 0m46.753s
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
ct-web-lb LoadBalancer 34.118.236.162 34.81.139.144 80:32672/TCP 47s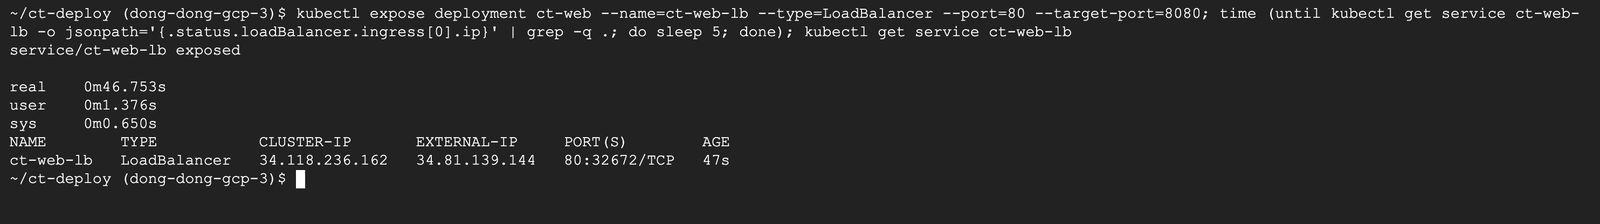
--port=80是對外的 Port,--target-port=8080是容器裡 Flask 聽的 Port(第 13 篇講過 port 和 targetPort 的差別)- 46.7 秒拿到外部 IP,第 24 篇是 57 秒,大約都在 1 分鐘內
- 這個 IP 跟第 24 篇拿到的一模一樣(34.81.139.144),原因寫在「實測時的意外」
步驟 10:連 6 次,看流量分給 2 個 Pod
IP=$(kubectl get service ct-web-lb -o jsonpath='{.status.loadBalancer.ingress[0].ip}'); for i in 1 2 3 4 5 6; do curl -s http://$IP | grep -o 'hostname): [^<]*'; done; curl -s http://$IP | grep APP_ENVhostname): ct-web-6d979cf88f-spbwm
hostname): ct-web-6d979cf88f-cbzpk
hostname): ct-web-6d979cf88f-spbwm
hostname): ct-web-6d979cf88f-cbzpk
hostname): ct-web-6d979cf88f-spbwm
hostname): ct-web-6d979cf88f-cbzpk
<p>APP_ENV: gke</p>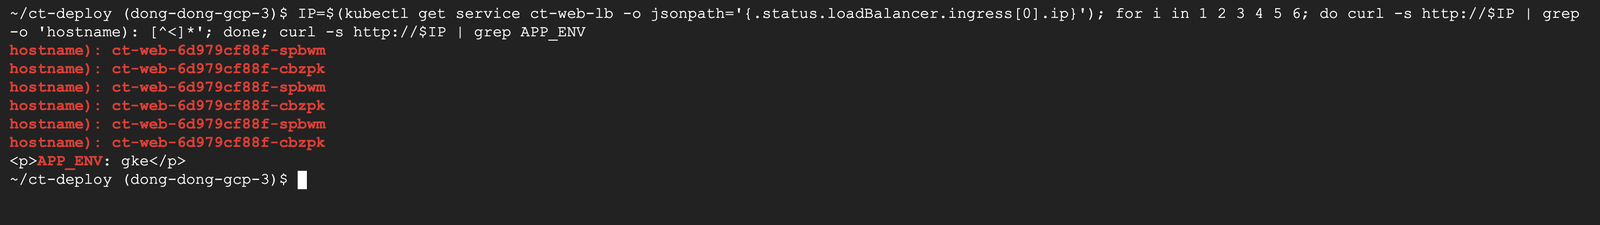
- 回應的 hostname 在兩個 Pod 之間輪流,代表負載平衡器真的把流量分給了 2 個 Pod
APP_ENV: gke:Deployment 裡設的環境變數有傳進容器for i in 1 2 3 4 5 6; do ...; done是「同一個指令跑 6 次」;grep -o只留下 hostname 那一段
步驟 11:看叢集裡有哪些 GatewayClass
kubectl get gatewayclassNAME CONTROLLER ACCEPTED AGE
gke-l7-global-external-managed networking.gke.io/gateway True 47m
gke-l7-gxlb networking.gke.io/gateway True 47m
gke-l7-regional-external-managed networking.gke.io/gateway True 47m
gke-l7-rilb networking.gke.io/gateway True 47m
gke-passthrough-lb-external-managed networking.gke.io/persistent-ip-controller True 48m
gke-passthrough-lb-internal-managed networking.gke.io/persistent-ip-controller True 48m
gke-persistent-fast-regional-external-managed networking.gke.io/persistent-ip-controller True 48m
gke-persistent-fast-regional-internal-managed networking.gke.io/persistent-ip-controller True 48m
gke-persistent-regional-external-managed networking.gke.io/persistent-ip-controller True 48m
gke-persistent-regional-internal-managed networking.gke.io/persistent-ip-controller True 48m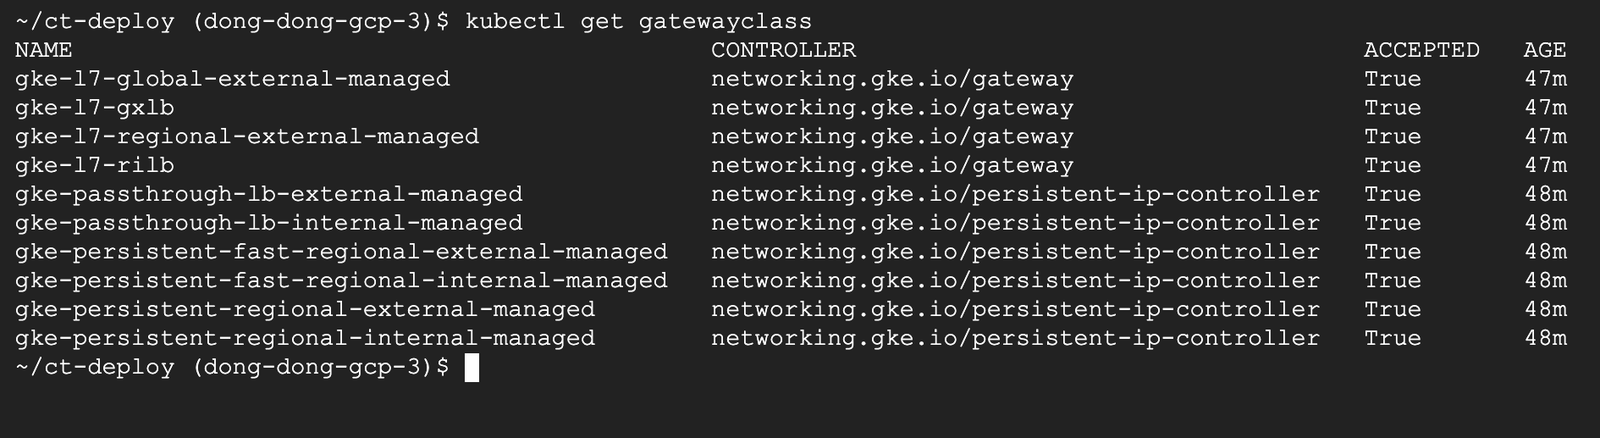
- 前 4 個
gke-l7-開頭的,就是「GKE 預裝的 GatewayClass」那張表的 4 種,CONTROLLER是networking.gke.io/gateway,代表由 GKE 的 Gateway 控制器負責建負載平衡器 - 後 6 個
gke-passthrough-、gke-persistent-開頭的屬於另一個控制器persistent-ip-controller,用來給第 4 層服務保留固定 IP,這篇用不到 ACCEPTED True:控制器已經接手,可以直接用。這些都是 GKE 自己裝的,不用另外安裝 Gateway API
步驟 12:開一個叢集內部用的 Service,寫 Gateway 和 HTTPRoute
Gateway 要把流量交給一個 Service。這裡另外開一個 ClusterIP(只在叢集裡面能連)的 Service ct-web,再寫兩個檔案:
kubectl expose deployment ct-web --port=80 --target-port=8080
cat > gateway.yaml <<'EOF'
apiVersion: gateway.networking.k8s.io/v1
kind: Gateway
metadata:
  name: ct-gw
spec:
  gatewayClassName: gke-l7-global-external-managed
  listeners:
  - name: http
    protocol: HTTP
    port: 80
EOF
cat > route.yaml <<'EOF'
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: ct-route
spec:
  parentRefs:
  - name: ct-gw
  rules:
  - backendRefs:
    - name: ct-web
      port: 80
EOF
kubectl get service
service/ct-web exposed
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
ct-web ClusterIP 34.118.233.241 <none> 80/TCP 0s
ct-web-lb LoadBalancer 34.118.236.162 34.81.139.144 80:32672/TCP 102s
kubernetes ClusterIP 34.118.224.1 <none> 443/TCP 51m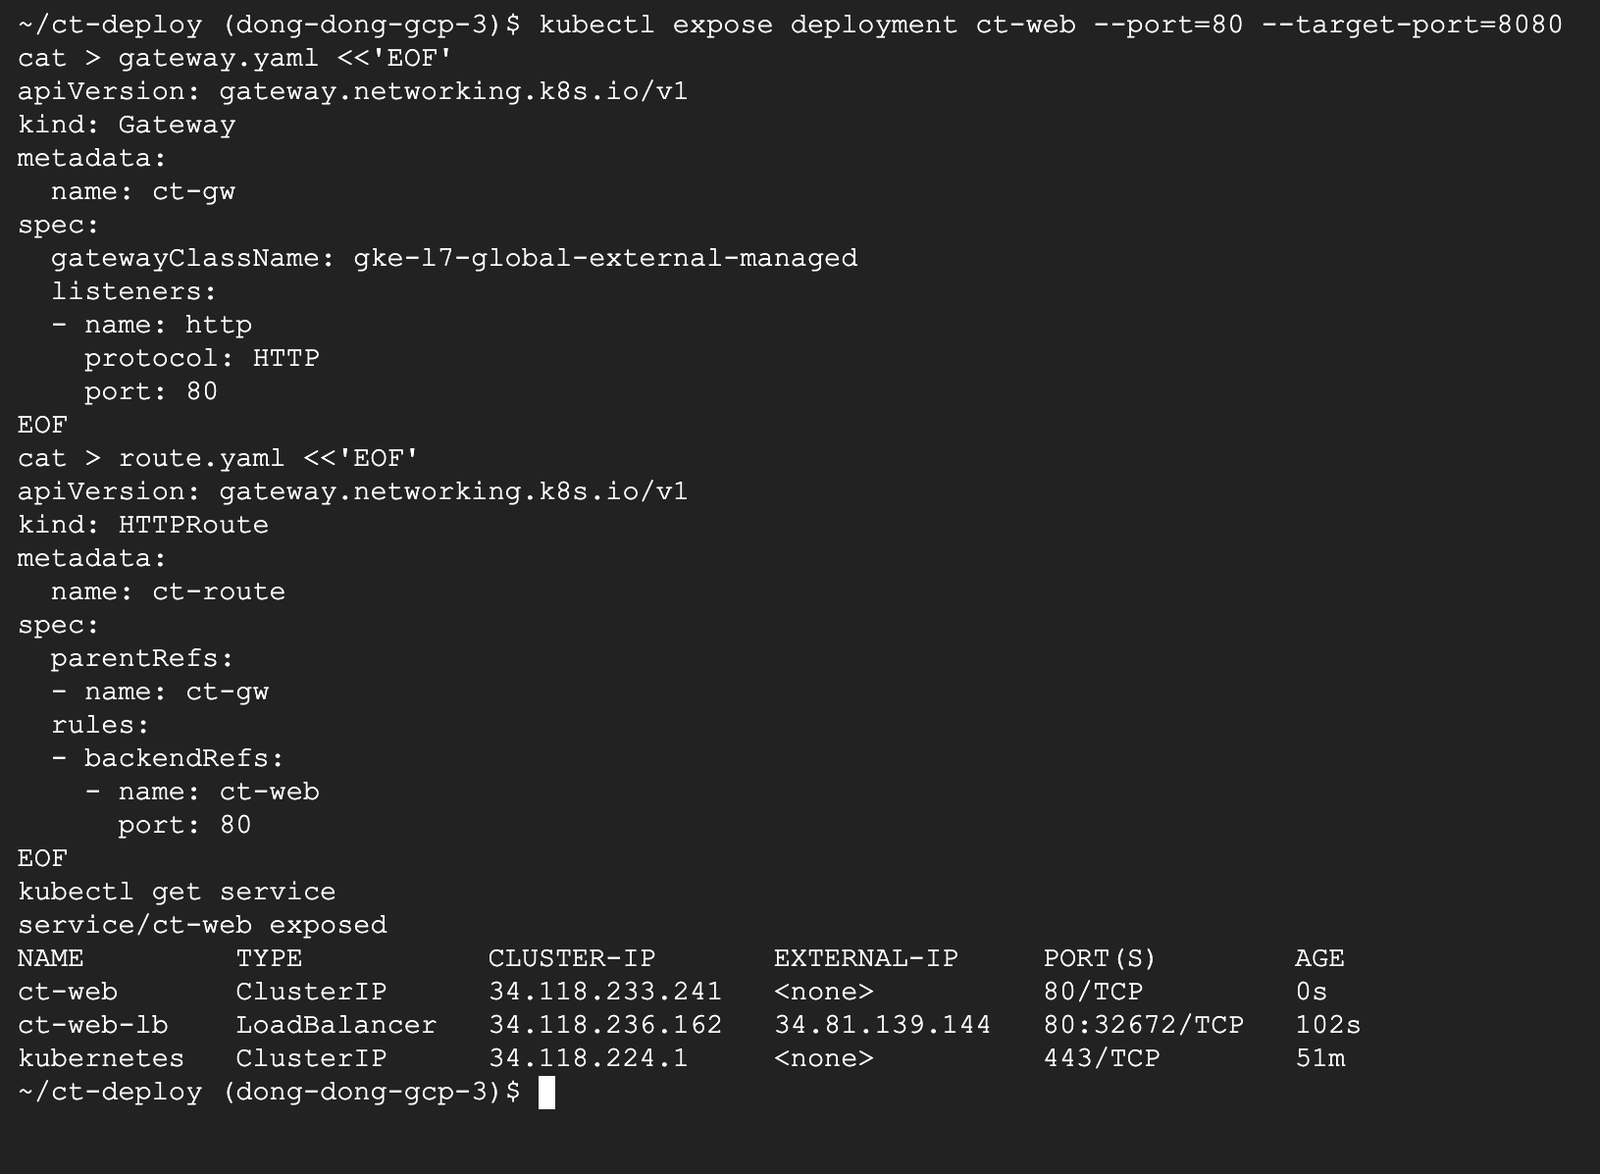
- gateway.yaml(門):
gatewayClassName選全球外部型,listeners說這扇門接 HTTP、Port 80 - route.yaml(指示牌):
parentRefs說「我是掛在ct-gw這扇門上的」,backendRefs說「進來的流量都交給 Servicect-web的 80 Port」。沒寫matches,就是所有路徑都送過去 - 想做第 14 篇那種
/a、/b分流,就在rules底下加matches: - path: {type: PathPrefix, value: /a},每條規則指到不同的 Service ct-web-lb先留著,等一下兩種對外方式可以比較
步驟 13:部署 Gateway,等它變成 Programmed
kubectl apply -f gateway.yaml -f route.yaml; time kubectl wait gateway/ct-gw --for=condition=Programmed --timeout=15m; kubectl get gateway ct-gwgateway.gateway.networking.k8s.io/ct-gw created
httproute.gateway.networking.k8s.io/ct-route created
gateway.gateway.networking.k8s.io/ct-gw condition met
real 1m36.965s
NAME CLASS ADDRESS PROGRAMMED AGE
ct-gw gke-l7-global-external-managed 136.81.43.58 True 97s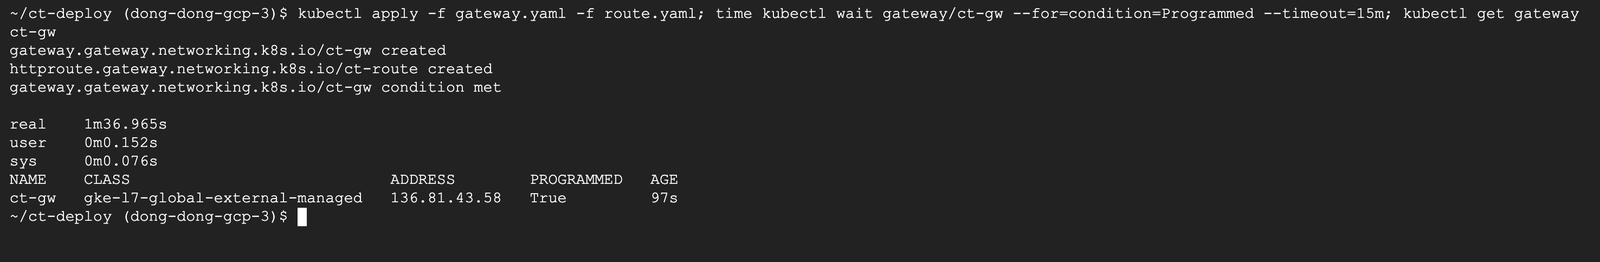
kubectl wait --for=condition=Programmed:一直等到 Gateway 的Programmed狀態變成 True。官方文件說Programmed才是「負載平衡器設定好了」的訊號,舊的Ready狀態已經保留給以後用- 1 分 37 秒拿到全球 IP
136.81.43.58。這段時間 GKE 在背後建了一整套負載平衡器:轉送規則、目標 Proxy、網址對應、後端服務、健康檢查、防火牆規則
步驟 14:等 Gateway 真的能連
Programmed 不等於馬上連得到。每 10 秒打一次,印出 HTTP 狀態碼,直到回 200:
GW=$(kubectl get gateway ct-gw -o jsonpath='{.status.addresses[0].value}'); echo $GW; S=$(date +%s); until c=$(curl -s -o /dev/null -w '%{http_code}' http://$GW); [ "$c" = 200 ]; do printf '%s ' "$c"; sleep 10; done; echo; echo "200 after $(( $(date +%s)-S ))s"136.81.43.58
000 000 000 000 000 000 000 000 000 000 000 404 404 404
200 after 141s
000:連線根本沒建立,全世界的 Google 入口還沒拿到這個 IP 的設定404:負載平衡器已經接起來了,但「網址要送給誰」的規則還沒生效,所以回找不到- 141 秒後才回 200。加上步驟 13 的 1 分 37 秒,從 apply 到真的能用大約 4 分鐘;LoadBalancer Service 是 47 秒。全球型負載平衡器要把設定推到全世界的入口,所以比較慢
until ...; do ...; done是「條件不成立就一直做」,printf把每次的狀態碼印在同一行
步驟 15:從 Gateway 連看看
for i in 1 2 3 4; do curl -s http://$GW | grep -o 'hostname): [^<]*'; done; curl -s -o /dev/null -w "code=%{http_code} total=%{time_total}s\n" http://$GW; kubectl get httproute ct-routehostname): ct-web-6d979cf88f-spbwm
hostname): ct-web-6d979cf88f-cbzpk
code=200 total=0.010847s
NAME HOSTNAMES AGE
ct-route 4m10s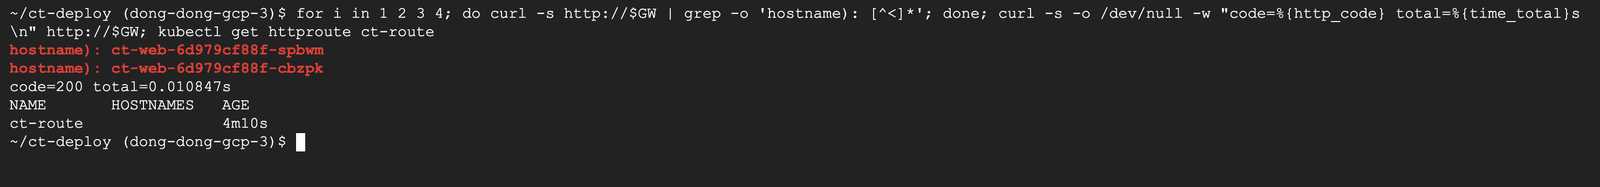
- 回應一樣來自
spbwm、cbzpk兩個 Pod,Gateway 跟 LoadBalancer Service 用的是同一組 Pod - 連 4 次只印出 2 個 hostname:剛回 200 的頭幾分鐘,有些請求還會失敗,下一步確認
HOSTNAMES是空的:HTTPRoute 沒限定網域,打 IP 就能連;正式環境會寫hostnames: ["www.你的網域"]
步驟 16:再連 12 次,確認 Gateway 穩定了
for i in $(seq 1 12); do curl -s -o /dev/null -w '%{http_code} ' http://$GW; done; echo200 200 200 200 200 200 200 200 200 200 200 200
再過約 1 分鐘,12 次全部 200。Gateway 剛回 200 的頭一兩分鐘還會偶爾失敗,上線、切換網域時要預留這段時間,不要一看到第一個 200 就把舊的入口拆掉。
步驟 17:開 HPA,目標 CPU 50%
第 17 篇在 Minikube 開 HPA 之前,要先 minikube addons enable metrics-server;GKE 的指標服務是內建的,直接開:
kubectl autoscale deployment ct-web --cpu=50% --min=2 --max=10; sleep 60; kubectl get hpa ct-web; kubectl top podshorizontalpodautoscaler.autoscaling/ct-web autoscaled
NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGE
ct-web Deployment/ct-web cpu: 1%/50% 2 10 2 60s
NAME CPU(cores) MEMORY(bytes)
ct-web-6d979cf88f-cbzpk 1m 34Mi
ct-web-6d979cf88f-spbwm 1m 25Mi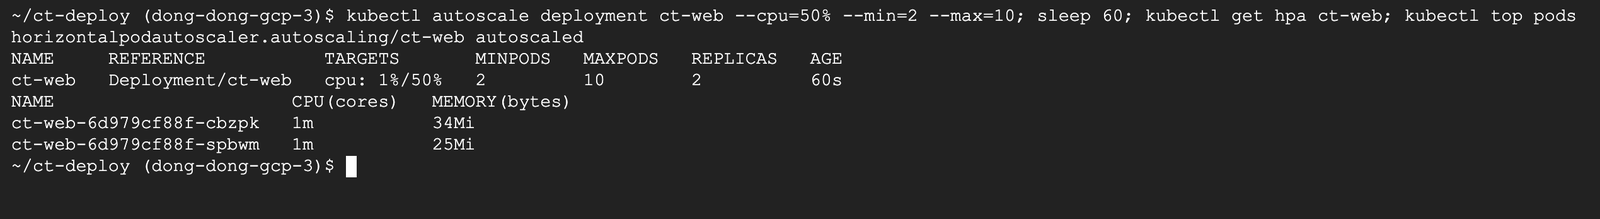
- HPA(Horizontal Pod Autoscaler,水平 Pod 自動擴展)依 CPU 這類指標自動調整 Pod 數量,第 17 篇有完整說明
--cpu=50%:目標是「平均每個 Pod 的 CPU 用量到 requests 的 50%」,requests 是 100m,所以目標是每個 Pod 用 50m。第 17 篇用的舊參數--cpu-percent已經棄用,這次用新寫法,沒有出現棄用警告--min=2 --max=10:最少留 2 個(一個壞了還有另一個),最多 10 個(避免流量暴衝時帳單跟著暴衝)TARGETS cpu: 1%/50%:開完 1 分鐘就有數字,不像 Minikube 會先顯示<unknown>一陣子kubectl top pods:每個 Pod 實際只用 1m CPU、25~34 MiB 記憶體。記憶體要了 128Mi 只用到 3 成,正式環境可以觀察幾天再調低
步驟 18:壓力測試,看 HPA 擴展
跟第 17 篇一樣,開一個 busybox Pod 不停地連 ct-web,每 30 秒印一次 HPA 的狀態(時間是 UTC,台灣時間要加 8 小時):
kubectl run load-generator --image=busybox:1.37 --restart=Never -- /bin/sh -c 'while true; do wget -q -O- http://ct-web > /dev/null; done'; for i in $(seq 1 10); do sleep 30; echo "$(date +%T) $(kubectl get hpa ct-web --no-headers)"; doneWarning: autopilot-default-resources-mutator:Autopilot updated Pod default/load-generator: defaulted unspecified 'cpu' resource for containers [load-generator] (see http://g.co/gke/autopilot-defaults).
pod/load-generator created
04:19:14 ct-web Deployment/ct-web cpu: 125%/50% 2 10 4 96s
04:19:44 ct-web Deployment/ct-web cpu: 125%/50% 2 10 5 2m6s
04:20:14 ct-web Deployment/ct-web cpu: 125%/50% 2 10 5 2m37s
04:20:45 ct-web Deployment/ct-web cpu: 52%/50% 2 10 5 3m7s
04:21:15 ct-web Deployment/ct-web cpu: 52%/50% 2 10 5 3m37s
04:21:45 ct-web Deployment/ct-web cpu: 50%/50% 2 10 5 4m7s
04:22:15 ct-web Deployment/ct-web cpu: 50%/50% 2 10 5 4m37s
04:22:45 ct-web Deployment/ct-web cpu: 51%/50% 2 10 5 5m8s
04:23:16 ct-web Deployment/ct-web cpu: 51%/50% 2 10 5 5m38s
04:23:46 ct-web Deployment/ct-web cpu: 49%/50% 2 10 5 6m8s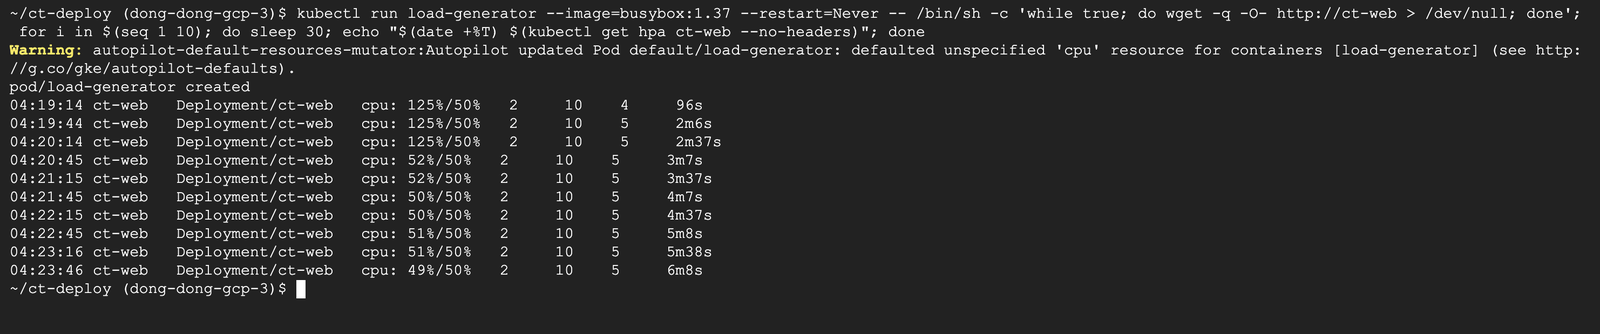
- 30 秒內從 2 個擴到 4 個,1 分鐘內到 5 個。
cpu: 125%/50%是「平均每個 Pod 用了 requests 的 125%」,也就是 125m - 用第 17 篇的公式算一次:期望 Pod 數 = 無條件進位(目前 Pod 數 × 目前使用率 ÷ 目標使用率)= 2 × 125 ÷ 50 = 5,跟實際停在 5 個一樣
- 擴到 5 個之後,同樣的流量分給 5 個 Pod,使用率降到 49~52%,剛好在目標附近,HPA 就不再加
- 用量 125% 超過 requests 100%:這就是步驟 8 說的爆發,沒寫上限的 Pod 可以暫時用到比 requests 多的 CPU
- 黃色
Warning:kubectl run沒辦法寫 requests,Autopilot 幫 load-generator 補了預設值(第 24 篇看過),壓測完就刪,影響不大
步驟 19:新的 Pod 放在哪裡
kubectl get pods -o wide | cut -c1-150; kubectl top pods; kubectl get nodesNAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES
ct-web-6d979cf88f-cbzpk 1/1 Running 0 13m 10.70.1.7 gk3-ct-gke-nap-1excmks3-f2c227a8-zqrb <none> <none>
ct-web-6d979cf88f-d7818 1/1 Running 0 4m51s 10.70.0.133 gk3-ct-gke-nap-1excmks3-544f3138-pwfh <none> 1/1
ct-web-6d979cf88f-hz4ml 1/1 Running 0 4m51s 10.70.1.132 gk3-ct-gke-nap-1excmks3-f6b8e9c7-xpfg <none> 1/1
ct-web-6d979cf88f-kwc7j 1/1 Running 0 4m38s 10.70.0.134 gk3-ct-gke-nap-1excmks3-544f3138-pwfh <none> 1/1
ct-web-6d979cf88f-spbwm 1/1 Running 0 13m 10.70.1.8 gk3-ct-gke-nap-1excmks3-f2c227a8-zqrb <none> <none>
load-generator 1/1 Running 0 5m8s 10.70.0.132 gk3-ct-gke-nap-1excmks3-544f3138-pwfh <none> <none>
NAME CPU(cores) MEMORY(bytes)
ct-web-6d979cf88f-cbzpk 54m 34Mi
ct-web-6d979cf88f-d7818 44m 32Mi
ct-web-6d979cf88f-hz4ml 45m 25Mi
ct-web-6d979cf88f-kwc7j 48m 24Mi
ct-web-6d979cf88f-spbwm 57m 25Mi
load-generator 360m 6Mi
NAME STATUS ROLES AGE VERSION
gk3-ct-gke-nap-1excmks3-544f3138-pwfh Ready <none> 13m v1.36.4-gke.2377000
gk3-ct-gke-nap-1excmks3-544f3138-v2dd Ready <none> 97s v1.36.4-gke.2377000
gk3-ct-gke-nap-1excmks3-f2c227a8-zqrb Ready <none> 57m v1.36.4-gke.2377000
gk3-ct-gke-nap-1excmks3-f6b8e9c7-lwlh Ready <none> 58m v1.36.4-gke.2377000
gk3-ct-gke-nap-1excmks3-f6b8e9c7-xpfg Ready <none> 10m v1.36.4-gke.2377000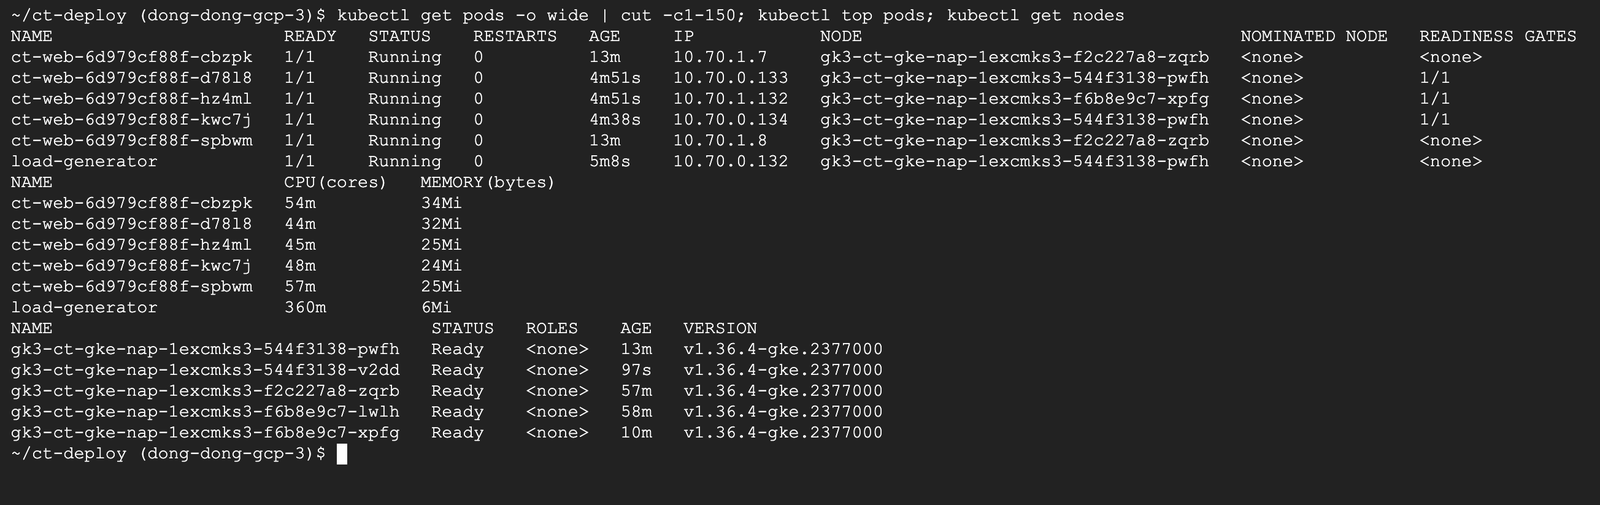
- 3 個新 Pod 放在已經開著的節點上(
pwfh、xpfg),不用等開新機器,所以 30 秒內就能接流量。第 24 篇第一次部署要等 GKE 開節點,多花了約 45 秒;如果新 Pod 放不下,Autopilot 一樣會自動開節點,只是擴展會慢一點 - 新 Pod 的
READINESS GATES是1/1,舊的是<none>:Gateway 用的是「容器原生負載平衡」(Container-native load balancing,負載平衡器直接把流量送到 Pod 的 IP,不經過節點轉一手),GKE 會幫新 Pod 加一道就緒關卡,等負載平衡器的健康檢查也通過才算就緒,避免流量打到還沒準備好的 Pod(官方說明) kubectl top pods:5 個 ct-web 各用 44~57m,平均約 50m,正好是目標(100m 的 50%)。load-generator 自己用了 360m,壓測工具本身也很吃 CPU- 節點有 5 台,其中
v2dd才開 97 秒,是 GKE 自己決定多準備的。Autopilot 照 Pod 收錢,節點數不影響帳單
步驟 20:停掉壓力,看 HPA 多久縮回來
kubectl delete pod load-generator --now; for i in $(seq 1 9); do sleep 60; echo "$(date +%T) $(kubectl get hpa ct-web --no-headers)"; donepod "load-generator" deleted from default namespace
04:25:03 ct-web Deployment/ct-web cpu: 7%/50% 2 10 5 7m25s
04:26:03 ct-web Deployment/ct-web cpu: 1%/50% 2 10 5 8m25s
04:27:03 ct-web Deployment/ct-web cpu: 1%/50% 2 10 5 9m25s
04:28:03 ct-web Deployment/ct-web cpu: 1%/50% 2 10 5 10m
04:29:03 ct-web Deployment/ct-web cpu: 1%/50% 2 10 5 11m
04:30:04 ct-web Deployment/ct-web cpu: 1%/50% 2 10 5 12m
04:31:04 ct-web Deployment/ct-web cpu: 1%/50% 2 10 5 13m
04:32:04 ct-web Deployment/ct-web cpu: 0%/50% 2 10 3 14m
04:33:04 ct-web Deployment/ct-web cpu: 1%/50% 2 10 3 15m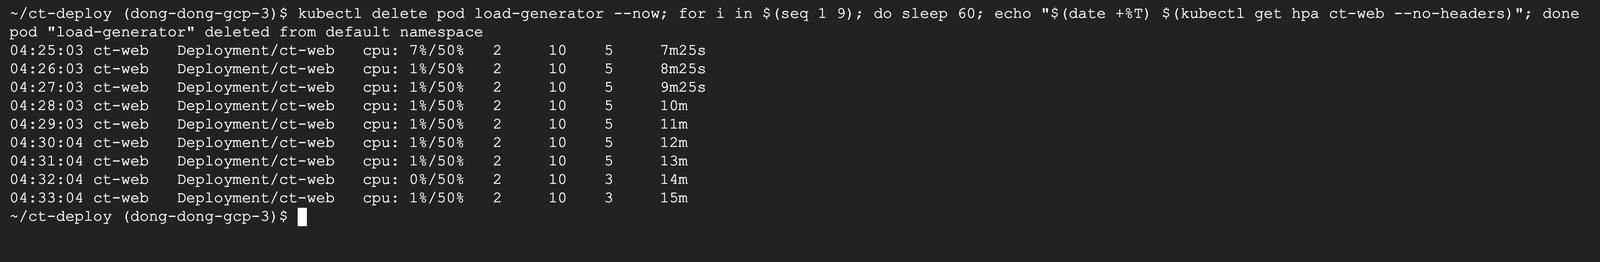
--now是立刻刪掉、不等 30 秒的正常關機時間(第 11 篇看過 busybox 收到關機訊號不理,刪除要等滿 30 秒)- CPU 1 分鐘內就掉到 1%,Pod 數卻維持 5 個約 8 分鐘,04:32 才縮成 3 個,9 分鐘結束時還沒回到最少的 2 個
- 這是故意的:HPA 縮減前有 5 分鐘的穩定視窗(scale-down stabilization window),要看到連續 5 分鐘都不需要那麼多 Pod 才縮,避免流量忽高忽低時一直開了又關(2026 年 11 月查官方 HPA 說明)。擴展則沒有等待,0 秒就動
- 對帳單的意思:尖峰過後還會多付幾分鐘的 Pod 錢,但比「尖峰時 Pod 不夠、網站變慢」划算
再看一次現在的 Pod:
date +%T; kubectl get hpa ct-web; kubectl get pods04:33:24
NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGE
ct-web Deployment/ct-web cpu: 1%/50% 2 10 3 15m
NAME READY STATUS RESTARTS AGE
ct-web-6d979cf88f-5l77c 1/1 Running 0 7m31s
ct-web-6d979cf88f-cbzpk 1/1 Running 0 23m
ct-web-6d979cf88f-spbwm 1/1 Running 0 23m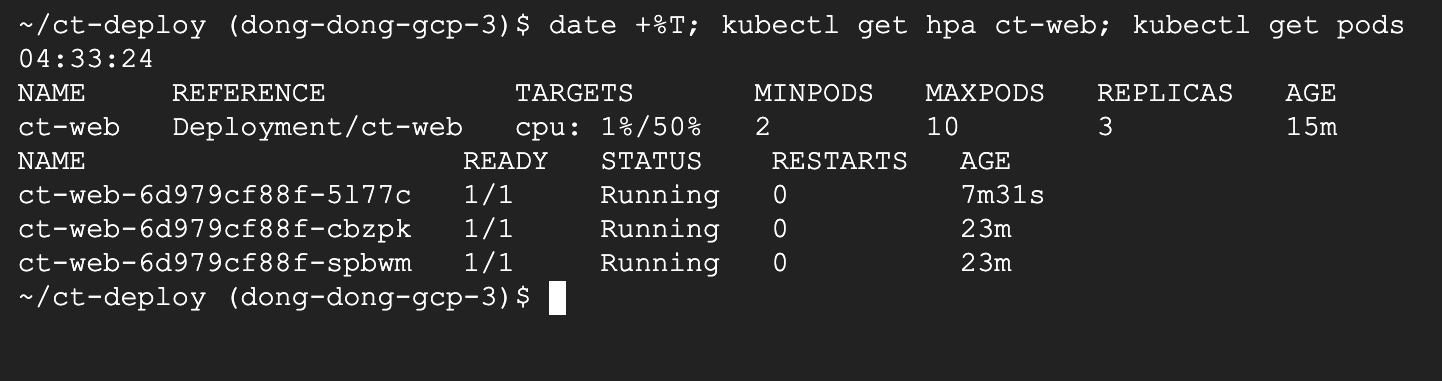
剩下的 3 個 Pod 裡,5l77c 是 7 分 31 秒前才建立的,不在壓測時新開的那 3 個裡面。壓力停掉後,GKE 一邊縮 Pod、一邊把用不到的節點收掉,原本在那些節點上的 Pod 會被搬到別台重開。所以程式要能隨時被關掉、在別台重開也不出事,這也是 K8s 要求應用「無狀態」的原因(第 16 篇講過資料要放在 Volume 或外部資料庫)。
實測時的意外
1. Gateway 顯示 Programmed,還要再等 2 分多鐘才連得到
一般以為 kubectl wait --for=condition=Programmed 回來就能用了。實測 Programmed 之後,先是 11 次連不上(000)、再 3 次 404,141 秒後才回 200;剛回 200 時連 4 次還有 2 次失敗,再過 1 分鐘才 12 次全部成功。全球型負載平衡器要把設定推到全世界的 Google 入口,所以會有這段空窗。換網域、切流量時,要用 curl 連續確認一陣子都是 200,才把舊的入口拆掉。
2. LoadBalancer 拿到的 IP,跟第 24 篇一模一樣
步驟 9 拿到的外部 IP 是 34.81.139.144,跟第 24 篇刪掉的那個 LoadBalancer 是同一個。LoadBalancer Service 預設用的是臨時外部 IP(Ephemeral IP),Service 刪掉後 IP 會還給 Google,之後可能被分給任何人,這次剛好又分回同一個專案。反過來說,刪掉 Service 再重建,IP 通常會變,網域的 DNS 記錄要跟著改。正式環境要固定 IP,要先保留一個靜態外部 IP 位址,再指定給 Service 或 Gateway(官方 IP 位址說明)。
3. GatewayClass 有 10 個,不只文件常講的 4 個
第 24 篇的事件裡只看到 4 個 gke-l7- 開頭的 GatewayClass,步驟 11 列出來卻有 10 個,多的 6 個是 gke-passthrough-、gke-persistent- 開頭、由另一個控制器 persistent-ip-controller 負責,用途是幫第 4 層的服務保留固定 IP。看到這麼多不用緊張,對外的網頁服務選 gke-l7-global-external-managed 就好。
4. 擴展 30 秒、縮回 8 分鐘
HPA 擴展幾乎是立刻的:壓測開始後 30 秒內就從 2 個變 4 個。縮回卻慢很多:CPU 1 分鐘就掉到 1%,Pod 數維持 5 個約 8 分鐘才縮成 3 個。這是 HPA 預設的 5 分鐘縮減穩定視窗,不是故障。想縮快一點,可以在 HPA 的 YAML 寫 behavior.scaleDown.stabilizationWindowSeconds 調短,但流量忽高忽低的服務會因此一直開了又關。
用完記得刪
先刪 HPA、Gateway、Service、Deployment
負載平衡器先刪:LoadBalancer 和 Gateway 都是照小時計費、而且對全世界開著的。
kubectl delete hpa ct-web; kubectl delete -f route.yaml -f gateway.yaml; time kubectl delete service ct-web-lb; kubectl delete service ct-web; kubectl delete deployment ct-web; kubectl get allhorizontalpodautoscaler.autoscaling "ct-web" deleted from default namespace
httproute.gateway.networking.k8s.io "ct-route" deleted from default namespace
gateway.gateway.networking.k8s.io "ct-gw" deleted from default namespace
service "ct-web-lb" deleted from default namespace
real 0m33.031s
service "ct-web" deleted from default namespace
deployment.apps "ct-web" deleted from default namespace
NAME READY STATUS RESTARTS AGE
pod/ct-web-6d979cf88f-5l77c 1/1 Terminating 0 8m51s
pod/ct-web-6d979cf88f-cbzpk 1/1 Terminating 0 24m
pod/ct-web-6d979cf88f-spbwm 1/1 Terminating 0 24m
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
service/kubernetes ClusterIP 34.118.224.1 <none> 443/TCP 74m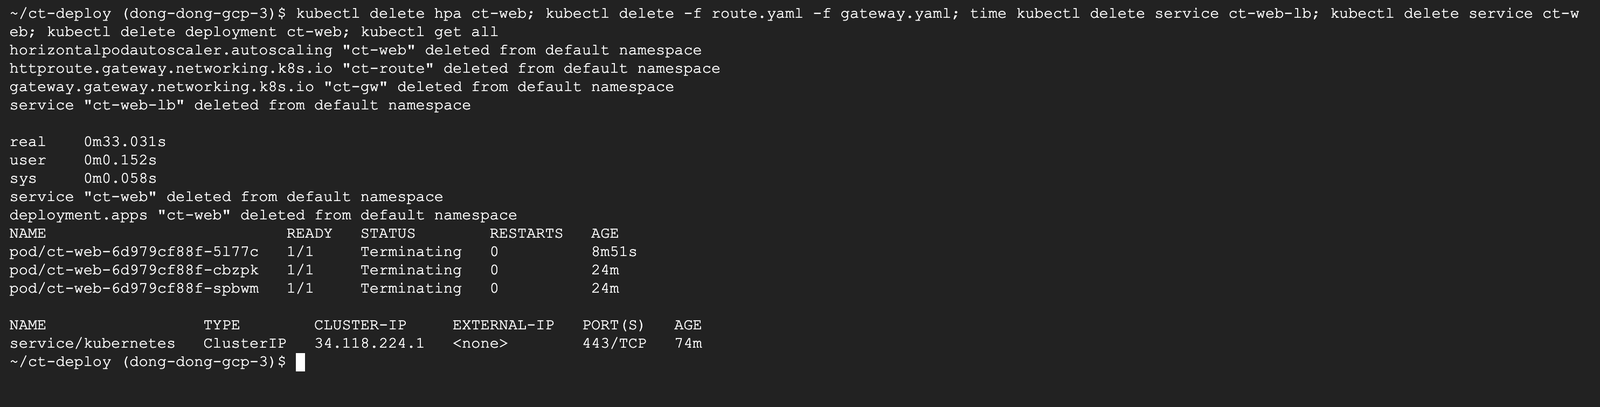
- 刪 LoadBalancer Service 花了 33 秒,
kubectl會等負載平衡器拆完才回來;刪 Gateway 是馬上回來,負載平衡器在背後慢慢拆,所以要另外確認 service/kubernetes是叢集內建的,不要刪
確認負載平衡器真的拆掉了
等 90 秒,查專案裡還有沒有這篇建的轉送規則:
sleep 90; gcloud compute forwarding-rules list --filter="name~ct-gw OR description~ct-web-lb" --format='table(name,region.basename(),IPAddress)'WARNING: The following filter keys were not present in any resource : description, name
這個警告的意思是「專案裡一筆轉送規則都沒有,所以找不到這些欄位」,也就是 LoadBalancer 和 Gateway 的轉送規則都已經刪光了。另外查網路端點群組、後端服務、健康檢查、防火牆規則,跟 ct- 有關的也都是 0 筆(2026 年 11 月實測)。
刪存放區和 Cloud Shell 裡的資料夾
cd ~ && rm -rf ~/ct-deploy && gcloud artifacts repositories delete ct-demo --location=asia-east1 --quiet; gcloud artifacts repositories list --location=asia-east1 --format='value(name.basename())' | grep -c ct-demoDelete request issued for: [ct-demo]
Waiting for operation [projects/dong-dong-gcp-3/locations/asia-east1/operations/5bfdd746-c68f-4005-b3ef-3e0e4e4a5a7f] to complete...
.done.
Deleted repository [ct-demo].
Listing items under project dong-dong-gcp-3, location asia-east1.
0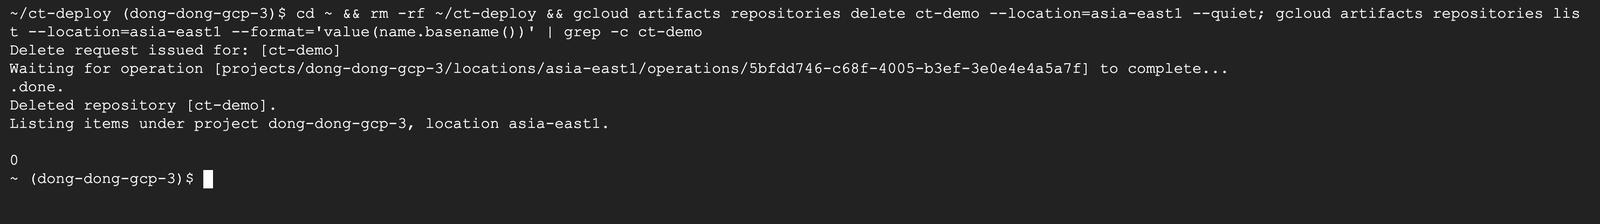
刪存放區會連裡面的映像檔一起刪。最後的 0 是「存放區清單裡 ct-demo 出現 0 次」,確認刪掉了。
刪 Cloud Build 留下的原始碼壓縮檔
gcloud builds submit 上傳的原始碼留在 專案ID_cloudbuild 這個 bucket,bucket 本身不要刪(之後的建置還會用),只刪這次的檔案:
gcloud builds list --region=asia-east1 --filter='images~ct-demo/ct-web' --format='value(id,source.storageSource.bucket,source.storageSource.object)'57381d2b-ae59-4ce7-9e6e-d65903b84049 dong-dong-gcp-3_cloudbuild source/1795234166.275054-49df57e8d2b640cd8f5054eab727cd7a.tgzgcloud storage rm gs://dong-dong-gcp-3_cloudbuild/source/1795234166.275054-49df57e8d2b640cd8f5054eab727cd7a.tgzRemoving gs://dong-dong-gcp-3_cloudbuild/source/1795234166.275054-49df57e8d2b640cd8f5054eab727cd7a.tgz...叢集先留著(第 26 篇會沿用)
kubectl get all; gcloud container clusters list --format='table(name,location,currentMasterVersion,autopilot.enabled,status)'NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
service/kubernetes ClusterIP 34.118.224.1 <none> 443/TCP 76m
NAME: ct-gke
LOCATION: asia-east1
CURRENT_MASTER_VERSION: 1.36.4-gke.2377000
ENABLED: True
STATUS: RUNNING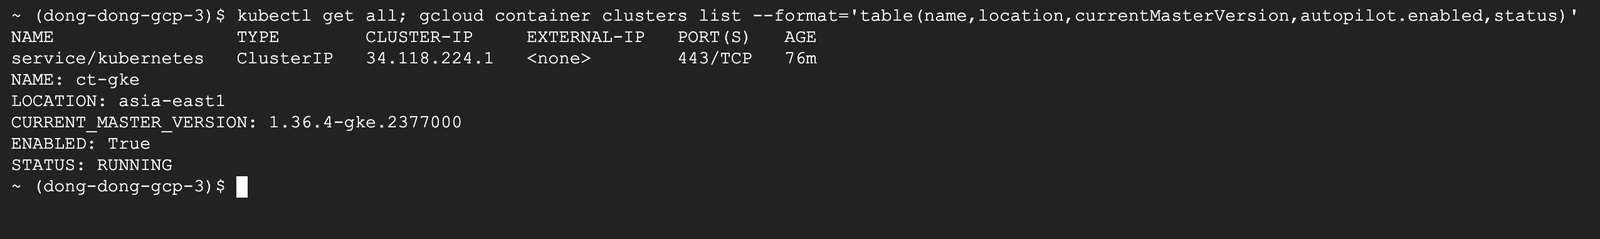
叢集裡只剩內建的 service/kubernetes。這個叢集第 26 篇還會用,所以先不刪。你練習完不打算接著做,就直接刪整個叢集:
gcloud container clusters delete ct-gke --region=asia-east1 --quiet第 26 篇做完會實際刪一次並附上輸出。
不刪會怎麼計費
| 資源 | 不刪的話(asia-east1,2026 年 11 月查) |
|---|---|
| LoadBalancer Service、Gateway | 轉送規則各每小時 0.025 美元,一條一個月約 18 美元,另加流量處理費 |
| Deployment 的 2 個 Pod | 照 requests:一個月約 8.67 美元;沒寫 requests 約 53.73 美元 |
| HPA 擴出來的 Pod | 每多一個,一個月多約 4.34 美元 |
| Artifact Registry 的 50 MB 映像檔 | 每個帳單帳戶每月前 0.5 GiB 免費,超過每 GiB 每月約 0.10 美元(第 19 篇有算法) |
| 空的 Autopilot 叢集 | 管理費每小時 0.10 美元,帳單帳戶當月只有這一個叢集的話被 74.40 美元免費額度抵掉 |
在 Minikube 怎麼做、在 GKE 有什麼不一樣
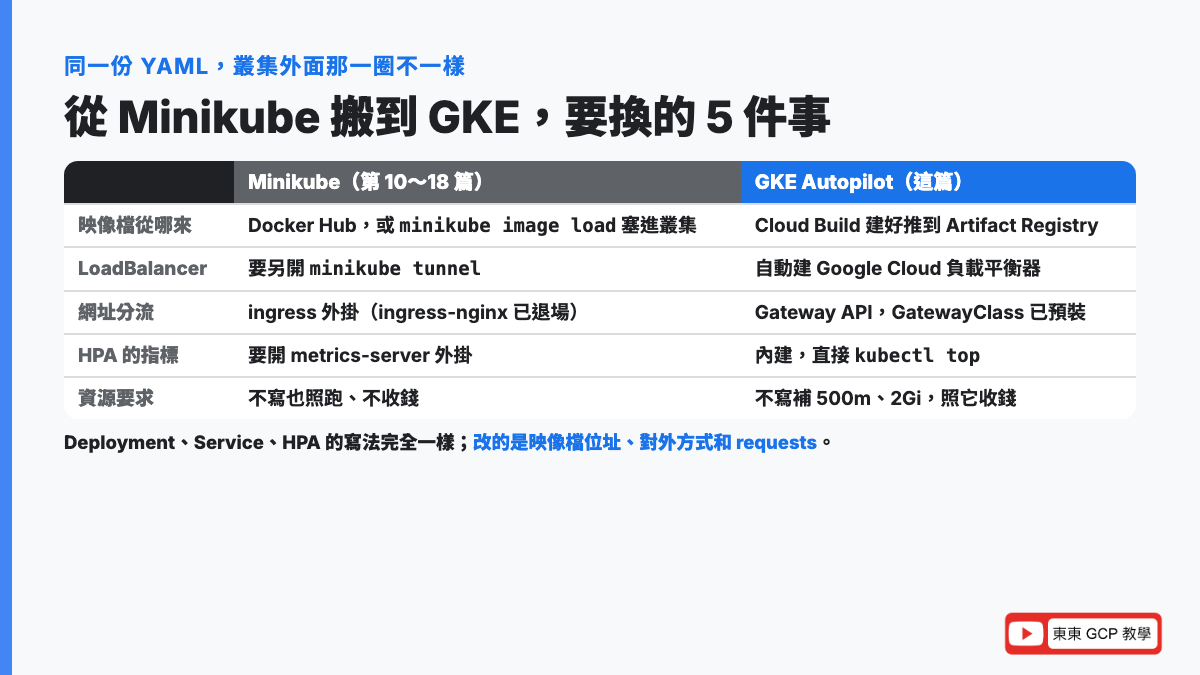
同一套 Deployment、Service、HPA 的寫法,第 10~18 篇在 Minikube、這篇在 GKE 都能用。不一樣的是叢集外面那一圈:
| Minikube(第 10~18 篇) | GKE Autopilot(這篇實測) | |
|---|---|---|
| 映像檔從哪來 | Docker Hub,或 minikube image load 把本機映像檔塞進叢集 | Cloud Build 建好推到 Artifact Registry(26.8 秒) |
image: 怎麼寫 | nginx:1.30 這種短名字 | asia-east1-docker.pkg.dev/專案ID/ct-demo/ct-web:v1 完整位址 |
| LoadBalancer | 要另開 minikube tunnel 才有 IP | 自動建 Google Cloud 負載平衡器,46.7 秒拿到公開 IP |
| 網址分流 | minikube addons enable ingress(ingress-nginx 已退場) | Gateway API,GatewayClass 已預裝,約 4 分鐘能連 |
| HPA 的指標 | 要先 minikube addons enable metrics-server | 內建,kubectl top 直接能用 |
| Pod 放不下時 | Pending,要自己加資源 | Autopilot 自動開節點 |
| 資源要求 | 不寫也照跑、不收錢 | 不寫補 500m、2Gi,照 requests 收錢 |
練 K8s 指令用 Minikube,不花錢;要讓網站真的對外、要自動擴展到多台機器,才上 GKE。
面試/證照會怎麼問
面試常見題
- 「怎麼把一個應用部署到 GKE?」:用 Cloud Build(或 CI/CD)建映像檔推到 Artifact Registry;Deployment 的
image寫 Artifact Registry 的完整位址、寫好 requests 和 readinessProbe;用 LoadBalancer Service 或 Gateway 對外;用 HPA 依 CPU 自動擴展 - 「LoadBalancer Service 和 Ingress、Gateway 怎麼選?」:只有一個服務、只要一個 IP,用 LoadBalancer(第 4 層,最快);要依網址路徑或網域分流、要在入口掛 HTTPS 憑證、多個服務共用一個 IP,用 Gateway(第 7 層),新專案不要再選 Ingress
- 「GKE 節點怎麼有權限拉私人映像檔?」:節點用 Compute Engine 預設服務帳戶(或你指定的節點服務帳戶),需要 Artifact Registry 讀取者角色;同一個專案預設就有,跨專案要另外授權
- 「HPA 在 Autopilot 上擴展時,節點不夠怎麼辦?」:HPA 只負責加 Pod,Pod 放不下時 Autopilot 自動開節點(Standard 要開叢集自動調度器);這也是 Autopilot 擴展比較慢的原因之一
Google Cloud 證照(ACE、PCA)
Associate Cloud Engineer(ACE)是 2 小時、50~60 題單選和複選的情境選擇題,不是上機考,報名費 125 美元、效期 3 年(2026 年 11 月查官方考試頁)。這篇的流程在 ACE 常以「部署容器到 GKE 的正確步驟順序」「讓 Deployment 依 CPU 自動擴展用哪個指令」出題;PCA(雲端架構師)會問「全球使用者、要 HTTPS、要依路徑分流」該選哪種負載平衡器。準備方式可以看雲端架構師證照怎麼準備。
Kubernetes 自己的證照 CKAD、CKA 是上機實作考,kubectl autoscale、kubectl expose、kubectl set image 這類原生指令要很熟;Gateway API 也已經在 CKA 的範圍裡(第 14 篇有整理)。
看到這些字,就想到這個
| 題目關鍵字 | 想到 |
|---|---|
| 「私人映像檔」「GKE 要拉映像檔」「取代 Container Registry」 | Artifact Registry |
| 「不想在本機裝 Docker」「雲端建置」 | Cloud Build(gcloud builds submit) |
| 「依 CPU 使用率自動增減 Pod」 | HPA(kubectl autoscale) |
| 「Pod 不夠放時自動加機器」 | Autopilot 自動開節點/Standard 的叢集自動調度器 |
| 「全球使用者、依路徑分流、HTTPS」 | Gateway(全球外部應用程式負載平衡器) |
| 「只要一個對外 IP、TCP/UDP」 | LoadBalancer Service(直通式網路負載平衡器) |
| 「Autopilot 帳單太高」 | 檢查 requests 有沒有寫、寫太大 |
常見問答
GKE 部署應用要哪幾個步驟?
五步:用 Cloud Build 建映像檔並推到 Artifact Registry;寫 Deployment,image 填 Artifact Registry 的完整位址、寫好 requests;用 kubectl apply 部署;用 LoadBalancer Service 或 Gateway 對外;用 HPA 依 CPU 自動擴展。這篇在 Autopilot 實測:建映像檔 26.8 秒、部署 18.5 秒、LoadBalancer 46.7 秒拿到 IP、Gateway 約 4 分鐘能連(2026 年 11 月)。
GKE 要用 Ingress 還是 Gateway?
新專案用 Gateway。Gateway API 是 Kubernetes 取代 Ingress 的新標準,把「門」和「路由規則」拆開,GKE 叢集已經預裝好 GatewayClass。要對外又不想建 proxy-only 子網路,選 gke-l7-global-external-managed(全球外部應用程式負載平衡器);官方建議不要再用傳統版的 gke-l7-gxlb(2026 年 11 月查官方文件)。
GKE 的 Gateway 建好要多久才能連?
這篇實測(asia-east1,全球外部型):kubectl apply 後 1 分 37 秒狀態變成 Programmed、拿到全球 IP,之後再等 141 秒才回 200,中間先是連不上(000)、再回 404;剛回 200 的頭幾分鐘偶爾還會失敗。同一個叢集的 LoadBalancer Service 是 46.7 秒拿到 IP、馬上能連。
GKE Autopilot 的 requests 要怎麼寫才省錢?
照程式真正用到的量寫,不要不寫。沒寫會被補成 0.5 vCPU、2 GiB,2 個 Pod 一個月約 53.73 美元;這篇寫 100m、128Mi,降到約 8.67 美元。支援爆發的叢集(1.30.2 版以後)最小可以寫 50m、52 MiB,CPU 和記憶體比例要在 1:1 到 1:6.5 之間(2026 年 11 月查官方文件)。
GKE 節點拉不到 Artifact Registry 的映像檔怎麼辦?
先看映像檔位址有沒有寫錯(kubectl describe pod 的事件會寫 ImagePullBackOff,第 18 篇有排錯步驟);位址對的話,是節點的服務帳戶沒有讀取權限。同一個專案預設就能拉;跨專案或專案關掉了預設的 Editor 角色時,要給節點的服務帳戶「Artifact Registry 讀取者」(roles/artifactregistry.reader)。
GKE 上的 HPA 多久會擴展、多久會縮回?
這篇在 GKE Autopilot 實測(目標 CPU 50%、最少 2 最多 10 個):壓力開始後 30 秒內從 2 個擴到 4 個,1 分鐘內到 5 個,剛好是公式 2 × 125% ÷ 50% = 5;停掉壓力後 CPU 1 分鐘就降到 1%,但 Pod 數維持約 8 分鐘才縮成 3 個。縮得慢是因為 HPA 預設有 5 分鐘的縮減穩定視窗,擴展則是 0 秒(2026 年 11 月查官方文件)。
重點整理
- GKE 部署 5 站:Cloud Build 建映像檔 → Artifact Registry 存 → Deployment 跑(寫 requests)→ LoadBalancer 或 Gateway 對外 → HPA 擴展
- requests 是 Autopilot 帳單的開關:2 個 Pod 一個月,沒寫約 53.73 美元、寫 100m、128Mi 約 8.67 美元;這次部署沒出現補資源的警告
- 對外兩條路:LoadBalancer Service 是第 4 層,46.7 秒拿到 IP;Gateway 是第 7 層、能依路徑分流,約 4 分鐘才能連。不想動網路設定就選全球型
gke-l7-global-external-managed - HPA 擴得快、縮得慢:壓測 30 秒內 2 個變 4 個、1 分鐘到 5 個(2 × 125% ÷ 50% = 5);停掉後約 8 分鐘才縮到 3 個,縮減預設有 5 分鐘穩定視窗
- 跟 Minikube 的差別在叢集外面:映像檔要放網路上拿得到的倉庫、LoadBalancer 不用 tunnel、Ingress 換 Gateway、指標內建、節點自動開
延伸閱讀
本系列
- 第 4 篇:Dockerfile 怎麼寫?從零打包你的第一個網頁映像檔
- 第 12 篇:Deployment 教學:自動補位、擴縮、滾動更新與回滾
- 第 13 篇:K8s Service 怎麼選?ClusterIP、NodePort、LoadBalancer 差在哪
- 第 14 篇:Ingress 是什麼?用網址路徑把流量分給不同服務(含 Gateway API)
- 第 17 篇:健康檢查與自動擴展:Probe、資源限制、HPA
- 第 19 篇:Artifact Registry 是什麼?把 Docker 映像檔推上 GCP 教學
- 第 21 篇:Cloud Build 是什麼?用 cloudbuild.yaml 自動建映像檔、部署到 Cloud Run
- 上一篇:第 24 篇:GKE 是什麼?Google Kubernetes Engine 教學:Autopilot 和 Standard 怎麼選
- 下一篇:第 26 篇:Workload Identity 是什麼?GKE 不用金鑰安全存取 GCP 服務
Kubernetes、GKE 相關
- Kubernetes 是什麼?白話解釋+判斷你是否真的需要它
- Helm Charts 是什麼?GKE 上的 Kubernetes 套件管理
- GitOps 是什麼?
- GCP 帳單爆炸防護
- 影片版(五條指令建 GKE 叢集和 HTTP 負載平衡器,2025 年錄製,介面可能跟現在略有不同):[[GKE 教學] 032 五條指令完成 GKE Cluster 和 Http Load Balancer](https://www.youtube.com/watch?v=3f-_I8EyzUY)
站上相關文章
程式已經在 GKE 上自動擴展了,下一篇處理上線前最後一個問題:Pod 要讀 Cloud Storage 這類 GCP 服務時,怎麼不放金鑰也能安全存取。可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。