訓練集、驗證集、測試集怎麼切?常見是 8:1:1,訓練集練習、驗證集調整、測試集最後打分數;有時間順序的資料要照時間切。
這篇一樣用手搖飲料店的銷售紀錄當例子,一步一步算給你看:資料要分幾份、每份多少筆、為什麼測試集不能偷看,以及「照日期排的資料」隨便亂切,分數會假到什麼程度。
為什麼你需要知道
- 分數會騙人:模型拿練習過的資料來考,當然考得好。不切資料,你看到的分數根本不代表上線後的表現
- 時間資料最容易出事:銷售量、股價、網站流量這種「照日期排」的資料,亂切會讓模型偷看到未來,練習時分數超漂亮,一上線就破功
- GCP 預設值要看懂:BigQuery ML 和 AutoML 都會自動幫你切,但切法不一樣。資料少於 500 筆時,BigQuery ML 甚至完全不切
- 證照必考:PMLE 考題很愛問「這份資料應該怎麼切」,尤其是時間序列和資料洩漏
先看全貌:三份資料各做什麼
上一篇〈特徵、標籤、超參數是什麼?〉最後提到:試超參數時,要拿一份「訓練時沒看過」的資料來打分數。這篇就是在講這件事。
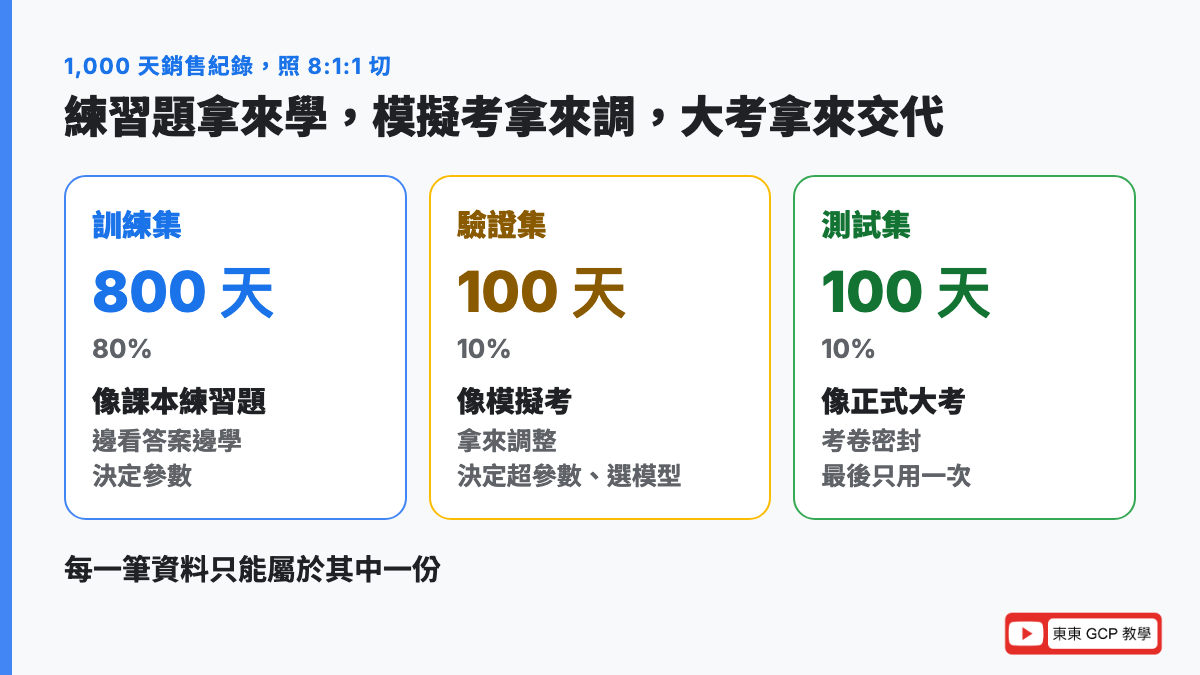
假設店長有 1,000 天的銷售紀錄(教學用的假設數字),每天記氣溫、是不是假日、賣出杯數。照 8:1:1 切:
訓練集 = 1,000 × 80% = 800 天
驗證集 = 1,000 × 10% = 100 天
測試集 = 1,000 × 10% = 100 天| 訓練集(Training Set) | 驗證集(Validation Set) | 測試集(Test Set) | |
|---|---|---|---|
| 白話 | 給模型練習用的資料 | 訓練過程中拿來檢查、調整的資料 | 全部做完,最後打一次分數的資料 |
| 學生比喻 | 課本練習題 | 模擬考 | 正式大考(考卷密封) |
| 飲料店例子 | 800 天 | 100 天 | 100 天 |
| 模型看得到答案嗎 | 看得到,邊看邊學 | 看不到,只拿來打分數 | 看不到,而且只能用一次 |
| 用來決定什麼 | 參數(權重、偏差) | 超參數、要選哪個模型、什麼時候停 | 什麼都不決定,只回報最終成績 |
一句話記:練習題拿來學,模擬考拿來調,大考拿來交代。
訓練集(Training Set)
白話是什麼
訓練集:模型拿來「學」的資料。模型會看裡面的特徵和標籤,一路修正自己的參數。
比喻
就是課本裡的練習題,附解答。學生寫一題、對一次答案、訂正一次,越練越熟。
來龍去脈
Training 就是「訓練」。上一篇講的梯度下降、學習率、訓練輪數,全部都只在訓練集上進行。上一篇算的「每熱 1 度多賣 5 杯」這個權重,就是從訓練集裡學出來的。
為什麼要學
訓練集通常佔最大份(60%~80%),因為模型要看夠多例子才學得會。但也正因為模型「看過答案」,它在訓練集上的分數一定偏高,不能拿來當成績。
驗證集(Validation Set)
白話是什麼
驗證集:訓練過程中,拿來檢查模型學得怎麼樣、幫你做決定的資料。模型不會從它身上學參數。
比喻
就是模擬考。模擬考考不好,你會調整讀書方法:多讀幾遍、換一本參考書。模擬考的分數,是拿來幫你「調整策略」的。
來龍去脈
Validation 是「確認、驗證」的意思:開發途中先驗一下,方向對不對。Google 機器學習速成課程的說法是:驗證集負責模型訓練時的「初步測試」。
它最常拿來決定這三件事:
| 拿驗證集來決定 | 白話 | 上一篇的例子 |
|---|---|---|
| 超參數要設多少 | 讀書計畫怎麼排 | 學習率 0.01、0.1、0.5 哪個好 |
| 要選哪一個模型 | 換哪一本參考書 | 線性迴歸還是決策樹 |
| 什麼時候停止訓練 | 讀到第幾遍就夠了 | 驗證分數開始變差就停(叫提前停止,第 7 篇會講) |
名字有點亂,先講清楚:BigQuery ML 把驗證集叫「評估資料(evaluation data)」,AutoML 的欄位值叫 VALIDATE,有些教材又叫「開發集(dev set)」。指的都是同一份:訓練途中拿來調整的那份。
為什麼要學
沒有驗證集,你就只能拿測試集來調超參數。這樣測試集就變成另一份模擬考,最後再也沒有一份乾淨的資料可以打分數。下面馬上算給你看會發生什麼事。
測試集(Test Set)
白話是什麼
測試集:所有調整都做完之後,最後才拿出來打一次分數的資料。它的分數,是你對外報告「這個模型上線大概有多準」的依據。
比喻
就是正式大考。考卷密封,考前誰都不能看;考完就是最終成績,不能說「這次沒考好,我再調一下重考」。
來龍去脈
Google 機器學習詞彙表說得很直接:每一筆資料只能屬於三份裡的其中一份,同一筆不能同時在訓練集和測試集。
速成課程還提到一個重點:測試集和驗證集用久了會「磨損」(wear out)。同一份資料一直拿來做決定,你就會不知不覺把模型調成「剛好適合這份資料」,分數越來越不可信。解法是定期補新的資料進來。
算一次給你看:為什麼不能拿測試集來挑
上一篇算過:3 種學習率 × 4 種訓練輪數 = 12 組超參數。
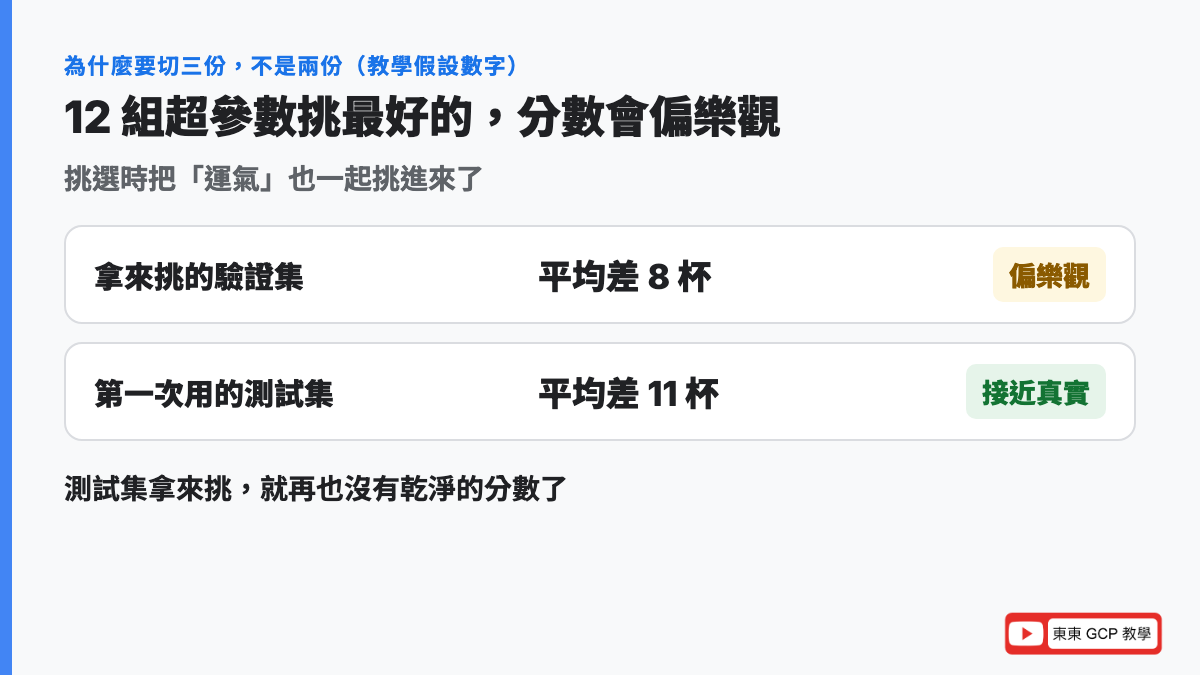
假設(教學用的數字)你把 12 組都訓練完,拿同一份 100 天的資料打分數,誤差最小的那組是 平均差 8 杯。
問題來了:這 8 杯可信嗎?
- 12 組裡,總有一組會「剛好」特別適合這 100 天,可能只是運氣好,例如這 100 天剛好很少下雨
- 你挑了分數最好的那組,等於把運氣也一起挑進來了
- 拿一份完全沒碰過的 100 天再考一次,誤差可能變成 11 杯
| 拿來挑 12 組的資料 | 回報的分數 | 可信嗎 |
|---|---|---|
| 驗證集(100 天) | 平均差 8 杯 | 偏樂觀,因為是挑出來的 |
| 測試集(另外 100 天,第一次用) | 平均差 11 杯 | 比較接近上線後的真實表現 |
數字怎麼看:
- 測試分數比驗證分數差一點:很正常,代表你挑超參數時沾了一點運氣
- 差很多(例如驗證 8 杯、測試 30 杯):模型可能死背了訓練資料(過度擬合,第 7 篇),或資料切法有問題,例如下面要講的時間序列
- 測試分數比驗證好很多:先別高興,檢查測試集是不是混進了訓練資料
這也是為什麼要分三份,不是兩份。只有兩份(訓練+測試),測試集就會被你拿來挑超參數,最後沒有任何一份分數是乾淨的。
比例要怎麼抓?
8:1:1 是常見的起點,但不是規定。原則是:資料越多,驗證集和測試集的「比例」可以越小。
| 資料量 | 常見切法 | 為什麼 |
|---|---|---|
| 幾百筆 | 7:1.5:1.5 或改用交叉驗證 | 驗證、測試太少,分數會很不穩 |
| 幾千到幾萬筆 | 8:1:1 | 最常見的平衡點 |
| 幾十萬筆以上 | 98:1:1 也可以 | 1% 就有幾千筆,已經夠打分數 |
算一次給你看:測試集要多大才夠?
1,000 天 × 10% = 100 天 → 夠用
100 天 × 10%   = 10 天  → 太少,碰上一次颱風,分數就整個歪掉
100 萬筆 × 1% = 1 萬筆 → 綽綽有餘數字怎麼看:測試集太小,分數會一直跳,今天切一次 85 分、換個切法變 70 分,你根本不知道哪個是真的。測試集太大,又會讓訓練集變少,模型學不夠。
資料很少怎麼辦?用交叉驗證(Cross-Validation)。 比喻:只有一本考古題,就輪流把不同章節當模擬考。例如 1,000 筆切成 5 份,每份 200 筆,輪流拿 1 份當驗證、另外 4 份訓練,總共訓練 5 次。假設 5 次的誤差是 10、12、9、11、13 杯,平均起來 11 杯,比只考一次穩。叫「交叉」,是因為每一份資料都輪流當過訓練和驗證。代價是訓練時間變 5 倍。
時間序列為什麼不能亂切
白話是什麼
時間序列(Time Series):照時間順序記錄下來的資料,例如每天的銷售量、每小時的氣溫、每分鐘的股價。飲料店的 1,000 天紀錄就是時間序列。
隨機切分:把資料像洗牌一樣打亂,再抽 80%、10%、10%。
照時間切分:照日期排好,最早的當訓練集,中間的當驗證集,最新的當測試集。
來龍去脈
Series 是「一連串」的意思,時間序列就是照時間排好的一連串數字。這種資料有個特性:相鄰的時間點通常很像,今天很熱,明天多半也熱;這週生意好,下週通常不會差太多。統計上叫自相關(autocorrelation),白話就是「自己跟自己的過去有關」。這正是亂切會出事的根本原因。
比喻
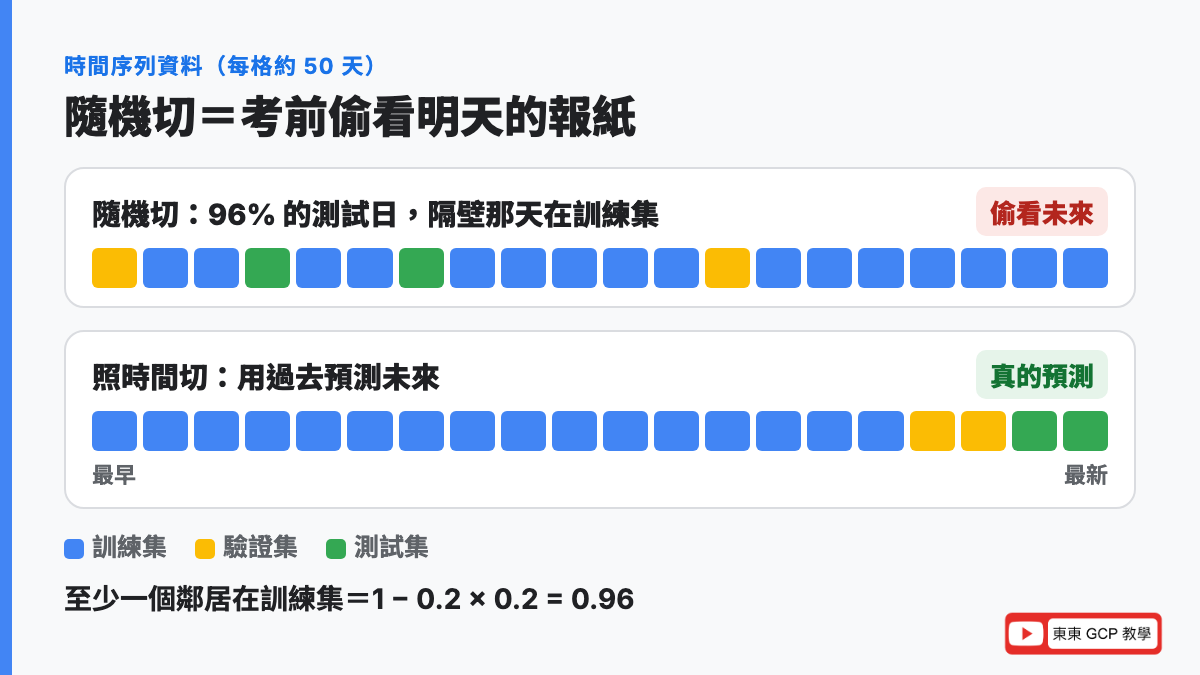
隨機切分時間資料,就像考前把明天的報紙偷偷塞給你。
你要預測 7 月 15 日賣幾杯,結果 7 月 14 日和 7 月 16 日都在訓練集裡。連續兩天的生意通常很像,模型只要「抄隔壁那兩天」就能猜得很準。可是真正上線時,你在 7 月 15 日早上不可能知道 7 月 16 日賣了幾杯。
算一次給你看:隨機切,有多少考題被「洩題」
用 8:1:1 隨機切 1,000 天。挑一個測試集裡的日子,看看它的前一天、後一天有多大機率在訓練集:
前一天在訓練集的機率 = 80% = 0.8
後一天在訓練集的機率 = 80% = 0.8

前後兩天都在訓練集   = 0.8 × 0.8         = 0.64 → 64%
至少有一天在訓練集   = 1 − (0.2 × 0.2)   = 1 − 0.04 = 0.96 → 96%
(0.2 是「不在訓練集」的機率,也就是 1 − 0.8。兩天都不在訓練集的機率是 0.2 × 0.2。)
數字怎麼看:測試集 100 天裡,平均有 96 天的「隔壁那天」模型練習時看過答案,其中 64 天是前後兩天都看過。這不叫考試,這叫開書考。
假設(教學用的數字)結果會像這樣:
| 切法 | 測試集平均誤差 | 代表什麼 |
|---|---|---|
| 隨機切 | 差 6 杯 | 假的好成績,模型偷看了未來 |
| 照時間切(最後 100 天當測試) | 差 15 杯 | 比較接近上線後的真實表現 |
隨機切的分數看起來好很多,店長就會以為「模型很準,備料照它的數字就好」,結果上線後天天備錯。這種「訓練時偷看到不該看的資訊」叫做資料洩漏(Data Leakage),第 8 篇會專門講。
照時間切,要怎麼切
1,000 天照日期排好:
第 1~800 天  → 訓練集(最早的)
第 801~900 天 → 驗證集
第 901~1,000 天 → 測試集(最新的)模型永遠是用過去預測未來,跟真正上線時的情況一模一樣。
進階:滾動式驗證
時間資料不能隨便洗牌,所以一般的交叉驗證也不能直接用。替代做法是滾動式驗證(rolling / expanding window):訓練範圍一段一段往後長,每次都用「後面一段」來驗證。
第 1 次:用第 1~600 天訓練,第 601~700 天驗證
第 2 次:用第 1~700 天訓練,第 701~800 天驗證
第 3 次:用第 1~800 天訓練,第 801~900 天驗證
最後:第 901~1,000 天留給測試集,只用一次比喻:像天氣預報員的訓練,每次都只拿「到昨天為止」的資料來猜今天,猜完再把今天加進去,繼續猜明天。
除了時間,還有 3 個常見的切法陷阱
陷阱 1:重複的資料跨了兩份
同一筆資料不小心出現兩次,一次在訓練集、一次在測試集。模型等於考到練習過的原題。Google 速成課程建議:驗證集、測試集裡和訓練集重複的資料要刪掉,因為公平的考試只能考新題目。
陷阱 2:同一個「群組」被拆散
假設飲料店有 10 間分店,模型上線後要拿去預測新開的分店。如果隨機切,每間分店的資料都會出現在訓練集,模型就熟悉了每一間的生意,測試分數自然好。
正確做法是照分店切:例如 8 間分店當訓練、1 間當驗證、1 間當測試。Google Cloud 的 AutoML 官方文件舉的就是這個例子:要預測沒看過的商店,就要讓測試集裡的商店,跟訓練集完全不重疊。
陷阱 3:稀少的類別被切光了
假設要預測「這筆訂單是不是退貨」,1,000 筆裡只有 20 筆退貨。隨機切出 100 筆測試集:
期望的退貨筆數 = 100 × (20 ÷ 1,000) = 100 × 2% = 2 筆平均只有 2 筆,運氣不好甚至 0 筆。測試集裡根本沒有退貨,就沒辦法知道模型抓不抓得到退貨。解法是分層抽樣(Stratified Sampling):切的時候,讓每一份的退貨比例都維持 2%。AutoML 官方文件特別提醒:它不會幫你做分層抽樣,少數類別要自己用手動切分處理。(類別不平衡在第 9 篇會完整講。)
在 GCP 上怎麼做
GCP(Google Cloud Platform) 是 Google 的雲端服務,白話說就是租用 Google 機房裡的電腦和工具。兩個最常用的機器學習工具,BigQuery ML 和 AutoML,都會自動幫你切資料,但規則不一樣。
1. BigQuery ML:預設切法要看資料有幾筆
- BigQuery:Google 的大型資料倉庫,專門存放和分析超大量的表格資料
- BigQuery ML:讓你用 SQL(跟資料庫說話的語言)直接在 BigQuery 裡訓練模型
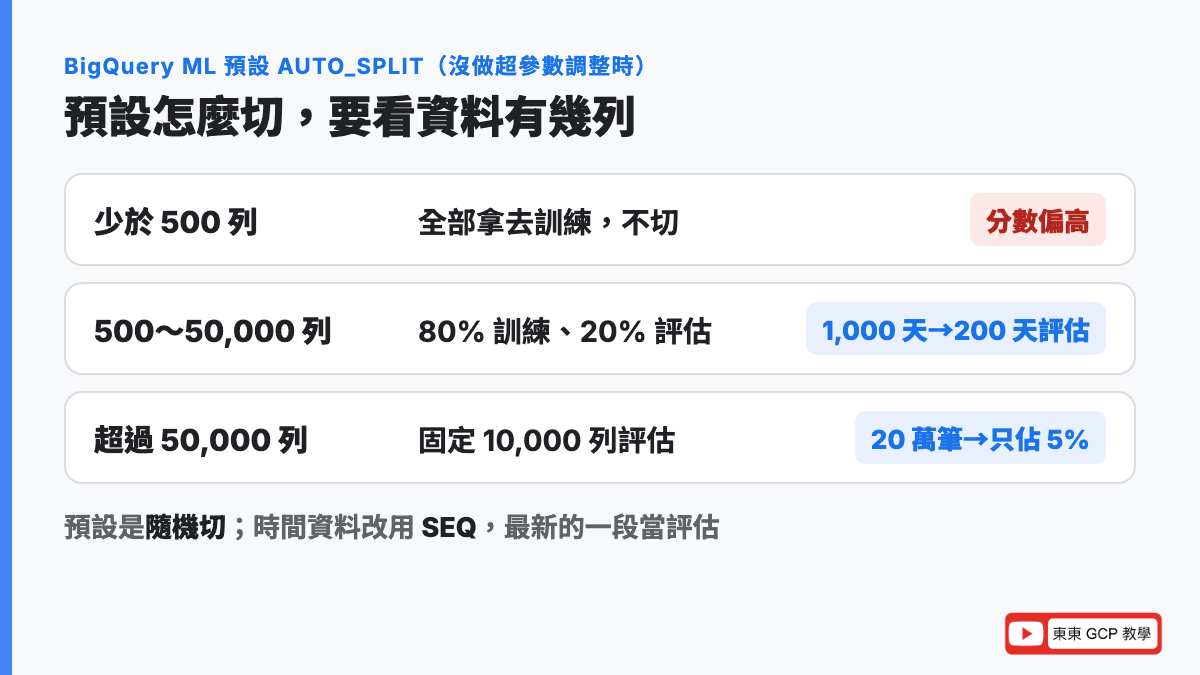
依照官方文件,切法由 DATA_SPLIT_METHOD 決定,預設是 AUTO_SPLIT,規則是:
| 資料有幾列 | 沒做超參數調整時 | 有做超參數調整時 |
|---|---|---|
| 少於 500 列 | 全部拿去訓練,不切 | 全部拿去訓練,不切 |
| 500~50,000 列 | 隨機切:80% 訓練、20% 評估 | 隨機切:80% 訓練、10% 評估、10% 測試 |
| 超過 50,000 列 | 隨機切:固定 10,000 列評估,其他訓練 | 隨機切:80% 訓練、10% 評估、10% 測試 |
(BigQuery ML 把驗證集叫「評估資料」。)
算一次給你看:
飲料店 400 天   → 少於 500 列,全部拿去訓練,沒有評估資料
飲料店 1,000 天 → 評估 = 1,000 × 20% = 200 天,訓練 800 天
連鎖店 200,000 筆 → 評估固定 10,000 筆(只佔 10,000 ÷ 200,000 = 5%),訓練 190,000 筆數字怎麼看:
- 400 天那個最危險:不切資料,你看到的分數就是「考練習題」的分數,一定偏高
- 20 萬筆時評估只佔 5%:資料多,1 萬筆已經夠打分數,剩下的全部拿去學,這就是「資料越多,比例可以越小」
照時間切:用 SEQ
飲料店的資料有日期,就不要用預設的隨機切,改成 SEQ(Sequential,依序):
CREATE MODEL `shop.daily_cups`
OPTIONS(model_type='LINEAR_REG',
        input_label_cols=['cups_sold'],
        data_split_method='SEQ',
        data_split_col='sale_time',
        data_split_eval_fraction=0.2) AS
SELECT sale_time, temperature, is_holiday, cups_sold
FROM `shop.daily_sales`;
翻成白話:
data_split_method='SEQ':照順序切,不要洗牌data_split_col='sale_time':照「銷售時間」這一欄由小排到大(舊的在前)data_split_eval_fraction=0.2:最後 20%(最新的 200 天)拿來評估,前面 800 天訓練
幾個官方文件寫到的細節:
SEQ用的欄位,資料格式要是數字、文字或TIMESTAMP(時間戳記,精確到秒的日期時間)。文件列的型別裡沒有DATE,如果你的日期欄是DATE,先轉成TIMESTAMP比較保險- 拿來切的那一欄會自動被排除,不會被當成特徵
- 有做超參數調整時,再加
data_split_test_fraction,就會切成三份:最後一段測試、倒數第二段評估、其他訓練 - 想自己指定每一列放哪份,用
CUSTOM加一個欄位:沒做調參時是TRUE/FALSE(TRUE是評估),有做調參時是TRAIN/EVAL/TEST - 隨機切也是「固定的隨機」:同一份資料重訓,會切出一樣的結果,方便比較
- 切好的資料會存在暫存表(暫時的表格,時間到自動刪掉)48 小時,要留久一點要自己匯出
2. AutoML on Agent Platform(原 Vertex AI AutoML)
AutoML:只要把資料丟進去,Google 自動幫你挑模型、調超參數的服務,不用寫程式。這個服務所在的平台最近改名了:
舊題庫可能還會看到 Vertex AI AutoML Tables,現在叫 AutoML on Gemini Enterprise Agent Platform。
Google Cloud 在 2026 年 4 月 22 日把 Vertex AI 改名為 Gemini Enterprise Agent Platform(簡稱 Agent Platform),底下功能跟著改名(官方對照表)。功能本身是延續的。
依照官方文件,表格資料有三種切法:
| 切法 | 怎麼切 | 什麼時候用 |
|---|---|---|
| 隨機切分(預設) | 隨機抽 80% 訓練、10% 驗證、10% 測試,比例可以改 | 資料不隨時間變化、類別大致平衡 |
| 手動切分 | 自己加一欄,每列填 TRAIN、VALIDATE、TEST(或只填 TEST 和 UNASSIGNED) | 要照分店切、要確保少數類別有進測試集 |
| 照時間切分 | 指定一個時間欄,最早的訓練、接著驗證、最新的測試 | 資料有時間性,但不是做預測未來數值的模型 |
官方特別寫到的幾個重點:
- 預測(Forecasting)模型預設就照時間切,而且會丟掉「預測範圍跨在兩份之間」的那幾列,就是為了避免資料洩漏
- 照時間切的時間欄,要有夠多不同的值,官方建議至少 20 個,不然驗證集、測試集可能是空的
- 測試集只在最後評估時用一次:AutoML 先用訓練集、驗證集挑出最好的設定,最後才拿測試集算出最終分數
- 分類、迴歸模型最後上線用的版本,會把三份資料合起來再訓練一次,讓模型學到最多。這跟「測試集不能偷看」不衝突:分數已經先用測試集算好了
| 舊名稱 | 現在的名稱 |
|---|---|
| Vertex AI | Gemini Enterprise Agent Platform(Agent Platform) |
| Vertex AI AutoML(Tables) | AutoML on Gemini Enterprise Agent Platform |
| Vertex AI Training | Gemini Enterprise Agent Platform Managed Training |
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南沒有一條直接寫「資料切分」,但它藏在好幾個區塊裡:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 1 區:用低程式碼方式打造 AI 方案(約 13%) | 用 BigQuery ML、AutoML 訓練模型(切分設定就在這裡) |
| 第 2 區:跨團隊管理資料與模型(約 16%) | 評估模型(要用沒看過的資料評估) |
| 第 3 區:把原型擴展成正式模型(約 21%) | 超參數調整、排查訓練問題 |
| 第 5 區:自動化 ML 管線(約 18%) | 驗證資料與模型 |
考題很少問「驗證集的定義」,而是給你一段情境,問哪裡切錯了。
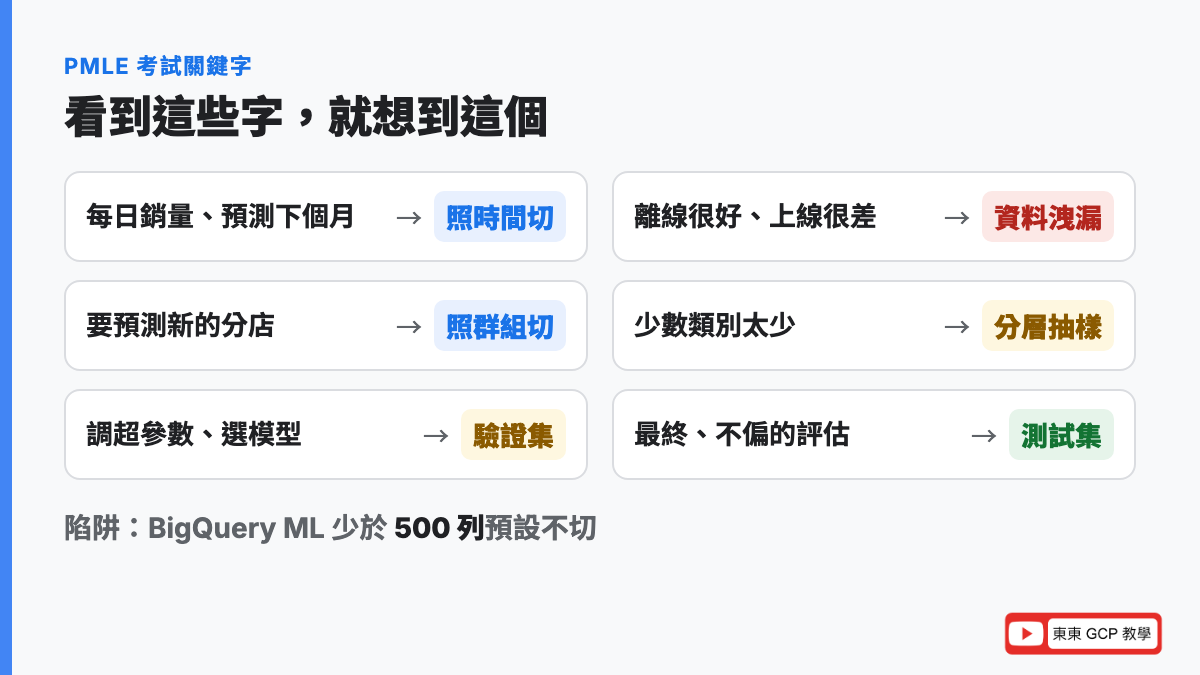
看到這些字,就想到這個
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「依日期」「每天的銷量」「預測下個月」「時間序列」 | 照時間切,最新的當測試集;BigQuery ML 用 SEQ |
| 「離線分數很好,上線後很差」 | 先懷疑資料洩漏,尤其是時間資料被隨機切 |
| 「要預測新的商店/新的客戶」 | 照群組切,同一群不能跨兩份;AutoML 用手動切分 |
| 「少數類別很少,測試集可能抽不到」 | 分層抽樣或手動切分(AutoML 不會自動分層) |
| 「調超參數」「選模型」「提前停止」 | 用驗證集,不是測試集 |
| 「最終、不偏的評估」 | 測試集,只用一次 |
| 「資料很少」「分數不穩定」 | 交叉驗證 |
| 「AutoML 預設怎麼切」 | 分類、迴歸隨機 80/10/10;預測模型照時間切 |
三個常見陷阱
- 拿測試集調超參數:選項寫「用測試集比較多組超參數,挑最好的」,錯。挑選要用驗證集
- 時間序列用隨機切:選項寫「隨機打散後切 80/20」,對時間資料來說通常是錯的
- 以為 BigQuery ML 一定會切:資料少於 500 列時,預設全部拿去訓練,看到的評估分數其實是訓練分數
練習情境(自己出的練習,不是真實考題)
一間連鎖飲料店有 3 年的每日銷售資料,用 BigQuery ML 訓練模型預測下週銷量。資料科學家用預設設定訓練,評估分數非常好,但上線一個月後,預測和實際差很多。最可能的原因是什麼?該怎麼改?
判斷過程:
- 「每日銷售」「預測下週」→ 這是時間序列
- 「預設設定」→ BigQuery ML 預設
AUTO_SPLIT是隨機切 - 「評估很好、上線很差」→ 隨機切讓模型偷看了前後幾天,是資料洩漏
- 改法:
data_split_method='SEQ',data_split_col指定日期欄,讓最新的一段資料當評估資料
常見問答
訓練集、驗證集、測試集的比例要怎麼抓?
常見起點是 80%、10%、10%。資料只有幾百筆時,驗證、測試集要多留一點,或改用交叉驗證;資料有幾十萬筆以上,驗證、測試集各 1% 就夠。原則是測試集的筆數要夠多,分數才會穩定。
驗證集和測試集差在哪?
驗證集在訓練過程中拿來調超參數、選模型、決定什麼時候停,像模擬考;測試集是全部調完之後,最後才打一次分數,像正式大考。驗證集會被拿來做決定,所以分數會偏樂觀;測試集只用一次,分數才可信。
一定要切三份嗎?只切訓練集和測試集可以嗎?
只切兩份的話,你調超參數時就只能看測試集,測試集等於變成模擬考,最後沒有一份乾淨的資料能打分數。如果完全不調超參數、不選模型,兩份勉強可以;要調整,就要三份,或用交叉驗證代替驗證集。
時間序列資料為什麼不能隨機切?
因為隨機切會讓模型在訓練時看到「未來」的資料。用 8:1:1 隨機切每日資料,測試集裡約 96% 的日子,前一天或後一天在訓練集裡,模型抄隔壁天就能猜得很準,但真正上線時你不會知道明天的答案。時間資料要照時間切,最新的當測試集。
BigQuery ML 預設會怎麼切資料?
預設是 AUTO_SPLIT:少於 500 列全部拿去訓練、不切;500 到 50,000 列隨機切 80% 訓練、20% 評估;超過 50,000 列固定 10,000 列評估。有做超參數調整時是 80%、10%、10%。時間資料要改用 SEQ 並指定日期欄。
交叉驗證是什麼?什麼時候用?
交叉驗證是把資料分成幾份,輪流拿其中一份當驗證、其他拿來訓練,最後把分數平均。例如 5 折交叉驗證要訓練 5 次。資料很少、只切一次分數不穩時特別有用,代價是訓練時間變成好幾倍。時間資料要改用滾動式驗證。
Vertex AI AutoML 的資料切分現在叫什麼?
Vertex AI 在 2026 年 4 月 22 日改名為 Gemini Enterprise Agent Platform(簡稱 Agent Platform),AutoML 現在叫 AutoML on Gemini Enterprise Agent Platform。切分規則延續:分類、迴歸預設隨機 80/10/10,預測模型預設照時間切,也可以用手動切分欄位指定 TRAIN、VALIDATE、TEST。
重點整理
- 訓練集拿來學參數,驗證集拿來調超參數和選模型,測試集最後只用一次,回報真實成績
- 常見比例 8:1:1;資料越多,驗證、測試的比例可以越小;資料很少就用交叉驗證
- 時間序列要照時間切:隨機切時,約 96% 的測試日隔壁那天在訓練集,等於偷看未來,是資料洩漏
- 另外三個陷阱:重複資料跨兩份、同一群組被拆散、少數類別沒進測試集(用分層抽樣)
- BigQuery ML 預設
AUTO_SPLIT,少於 500 列不切,時間資料改用SEQ;AutoML(原 Vertex AI,現為 Gemini Enterprise Agent Platform)預設隨機 80/10/10,預測模型照時間切
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 上一篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 下一篇:第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
站上相關文章
- AI 教學:正則化(Regularization),過度擬合(Overfitting)的解決方法
- BigQuery 不就是查詢嗎?跟資料庫差在哪裡?能做什麼分析?
- End-to-end Training(端到端訓練)是什麼?
- GCP 學習路徑 Learning Roadmap 和八大關卡
資料切對了,你看到的分數才是真的;切錯了,模型再厲害都只是在考練習題。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。