特徵、標籤、超參數是什麼?特徵是模型拿來判斷的線索,標籤是要它學會的正確答案,超參數是訓練前由人設定的學習方式。
再加上「樣本」和「參數」,這 5 個名詞就是機器學習的基本詞彙,後面每一篇都會用到。這篇一樣用手搖飲料店當例子,把 5 個名詞放進同一張表、同一個公式裡,一步一步算給你看。
為什麼你需要知道
- 看不懂任何教學:機器學習的文章、課程、官方文件,開口閉口都是「特徵」「標籤」「超參數」。這 3 個字卡住,後面全部讀不下去
- 最容易搞混的一組:「參數」和「超參數」只差一個字,意思完全不同。很多人學了半年還分不清,考試也最愛拿這個出題
- GCP 上每一步都要填:在 BigQuery ML 訓練模型,你要指定哪一欄是標籤、哪些欄是特徵、超參數設多少。名詞不懂,連設定畫面都看不懂
- 證照必考:PMLE 官方考試指南裡,「特徵工程」「Feature Store」「超參數調整」分散在好幾個大區塊,都是建在這 5 個名詞上
先看全貌:一張表看懂 5 個名詞
上一篇〈分類和迴歸差在哪?〉用飲料店預測「明天賣幾杯珍奶」。這篇沿用同一個例子。
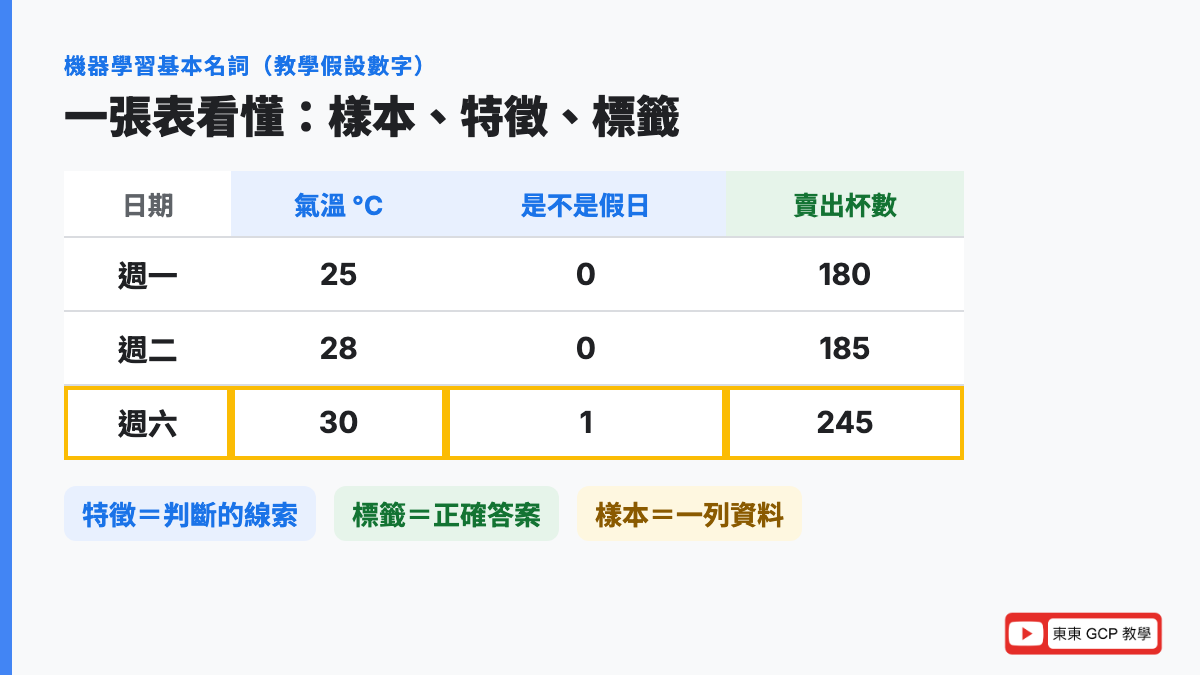
假設店長手上有過去的銷售紀錄,長這樣(教學用的假設數字):
| 日期 | 氣溫(°C) | 是不是假日 | 賣出杯數 |
|---|---|---|---|
| 週一 | 25 | 否(0) | 180 |
| 週二 | 28 | 否(0) | 185 |
| 週六 | 30 | 是(1) | 245 |
這張表裡就藏了 3 個名詞:
- 每一列(一天的紀錄)= 一個樣本
- 「氣溫」「是不是假日」這兩欄 = 特徵
- 「賣出杯數」這一欄 = 標籤
另外 2 個名詞,參數和超參數,不在表裡,而是在「模型」和「訓練過程」裡。先用一張總表記住,下面一個一個拆開講:
| 名詞 | 白話 | 飲料店例子 | 誰決定的 |
|---|---|---|---|
| 樣本(Example) | 一筆資料,表格的一列 | 週六那天的紀錄 | 你收集來的 |
| 特徵(Feature) | 拿來判斷的線索 | 氣溫、是不是假日 | 你挑的 |
| 標籤(Label) | 要學會的正確答案 | 賣出杯數 | 你準備的 |
| 參數(Parameter) | 模型自己學出來的數字 | 「每熱 1 度多賣 5 杯」的 5 | 模型自己學的 |
| 超參數(Hyperparameter) | 訓練前由人設定的學習方式 | 學習率、要訓練幾輪 | 人設定的 |
表格裡的「列」是橫的一行,一列代表一筆紀錄;「欄」是直的一行,一欄代表一種資訊。這兩個字後面會一直出現。
名詞 1:樣本(Example)
白話是什麼
樣本:一筆資料,就是表格裡的一列。
比喻
就像一本考古題裡的一道題目。整本考古題是資料集,每一題就是一個樣本。
來龍去脈
Google 的機器學習詞彙表把它叫 Example(範例),定義是「一列特徵的值,可能再加上標籤」。統計學習慣叫 Sample(樣本)或觀測值,指的都是同一件事。台灣的中文教材「樣本」最常見,這篇統一用樣本。
樣本分兩種,差別在有沒有附答案:
| 有標籤的樣本(Labeled Example) | 沒標籤的樣本(Unlabeled Example) | |
|---|---|---|
| 長怎樣 | 特徵+標籤 | 只有特徵 |
| 飲料店例子 | 週六:30 度、假日、賣了 245 杯 | 明天:32 度、假日、賣幾杯?還不知道 |
| 什麼時候用 | 訓練時(給模型練習) | 預測時(叫模型回答) |
為什麼要學
模型能學多好,很大一部分看樣本夠不夠多、夠不夠有代表性。只收集了夏天的樣本,模型就不知道冬天會怎樣。之後講資料切分、類別不平衡,都是在處理「樣本」的問題。
名詞 2:特徵(Feature)
白話是什麼
特徵:模型拿來做判斷的線索,就是表格裡「答案以外」的那些欄位。
比喻
就像你在人群裡認朋友,看的是「身高、髮型、走路的樣子」。這些用來辨認的線索就是特徵。
飲料店店長憑經驗猜明天生意,腦中想的也是線索:「明天很熱、又是週末,應該會很忙。」氣溫、是不是週末,就是他在用的特徵。
來龍去脈
Feature 的原意是「特點、明顯的特色」,像臉部特徵。在機器學習裡,Google 詞彙表的定義是「模型的輸入變數」,也就是餵進模型的東西。
一個樣本通常有好幾個特徵,把它們排成一串,例如 [30, 1](30 度、假日),這一串叫特徵向量(Feature Vector)。看到這個詞,想成「一筆資料的所有線索排成一排」就好。
特徵的兩種樣子
| 種類 | 白話 | 飲料店例子 |
|---|---|---|
| 數值特徵 | 本身就是數字,可以比大小 | 氣溫 30 度、會員年齡 28 歲 |
| 類別特徵 | 幾個選項之一 | 天氣(晴/雨/陰)、分店(台北/台中) |
模型只看得懂數字,所以類別特徵要先轉成數字。例如「是不是假日」轉成 1 和 0。更複雜的轉法會在第 10、11 篇(資料前處理、特徵工程)講。
為什麼要學
特徵挑得好不好,常常比模型選得好不好更重要。
想像店長只看「今天星期幾」來猜生意,完全不管天氣,颱風天也照樣備一堆料,一定猜不準。挑出真正有影響的線索,叫做特徵選擇;把原始資料加工成更好用的線索,叫做特徵工程。這兩件事都在 PMLE 考試範圍裡。
名詞 3:標籤(Label)
白話是什麼
標籤:每一個樣本的正確答案,也就是你想讓模型學會預測的那一欄。
比喻
就是考古題後面附的解答。學生寫完題目對答案,才知道自己錯在哪。
來龍去脈
Label 原意是「貼在東西上的標示」。早期要訓練模型認貓狗照片,得先請人一張一張看,貼上「貓」「狗」的標示,所以叫標籤。這個「請人貼答案」的工作,到現在還叫資料標註(Data Labeling),Google Cloud 也有提供標註服務。
Google 詞彙表的定義是:在監督式學習裡,樣本的「答案」或「結果」那一部分。
標籤長什麼樣子,決定了你在做哪一種學習:
| 標籤長這樣 | 是哪一種 | 飲料店例子 |
|---|---|---|
| 一個選項 | 分類 | 會員會不會回來? |
| 一個數字 | 迴歸 | 明天賣幾杯? |
| 沒有標籤 | 非監督式學習 | 把會員自動分群,事先不知道有哪幾群 |
最後一列很重要:不是每種機器學習都有標籤。第 1 篇講過,非監督式學習就是「沒有答案,自己找規律」,所以只有特徵、沒有標籤。
為什麼要學
兩個最常見的坑都跟標籤有關:
- 標籤錯了,模型就學錯:解答本印錯,學生越練越歪。標註品質是很多專案失敗的真正原因
- 把答案混進特徵裡:例如想預測「今天賣幾杯」,卻把「今天的營業額」也當成特徵。營業額根本就是賣出杯數算出來的,等於讓模型偷看答案,練習時分數超高,真的上線就破功。這種狀況叫資料洩漏(Data Leakage),第 8 篇會專門講
名詞 4:參數(Parameter)
白話是什麼
參數:模型在訓練過程中自己學出來的數字。訓練完,這些數字就是模型學到的「經驗」。
比喻
就像資深店員腦中的直覺:「每熱 1 度大概多賣 5 杯,週末再多 40 杯。」這個 5 和 40 不是誰教他的,是他看了幾百天的生意自己摸出來的。
來龍去脈
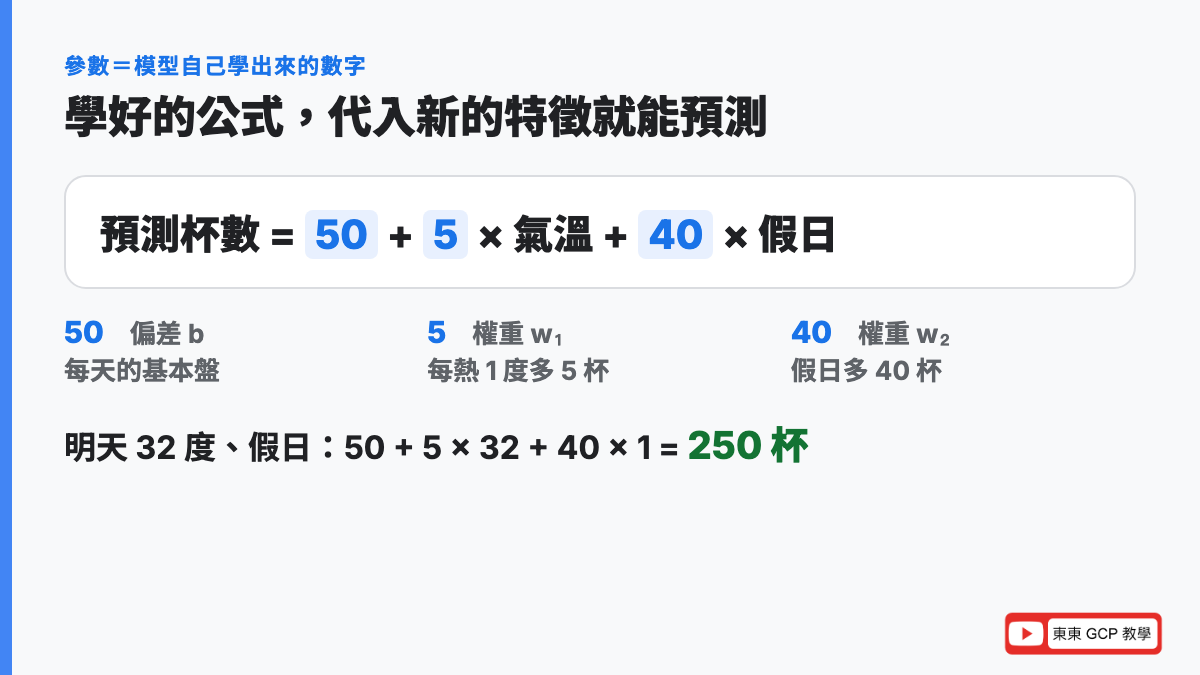
Parameter 是數學用語,指公式裡的係數。以最簡單的線性迴歸為例,模型其實就是一條公式:
預測杯數 = b + w₁ × 氣溫 + w₂ × 是不是假日公式裡的 b、w₁、w₂ 就是參數,有兩種:
- 權重(Weight,w):每個特徵「有多重要」。
w₁是氣溫的權重,意思是每熱 1 度多賣幾杯 - 偏差(Bias,b):不管特徵是多少,都會有的「基本量」。就像就算 0 度、平日,也還是會有一些固定客人
這裡的「偏差」是數學上的意思(公式的起點),跟 AI 倫理講的「偏見」不一樣,英文都叫 bias,看到時要分清楚。
算一次給你看
假設模型訓練完,學到的參數是(教學假設的數字):
| 參數 | 學到的值 | 白話意思 |
|---|---|---|
| b(偏差) | 50 | 基本盤,每天至少 50 杯 |
| w₁(氣溫的權重) | 5 | 每熱 1 度,多賣 5 杯 |
| w₂(假日的權重) | 40 | 假日比平日多 40 杯 |
把前面那張表的樣本代進去,看看模型猜得準不準:
週一(25 度、平日):50 + 5 × 25 + 40 × 0 = 50 + 125 + 0  = 175 杯(實際 180,差 5 杯)
週二(28 度、平日):50 + 5 × 28 + 40 × 0 = 50 + 140 + 0  = 190 杯(實際 185,差 5 杯)
週六(30 度、假日):50 + 5 × 30 + 40 × 1 = 50 + 150 + 40 = 240 杯(實際 245,差 5 杯)
每天都只差 5 杯,這組參數學得不錯。現在拿一個沒標籤的樣本來預測:
明天(32 度、假日):50 + 5 × 32 + 40 × 1 = 50 + 160 + 40 = 250 杯這就是「預測」:把新的特徵代進學好的公式,算出答案。
數字怎麼看:
- 權重越大:這個特徵影響越大。
w₂ = 40比w₁ = 5大,但不代表假日比氣溫重要,因為氣溫的數字本身很大(25~32),乘起來影響其實也不小 - 權重是負的:代表這個特徵越大,答案越小。例如「下雨量」的權重可能是負的,雨越大賣越少
- 權重接近 0:這個特徵幾乎沒用,可以考慮拿掉
為什麼要學
「訓練模型」這件事,說穿了就是找出一組最好的參數。之後看到「模型檔案」,裡面存的主要就是這些數字。簡單的模型只有幾個參數;大型語言模型的參數動輒幾十億、幾千億個,「參數量」就是在講這個。
名詞 5:超參數(Hyperparameter)
白話是什麼
超參數:訓練開始之前,由人設定的數字,用來控制「模型要怎麼學」。
比喻
把模型想成一個準備考試的學生:
- 參數=學生腦中學到的知識。是他自己讀出來的,別人沒辦法直接塞給他
- 超參數=老師幫他排的讀書計畫:一次讀幾題才對答案、整本要讀幾遍、每次訂正要改多大
讀書計畫排得好,同一個學生可以考得更好;排得爛,再聰明也學不起來。
來龍去脈
「超」(Hyper)是「在……之上」的意思。超參數就是管參數的參數:它不直接出現在模型的公式裡,而是在上面一層,控制參數怎麼被學出來。
Google 詞彙表的說法很清楚:參數是模型在訓練中學到的;超參數是你(或超參數調整服務)提供給模型的。
常見的超參數
| 超參數 | 白話 | 讀書計畫比喻 |
|---|---|---|
| 學習率(Learning Rate) | 每次修正參數時,改多大 | 每次訂正,觀念要改多少 |
| 批次大小(Batch Size) | 看幾個樣本才修正一次 | 做幾題才對一次答案 |
| 訓練輪數(Epochs) | 整份資料要看幾遍 | 整本考古題讀幾遍 |
| 正則化強度(Regularization) | 懲罰模型「死背」的力道 | 規定不准只背答案,要懂觀念 |
| 樹的深度、網路層數 | 模型本身要多複雜 | 學生腦容量開多大 |
正則化是解決「死背」(過度擬合)的方法,第 7 篇會完整講;站上也有一篇正則化的介紹可以先看。
算一次給你看 1:學習率設多少,差很多
模型是怎麼「學」出參數的?最常見的方法叫梯度下降(Gradient Descent)。
比喻:你在大霧的山上,想走到山谷最低點(誤差最小的地方),但看不到路。你只能用腳感覺腳下的坡往哪邊斜,然後往下坡方向跨一步。一直重複,就會慢慢走到谷底。
- 「坡往哪邊斜、斜多少」叫梯度,是模型自己算出來的
- 「每一步跨多大」就是學習率,是人設定的超參數
更新參數的公式:
新的參數 = 舊的參數 − 學習率 × 梯度情境(教學簡化的數字):我們只看氣溫的權重 w₁。最理想的值是 5(每熱 1 度多賣 5 杯),但模型一開始是亂猜的,猜成 3。在 w₁ = 3 這個位置,模型算出的梯度是 −20(負號代表「往大的方向調,誤差會變小」)。
三種學習率,各走一步:
學習率 0.01:3 − 0.01 × (−20) = 3 + 0.2 = 3.2
學習率 0.1 :3 − 0.1  × (−20) = 3 + 2   = 5
學習率 0.5 :3 − 0.5  × (−20) = 3 + 10  = 13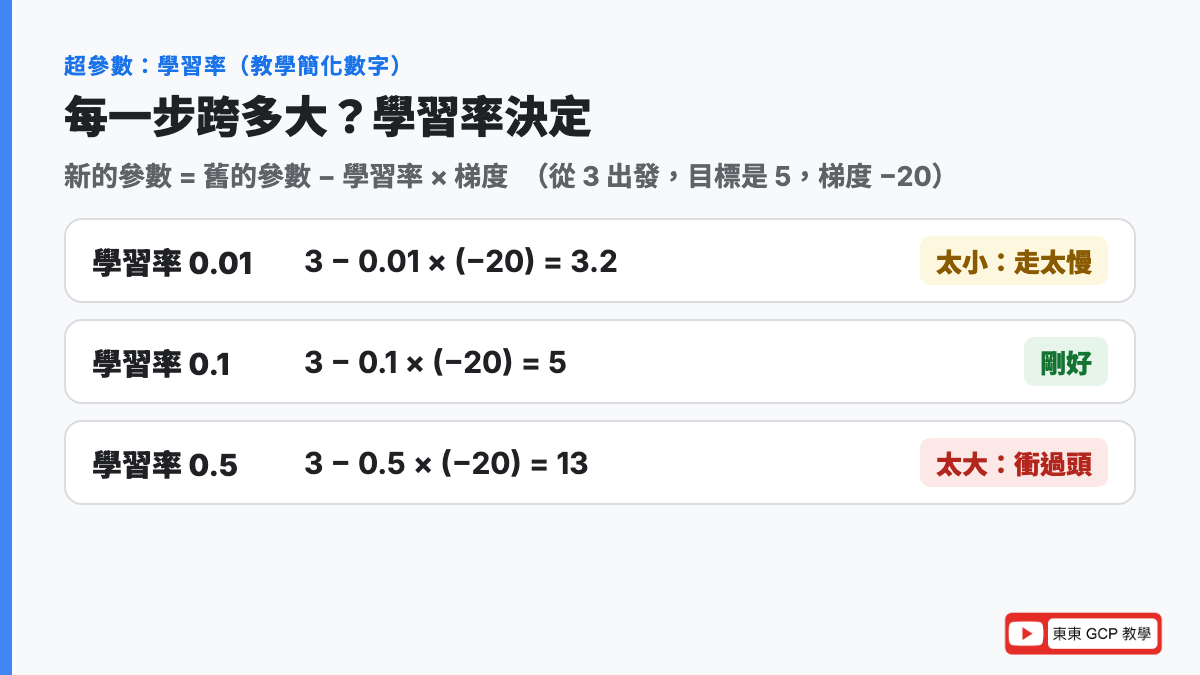
數字怎麼看:
- 0.01(太小):只從 3 走到 3.2,離 5 還很遠。不是錯,是太慢,要走很多步、花很多訓練時間
- 0.1(剛好):一步就到 5。實際訓練每走一步梯度都會重新計算,很少一步到位,但方向和速度都對
- 0.5(太大):直接衝到 13,比原本的 3 離 5 更遠了。下一步可能又衝回另一邊,在谷底兩側跳來跳去,一直停不下來
w₁ = 13 在現實中代表什麼?模型會以為「每熱 1 度多賣 13 杯」,週六 30 度、假日就會預測 50 + 13 × 30 + 40 = 480 杯,實際只賣 245 杯。店長照這個備料,一半要倒掉。
Google 機器學習速成課程的說法一樣:學習率太低,要很久才能收斂;太高,誤差會上下亂跳、甚至越來越大。「收斂」的意思是誤差降到差不多不再變化,模型學得差不多了。
算一次給你看 2:批次大小和訓練輪數
假設店長有 1,000 天的銷售紀錄(1,000 個樣本),設定:
- 批次大小 = 50(每看 50 天的資料,修正一次參數)
- 訓練輪數 = 10(整份資料看 10 遍)
一輪要修正幾次 = 樣本數 ÷ 批次大小 = 1,000 ÷ 50 = 20 次
總共修正幾次 = 20 次 × 10 輪 = 200 次數字怎麼看:
- 批次調大(例如 500):一輪只修正 2 次,每次看得比較全面、比較穩,但修正次數少,可能學不夠
- 批次調小(例如 1):一輪修正 1,000 次,學得快,但每次只看 1 天,容易被特例帶著走,走起來歪歪扭扭
- 輪數太少:還沒學會就停了;輪數太多:開始死背訓練資料,遇到新資料反而變差(過度擬合,第 7 篇)
這也是為什麼超參數沒有標準答案,要試。
參數 vs 超參數:一張表比完
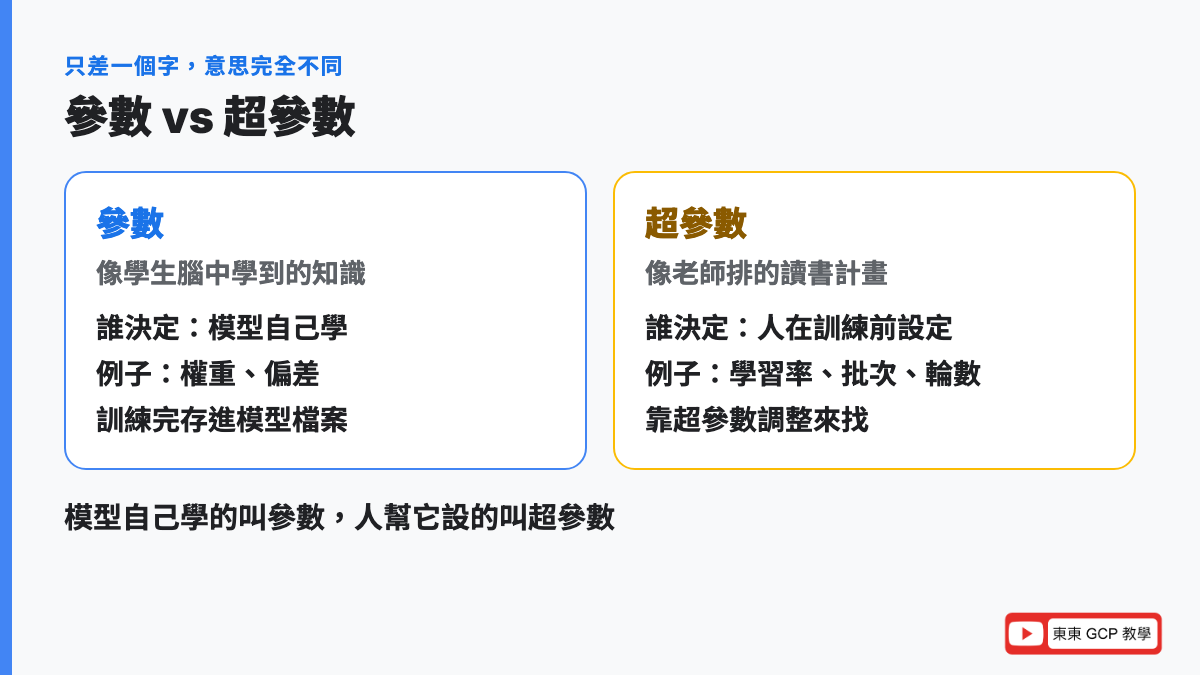
| 參數(Parameter) | 超參數(Hyperparameter) | |
|---|---|---|
| 誰決定 | 模型在訓練中自己學 | 人在訓練前設定 |
| 什麼時候定下來 | 訓練過程中一直在變,訓練完才固定 | 訓練開始前就定好 |
| 比喻 | 學生腦中的知識 | 老師排的讀書計畫 |
| 例子 | 權重(w)、偏差(b) | 學習率、批次大小、訓練輪數、正則化強度 |
| 存在哪裡 | 存在模型檔案裡,預測時要用 | 只在訓練時用,預測時用不到 |
| 怎麼找到好的值 | 訓練(梯度下降) | 超參數調整(試很多組,挑最好的) |
一句話記住:模型自己學的叫參數,人幫它設的叫超參數。
超參數調整:怎麼找到最好的設定
既然超參數要試,就有方法幫你自動試,叫做超參數調整(Hyperparameter Tuning)。
比喻:像在找最好喝的珍奶配方,糖度、冰塊、珍珠煮幾分鐘都要試。每一種組合泡一杯、請客人試喝打分數,最後選分數最高的那杯。每泡一杯,就是一次「試驗(Trial)」。
常見的三種試法:
| 方法 | 白話 | 珍奶比喻 |
|---|---|---|
| 網格搜尋(Grid Search) | 列出所有組合,全部試一遍 | 每種糖度配每種冰塊,全部泡一輪 |
| 隨機搜尋(Random Search) | 在範圍內隨機抽幾組來試 | 隨便抽 10 種組合來泡 |
| 貝氏最佳化(Bayesian Optimization) | 根據前面試過的分數,猜下一組最可能更好的 | 發現半糖少冰分數高,下一杯就往附近試 |
算一次給你看(教學假設的數字):想試 3 種學習率(0.01、0.1、0.5)和 4 種訓練輪數(5、10、20、40),用網格搜尋:
要試幾組  = 3 × 4 = 12 組
一組訓練 10 分鐘,一組一組排隊跑:12 × 10 = 120 分鐘
同時跑 4 組(平行):12 ÷ 4 = 3 批,3 × 10 = 30 分鐘數字怎麼看:超參數每多一種、每種多幾個選項,組合數是相乘往上跳的。再加一個有 5 個選項的超參數,就變成 60 組。所以超參數一多,大家就不用網格搜尋全部試,改用隨機搜尋或貝氏最佳化,用比較少的次數找到夠好的組合。
平行跑是指同時開好幾台電腦一起訓練,等的時間變短,但總共用掉的運算量一樣,雲端費用不會比較少。
試超參數時,要拿一份「訓練時沒看過」的資料來打分數,不然模型只是把練習題背熟了。這份資料叫驗證集,下一篇(第 4 篇)會講怎麼切。
在 GCP 上怎麼做
GCP(Google Cloud Platform) 是 Google 的雲端服務,白話說就是租用 Google 機房裡的電腦和工具。5 個名詞在 GCP 上最直接看得到的地方,是 BigQuery ML。
1. BigQuery ML:一段 SQL 看到 5 個名詞
- BigQuery:Google 的大型資料倉庫,專門存放和分析超大量的表格資料
- SQL:一種「跟資料庫說話」的語言,用來查詢、整理資料
- BigQuery ML:讓你用 SQL 直接在 BigQuery 裡訓練模型
CREATE MODEL `shop.daily_cups`
OPTIONS(model_type='LINEAR_REG',
        input_label_cols=['cups_sold'],
        optimize_strategy='BATCH_GRADIENT_DESCENT',
        learn_rate_strategy='CONSTANT',
        learn_rate=0.1,
        max_iterations=10) AS
SELECT temperature, is_holiday, cups_sold
FROM `shop.daily_sales`;
一行一行對回這篇的名詞:
| 程式裡的 | 是哪個名詞 | 白話 |
|---|---|---|
FROM shop.daily_sales 的每一列 | 樣本 | 每一天的銷售紀錄 |
temperature、is_holiday | 特徵 | 氣溫、是不是假日 |
input_label_cols=['cups_sold'] | 標籤 | 告訴它「賣出杯數」是答案 |
learn_rate=0.1、max_iterations=10 | 超參數 | 學習率 0.1、最多訓練 10 輪 |
| 訓練完模型裡存的數字 | 參數 | 每個特徵的權重 |
依照官方文件,幾個要注意的細節:
- 沒寫
input_label_cols的話,它會找名字叫label的欄位當標籤 - 學習率預設是自動找(
LINE_SEARCH),要自己指定learn_rate,得先把learn_rate_strategy改成CONSTANT - 線性迴歸在資料不多時,預設可能直接用公式一次解出參數,不走梯度下降,這時學習率用不到。所以範例裡寫明
optimize_strategy='BATCH_GRADIENT_DESCENT' max_iterations預設 20;正則化l1_reg、l2_reg預設 0(不懲罰)
訓練完,想看模型學到的參數,用 ML.WEIGHTS:
SELECT * FROM ML.WEIGHTS(MODEL `shop.daily_cups`);它會列出每個特徵學到的權重。如果氣溫那一列是 5 左右,就對應到這篇講的「每熱 1 度多賣 5 杯」。
2. BigQuery ML 的超參數調整
不想自己一組一組試,BigQuery ML 可以自動幫你調超參數:
CREATE MODEL `shop.daily_cups_tuned`
OPTIONS(model_type='LINEAR_REG',
        input_label_cols=['cups_sold'],
        num_trials=12,
        max_parallel_trials=4,
        l1_reg=HPARAM_CANDIDATES([0, 1.0, 3.0]),
        l2_reg=HPARAM_CANDIDATES([0, 1.0, 3.0, 5.0])) AS
SELECT temperature, is_holiday, cups_sold
FROM `shop.daily_sales`;
翻成白話:
num_trials=12:總共試 12 組(可設 1 到 100),要寫這個才會開啟超參數調整max_parallel_trials=4:最多同時跑 4 組(上限 5,預設 1)HPARAM_CANDIDATES([...]):列出要試的選項;也可以用HPARAM_RANGE(最小, 最大)給一個範圍- 3 種
l1_reg× 4 種l2_reg= 12 組,跟上面算的組合數一樣道理
幾個官方預設值:
| 設定 | 預設 | 白話 |
|---|---|---|
搜尋方法 HPARAM_TUNING_ALGORITHM | VIZIER_DEFAULT | Google 的自動調參演算法,另外可選 RANDOM_SEARCH、GRID_SEARCH |
| 線性迴歸用什麼分數挑 | R2_SCORE | 上一篇講的 R²,越接近 1 越好 |
| 邏輯迴歸用什麼分數挑 | ROC_AUC | 分類用的分數,第 6 篇會講 |
| 資料怎麼切 | 80% 訓練、10% 評估、10% 測試 | 自動切好,第 4 篇會講為什麼要切 |
3. Agent Platform 上的超參數調整(原 Vertex AI)
如果模型是自己用 Python 寫的(不是用 SQL),可以用 Google Cloud 的機器學習平台幫你跑超參數調整。這個平台名字最近改了:
舊題庫可能還會看到 Vertex AI,現在叫 Gemini Enterprise Agent Platform(簡稱 Agent Platform)。
Google Cloud 在 2026 年 4 月 22 日把 Vertex AI 改名,底下功能跟著改名(官方對照表)。功能本身是延續的。
依照官方文件,做法是:你告訴它要調哪些超參數、每個的範圍、用哪個分數當目標、要越大還是越小,它就會跑很多次試驗、記錄結果、自動調整下一次要試的值。沒有特別指定的話,預設用貝氏最佳化,也可以選網格搜尋或隨機搜尋。
另外一個跟「特徵」有關的服務是 Feature Store:把整理好的特徵集中存放,讓不同團隊、不同模型共用,預測時也能很快取用。可以想成全公司共用的「線索倉庫」,第 23 篇會再細講。
| 舊名稱 | 現在的名稱 |
|---|---|
| Vertex AI | Gemini Enterprise Agent Platform(Agent Platform) |
| Vertex AI Training(含超參數調整) | Gemini Enterprise Agent Platform Managed Training |
| Vertex AI Feature Store | Feature Store on Gemini Enterprise Agent Platform |
| Vertex AI Experiments | Experiments on Agent Platform |
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這 5 個名詞散在好幾個區塊:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 1 區:用低程式碼方式打造 AI 方案(約 13%) | 用 BigQuery ML 做特徵工程或特徵選擇 |
| 第 2 區:跨團隊管理資料與模型(約 16%) | 在 Agent Platform Feature Store 建立、整合特徵 |
| 第 3 區:把原型擴展成正式模型(約 21%) | 超參數調整 |
| 第 4 區:模型服務與擴展(約 20%) | 用 Feature Store 管理、提供特徵 |
考題通常不會問「特徵的定義是什麼」,而是給一段情境,看你能不能分辨。
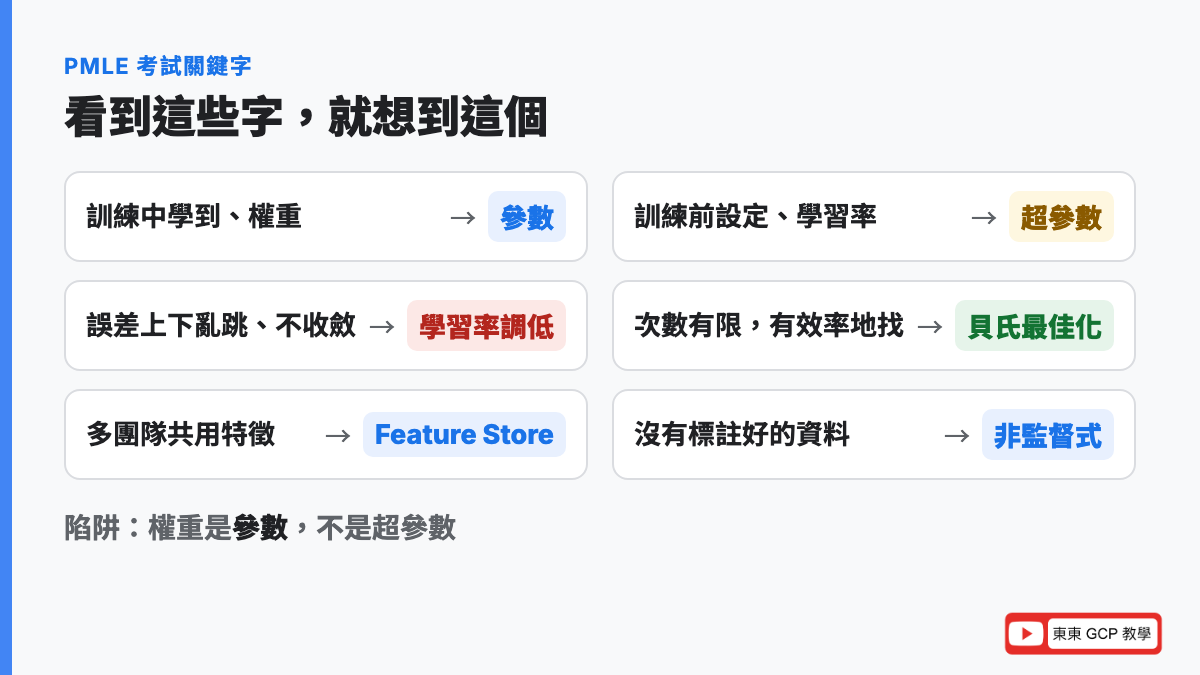
看到這些字,就想到這個
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「訓練中學到的」「權重」「weights and biases」 | 參數 |
| 「訓練前設定」「學習率、層數、批次大小」 | 超參數 |
| 「找出最佳的學習率/層數」「自動試多組設定」 | 超參數調整(Hyperparameter Tuning) |
| 「誤差(loss)上下震盪、不收斂、越來越大」 | 學習率太高,調低 |
| 「誤差降得很慢、訓練太久」 | 學習率可能太低 |
| 「試驗次數有限、預算有限,要有效率地找」 | 貝氏最佳化(預設),不是網格搜尋 |
| 「多個團隊重複算同樣的特徵」「線上預測要低延遲取特徵」 | Feature Store |
| 「用 SQL 找出重要的特徵」 | BigQuery ML 的特徵選擇 |
| 「模型在測試時分數好到不合理」 | 檢查是不是標籤混進特徵(資料洩漏) |
三個常見陷阱
- 把權重當成超參數:選項寫「調整模型的權重來做超參數調整」,錯。權重是參數,是模型自己學的
- 網格搜尋不一定最好:超參數多、預算有限時,網格搜尋組合數會爆炸,題目通常要你選更有效率的方法
- 非監督式學習沒有標籤:題目說「沒有標註好的資料」,就不能直接用分類、迴歸這種監督式模型
練習情境(自己出的練習,不是真實考題)
一間連鎖飲料店用自訂的神經網路預測各分店銷量。資料科學家發現,訓練時誤差一下高一下低,始終降不下來。團隊想找出更好的訓練設定,但雲端預算只夠跑 20 次訓練。該怎麼做?
判斷過程:
- 「誤差一下高一下低、降不下來」→ 典型的學習率太高,要把學習率列入調整範圍、往小的方向試
- 「找出更好的訓練設定」→ 調的是超參數,用超參數調整服務
- 「只夠跑 20 次」→ 次數有限,用預設的貝氏最佳化,它會根據前面的結果挑下一組,比網格搜尋有效率
- 「自訂的神經網路」→ 不是 SQL 模型,用 Agent Platform(原 Vertex AI) 的超參數調整
常見問答
特徵和標籤差在哪?
特徵是模型拿來判斷的線索,標籤是要它預測的正確答案。以飲料店為例,氣溫、是不是假日是特徵,賣出杯數是標籤。訓練時兩個都要有;預測時只給特徵,讓模型算出標籤。
參數和超參數差在哪?
參數是模型在訓練中自己學出來的數字,例如權重和偏差;超參數是人在訓練開始前設定的數字,例如學習率、批次大小、訓練輪數。一句話記:模型自己學的叫參數,人幫它設的叫超參數。
學習率要設多少?
沒有固定答案,常見的起點是 0.1、0.01、0.001 這類數字,再用超參數調整去試。設太大,誤差會上下亂跳停不下來;設太小,訓練會很慢。BigQuery ML 的線性模型預設會自動找學習率。
超參數調整是什麼?
超參數調整是自動試很多組超參數、比較分數、挑出最好那組的過程,每試一組叫一次試驗。常見方法有網格搜尋(全部試)、隨機搜尋(隨機抽)、貝氏最佳化(根據前面結果猜下一組)。Google Cloud 上預設用貝氏最佳化。
非監督式學習有標籤嗎?
沒有。非監督式學習只有特徵、沒有標籤,模型要自己從資料裡找規律,例如把會員自動分成幾群。有標籤的是監督式學習,分類和迴歸都屬於這一類。
特徵越多越好嗎?
不一定。沒用的特徵會干擾模型、拖慢訓練、增加成本,還可能讓模型死背訓練資料(過度擬合)。更要小心的是把答案偷偷混進特徵,造成資料洩漏。挑出真正有用的特徵,叫做特徵選擇。
Vertex AI 的超參數調整現在叫什麼?
Vertex AI 在 2026 年 4 月 22 日改名為 Gemini Enterprise Agent Platform(簡稱 Agent Platform)。超參數調整屬於訓練功能,Vertex AI Training 現在叫 Gemini Enterprise Agent Platform Managed Training,功能是延續的。
重點整理
- 樣本是一列資料;特徵是拿來判斷的線索;標籤是正確答案。訓練用有標籤的樣本,預測用沒標籤的樣本
- 參數(權重、偏差)是模型自己學的;超參數(學習率、批次大小、訓練輪數)是人在訓練前設定的
- 學習率太大會衝過頭、亂跳不收斂;太小會學很慢
- 超參數調整是自動試多組設定挑最好的;組合數會相乘爆炸,所以常用貝氏最佳化(Google Cloud 預設)
- BigQuery ML 裡:
input_label_cols指定標籤、SELECT的其他欄是特徵、OPTIONS裡的learn_rate等是超參數;Vertex AI 已改名為 Gemini Enterprise Agent Platform
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 上一篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 下一篇:第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切(撰寫中)
站上相關文章
- AI 教學:正則化(Regularization),過度擬合(Overfitting)的解決方法
- End-to-end Training(端到端訓練)是什麼?
- BigQuery 不就是查詢嗎?跟資料庫差在哪裡?能做什麼分析?
- GCP AI 教學:如何在 GCP 建立 AI 包含 GPU 的環境?
把這 5 個名詞弄懂,之後不管看官方文件、看教學影片,還是看考題,都不會再被基本詞彙卡住。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。