ROC 曲線和 AUC 怎麼看?ROC 曲線把每個門檻「抓到幾成、冤枉幾成」連成線,AUC 是線下面積,越接近 1 越會分辨。
上一篇的混淆矩陣,是在一個門檻下算出來的。這篇把門檻從高轉到低,一格一格算給你看,畫出 ROC 曲線、算出 AUC,再告訴你資料不平衡時為什麼要改看 AUC-PR,以及門檻到底該設在哪裡。
為什麼你需要知道
- 同一個模型,換個門檻就像換了一個模型:門檻調一下,召回率可以從 25% 變成 100%。只看一組混淆矩陣,你看到的只是模型的其中一面
- 比較兩個模型時,需要一個不受門檻影響的分數:A 模型在門檻 0.5 比較好,B 模型在門檻 0.3 比較好,到底誰強?AUC 就是用來回答這個問題
- 資料不平衡時,AUC-ROC 會讓模型看起來比實際好:抓詐騙、抓罕見疾病,要看 AUC-PR 才不會被騙
- 證照必考:PMLE 考題很愛問「資料極度不平衡,AutoML 該選哪個最佳化目標」「誤報很貴,門檻該往哪調」
先準備一組例子:10 個人的快篩分數
第 5 篇〈混淆矩陣是什麼?〉用的是流感快篩。這篇繼續用快篩,但換一個更接近模型真實運作的版本。
模型其實不會直接說「陽性」或「陰性」,而是先給每個人一個分數(0 到 1 之間),代表「這個人有流感的機率有多高」。
假設(教學用的數字)有 10 個人做快篩,其中 4 個人真的有流感、6 個人沒有,模型給的分數如下:
| 人 | 模型給的分數 | 真的有流感嗎 |
|---|---|---|
| A | 0.95 | ✅ 有 |
| B | 0.80 | ✅ 有 |
| E | 0.72 | ❌ 沒有 |
| C | 0.60 | ✅ 有 |
| F | 0.45 | ❌ 沒有 |
| D | 0.35 | ✅ 有 |
| G | 0.28 | ❌ 沒有 |
| H | 0.20 | ❌ 沒有 |
| I | 0.15 | ❌ 沒有 |
| J | 0.05 | ❌ 沒有 |
表格已經照分數從高排到低。你會發現模型大致把病人排在前面,但不完美:沒病的 E 拿了 0.72,比病人 C(0.60)和 D(0.35)都高。
接下來整篇文章,全部用這 10 個人算。
門檻(Threshold):分數超過多少,就說「陽性」
白話是什麼
門檻:一條線,模型給的分數大於等於這條線就判陽性,低於就判陰性。
比喻
就像考試的及格線。同一批考卷,及格線定 60 分和定 80 分,「及格的人」會差很多,但考卷本身一個字都沒改。
快篩試劑也一樣:那條線要多深才算陽性?標準定得寬鬆,比較多人會被判陽性;定得嚴格,比較少人被判陽性。
來龍去脈
第 2 篇〈分類和迴歸差在哪?〉講過,像邏輯迴歸這類分類模型,輸出的其實是一個機率。但現實世界要的是決定:這封信要不要丟進垃圾桶?這個人要不要隔離?所以一定要有一條線,把機率轉成「是/不是」。這條線就是門檻。
Google 機器學習速成課程也特別說明:門檻不是固定 0.5,要依照情境調整。
為什麼要學
模型訓練好之後,門檻是你唯一不用重新訓練、就能改變模型行為的旋鈕。很多考題的正確答案不是「換模型」,而是「調門檻」。
算一次給你看:門檻從 0.9 調到 0.1
我們挑 5 個門檻,每個門檻都數一次混淆矩陣的四格。
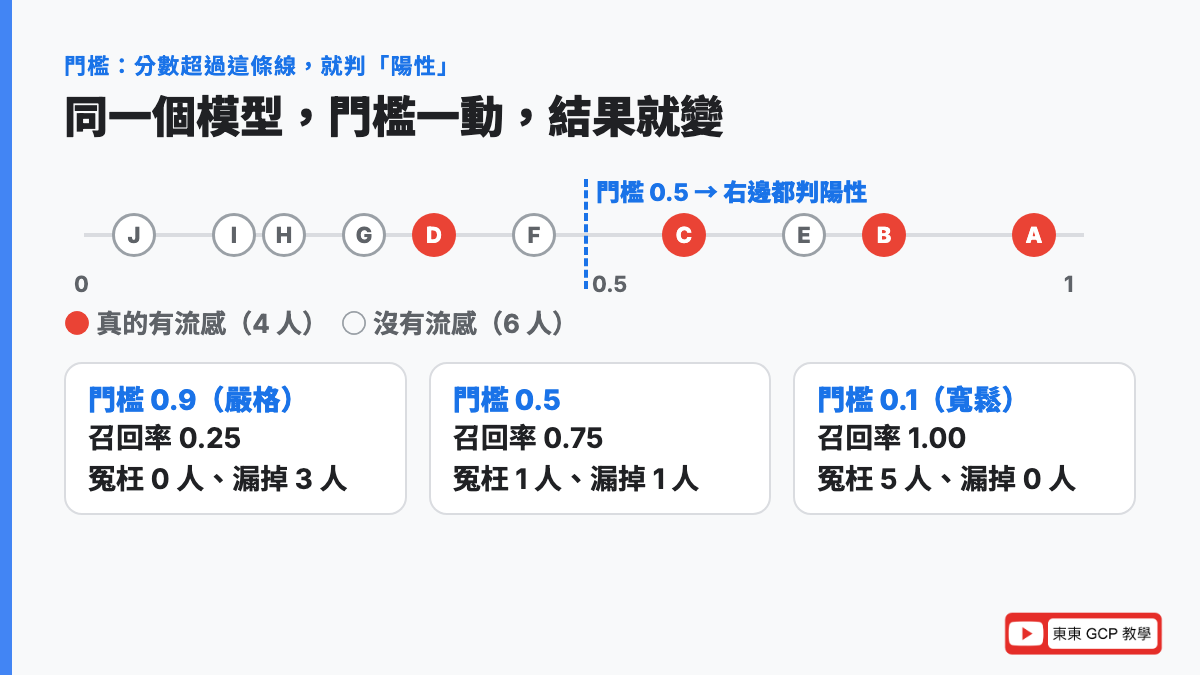
以門檻 0.5 為例:分數 ≥ 0.5 的是 A、B、E、C,這 4 人被判陽性。
- A、B、C 真的有病 → 抓對了 3 個(TP)
- E 沒病 → 冤枉 1 個(FP)
- D 有病但只有 0.35 → 漏掉 1 個(FN)
- 其他 5 個沒病的都低於 0.5 → 放對 5 個(TN)
5 個門檻全部算完:
| 門檻 | 判陽性的人 | 抓對 TP | 冤枉 FP | 漏掉 FN | 放對 TN | 召回率 | 偽陽性率 | 精確率 |
|---|---|---|---|---|---|---|---|---|
| 0.9 | A | 1 | 0 | 3 | 6 | 0.25 | 0.00 | 1.00 |
| 0.7 | A、B、E | 2 | 1 | 2 | 5 | 0.50 | 0.17 | 0.67 |
| 0.5 | A、B、E、C | 3 | 1 | 1 | 5 | 0.75 | 0.17 | 0.75 |
| 0.3 | 再加 F、D | 4 | 2 | 0 | 4 | 1.00 | 0.33 | 0.67 |
| 0.1 | 再加 G、H、I | 4 | 5 | 0 | 1 | 1.00 | 0.83 | 0.44 |
三個分數的公式(第 5 篇都算過):
召回率   = 抓對了 ÷ 真的有病的人 = TP ÷ (TP + FN)
偽陽性率 = 冤枉人 ÷ 真的沒病的人 = FP ÷ (FP + TN)
精確率   = 抓對了 ÷ 說陽性的人   = TP ÷ (TP + FP)
以門檻 0.5 那一列為例:召回率 = 3 ÷ 4 = 0.75;偽陽性率 = 1 ÷ 6 ≈ 0.17;精確率 = 3 ÷ 4 = 0.75。
數字怎麼看
- 門檻調低(0.9 → 0.1):模型越來越敢說陽性。召回率從 0.25 一路升到 1.00,病人都抓到了;但偽陽性率也從 0 升到 0.83,6 個健康的人冤枉了 5 個
- 門檻調高:反過來,冤枉的人變少,但漏掉的病人變多
- 沒有一個門檻能讓「抓到 100%」又「冤枉 0%」,除非模型完美。這就是上一篇講的取捨
問題來了:5 個門檻、5 組數字,到底這個模型好不好? 這就需要 ROC 曲線。
ROC 曲線:把每個門檻的表現連成一條線
白話是什麼
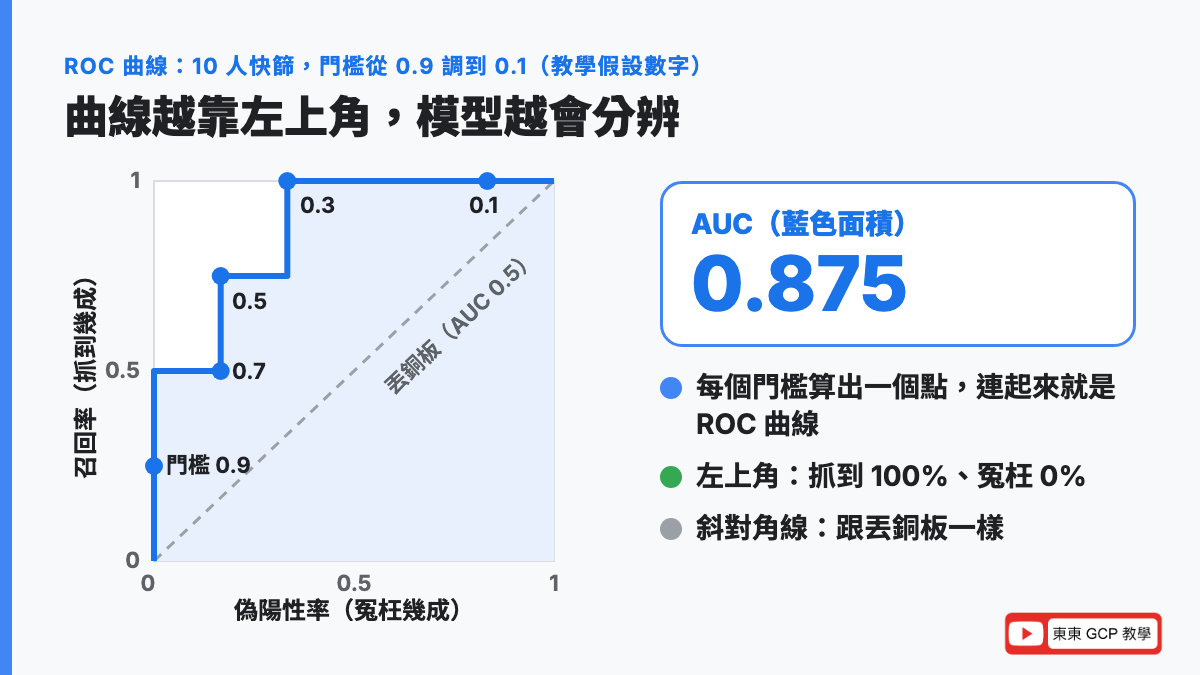
ROC 曲線:橫軸是偽陽性率(冤枉幾成),縱軸是召回率(抓到幾成)。每個門檻算出一個點,把所有點連起來,就是 ROC 曲線。
在畫 ROC 曲線的場合,召回率通常改叫真陽性率(True Positive Rate,TPR),偽陽性率叫 FPR(False Positive Rate),兩個是同一個東西的不同叫法。
比喻
像調收音機的靈敏度旋鈕。轉到最靈敏,連很遠的電台都收得到(抓到多),但雜訊也一起進來(冤枉多);轉到最不靈敏,雜訊沒了,但很多電台也收不到。ROC 曲線就是把旋鈕從頭轉到尾,每一格記下「收到幾成、雜訊幾成」畫成的軌跡。
來龍去脈
ROC 的全名是 Receiver Operating Characteristic,中文常譯成接收者操作特徵曲線。名字這麼奇怪,是因為它來自二次世界大戰的雷達(Google 速成課程也有提到):雷達兵要從螢幕上的訊號判斷「這是敵機,還是雜訊」。訊號判讀調得太敏感,會一直誤報;太遲鈍,又會漏掉真的敵機。這個「抓到 vs 誤報」的取捨,後來被醫學和機器學習沿用。
算一次給你看:把 5 個門檻畫成點
從上面的表,每個門檻取出 (偽陽性率, 召回率):
| 門檻 | 偽陽性率(橫軸) | 召回率(縱軸) | 點 |
|---|---|---|---|
| 比 0.95 還高 | 0 | 0 | (0, 0):誰都不說陽性 |
| 0.9 | 0.00 | 0.25 | (0, 0.25) |
| 0.7 | 0.17 | 0.50 | (0.17, 0.5) |
| 0.5 | 0.17 | 0.75 | (0.17, 0.75) |
| 0.3 | 0.33 | 1.00 | (0.33, 1) |
| 0.1 | 0.83 | 1.00 | (0.83, 1) |
| 0 | 1 | 1 | (1, 1):每個人都說陽性 |
ROC 曲線一定從左下角 (0, 0) 出發,走到右上角 (1, 1):門檻最高時誰都不判陽性,門檻最低時每個人都判陽性。
數字怎麼看
- 左上角 (0, 1) 是夢想的位置:抓到 100%、冤枉 0%。曲線越往左上角靠,模型越好
- 斜對角線(左下到右上)是丟銅板:一個亂猜的模型,抓到幾成就冤枉幾成,點都落在這條線上
- 我們的曲線在門檻 0.3 時到了 (0.33, 1):病人全抓到,代價是 6 個健康的人冤枉 2 個
為什麼要學
ROC 曲線讓你不用先決定門檻,就能看到模型的完整能力,也是你挑門檻時的地圖:曲線上每個點都是一個可以選的門檻。
AUC:把整條曲線濃縮成一個分數
白話是什麼
AUC(Area Under the Curve):曲線下面積。ROC 曲線底下的面積,範圍 0 到 1。通常說「AUC」指的就是 ROC 曲線下的面積,也寫成 AUC-ROC 或 AUROC。
比喻
AUC 有一個很好懂的意思,Google 速成課程是這樣定義的:
隨便抓一個病人、再隨便抓一個健康的人,模型給病人比較高分的機率。
像兩個人比賽:一個病人、一個健康的人站在一起,模型要指出誰比較可能有病。AUC 就是模型指對的機率。
來龍去脈
一條曲線很難拿來比較:A 模型在左邊比較高,B 模型在右邊比較高,到底誰好?所以大家把曲線底下的面積算出來,變成一個數字,就可以直接比大小。
算一次給你看:數「病人贏了幾場」
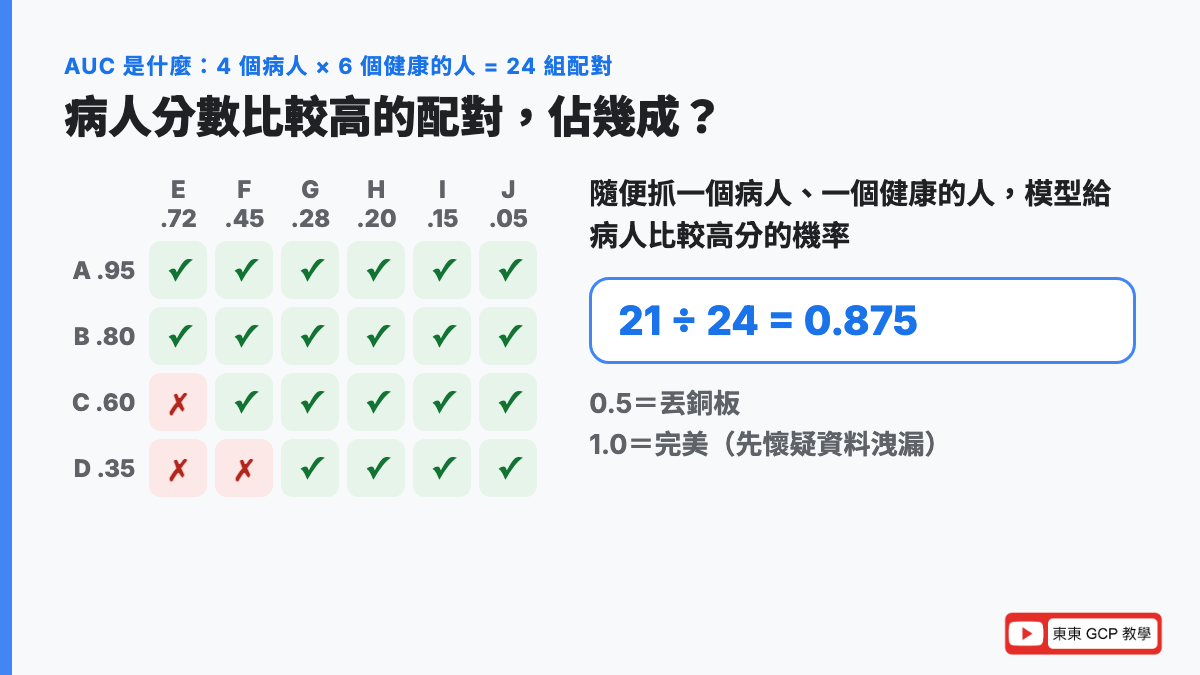
4 個病人 × 6 個健康的人,總共可以配出 4 × 6 = 24 組。每一組比一次:病人的分數比較高,就算「模型排對了」。
| 病人 | 分數 | 贏過哪些健康的人 | 贏幾組 |
|---|---|---|---|
| A | 0.95 | E、F、G、H、I、J(全部) | 6 |
| B | 0.80 | E、F、G、H、I、J(全部) | 6 |
| C | 0.60 | F、G、H、I、J(輸給 E 的 0.72) | 5 |
| D | 0.35 | G、H、I、J(輸給 E、F) | 4 |
AUC = 排對的組數 ÷ 全部組數
    = (6 + 6 + 5 + 4) ÷ 24
    = 21 ÷ 24
= 0.875用面積驗算:把曲線底下切成三塊長方形。
偽陽性率 0 → 1/6 這段,曲線高度 0.50:面積 = 1/6 × 0.50 ≈ 0.083
偽陽性率 1/6 → 2/6 這段,曲線高度 0.75:面積 = 1/6 × 0.75 = 0.125
偽陽性率 2/6 → 1 這段,曲線高度 1.00:面積 = 4/6 × 1.00 ≈ 0.667
總面積 ≈ 0.083 + 0.125 + 0.667 = 0.875
兩種算法答案一樣,都是 0.875。
數字怎麼看
- 0.875:隨便抓一個病人和一個健康的人,模型有 87.5% 的機率給病人比較高分
- AUC 跟門檻無關:它只看「排名排得對不對」,不管你最後門檻設在哪。這也是它適合拿來比較模型的原因
- AUC 不管分數本身準不準:把所有分數都除以 2,排名不變,AUC 也不變。所以 AUC 高,不代表模型說「70% 機率」就真的是 70%
AUC 0.5、0.7、0.9 各代表什麼程度
下面是業界常見的粗略分級,不是官方標準,不同領域的要求也不一樣(醫療通常要求更高):
| AUC | 白話 | 說明 |
|---|---|---|
| 1.0 | 完美 | 每個病人的分數都比每個健康的人高。實務上看到 1.0 要先懷疑資料洩漏(第 8 篇會講) |
| 0.9 以上 | 很會分辨 | 大部分配對都排對 |
| 0.8~0.9 | 不錯 | 我們的 0.875 在這裡 |
| 0.7~0.8 | 普通 | 有用,但還有進步空間 |
| 0.5~0.7 | 差 | 只比亂猜好一點 |
| 0.5 | 丟銅板 | 病人和健康的人分不出來,曲線就是那條斜對角線 |
| 低於 0.5 | 比亂猜還差 | 通常是標籤弄反了。官方速成課程提到:把預測反過來,就會變得比亂猜好 |
為什麼要學
AUC 是比較分類模型最常用的單一分數。BigQuery ML 的評估結果有 roc_auc,AutoML 二元分類的預設最佳化目標就是最大化 AUC-ROC(後面會講)。
PR 曲線和 AUC-PR:精確率的版本
白話是什麼
PR 曲線(Precision-Recall Curve,精確率-召回率曲線):橫軸是召回率,縱軸是精確率。一樣是每個門檻算一個點連成線。
AUC-PR:PR 曲線底下的面積,也叫 AUPRC。依照 Agent Platform 官方文件,它也被稱為平均精確率(Average Precision),範圍 0 到 1,越高越好。
比喻
像撒網捕魚。網撒得越大(召回率越高),魚撈得越多,但網裡的垃圾也越多(精確率下降)。PR 曲線記錄的是:撈到幾成的魚時,網裡還有幾成是魚。
來龍去脈
精確率和召回率這兩個詞,最早來自圖書館和搜尋系統的評估:搜尋結果裡有幾成是你要的(精確率),你要的資料有幾成被找出來(召回率)。搜尋的世界,「相關的資料」永遠只佔極少數,所以 PR 曲線天生就適合陽性很少的情況。
算一次給你看
同樣 10 個人,從上面的大表取出 (召回率, 精確率):
| 門檻 | 召回率(橫軸) | 精確率(縱軸) |
|---|---|---|
| 0.9 | 0.25 | 1.00 |
| 0.7 | 0.50 | 0.67 |
| 0.5 | 0.75 | 0.75 |
| 0.3 | 1.00 | 0.67 |
| 0.1 | 1.00 | 0.44 |
平均精確率的算法很直覺:照分數從高到低一個一個往下看,每抓到一個病人,就記下當下的精確率,最後平均。
抓到 A(第 1 名):說陽性 1 人,對 1 人 → 精確率 1/1 = 1.00
抓到 B(第 2 名):說陽性 2 人,對 2 人 → 精確率 2/2 = 1.00
(E 第 3 名,沒病,跳過)
抓到 C(第 4 名):說陽性 4 人,對 3 人 → 精確率 3/4 = 0.75
(F 第 5 名,沒病,跳過)
抓到 D(第 6 名):說陽性 6 人,對 4 人 → 精確率 4/6 ≈ 0.67

平均精確率 = (1.00 + 1.00 + 0.75 + 0.67) ÷ 4 ≈ 0.85
數字怎麼看
- AUC-PR 越接近 1 越好:代表一路抓病人,判陽性的人大多真的有病
- 及格線不是 0.5:亂猜的模型,精確率就等於「陽性佔的比例」。我們 10 人裡有 4 個病人,亂猜的 AUC-PR 約 0.4,0.85 遠高於它
- 如果陽性只佔 1%,亂猜的 AUC-PR 只有約 0.01。這時 AUC-PR 0.3 可能已經很不錯;AUC-ROC 的亂猜基準卻永遠是 0.5。看 AUC-PR 一定要先知道陽性佔幾成
什麼時候該看 AUC-PR,而不是 AUC-ROC
算一次給你看:同一個 ROC 點,精確率差 7 倍
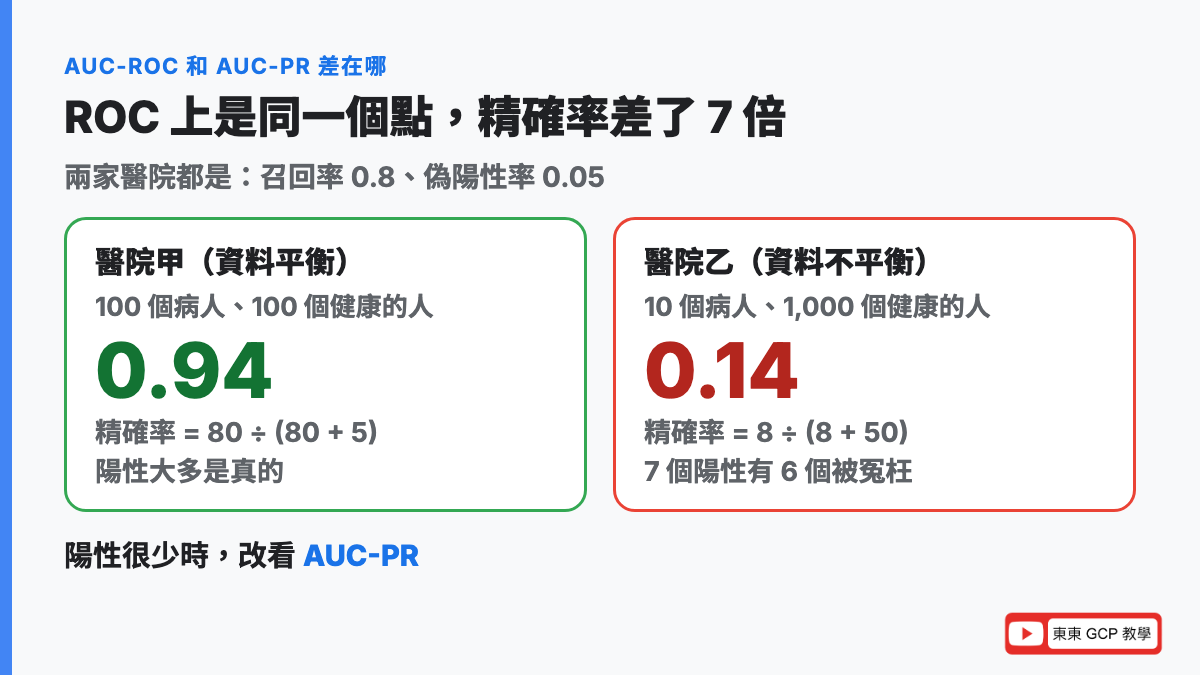
假設(教學用的數字)兩家醫院用同一款快篩,同樣設定門檻,都得到 召回率 0.8、偽陽性率 0.05,在 ROC 曲線上是同一個點。
| 醫院甲:100 個病人、100 個健康的人 | 醫院乙:10 個病人、1,000 個健康的人 | |
|---|---|---|
| 抓對了 | 100 × 0.8 = 80 | 10 × 0.8 = 8 |
| 冤枉人 | 100 × 0.05 = 5 | 1,000 × 0.05 = 50 |
| 精確率 | 80 ÷ (80 + 5) ≈ 0.94 | 8 ÷ (8 + 50) ≈ 0.14 |
數字怎麼看:
- 在醫院甲,拿到陽性,94% 是真的有病
- 在醫院乙,拿到陽性,只有 14% 是真的,大約 7 個陽性裡有 6 個是被冤枉的
- 但兩家醫院的 ROC 曲線長得一模一樣,AUC-ROC 完全看不出這個差別
原因在分母:偽陽性率的分母是「所有健康的人」,醫院乙有 1,000 個,冤枉 50 個也才 5%,看起來很小。精確率的分母是「被判陽性的人」,冤枉的人直接被看見。
這就是 Google 速成課程說的:ROC 和 AUC 在兩類數量差不多時很好用;資料不平衡時,PR 曲線和它的面積可能是更好的比較方式。
一張表比完
| AUC-ROC | AUC-PR | |
|---|---|---|
| 曲線的兩個軸 | 偽陽性率(橫)× 召回率(縱) | 召回率(橫)× 精確率(縱) |
| 白話意思 | 隨便抓一個陽性、一個陰性,模型排對的機率 | 一路往下抓,判陽性的人平均有幾成是真的 |
| 亂猜的分數 | 永遠 0.5 | 等於陽性佔的比例(例如 1% 就是 0.01) |
| 適合 | 兩類數量差不多,想比較模型整體分辨能力 | 類別不平衡,在意少數那一類(詐騙、罕病、故障) |
| 弱點 | 大量容易判斷的陰性,會讓分數看起來很漂亮 | 分數高低要搭配陽性比例才看得懂 |
| GCP 上的名字 | BigQuery ML roc_auc;AutoML maximize-au-roc | AutoML maximize-au-prc、評估頁的 AuPRC |
門檻怎麼選:把「錯的代價」算進去
ROC 曲線給你地圖,但門檻要選在哪,要看兩種錯哪個比較貴。官方速成課程的建議是:
- 冤枉人很貴:選偽陽性率低的點,就算召回率低一點也沒關係
- 漏掉很貴:選召回率最高的點
- 兩種差不多:選最靠近左上角的點
算一次給你看:兩種情境,兩個答案
同樣 10 個人、5 個門檻。用「錯一次扣幾分」來算總代價(教學假設的分數)。
情境一:流感防疫,漏掉一個病人扣 10 分(會傳染給別人),冤枉一個人扣 1 分(多做一次檢查):
總代價 = 10 × 漏掉 + 1 × 冤枉情境二:垃圾信過濾,把正常信件誤判成垃圾信扣 10 分(可能錯過重要信),漏掉一封垃圾信扣 1 分(自己刪掉就好):
總代價 = 1 × 漏掉 + 10 × 冤枉| 門檻 | 漏掉 FN | 冤枉 FP | 情境一(漏掉貴) | 情境二(冤枉貴) |
|---|---|---|---|---|
| 0.9 | 3 | 0 | 30 + 0 = 30 | 3 + 0 = 3 ✅ |
| 0.7 | 2 | 1 | 20 + 1 = 21 | 2 + 10 = 12 |
| 0.5 | 1 | 1 | 10 + 1 = 11 | 1 + 10 = 11 |
| 0.3 | 0 | 2 | 0 + 2 = 2 ✅ | 0 + 20 = 20 |
| 0.1 | 0 | 5 | 0 + 5 = 5 | 0 + 50 = 50 |
數字怎麼看:
- 同一個模型、同一條 ROC 曲線,情境一的最佳門檻是 0.3,情境二是 0.9
- 預設的 0.5 在兩個情境都不是最好的
- 所以「門檻要設多少」沒有標準答案,要先問清楚哪種錯比較貴
在 GCP 上怎麼做
GCP(Google Cloud Platform) 是 Google 的雲端服務,白話說就是租用 Google 機房裡的電腦和工具。在 GCP 上訓練分類模型,AUC 和 ROC 曲線都可以直接拿到。
1. BigQuery ML:ML.EVALUATE 看 AUC,ML.ROC_CURVE 畫曲線
- BigQuery:Google 的大型資料倉庫,專門存放和分析超大量的表格資料
- BigQuery ML:讓你用 SQL(跟資料庫說話的語言)直接在 BigQuery 裡訓練模型
沿用第 5 篇的例子:診所訓練了一個流感分類模型 clinic.flu_model(教學用的範例)。
看 AUC,用 ML.EVALUATE,回傳的欄位裡 roc_auc 就是 AUC-ROC:
SELECT roc_auc, precision, recall
FROM ML.EVALUATE(MODEL `clinic.flu_model`,
(SELECT body_temp, has_cough, has_flu FROM `clinic.visits_2026`));看每個門檻的表現,用 ML.ROC_CURVE。最後的 GENERATE_ARRAY(0.1, 0.9, 0.2) 是自己指定要算哪幾個門檻,這裡會產生 0.1、0.3、0.5、0.7、0.9,跟上面的大表一樣:
SELECT *
FROM ML.ROC_CURVE(MODEL `clinic.flu_model`,
  (SELECT body_temp, has_cough, has_flu FROM `clinic.visits_2026`),
  GENERATE_ARRAY(0.1, 0.9, 0.2));
每一列是一個門檻,有 threshold(門檻)、recall(召回率)、false_positive_rate(偽陽性率),以及 TP、FP、TN、FN 的次數。把 false_positive_rate 當橫軸、recall 當縱軸畫出來,就是 ROC 曲線。
畫 PR 曲線,官方文件示範用同一個函式,自己算出精確率:
SELECT
  recall,
  true_positives / (true_positives + false_positives) AS precision
FROM ML.ROC_CURVE(MODEL `clinic.flu_model`,
  (SELECT body_temp, has_cough, has_flu FROM `clinic.visits_2026`));
依照官方文件,幾個要注意的地方:
ML.ROC_CURVE只能用在二元分類(只有兩個選項的分類)- 不給門檻的話,它會依照模型預測分數的分布,自動挑一批門檻來算
- 不給評估資料的話,會用訓練時切出來的評估資料;訓練時沒切,就用整份訓練資料算(等於在考練習題,第 4 篇講過為什麼不行)
2. AutoML on Agent Platform:訓練前就選好要追哪個分數
AutoML:只要把資料丟進去,Google 自動幫你挑模型、調超參數的服務,不用寫程式。
舊題庫可能還會看到 Vertex AI AutoML 或 AutoML Tables,現在叫 AutoML on Gemini Enterprise Agent Platform。
Google Cloud 在 2026 年 4 月 22 日把 Vertex AI 改名為 Gemini Enterprise Agent Platform(簡稱 Agent Platform),底下功能跟著改名(官方對照表)。功能本身是延續的。
AutoML 訓練表格資料的分類模型時,可以選最佳化目標(Optimization objective),意思是「訓練時要拚命把哪個分數拉高」。依照官方文件,分類模型有這 5 種:
| 最佳化目標 | API 名稱 | 什麼時候選 |
|---|---|---|
| AUC ROC | maximize-au-roc | 想讓模型把兩類分得越開越好。二元分類的預設值 |
| Log loss | minimize-log-loss | 想讓模型給的機率越準越好。多類別分類只能選這個 |
| AUC PR | maximize-au-prc | 在意比較少的那一類,例如詐騙、罕見疾病 |
| Precision at Recall | maximize-precision-at-recall | 召回率要先達到某個數字,在這個前提下精確率越高越好 |
| Recall at Precision | maximize-recall-at-precision | 精確率要先達到某個數字,在這個前提下召回率越高越好 |
Log loss(對數損失)是另一種分數:它不只看排名,還看模型給的機率準不準。例如模型對一個真的病人說「有病機率 0.99」,log loss 很小;說「0.51」雖然一樣判陽性,log loss 就比較大。範圍 0 到無限大,越低越好。
訓練完,評估頁面會列出 AuPRC、AuROC、Log loss,以及不同信心門檻(confidence threshold)下的精確率和召回率。官方寫得很直接:門檻調高,精確率上升、召回率下降。
| 舊名稱 | 現在的名稱 |
|---|---|
| Vertex AI | Gemini Enterprise Agent Platform(Agent Platform) |
| Vertex AI AutoML、AutoML Tables | AutoML on Gemini Enterprise Agent Platform |
| Vertex AI Model Monitoring | Model Monitoring on Gemini Enterprise Agent Platform |
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這篇的內容對應到:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 1 區:用低程式碼方式打造 AI 方案(約 13%) | 用 BigQuery ML、Agent Platform AutoML 訓練模型 |
| 第 2 區:跨團隊管理資料與模型(約 16%) | 評估預測型與生成式 AI 方案(例如模型評估指標) |
| 第 6 區:監控 AI 方案(約 13%) | 為正式上線的模型建立持續評估指標 |
考題很少叫你算 AUC,而是給一個情境,問你該看哪個分數、該選哪個最佳化目標、門檻該往哪調。
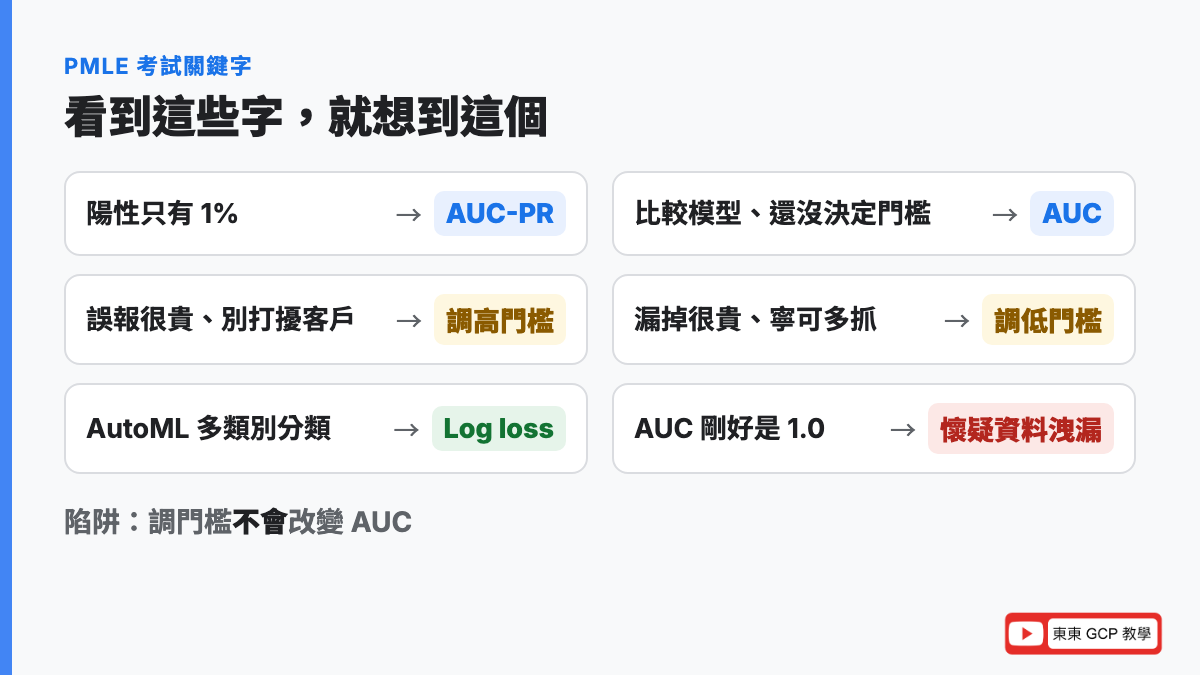
看到這些字,就想到這個
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「比較兩個模型」「還沒決定門檻」 | AUC(AUC-ROC) |
| 「陽性只有 1%」「詐騙很少見」「在意少數類別」 | AUC-PR,AutoML 選 maximize-au-prc |
| 「召回率至少要 95%」「不能漏掉超過 5%」 | maximize-precision-at-recall |
| 「精確率至少要 90%」「誤報率不能太高」 | maximize-recall-at-precision |
| 「多類別分類」(三種以上選項) | AutoML 只能選 minimize-log-loss |
| 「誤報很貴」「不要打擾正常客戶」 | 調高門檻 |
| 「漏掉很貴」「寧可多抓」 | 調低門檻 |
| 「AUC 是 1.0」「好到不像真的」 | 先懷疑資料洩漏 |
| 「AUC 低於 0.5」 | 標籤可能弄反了 |
| BigQuery ML 要畫 ROC 曲線 | ML.ROC_CURVE |
三個常見陷阱
- 不平衡資料還看 AUC-ROC:題目說「詐騙只佔 0.1%」,選項裡有 AUC-ROC 和 AUC-PR,答案通常是 AUC-PR
- 以為 AUC 會跟著門檻變:AUC 是把所有門檻一起算的,調門檻不會改變 AUC,只會改變精確率、召回率
- 以為門檻一定是 0.5:0.5 只是預設值。題目描述了「哪種錯比較貴」,答案往往就是調門檻
練習情境(自己出的練習,不是真實考題)
一家保險公司要用 AutoML 訓練表格資料模型,偵測理賠詐騙。詐騙案件只佔所有理賠的 0.3%。被標記的案件會轉給調查員人工審查,但調查員人力有限。公司希望模型「盡量把詐騙案排在前面」。應該選哪個最佳化目標?
判斷過程:
- 「只佔 0.3%」→ 類別不平衡,AUC-ROC 會被大量正常理賠灌水
- 「在意少數那一類」「調查員人力有限」→ 被標記的案件要盡量是真的詐騙,精確率很重要
- 答案:選 AUC PR(
maximize-au-prc)。如果題目再加一句「至少要抓到 80% 的詐騙案」,就改選maximize-precision-at-recall
常見問答
ROC 曲線怎麼看?
ROC 曲線的橫軸是偽陽性率(健康的人被冤枉幾成),縱軸是召回率(病人被抓到幾成),每個門檻畫一個點連成線。曲線越靠近左上角越好,左上角代表抓到 100%、冤枉 0%;斜對角線代表跟丟銅板一樣。
AUC 是什麼意思?
AUC 是 ROC 曲線下的面積,範圍 0 到 1。白話的意思是:隨便抓一個陽性、一個陰性,模型給陽性比較高分的機率。AUC 0.875 代表有 87.5% 的機率排對。
AUC 0.7、0.8、0.9 算好嗎?
常見的粗略分級是:0.5 等於亂猜,0.7~0.8 普通,0.8~0.9 不錯,0.9 以上很好。這不是官方標準,醫療等高風險領域通常要求更高。如果 AUC 剛好是 1.0,要先懷疑是不是資料洩漏。
AUC-ROC 和 AUC-PR 差在哪?
AUC-ROC 用偽陽性率和召回率畫曲線,亂猜的分數永遠是 0.5;AUC-PR 用召回率和精確率畫曲線,亂猜的分數等於陽性佔的比例。資料不平衡時,大量陰性會讓 AUC-ROC 看起來很漂亮,AUC-PR 比較能反映少數類別抓得好不好。
什麼時候要看 AUC-PR?
陽性很少、而且你在意陽性那一類的時候,例如詐騙偵測、罕見疾病、設備故障。Google 速成課程也提到,資料不平衡時,PR 曲線和它的面積可能是比 ROC 更好的比較方式。
門檻調高或調低會怎樣?
門檻調高,模型比較保守,冤枉的人變少、精確率上升,但漏掉的變多、召回率下降。門檻調低則相反。調門檻不需要重新訓練,也不會改變 AUC。
門檻一定要設 0.5 嗎?
不用。0.5 只是 BigQuery ML 等工具的預設值。最好的門檻要看兩種錯哪個比較貴:漏掉很貴(防疫、詐騙)就調低,冤枉很貴(垃圾信、誤封帳號)就調高。
AutoML 的 maximize-au-prc 是什麼?
它是 AutoML on Gemini Enterprise Agent Platform(原 Vertex AI AutoML)表格分類模型的最佳化目標之一,意思是訓練時以最大化 PR 曲線下面積為目標,官方說明是「為比較少見的那一類最佳化」。二元分類的預設目標則是 maximize-au-roc。
重點整理
- 門檻是把分數轉成「是/不是」的那條線:調低,召回率和偽陽性率一起上升;調高則相反
- ROC 曲線:每個門檻畫一個點(橫軸偽陽性率、縱軸召回率),越靠近左上角越好,斜對角線是亂猜
- AUC=ROC 曲線下面積=隨便抓一對陽性和陰性,模型排對的機率;0.5 是亂猜,1.0 太完美要懷疑資料洩漏,跟門檻無關
- AUC-PR 用精確率和召回率畫,亂猜分數等於陽性比例;資料不平衡時看它,AutoML 選
maximize-au-prc - 門檻要依錯誤代價選:同一個模型,漏掉貴和冤枉貴的最佳門檻可以完全不同;BigQuery ML 用
ML.ROC_CURVE看每個門檻的表現
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 第 3 篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切
- 上一篇:第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
- 下一篇:第 7 篇:過度擬合是什麼?正則化、Dropout、提前停止 3 招解決(撰寫中)
站上相關文章
- iPAS AI 應用規劃師初級認證考試 人工智慧概論 重點整理&簡報下載
- BigQuery 不就是查詢嗎?跟資料庫差在哪裡?能做什麼分析?
- Vertex AI 核心功能 Agent Builder、Model Builder 和 Model Garden 介紹
- GCP 學習路徑 Learning Roadmap 和八大關卡
ROC 曲線和 AUC 看懂了,模型評估這一塊就算打好基礎了,接下來要面對的是「模型為什麼會表現不好」,例如下一篇的過度擬合。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。