ML 用哪個資料服務?訓練用 BigQuery、檔案放 Cloud Storage、線上查特徵用 Feature Store 配 Bigtable。
機器學習的資料不是「存起來」就好。訓練時要一次掃幾億筆,線上預測時要在幾十毫秒內查出一個會員的特徵,照片和模型檔又是另一種東西。一個服務做不到全部,所以 Google Cloud 有一整排:BigQuery、Cloud Storage、Bigtable、Memorystore、Feature Store,再加上處理資料的 Dataflow、Spark,和直接拿來用的 AI API。
這篇把 PMLE 筆記最後一塊「基礎服務與工具」一次整理:存在哪、怎麼算、怎麼端上桌,每個服務用一句白話加一個飲料店的情境,最後給你一張「看到什麼需求就選什麼」的表。
照系列慣例先說名稱:Vertex AI 在 2026 年 4 月起改名為 Gemini Enterprise Agent Platform(簡稱 Agent Platform),Feature Store 現在叫 Feature Store on Gemini Enterprise Agent Platform;Dataproc 改叫 Managed Service for Apache Spark;Cloud Composer 改叫 Managed Service for Apache Airflow;Cloud Functions 改叫 Cloud Run functions。文末有完整對照表。
一樣用有 2,000 間分店、50 萬名會員的連鎖飲料店當例子(教學假設):POS 每天進 300 萬筆交易、App 有會員照片、要做流失模型和推薦。
為什麼你需要知道
- 存錯地方,模型上線就慢:線上預測要在 100 毫秒內回答,去 BigQuery 查一筆要一秒以上,整個端點就卡住。這是最常見的架構錯誤
- 算錯地方,帳單爆炸:每天 300 萬筆交易用 Python 在筆記本裡跑,記憶體爆掉;全部丟 Spark 叢集又貴。考試指南 2.1 直接寫「依規模和複雜度選前處理工具」
- 重複造輪子:Vision API 一行呼叫就能 OCR,很多人還是自己訓練模型。考試 1.2 考的就是「什麼時候用現成的 API」
- 證照必考:2.1 選前處理工具與 Feature Store、3.2 訓練資料放 Cloud Storage 還是 BigQuery、4.2 用 Feature Store 服務特徵、1.2 產業 API,這篇全包
1. 先搞懂:資料有三種用法,服務跟著分三類
白話是什麼
機器學習對資料有三種動作,每種對速度的要求不一樣:
| 動作 | 白話 | 要多快 | 飲料店 |
|---|---|---|---|
| 分析與訓練 | 一次掃幾億筆,算統計、做特徵、訓練模型 | 幾秒到幾分鐘都可以 | 算每個會員 90 天來店次數 |
| 線上查詢 | 預測當下,查一個人的資料 | 幾十毫秒內 | 會員掃碼,馬上推薦一杯 |
| 放檔案 | 照片、影片、模型檔、CSV,整個檔案存取 | 看情況 | 50 萬會員的照片、訓練好的模型檔 |
毫秒是千分之一秒。眨一次眼大約 100~150 毫秒,線上預測的預算常常就是「一次眨眼」。
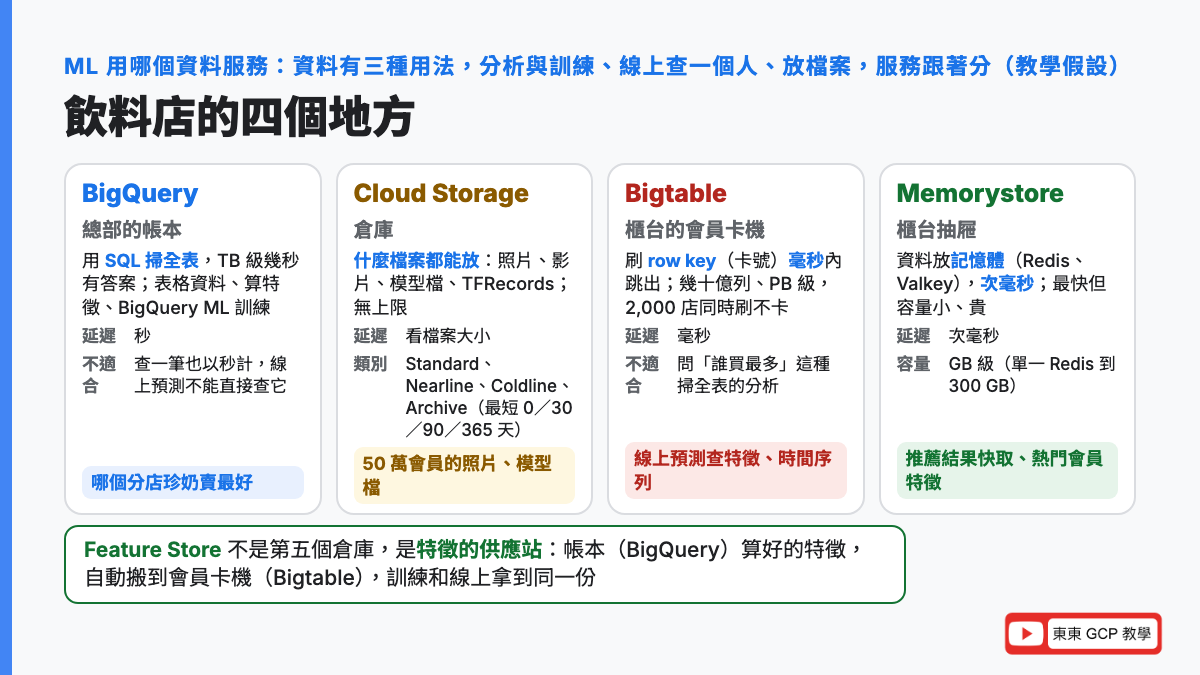
比喻:飲料店的四個地方
- BigQuery 是總部的帳本:所有交易都記在這,老闆問「哪個分店的珍奶賣最好」,一句 SQL 幾秒就有答案。但要查「這一位會員剛剛買什麼」,翻帳本太慢
- Cloud Storage 是倉庫:什麼都能放,照片、影片、模型檔、備份,按件計價,一件一件拿
- Bigtable 是櫃台的會員卡機:刷卡號,毫秒內跳出這個人的資料,而且全台 2,000 家同時刷也不卡。但它只認卡號,不能問「誰買最多」
- Memorystore 是櫃台抽屜:手伸過去就拿到,最快,但空間小、放的是最常用的幾樣
Feature Store 不是第五個倉庫,它是特徵的供應站:帳本(BigQuery)算好的特徵,自動搬一份到會員卡機(Bigtable),訓練和線上預測拿到的是同一份。
來龍去脈
這些名字對應四種資料庫家族:資料倉儲(data warehouse,給分析用)、物件儲存(object storage,放檔案)、NoSQL(不用表格、按鍵查值、能橫向擴張)、快取(cache,放記憶體的暫存)。BigQuery 是 Google 把內部的 Dremel 做成服務,Bigtable 是 2006 年那篇著名論文的服務版,Cloud Storage 對應其他雲的 S3。
為什麼要學
考題給你一個情境(延遲、資料量、資料長相),問你選哪個。分不清「分析用」和「線上查詢用」,一定選錯。
2. 四個儲存服務,各自長什麼樣
BigQuery:分析與訓練的主場
官方叫它「全代管、AI 就緒的資料平台」:無伺服器(白話:你不用開機器,丟 SQL 進去就跑),儲存和運算分開,查 TB 級資料幾秒、PB 級幾分鐘。
跟機器學習有關的:
- 欄位式儲存:一次只讀用到的欄,算特徵快又便宜(第 15 篇 BigQuery ML 直接在裡面訓練)
- 串流寫入:Storage Write API;Pub/Sub 有 BigQuery 訂閱可以把訊息直接寫進表,不用 Dataflow
- Feature Store V2 的離線倉庫就是它(下一節)
- 站上有兩篇講過:BigQuery 跟資料庫差在哪、BigQuery 計費方式
不適合:單筆低延遲查詢。它是為掃全表設計的,查一筆也要排程啟動,通常以秒計。
Cloud Storage:檔案、照片、模型檔
官方:存非結構化資料的服務,資料是物件(object,白話就是一個檔案),放在值區(bucket,白話是資料夾的最上層)。耐久度 11 個 9(一年掉一個檔的機率是千億分之一)。
機器學習用它放:訓練影像(第 13 篇的 TFRecords)、模型檔、管線的中間產物(第 18 篇)、TensorBoard 日誌(第 22 篇)。考試 3.2 寫「訓練資料放在 Cloud Storage 和 BigQuery」:表格資料放 BigQuery,檔案類放 Cloud Storage。
儲存類別(官方表)是考點,差別在「多久拿一次」:
| 類別 | 最短存放天數 | 取回費 | 適合 |
|---|---|---|---|
| Rapid | 無 | 無 | 單一區域、AI/ML 訓練要極高吞吐,配 Rapid Bucket |
| Standard | 無 | 無 | 常常讀的「熱」資料:正在訓練的資料集 |
| Nearline | 30 天 | 有 | 一個月碰一次:上個月的訓練快照 |
| Coldline | 90 天 | 有 | 一季碰一次:舊版訓練資料 |
| Archive | 365 天 | 有 | 一年碰不到一次:法規要留的原始資料 |
算一次給你看:照片放哪一級
飲料店 50 萬會員、每人 20 張照片、每張 2 MB(教學假設):
50 萬 × 20 × 2 MB = 20,000,000 MB = 20 TB訓練封膜檢查模型(第 14 篇)用過這批照片之後,接下來 90 天內不會再碰。選 Coldline(最短 90 天剛好)。如果貪便宜放 Archive,第 100 天要重訓拿出來:
- 取回費要付
- 最短 365 天,就算第 100 天刪掉,也照 365 天收費
數字怎麼看:類別越冷,每 GB 月費越低,但最短天數和取回費越高。「多久拿一次」才是選擇依據,不是「現在想省多少」。不確定就開 Autoclass,讓 Cloud Storage 依存取頻率自動換類別。
Bigtable:線上預測查特徵
官方:稀疏表,能到幾十億列、幾千欄,存 TB 到 PB,單一鍵值(single-keyed)資料的低延遲讀寫,高吞吐。
白話:一張超大的表,每列有一個 row key(列鍵,像會員卡號),只能靠這個鍵快速查,查到就是毫秒級。欄沒用到不占空間,所以叫「稀疏」。適合時間序列、購買紀錄、IoT 資料,官方明寫「機器學習應用」。
| 特色 | 白話 |
|---|---|
| 加節點就變快 | 2,000 家分店同時刷,加機器就撐得住,不停機 |
| HBase 相容 | 原本用 Hadoop 生態的程式搬過來不用改 |
| 自動擴縮 | 看 CPU 自動加減節點 |
| 免費試用 | 10 天、500 GB SSD、1 個節點,可延到 90 天 |
| 分層儲存(預覽) | 不常用的資料放便宜的層;還有記憶體層做次毫秒讀取 |
不適合:問「誰買最多」這種要掃全表的分析,那是 BigQuery 的事。
Memorystore:最快的那一層
官方:全代管的 Redis(開源的記憶體資料庫),次毫秒存取。有 Redis、Redis Cluster,和較新的 Valkey(Redis 的開源分支)三種。
白話:資料放記憶體不放硬碟,所以最快;代價是貴、容量有限(單一 Redis 執行個體到 300 GB)。機器學習用它放:推薦結果的快取、熱門會員的特徵、Dataflow 串流處理的中間資料。
四個放一起
| BigQuery | Cloud Storage | Bigtable | Memorystore | |
|---|---|---|---|---|
| 存什麼 | 表格 | 檔案 | 鍵值、寬表 | 鍵值(記憶體) |
| 怎麼查 | SQL,掃全表 | 整個檔案拿 | 按 row key | 按 key |
| 延遲 | 秒 | 看檔案大小 | 毫秒 | 次毫秒 |
| 容量 | PB | 無上限 | PB | GB 級 |
| ML 用途 | 分析、特徵、訓練、BigQuery ML | 影像、模型檔、管線產物 | 線上特徵、時間序列 | 快取、熱資料 |
| 飲料店 | 總部帳本 | 倉庫 | 會員卡機 | 櫃台抽屜 |
算一次給你看:延遲預算
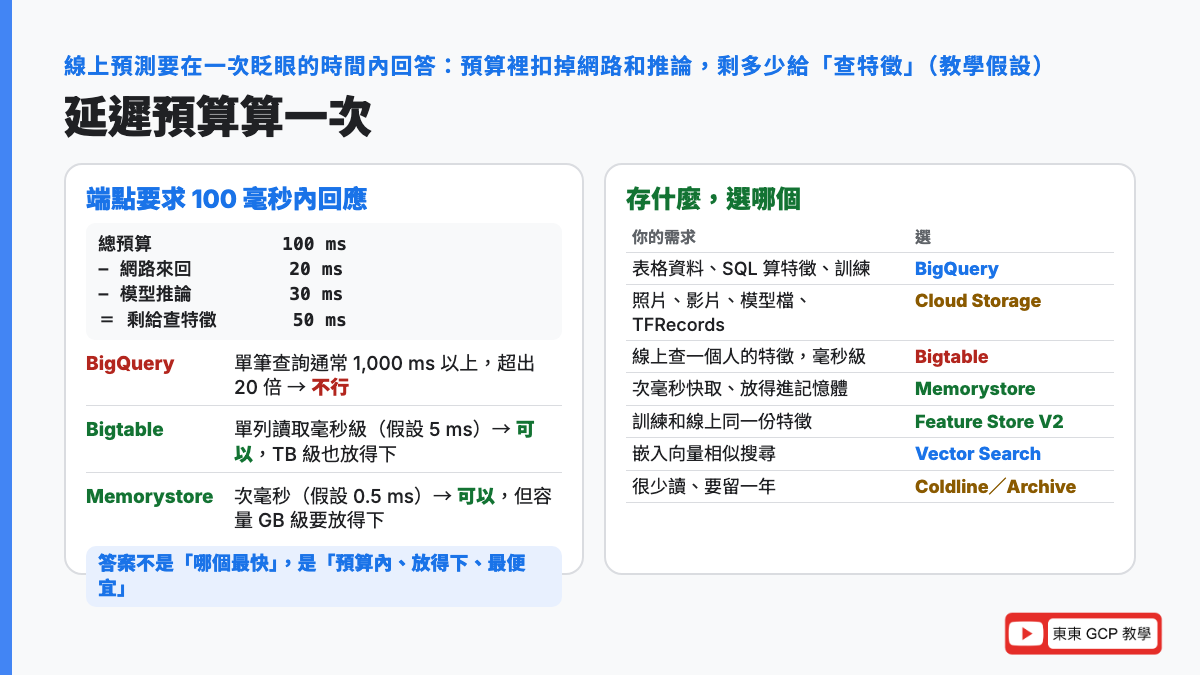
線上預測端點(第 17 篇)要求 100 毫秒內回應(教學假設):
總預算:100 ms
− 網路來回:20 ms
− 模型推論:30 ms
= 剩 50 ms 給「查特徵」

BigQuery 單筆查詢:通常 1,000 ms 以上 → 超出 20 倍,不行
Bigtable 單列讀取:毫秒級(假設 5 ms)→ 可以
Memorystore:次毫秒(假設 0.5 ms)→ 可以,但要放得下數字怎麼看:預算越緊(例如要 20 毫秒),越要往記憶體靠;資料越大(幾 TB 的會員特徵),越要用 Bigtable 而不是 Memorystore。這題的答案不是「哪個最快」,是「在預算內、放得下、最便宜」。
3. Feature Store:訓練和線上用同一份特徵
白話是什麼
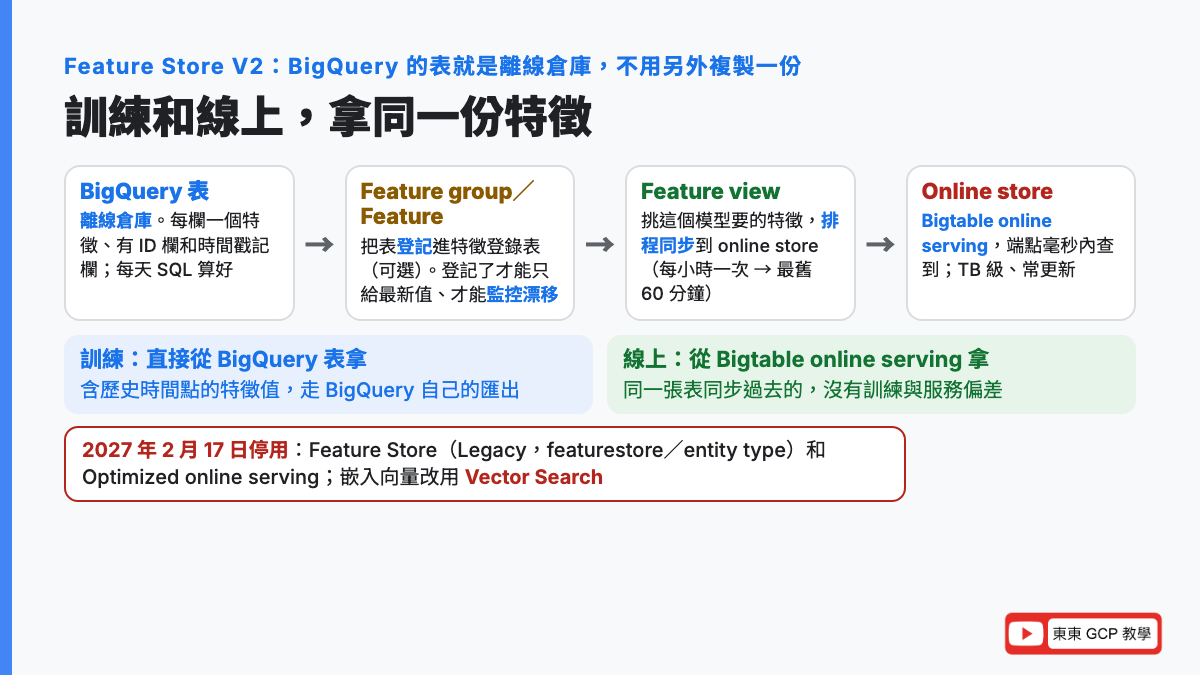
Feature Store on Gemini Enterprise Agent Platform(舊名 Vertex AI Feature Store):把算好的特徵集中管理,訓練時從 BigQuery 拿、線上預測時從 Bigtable 拿,兩邊是同一份。官方:它是 BigQuery 資料來源上面的一層中繼資料層,直接從 BigQuery 把最新特徵值搬去線上服務。
比喻
中央廚房。各分店不自己熬珍珠(各團隊不自己算「90 天來店次數」),總部熬好一鍋(BigQuery 算好),配送到每家店的保溫桶(線上倉庫)。客人拿到的和品管抽驗的是同一鍋。
來龍去脈
第 20 篇講的訓練與服務偏差(training-serving skew)最常見的原因就是:訓練時特徵用 SQL 算,上線時工程師用另一套程式重算,兩邊不一樣。Feature Store 的存在理由就是讓它們只有一個來源。另一個理由是重用:推薦模型和流失模型都要「90 天來店次數」,算一次大家用。
現在的版本(V2)長什麼樣
| 元件 | 白話 | 飲料店 |
|---|---|---|
| 離線倉庫 | 就是 BigQuery 的表或檢視,每欄一個特徵、有 ID 欄和時間戳記欄;不用另外複製 | member_features 表 |
| Feature group/Feature | 把 BigQuery 表登記進特徵登錄表(registry),可選;登記了才能按時間戳記只給最新值、才能監控漂移 | 登記「90 天來店次數」「距上次消費天數」 |
| Online store | 線上服務叢集 | 會員卡機 |
| Feature view | 從 registry 或 BigQuery 挑幾個特徵,掛到 online store,排程同步 | 推薦模型要的 8 個特徵 |
線上服務有兩種:
- Bigtable online serving:給 TB 級、常更新的資料,不支援嵌入(第 11 篇的向量)
- Optimized online serving:超低延遲、支援嵌入,但已在 2026 年 2 月 17 日淘汰、2027 年 2 月 17 日停用;淘汰公告要你改用 Bigtable online serving,嵌入改用 Vector Search
Vertex AI Feature Store(Legacy),也就是舊題庫寫的 featurestore/entity type 那套,同樣 2026 年 2 月 17 日淘汰、2027 年 2 月 17 日停用,官方說要搬到 V2。
算一次給你看:同步頻率
Feature view 排程從 BigQuery 同步到線上(教學假設):
每小時同步一次 → 線上拿到的特徵最舊 60 分鐘
改成每 10 分鐘 → 最舊 10 分鐘,但同步次數 × 6,費用跟著上升數字怎麼看:「特徵多新鮮」和「花多少錢」是對換的。流失模型看 90 天行為,一小時一次夠;要做「剛剛買了 A 就推 B」這種即時特徵,Feature Store 的排程同步不夠,要走第 4 節的 Dataflow 串流直接寫 Bigtable。
4. 處理資料:BigQuery SQL、Dataflow、Spark、Python 怎麼選
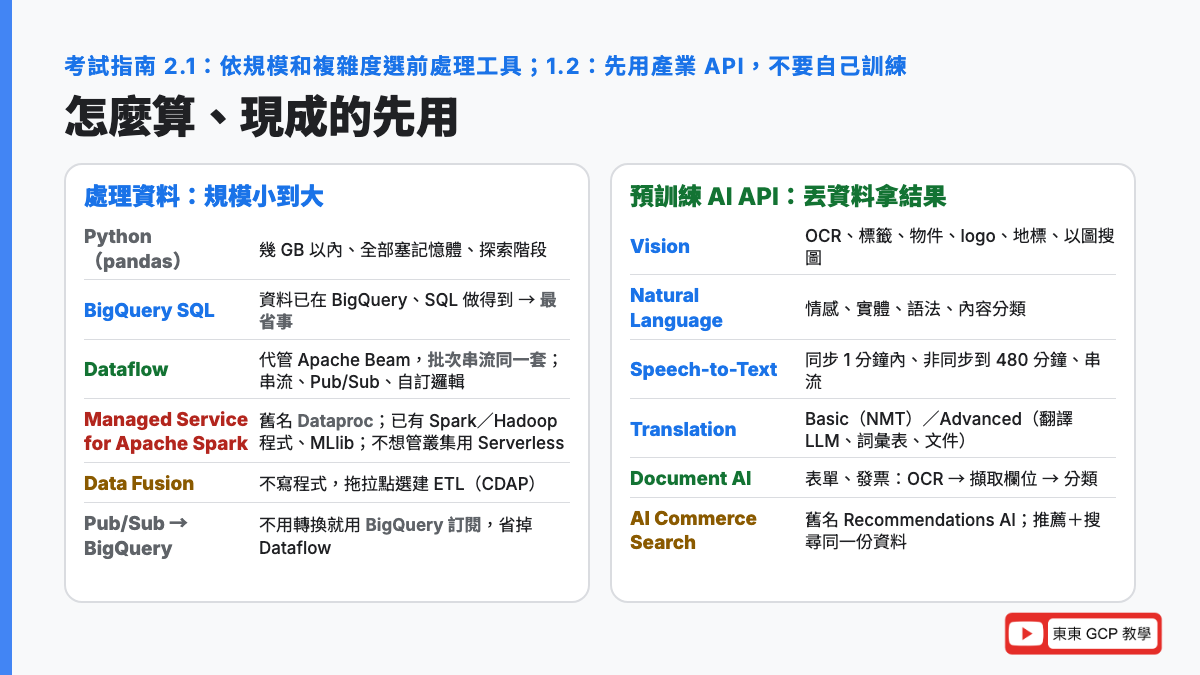
考試指南 2.1 的原話:「依規模和複雜度選前處理工具(例如 BigQuery SQL、Dataflow、Apache Spark、記憶體內的 Python 框架)」。四個工具的分界:
| 工具 | 白話 | 什麼時候選 | 飲料店 |
|---|---|---|---|
| Python(pandas) | 在筆記本裡、全部塞進記憶體 | 資料幾 GB 以內,探索階段 | 抽 10 萬筆看分布 |
| BigQuery SQL | 資料已經在 BigQuery,用 SQL 做特徵 | 表格、能用 SQL 表達的轉換,規模不是問題 | 算每個會員 90 天來店次數 |
| Dataflow | Google 代管的 Apache Beam,批次和串流同一套程式 | 要即時處理、要自訂程式邏輯、資料從 Pub/Sub 來 | 交易一進來就更新「最近一筆」特徵 |
| Managed Service for Apache Spark | 代管的 Spark/Hadoop(舊名 Dataproc) | 已有 Spark 程式、要用 Spark MLlib、團隊熟 Spark | 把舊的 Spark 特徵程式搬上雲 |
Dataflow
官方:統一的串流與批次處理,全代管、自動擴縮,預設恰好一次(exactly-once)處理。用途包括「串流資料的即時 ML 分析」、ETL 進 BigQuery。
白話:寫一次 Beam 程式,歷史資料用批次跑、新資料用串流跑,邏輯同一份,正好解決第 20 篇的偏差。它有範本(templates):Pub/Sub 到 BigQuery 這種常見流程不用寫程式。
Pub/Sub 是訊息佇列(站上有教學),白話是「郵筒」:POS 把交易丟進去,誰要就來收。官方說:訊息不用處理直接進表,用 BigQuery 訂閱就好,省掉 Dataflow;要轉換、開窗、彙總才用 Dataflow。
Managed Service for Apache Spark(舊名 Dataproc)
官方:叢集 90 秒內開好,每個 vCPU 每小時 1 美分加上機器費,整合 BigQuery、Cloud Storage、Bigtable。另有 Serverless 版:不開叢集,丟批次工作或在 BigQuery Studio 筆記本開互動 session。站上有Dataproc 是什麼。
Dataflow vs Spark 怎麼選(考試愛考):
| 看到 | 選 |
|---|---|
| 「串流」「即時」「Pub/Sub」「Beam」「批次串流同一套」 | Dataflow |
| 「已有 Spark/Hadoop 程式」「MLlib」「Hive」「搬遷」 | Managed Service for Apache Spark |
| 「不想管叢集」「偶爾跑一次 Spark」 | Serverless Spark |
| 「資料在 BigQuery、SQL 做得到」 | BigQuery SQL,最省事 |
不寫程式的:Data Fusion、Dataprep
- Cloud Data Fusion:官方說是「全代管的資料整合服務」,用開源 CDAP,拖拉點選建 ETL 管線,批次和即時都行。白話:給不想寫程式的資料工程師
- Dataprep:筆記寫的「資料清理與探索」工具,是 Trifacta(後來被 Alteryx 收購)的產品。現況:Google 的 Dataprep 產品頁已經導向 BigQuery,主控台裡以 Alteryx Designer Cloud 的名稱出現;Google 自己主推的是 BigQuery 內建的資料準備,用 Gemini 看資料給清理建議,Dataform 排程。舊題庫看到 Dataprep,知道它是第三方工具、現在有 BigQuery 內建替代
排程與協調:Managed Service for Apache Airflow
第 18 篇講過,Cloud Composer 現在叫 Managed Service for Apache Airflow,用 DAG 排整條資料流程:每天凌晨 Spark 算特徵 → BigQuery 更新 → Feature view 同步 → 觸發訓練管線。考試 5.1 把它和 Agent Platform Pipelines、Ray 並列為協調工具。
5. 現成的 AI API:先問「有沒有人做好了」
白話是什麼
預訓練 API(pre-trained API):Google 已經用海量資料訓練好的模型,你丟資料進去拿結果,不用準備訓練資料、不用訓練。考試 1.2 寫「用產業專用 API(Document AI、Vision、Translate)建方案」。
比喻
買現成的手搖飲料基底,而不是自己種茶葉。自己種(自訂訓練)只有在現成的味道不對時才值得。
有哪些
| API | 做什麼 | 飲料店 |
|---|---|---|
| Vision API | 功能表:OCR(一般文字、密集文件與手寫)、標籤、物件定位、logo、地標、裁切建議、以圖搜圖 | 讀發票、找出杯子上的 logo |
| Natural Language API | 功能:情感、實體、實體情感、語法、內容分類,自動偵測語言 | 評論是正面還是負面、提到哪家分店 |
| Speech-to-Text | 三種模式:同步(1 分鐘內)、非同步(到 480 分鐘)、串流(邊講邊轉);建議 16 kHz | 客服電話轉文字 |
| Cloud Translation | 兩版:Basic 用 NMT 模型;Advanced 多了翻譯 LLM、詞彙表、文件翻譯、批次 | 菜單翻成日文,「珍珠」固定譯法用詞彙表 |
| Document AI | 處理器分三類:數位化(Enterprise Document OCR)、擷取(Form Parser、Layout Parser、自訂擷取器)、分類(自訂分類器、分割器) | 供應商發票自動填進系統 |
| AI Commerce Search | 舊名 Recommendations AI、Vertex AI Search for Commerce;同一份商品目錄+使用者事件同時做推薦和搜尋 | App 的「你可能也喜歡」 |
怎麼判斷「用 API 還是自己訓練」
- 任務是通用的(OCR、翻譯、情感)→ API
- API 做得到但類別要客製(「封膜有沒有破」不在 Vision 的標籤裡)→ 第 14 篇的 AutoML 影像,或 Document AI 的自訂擷取器
- 文字、影片的客製需求 → AutoML Text 和 Video 已停用,改 Gemini 調校
- 以上都不行 → 自訂訓練(第 16 篇)
Vision 文件自己也說:掃描文件要 OCR 加表單欄位擷取,去用 Document AI。
6. 應用平台:程式跑在哪
筆記最後一塊「Cloud Functions、App Engine」,現況:
| 服務 | 現在 | ML 裡的角色 |
|---|---|---|
| Cloud Functions | 改叫 Cloud Run functions(對照:原 2nd gen 直接部署成 Cloud Run 服務;1st gen 還在) | 事件觸發:Cloud Storage 有新檔 → 啟動訓練管線(第 19 篇);輕量前處理 |
| App Engine | 還在,但官方寫「新使用者建議改用 Cloud Run」 | 舊的 Web/API 前端 |
| Cloud Run | 現在的主力無伺服器平台 | 第 17 篇:自己包容器服務模型,或 Agent Platform 端點以外的選擇 |
Cloud Run functions 的規格:HTTP 觸發最長 60 分鐘、16 GiB 記憶體 4 vCPU、一個執行個體可以同時接 1,000 個請求,映像只能放 Artifact Registry(Container Registry 已淘汰)。站上有Cloud Run Functions 簡介。
在 GCP 上怎麼做
飲料店的完整資料架構(2026 年 10 月)
- 交易進來:POS → Pub/Sub。不用轉換的直接開 BigQuery 訂閱進
transactions表;要算「最近 5 分鐘消費」這種開窗特徵的走 Dataflow 串流,直接寫 Bigtable - 照片進來:App 上傳到 Cloud Storage(Standard),訓練完 90 天沒碰自動轉 Coldline(開 Autoclass)
- 算特徵:每天凌晨 BigQuery SQL 算 90 天來店次數等慢特徵,寫
member_features表;舊的 Spark 程式搬到 Managed Service for Apache Spark,用 Managed Service for Apache Airflow 排 DAG - 登記特徵:
member_features登記成 Feature group,開特徵監控抓漂移(第 20 篇) - 訓練:從 BigQuery 取特徵(第 15、16 篇),模型檔放 Cloud Storage,登錄 Model Registry(第 22 篇)
- 上線:Feature view 每小時同步到 Bigtable online serving,端點(第 17 篇)50 毫秒內查到特徵;推薦結果快取到 Memorystore
- 現成的先用:發票用 Document AI、評論用 Natural Language API,不自己訓練
- 觸發:Cloud Storage 新資料到 → Cloud Run functions → 啟動 Pipelines(第 19 篇)
改名對照
| 舊名稱(筆記、舊題庫) | 現在 |
|---|---|
| Vertex AI Feature Store(Legacy:featurestore、entity type) | Feature Store on Gemini Enterprise Agent Platform(V2);Legacy 2026 年 2 月淘汰、2027 年 2 月停用 |
| Optimized online serving | 2027 年 2 月停用,改 Bigtable online serving;嵌入改 Vector Search |
| Dataproc | Managed Service for Apache Spark(叢集版與 Serverless 版) |
| Cloud Composer | Managed Service for Apache Airflow |
| Cloud Functions | Cloud Run functions |
| Dataprep | 主控台叫 Alteryx Designer Cloud(第三方);Google 主推 BigQuery 資料準備 |
| Recommendations AI、Vertex AI Search for Commerce | AI Commerce Search(Recommendations 從 Agent Search 提供) |
| Cloud Natural Language API、Cloud Vision API | 名稱沒變;文件歸在 Agent Platform 的「預訓練 API」底下 |
| Container Registry | Artifact Registry |
| Memorystore for Redis | 還在;新增 Memorystore for Valkey |
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這篇對應到:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 1 區:低程式碼 AI 方案(約 13%) | 1.2 用產業專用 API(Document AI、Vision、Translate)建方案 |
| 第 2 區:跨團隊協作管理資料與模型(約 16%) | 2.1 依規模與複雜度選前處理工具(BigQuery SQL、Dataflow、Spark、記憶體內 Python);在 Feature Store 建立與整合特徵 |
| 第 3 區:把原型放大成 ML 模型(約 21%) | 3.2 訓練資料放 Cloud Storage 和 BigQuery;從各種來源把結構化與非結構化資料餵進訓練管線 |
| 第 4 區:服務與擴展模型(約 20%) | 4.2 用 Feature Store 管理與服務特徵 |
| 第 5 區:自動化與協調 ML 管線(約 18%) | 5.1 用 Pipelines、Managed Service for Apache Airflow、Ray 協調 |
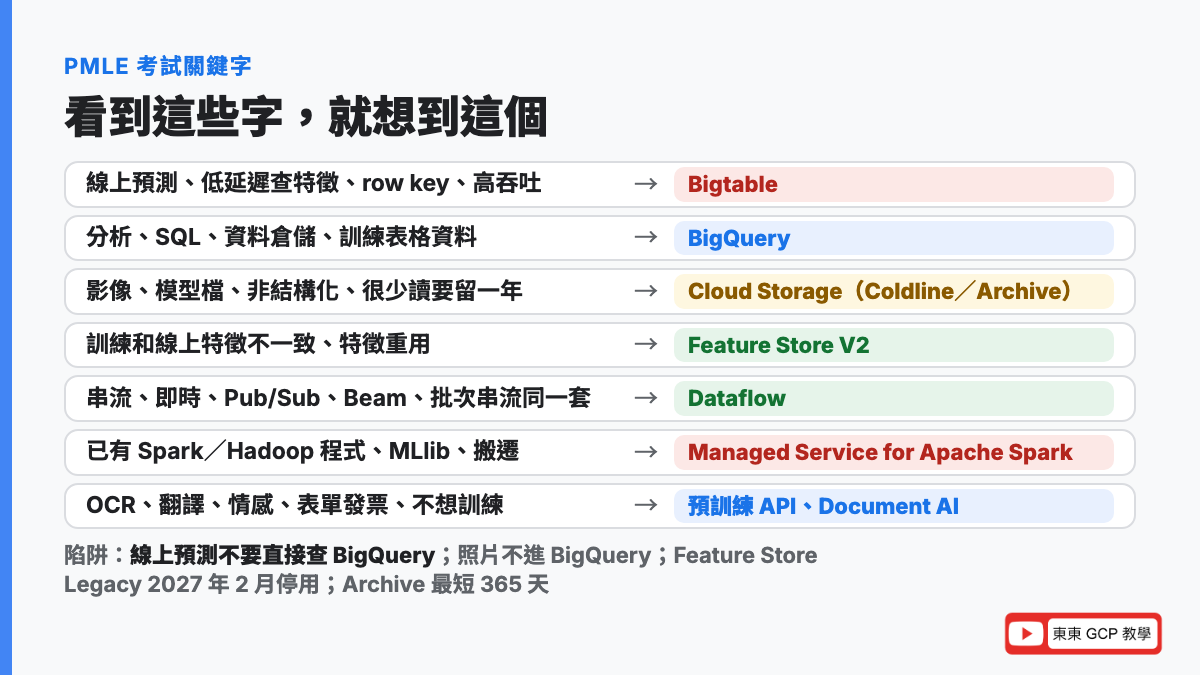
看到這些字,就想到這個
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「線上預測」「低延遲查特徵」「毫秒」「row key」「高吞吐」 | Bigtable(或 Feature Store 的 Bigtable online serving) |
| 「分析」「SQL」「資料倉儲」「掃全表」「訓練表格資料」 | BigQuery |
| 「影像」「影片」「模型檔」「非結構化」「TFRecords」 | Cloud Storage |
| 「很少存取」「保留一年」「最便宜」 | Cloud Storage Coldline/Archive,注意最短天數與取回費 |
| 「次毫秒」「快取」「記憶體」「Redis」 | Memorystore |
| 「訓練和線上特徵不一致」「特徵重用」「集中管理特徵」 | Feature Store |
| 「嵌入」「向量相似搜尋」 | Vector Search(Feature Store 的 Optimized serving 停用) |
| 「串流」「即時」「Pub/Sub」「Apache Beam」「批次串流同一套」 | Dataflow |
| 「Pub/Sub 直接進 BigQuery 不用轉換」 | BigQuery 訂閱 |
| 「Spark」「Hadoop」「Hive」「搬遷既有程式」 | Managed Service for Apache Spark(Dataproc) |
| 「資料小」「探索」「筆記本」 | 記憶體內 Python(pandas) |
| 「不寫程式的 ETL」「拖拉點選」 | Data Fusion |
| 「排程」「DAG」「跨服務的工作流」 | Managed Service for Apache Airflow |
| 「OCR」「翻譯」「情感分析」「語音轉文字」「不想訓練模型」 | 預訓練 API |
| 「表單」「發票」「擷取欄位」 | Document AI |
| 「商品推薦」「電商搜尋」 | AI Commerce Search(Recommendations AI) |
| 「新檔案到就觸發」「事件驅動」 | Cloud Run functions |
六個常見陷阱
- 線上預測去查 BigQuery:以秒計的延遲,端點會逾時。線上查特徵用 Bigtable、Memorystore,或 Feature Store 的線上服務
- 把照片存進 BigQuery:非結構化檔案放 Cloud Storage,BigQuery 存路徑就好
- 選 Feature Store(Legacy)的做法:entity type、featurestore 那套 2027 年 2 月停用,現在是 BigQuery 當離線倉庫的 V2
- 串流也選 Spark:Spark 能做串流,但 Google Cloud 的標準答案是 Dataflow(Beam);Spark 選在「已有 Spark 程式」
- 自己訓練 OCR:Vision API 或 Document AI 一行呼叫,考試看到「最少工程量」就選 API
- Archive 當一般儲存:最短 365 天,提早刪也照收,加取回費
練習情境(自己出的練習,不是真實考題)
飲料店 App 的推薦模型部署成線上端點,每次要讀該會員的 8 個特徵,要求 50 毫秒內回應。特徵每天在 BigQuery 用 SQL 算好。該怎麼把特徵端給端點?
判斷過程:
- 「50 毫秒」「線上」→ 不能直接查 BigQuery
- 「特徵已經在 BigQuery」→ Feature Store V2:BigQuery 表登記成 feature group,feature view 同步到 Bigtable online serving
- 訓練時從同一張 BigQuery 表拿,沒有訓練與服務偏差
每天 300 萬筆交易從 POS 進 Pub/Sub,要算每位會員「最近 5 分鐘消費金額」當即時特徵,也要把原始交易存進 BigQuery 給分析用。工程量最小的做法?
判斷過程:
- 「原始交易存 BigQuery、不用轉換」→ BigQuery 訂閱,不用寫程式
- 「最近 5 分鐘」是開窗彙總 → Dataflow 串流,算完寫 Bigtable 給線上用
- 不選 Spark:沒有既有 Spark 程式,Beam 一套程式批次串流都能用
供應商每月寄 2,000 張 PDF 發票,要自動抓出品項、金額、日期填進系統。團隊沒有 ML 工程師。該用什麼?
判斷過程:
- 「發票」「抓欄位」「沒有 ML 工程師」→ Document AI(發票是常見的預訓練解析器類型,或用 Form Parser)
- 不選 Vision API:它只給文字和座標,欄位要自己拼
- 不自己訓練:1.2 的重點就是先用產業 API
常見問答
機器學習的訓練資料該放 BigQuery 還是 Cloud Storage?
表格資料放 BigQuery,用 SQL 做特徵、直接 BigQuery ML 訓練,或讓自訂訓練讀 BigQuery。影像、音訊、影片、模型檔、TFRecords 這些檔案放 Cloud Storage,BigQuery 只存路徑。考試指南 3.2 兩個都列,分界就是「表格」和「檔案」。
Bigtable 和 BigQuery 差在哪?
BigQuery 是分析用的資料倉儲:用 SQL 掃全表,查 TB 級幾秒,但查一筆也以秒計。Bigtable 是 NoSQL 寬表:靠 row key 查,毫秒級、高吞吐、能到 PB,但不能做掃全表的分析。線上預測查特徵用 Bigtable,算特徵和訓練用 BigQuery。
Feature Store 是什麼?為什麼需要?
集中管理特徵的服務,讓訓練和線上預測拿到同一份特徵,避免訓練與服務偏差,也讓不同模型重用特徵。現在的 V2 版以 BigQuery 的表當離線倉庫,不用另外複製;把表登記成 feature group 和 feature,用 feature view 排程同步到 online store 的 Bigtable online serving 給端點查。
Vertex AI Feature Store(Legacy)還能用嗎?
2026 年 2 月 17 日淘汰,2027 年 2 月 17 日停用,官方要求搬到 Feature Store V2。同一天淘汰的還有 V2 的 Optimized online serving,改用 Bigtable online serving;要存和查嵌入向量改用 Vector Search。舊題庫寫的 featurestore、entity type 是 Legacy 的概念。
Dataflow 和 Dataproc 怎麼選?
Dataflow 是代管的 Apache Beam,批次和串流同一套程式,自動擴縮,預設恰好一次處理,看到「串流」「即時」「Pub/Sub」就選它。Dataproc 現在叫 Managed Service for Apache Spark,是代管的 Spark/Hadoop,選在「已經有 Spark 程式要搬上雲」「要用 MLlib、Hive」;不想管叢集用 Serverless 版。資料已經在 BigQuery、SQL 做得到,就用 BigQuery SQL 最省事。
資料前處理什麼時候用 Python 就好?
資料幾 GB 以內、能整個塞進記憶體、在探索階段,pandas 在筆記本裡最快。資料大到記憶體放不下,表格資料改 BigQuery SQL,要自訂邏輯或串流改 Dataflow,有 Spark 程式改 Managed Service for Apache Spark。考試指南 2.1 說的就是依規模和複雜度選。
Cloud Storage 的儲存類別怎麼選?
看多久拿一次:常讀的用 Standard(無最短天數、無取回費);一個月一次 Nearline(最短 30 天);一季一次 Coldline(90 天);一年一次 Archive(365 天)。冷的類別月費低但有取回費和最短天數,提早刪也照最短天數收費。AI/ML 訓練要極高吞吐有單一區域的 Rapid 類別。不確定就開 Autoclass 自動換。
什麼時候該用預訓練 API 而不是自己訓練?
任務是通用的就用 API:OCR 和物件辨識用 Vision、情感和實體用 Natural Language、語音用 Speech-to-Text、翻譯用 Cloud Translation、表單發票用 Document AI、電商推薦和搜尋用 AI Commerce Search。類別要客製但影像為主用 AutoML 影像;文字和影片的客製改 Gemini 調校(AutoML Text、Video 已停用);都不行才自訂訓練。
Dataprep 現在還在嗎?
Google 的 Dataprep 產品頁已導向 BigQuery,主控台裡以第三方的 Alteryx Designer Cloud 名稱出現。Google 主推的替代是 BigQuery 內建的資料準備功能:用 Gemini 看資料樣本給清理和轉換建議,由 Dataform 排程。舊題庫看到 Dataprep 要知道它不是 Google 自家服務。
Cloud Functions 改名了嗎?
改叫 Cloud Run functions:原本的 2nd gen 直接以 Cloud Run 服務部署,HTTP 觸發最長 60 分鐘、16 GiB 記憶體、一個執行個體可同時接 1,000 個請求;1st gen 還在。機器學習裡最常用在事件觸發:Cloud Storage 有新資料就啟動訓練管線。App Engine 還在,但官方建議新使用者改用 Cloud Run。
重點整理
- 三種動作三類服務:分析與訓練(BigQuery,秒級、掃全表)、線上查詢(Bigtable 毫秒、Memorystore 次毫秒)、放檔案(Cloud Storage,類別依多久拿一次選)
- 延遲預算:100 ms − 網路 20 − 推論 30 = 剩 50 ms 查特徵,BigQuery 以秒計所以不行;答案是「預算內、放得下、最便宜」
- Feature Store V2:BigQuery 當離線倉庫、feature view 同步到 Bigtable online serving;Legacy 與 Optimized serving 2027 年 2 月停用,嵌入改 Vector Search
- 前處理依規模與複雜度:Python(小)→ BigQuery SQL(表格)→ Dataflow(串流、自訂、Beam)→ Managed Service for Apache Spark(既有 Spark);Pub/Sub 不轉換直接 BigQuery 訂閱
- 現成的先用:Vision、Natural Language、Speech-to-Text、Translation、Document AI、AI Commerce Search;客製才 AutoML 影像、Gemini 調校、自訂訓練
- 改名:Dataproc → Managed Service for Apache Spark、Composer → Managed Service for Apache Airflow、Cloud Functions → Cloud Run functions、Recommendations AI → AI Commerce Search
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 第 3 篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切
- 第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
- 第 6 篇:ROC 曲線和 AUC 怎麼看?門檻怎麼調、AUC-PR 差在哪
- 第 7 篇:過度擬合是什麼?正則化、Dropout、提前停止 3 招解決
- 第 8 篇:資料洩漏是什麼?模型考試作弊的 3 種常見情況
- 第 9 篇:類別不平衡怎麼辦?過取樣、欠取樣與 Upweighting
- 第 10 篇:資料前處理怎麼做?標準化、遺失值、高基數類別
- 第 11 篇:特徵工程是什麼?特徵交叉、詞嵌入、資料增強一次看懂
- 第 12 篇:機器學習的資料隱私怎麼保護?DLP、聯邦學習、VPC Service Controls
- 第 13 篇:訓練資料讀太慢?TFRecords、tf.data 與 prefetch 加速
- 第 14 篇:Vertex AI AutoML、BigQuery ML、自訂訓練怎麼選?
- 第 15 篇:BigQuery ML 入門:只會 SQL 也能訓練模型
- 第 16 篇:Vertex AI 自訂訓練:容器、分散式訓練、GPU 與 TPU
- 第 17 篇:模型部署怎麼選?線上預測 vs 批次預測、流量分割
- 第 18 篇:MLOps 是什麼?Vertex AI Pipelines、Kubeflow、TFX 介紹
- 第 19 篇:機器學習的 CI/CD:程式改了、資料來了,模型自動重訓
- 第 20 篇:模型上線後會變笨?Drift 與 Training-Serving Skew 監控
- 第 21 篇:可解釋 AI 是什麼?Shapley、Integrated Gradients、XRAI
- 上一篇:第 22 篇:實驗怎麼追蹤?Vertex AI Experiments、Metadata、TensorBoard
- 下一篇:第 24 篇:GCP ML 證照怎麼考?PMLE 考試範圍、準備地圖與 23 篇重點整理
站上相關文章
- BigQuery 是資料庫嗎?跟資料庫差在哪
- BigQuery 計費方式完整指南
- 把資料上傳到 BigQuery 的各種方法
- Dataproc 是什麼?四大優勢與使用方法
- Cloud Pub/Sub 教學
- Cloud Run Functions 簡介與基本操作
- GCP 帳單爆炸防護指南
- GCP 學習路徑 Roadmap
資料放對地方、算對地方,模型才跑得快又不燒錢。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。