類別不平衡怎麼辦?先別看準確率,再用過取樣、欠取樣加權或類別權重,讓模型多注意那一小群少數資料。
這篇用信用卡盜刷當例子:10,000 筆交易裡只有 100 筆是盜刷。我們會一步一步算給你看,為什麼模型學不會抓盜刷、過取樣和欠取樣各怎麼做,以及 Google 推薦的「欠取樣再加權」為什麼一定要做第二步。
為什麼你需要知道
- 真實世界的資料大多不平衡:盜刷、罕見疾病、設備故障、垃圾信,你最想抓的那一類,通常都是最少的那一類
- 模型會「偷懶」:少數類別太少,模型只要一直猜多數類別,分數就很好看,第 5 篇算過,準確率 99% 也可能一個都沒抓到
- 處理方法有順序、有陷阱:資料複製的時機錯了,會變成第 8 篇的資料洩漏;欠取樣少做一步,模型會高估風險好幾倍
- 證照必考:PMLE 考題很愛問「詐騙只佔 0.1%,該怎麼訓練、怎麼評估」
類別不平衡(Class Imbalance)
白話是什麼
類別不平衡:分類資料裡,某一類的數量遠遠少於另一類。
- 數量多的那一類,叫多數類別(Majority Class),例如正常交易
- 數量少的那一類,叫少數類別(Minority Class),例如盜刷交易
比喻
像班上 99 個人講國語、只有 1 個人講台語。老師如果只照「大家最常說什麼」來學,很快就會國語說得很好,台語一句也學不會,因為練習的機會太少了。
來龍去脈
Google 機器學習速成課程舉的例子:信用卡交易裡,盜刷可能不到 0.1%;醫療診斷資料裡,某種罕見病毒的病人可能不到 0.01%。速成課程也直接說:真實世界裡,不平衡的資料遠比平衡的資料常見。
反過來,如果兩類數量差不多(例如 235 筆對 247 筆),就叫平衡的資料集。
為什麼要學
模型學不會少數類別,偏偏少數類別通常就是你最想抓的那一類。不處理的話,你會得到一個準確率很高、但完全沒用的模型。
算一次給你看:為什麼模型學不會抓盜刷
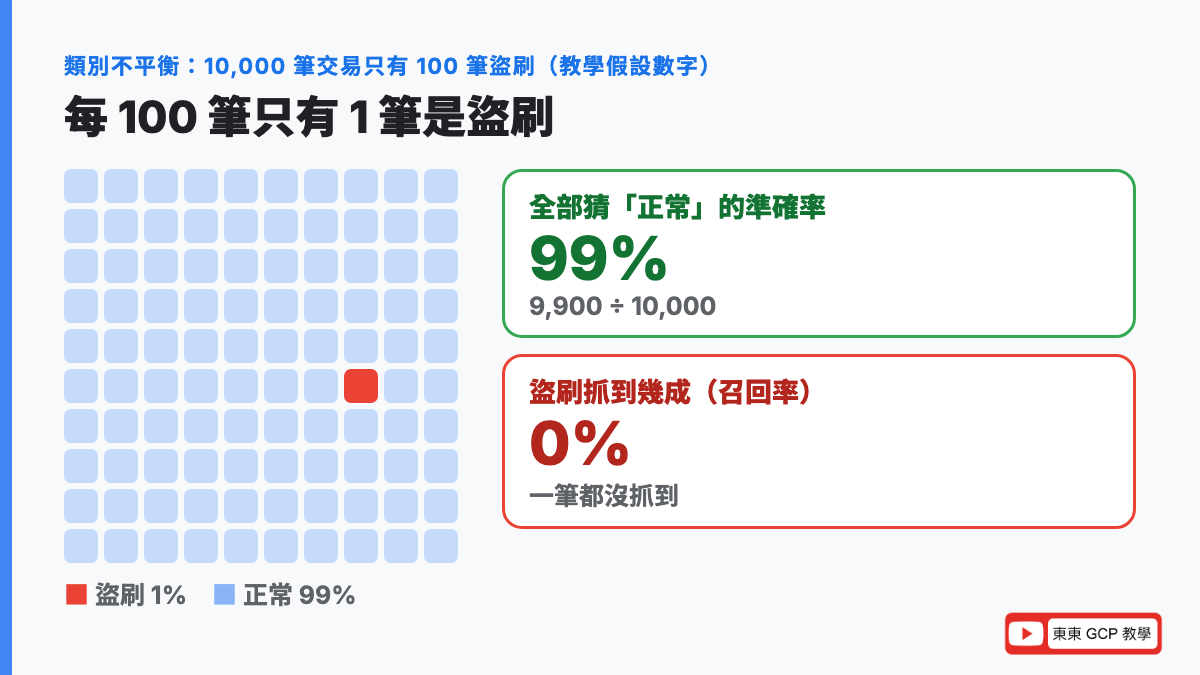
假設(教學用的數字)銀行有 10,000 筆交易,其中 100 筆盜刷、9,900 筆正常:
盜刷比例 = 100 ÷ 10,000 = 1%問題 1:偷懶就能拿高分
模型如果全部猜「正常」:
準確率 = 猜對的 ÷ 全部 = 9,900 ÷ 10,000 = 99%
召回率 = 抓到的盜刷 ÷ 全部盜刷 = 0 ÷ 100 = 0%
準確率 99%,一筆盜刷都沒抓到。這就是第 5 篇講的「準確率陷阱」。
問題 2:練習時根本看不到盜刷
模型訓練時,不是一次看完 10,000 筆,而是一小批一小批地看(一批叫一個 Batch,第 3 篇講過的批次大小)。每批看完就修正一次。
如果一批 100 筆,盜刷佔 1%:
每批平均有幾筆盜刷 = 100 × 1% = 1 筆
某一批「一筆盜刷都沒有」的機率 = 0.99 的 100 次方 ≈ 0.37
(每一筆是正常交易的機率是 0.99,100 筆全部都是正常,就是 0.99 連乘 100 次。)
如果一批只有 20 筆:
某一批一筆盜刷都沒有的機率 = 0.99 的 20 次方 ≈ 0.82數字怎麼看
- 一批 100 筆時,大約每 3 批就有 1 批完全沒有盜刷;就算有,通常也只有 1 筆
- 一批 20 筆時,超過 8 成的批次完全看不到盜刷
- 模型大部分時間都在練習「什麼是正常交易」,幾乎沒機會學「盜刷長什麼樣子」。Google 速成課程的說法一樣:嚴重不平衡時,大部分的批次裡根本沒有少數類別
第一步永遠是:換掉評估方式
在動資料之前,先把「怎麼打分數」換掉,不然你根本看不出處理得好不好:
| 不要看 | 改看 | 為什麼 |
|---|---|---|
| 準確率(Accuracy) | 召回率(Recall) | 盜刷抓到幾成,第 5 篇 |
| 精確率(Precision) | 被抓的有幾成真的是盜刷 | |
| F1 分數 | 兩個都顧 | |
| AUC-ROC | AUC-PR | 不平衡時 ROC 會被大量正常交易灌水,第 6 篇 |
另外,驗證集和測試集要保持真實比例(1% 盜刷)。下面介紹的過取樣、欠取樣,只能動訓練集,原因後面會講。
解法 1:過取樣(Oversampling),把少的那一類複製多一點
白話是什麼
過取樣:把少數類別的資料重複使用好幾次,讓它在訓練集裡變多。
比喻
像考前把錯最多的題型多抄幾份來練。題目本身沒有變多,但你練到的次數變多了。
來龍去脈
依照 Google 機器學習詞彙表,過取樣就是重複使用少數類別的樣本,讓訓練集比較平衡。例如多數對少數是 5,000 比 1 時,100 萬筆資料裡只有約 200 筆少數類別,太少了,可以把這 200 筆重複使用很多次。
除了直接複製,也有用相似的樣本「內插」出新資料的做法,最有名的是 SMOTE(Synthetic Minority Over-sampling Technique,合成少數類別過取樣),可以參考 imbalanced-learn 的說明。
算一次給你看
把 100 筆盜刷各複製成 10 份:
盜刷變成 = 100 × 10 = 1,000 筆
正常交易 = 9,900 筆(不動)
盜刷比例 = 1,000 ÷ (1,000 + 9,900) = 1,000 ÷ 10,900 ≈ 9.2%
盜刷從 1% 變成約 9.2%,每批 100 筆裡平均就有 9 筆盜刷可以練習。
數字怎麼看,和兩個陷阱
- 好處:資料一筆都沒丟,少數類別練習機會變多
- 陷阱 1:容易死背。同一筆盜刷被看 10 次,模型可能記住「這 100 筆的細節」,而不是盜刷的共同特徵,也就是第 7 篇的過度擬合
- 陷阱 2:先複製再切,就洩漏了。如果先把資料複製 10 份,再切訓練集、測試集,同一筆盜刷的分身會同時出現在兩邊,測試分數會假性變好。正確順序:先切資料,再只對訓練集過取樣(第 8 篇講過的「考卷混進練習題」)
解法 2:欠取樣+加權(Downsampling + Upweighting)
這是 Google 速成課程推薦的做法,分兩步。速成課程還特別先打預防針:很多學生第一次看到會覺得「這不可能是對的」,因為它有點反直覺。
白話是什麼
- 欠取樣(Downsampling):訓練時只用一部分的多數類別,把多數類別變少
- 加權(Upweighting):被丟掉的那一類,每一筆的錯誤算重一點,把丟掉的份量補回來
比喻
像做民調。台北人太多,你只抽十分之一來訪問,省時間;但統計時,每個台北人的回答要乘以 10,結果才會代表真正的全台灣。
來龍去脈
為什麼要拆成兩步?速成課程的解釋是:模型要學會兩件事,
- 每一類長什麼樣子(哪些特徵對應盜刷)
- 每一類有多常見(盜刷其實只佔 1%)
一般的訓練把這兩件事混在一起。欠取樣讓模型看清楚第 1 件事;加權把第 2 件事補回來。
算一次給你看:只做第一步會怎樣
第一步:欠取樣,正常交易只留 十分之一:
正常交易 = 9,900 ÷ 10 = 990 筆
盜刷     = 100 筆(全部保留)
盜刷比例 = 100 ÷ (100 + 990) = 100 ÷ 1,090 ≈ 9.2%問題來了:模型練習時看到的世界,每 11 筆就有 1 筆是盜刷,但真實世界是每 100 筆才 1 筆。它學到的「盜刷有多常見」高估了大約 9 倍。上線後,它給每筆交易的盜刷機率都會偏高。這種「模型平均預測值和真實比例對不上」的現象,叫預測偏差(Prediction Bias)。
第二步:加權,正常交易丟掉了九成,所以每一筆正常交易的錯誤算 10 倍:
加權後的正常交易份量 = 990 × 10 = 9,900
加權後的盜刷比例 = 100 ÷ (100 + 9,900) = 100 ÷ 10,000 = 1%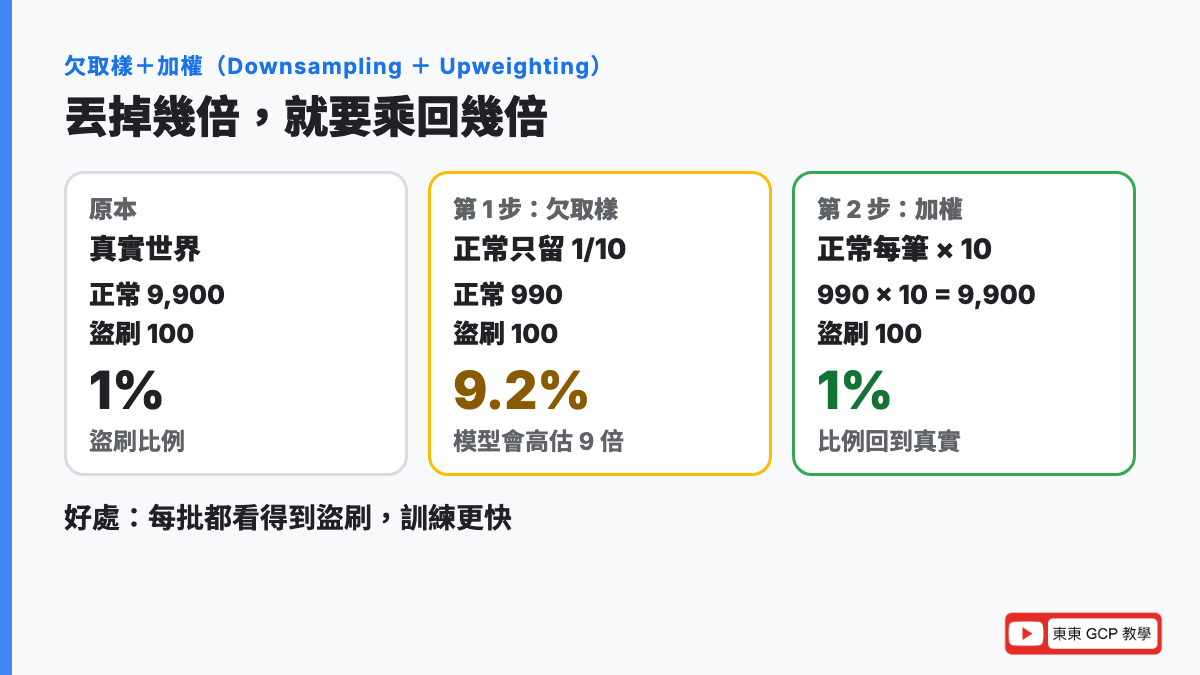
數字怎麼看
- 只欠取樣:盜刷看起來佔 9.2%,模型會高估風險
- 欠取樣+加權:練習時盜刷夠多(學得到樣子),算分數時比例又回到 1%(知道它很少見)
- 欠取樣幾倍、加權幾倍,要一樣:丟掉九成就乘 10,丟掉一半就乘 2
- 幾倍最好? 速成課程建議把它當成超參數,多試幾種比例;重點是每一批裡要有足夠的少數類別
為什麼要學
速成課程列出的好處:模型更好(同時知道盜刷的樣子和真實比例)、訓練更快收斂(每批都看得到盜刷),而且資料變少,也省硬碟空間和訓練時間。資料量很大時,這招特別划算。
解法 3:類別權重(Class Weights),直接把少數類別的錯算重一點
白話是什麼
類別權重:資料不動,但告訴模型:漏掉一筆盜刷,要扣的分是錯判一筆正常交易的好幾倍。
比喻
像考試的配分。選擇題一題 1 分、申論題一題 20 分。題目數量沒變,但學生自然會花更多力氣在申論題上。
來龍去脈
這跟解法 2 的「加權」是同一個工具,只是方向不同:
- 解法 2:先丟掉多數類別,再把多數類別加權補回來
- 解法 3:資料不丟,直接把少數類別加權
Google 速成課程的摘要提到:直接加權少數類別比較簡單,但跟「欠取樣+加權多數類別」比起來,可能會增加預測偏差。
算一次給你看:BigQuery ML 的自動權重
BigQuery ML 有一個選項 AUTO_CLASS_WEIGHTS,依照官方文件,它用這條公式自動算每一類的權重:
某一類的權重 = 總筆數 ÷ (這一類的筆數 × 類別數)套進我們的數字(2 類):
盜刷的權重 = 10,000 ÷ (100 × 2)   = 10,000 ÷ 200    = 50
正常的權重 = 10,000 ÷ (9,900 × 2) = 10,000 ÷ 19,800 ≈ 0.505

兩類的總份量:
盜刷 = 100 × 50      = 5,000
正常 = 9,900 × 0.505 ≈ 5,000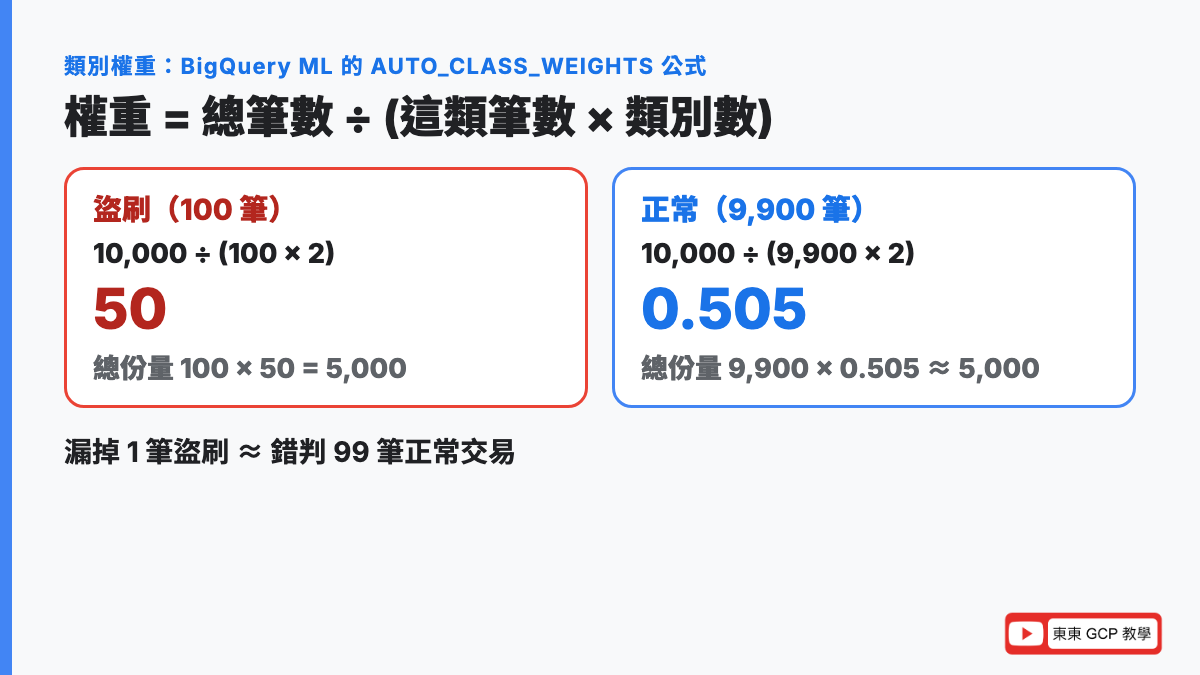
數字怎麼看
- 加權之後,兩類的總份量都是 5,000,模型會把兩類看得一樣重
- 漏掉 1 筆盜刷的代價(50),等於錯判 約 99 筆正常交易(50 ÷ 0.505 ≈ 99)
- 代價:模型會變得比較敢說「盜刷」,召回率上升、精確率下降,就是第 6 篇講的取捨
- 權重不一定要用自動公式,也可以自己設,例如只想讓盜刷重 10 倍
解法 4:調門檻,不用重新訓練
第 6 篇〈ROC 曲線和 AUC 怎麼看?〉講過,模型會先算出一個機率,再跟門檻比。預設門檻 0.5 對盜刷來說通常太高,因為盜刷的機率本來就很少超過一半。
把門檻調低(例如 0.2),模型就比較敢說「這筆是盜刷」,召回率上升。這招不用動資料、不用重新訓練,常常是最快的第一步。
4 招一張表比完
| 過取樣 | 欠取樣+加權 | 類別權重 | 調門檻 | |
|---|---|---|---|---|
| 白話 | 少的複製多一點 | 多的丟一些,再把份量補回來 | 少的錯算重一點 | 降低判斷「是」的標準 |
| 比喻 | 錯題多抄幾份練 | 民調抽樣再乘回去 | 申論題配分高 | 及格線調低 |
| 資料量 | 變多 | 變少 | 不變 | 不變 |
| 訓練速度 | 變慢 | 變快 | 不變 | 不用重訓 |
| 主要風險 | 死背重複的資料 | 丟掉一些資訊;忘了加權會高估 | 精確率下降、預測偏差 | 精確率下降 |
| 適合 | 資料量不大 | 資料量很大 | 想快速試、不想動資料 | 模型已經訓練好 |
實務順序建議:先換評估指標 → 試調門檻 → 試類別權重 → 資料量大就欠取樣+加權、資料量小就過取樣。不管用哪一招,都只動訓練集。
在 GCP 上怎麼做
GCP(Google Cloud Platform) 是 Google 的雲端服務,白話說就是租用 Google 機房裡的電腦和工具。
1. BigQuery ML:一行開啟類別權重
- BigQuery:Google 的大型資料倉庫,專門存放和分析超大量的表格資料
- BigQuery ML:讓你用 SQL(跟資料庫說話的語言)直接在 BigQuery 裡訓練模型
自動權重(教學用的範例,label 欄位裡是 fraud 或 normal):
CREATE MODEL `bank.fraud_model`
OPTIONS(model_type='LOGISTIC_REG',
        input_label_cols=['label'],
        auto_class_weights=TRUE) AS
SELECT amount, merchant_type, hour_of_day, label
FROM `bank.transactions_train`;欠取樣+自己設權重:正常交易只留十分之一,再用 CLASS_WEIGHTS 把正常交易的權重設成 10:
CREATE MODEL `bank.fraud_model_ds`
OPTIONS(model_type='LOGISTIC_REG',
        input_label_cols=['label'],
        class_weights=[STRUCT('normal', 10.0), STRUCT('fraud', 1.0)]) AS
SELECT amount, merchant_type, hour_of_day, label
FROM `bank.transactions_train`
WHERE label = 'fraud'
OR MOD(ABS(FARM_FINGERPRINT(transaction_id)), 10) = 0;最後一行的意思是:盜刷全部留下,正常交易用交易編號算一個固定的號碼,只留號碼尾數是 0 的那十分之一。用 FARM_FINGERPRINT 而不是隨機抽,好處是每次跑都抽到同一批,結果可以重現。
依照官方文件,幾個要注意的地方:
AUTO_CLASS_WEIGHTS預設是 FALSE,也就是預設不處理不平衡- 在線性模型的文件裡,它只能用在邏輯迴歸;深度神經網路等分類模型也有同樣的選項
AUTO_CLASS_WEIGHTS和CLASS_WEIGHTS不能同時設CLASS_WEIGHTS要每一個類別都給權重,權重加起來不用等於 1- 評估時用
ML.EVALUATE看precision、recall、f1_score,用ML.ROC_CURVE找適合的門檻(第 6 篇)
2. AutoML on Agent Platform:選對最佳化目標
AutoML:只要把資料丟進去,Google 自動幫你挑模型、調超參數的服務,不用寫程式。
舊題庫可能還會看到 Vertex AI AutoML 或 AutoML Tables,現在叫 AutoML on Gemini Enterprise Agent Platform。
Google Cloud 在 2026 年 4 月 22 日把 Vertex AI 改名為 Gemini Enterprise Agent Platform(簡稱 Agent Platform),底下功能跟著改名(官方對照表)。功能本身是延續的。
表格資料的分類模型,第 6 篇介紹過可以選最佳化目標。少數類別才是重點時,選 AUC PR(maximize-au-prc),官方文件的說明是「為比較少見的那一類最佳化」。
另外第 4 篇提過:AutoML 不會幫你做分層抽樣,少數類別很少時,要自己用手動切分確保驗證集、測試集裡都有盜刷。
3. Agent Platform 自訂訓練(原 Vertex AI Training)
自己寫程式訓練時,以 Keras 為例,類別權重一行就能加:
model.fit(x_train, y_train,
          validation_data=(x_val, y_val),
          class_weight={0: 0.505, 1: 50.0})   # 0 是正常、1 是盜刷
數字就是上面 AUTO_CLASS_WEIGHTS 公式算出來的權重。寫好的程式可以放到 Gemini Enterprise Agent Platform Managed Training(原 Vertex AI Training)上跑。
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這篇的內容對應到:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 1 區:用低程式碼方式打造 AI 方案(約 13%) | 用 BigQuery ML、Agent Platform AutoML 建分類模型 |
| 第 2 區:跨團隊管理資料與模型(約 16%) | 探索與前處理資料、評估模型 |
| 第 3 區:把原型擴展成正式模型(約 21%) | 排除模型訓練的問題 |
看到這些字,就想到這個
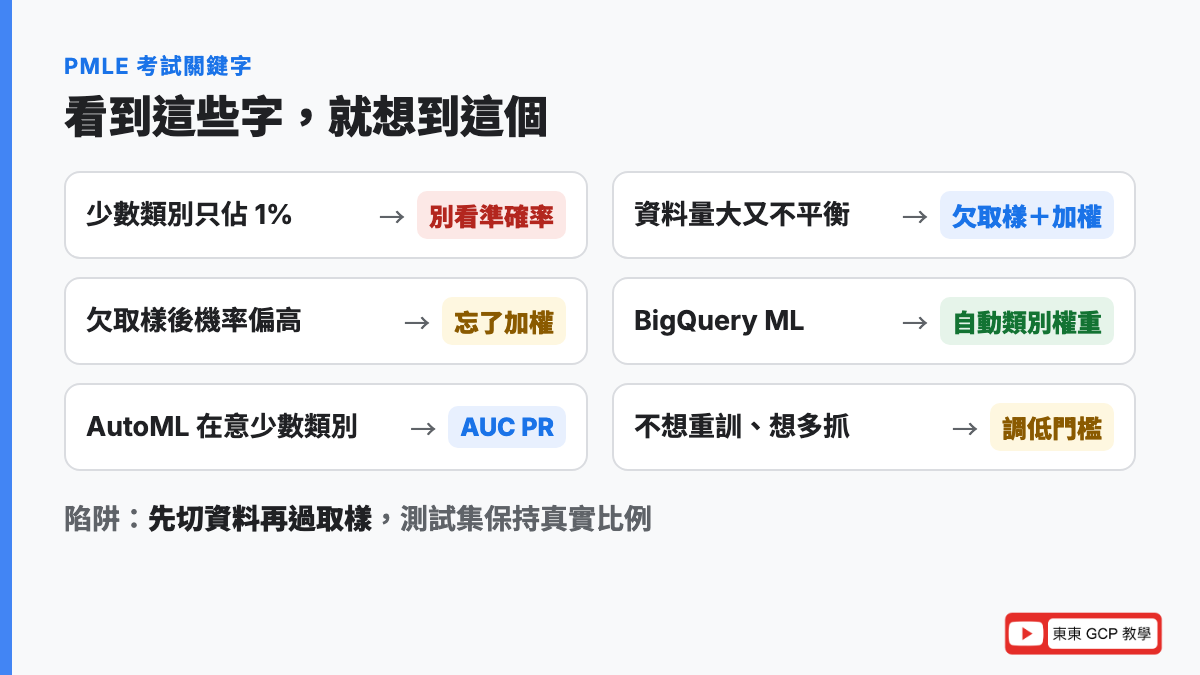
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「詐騙只佔 0.1%」「罕見」「極度不平衡」 | 類別不平衡,先換評估指標 |
| 「準確率很高,但抓不到少數類別」 | 不看準確率,改看召回率、F1、AUC-PR |
| 「資料量很大,訓練太慢,又不平衡」 | 欠取樣+加權(Downsampling + Upweighting) |
| 「欠取樣後,模型預測的機率普遍偏高」 | 忘了加權(Upweighting) |
| 「BigQuery ML 邏輯迴歸,類別不平衡」 | AUTO_CLASS_WEIGHTS=TRUE |
| 「AutoML 表格分類,在意少數類別」 | 最佳化目標選 AUC PR |
| 「少數類別樣本太少」 | 過取樣(記得先切資料) |
| 「不想重新訓練,想多抓一些」 | 調低門檻 |
三個常見陷阱
- 測試集也做了平衡:測試集要反映真實比例,才能知道上線後的表現;過取樣、欠取樣只動訓練集
- 先過取樣再切資料:同一筆的分身跨到測試集,分數假性變好,這是資料洩漏
- 欠取樣後沒加權:模型以為少數類別很常見,上線後一直誤報
練習情境(自己出的練習,不是真實考題)
一家電商有 5 億筆點擊紀錄,要預測「會不會下單」,下單只佔 0.2%。用全部資料訓練一次要 3 天,團隊希望縮短訓練時間,同時不要讓模型高估下單機率。最適合的做法是什麼?
判斷過程:
- 「只佔 0.2%」→ 類別不平衡
- 「資料量很大、訓練要 3 天」→ 適合欠取樣,把「沒下單」的資料大量丟掉,訓練變快
- 「不要高估下單機率」→ 欠取樣之後一定要加權,丟掉幾倍就乘回幾倍
- 評估時用真實比例的測試集,看召回率、精確率或 AUC-PR,不看準確率
常見問答
類別不平衡是什麼?
類別不平衡是分類資料中,某一類的數量遠少於另一類,例如 10,000 筆交易只有 100 筆盜刷。數量多的叫多數類別,少的叫少數類別。真實世界的資料大多是不平衡的,而且少數類別通常就是最想抓的那一類。
類別不平衡為什麼不能看準確率?
因為模型只要全部猜多數類別,準確率就很高。例如盜刷佔 1%,全部猜正常的準確率是 99%,但召回率是 0,一筆盜刷都沒抓到。不平衡時要改看召回率、精確率、F1 或 AUC-PR。
過取樣和欠取樣差在哪?
過取樣是把少數類別重複使用好幾次,讓它變多,資料量變大;欠取樣是只用一部分的多數類別,讓它變少,資料量變小、訓練變快。過取樣容易讓模型死背重複的資料,欠取樣會丟掉一些資訊,而且要記得加權。
欠取樣之後為什麼要加權(Upweighting)?
因為欠取樣讓模型看到一個比真實世界更平衡的假世界,它會高估少數類別有多常見。例如正常交易只留十分之一,盜刷看起來從 1% 變成 9.2%。把每筆正常交易的權重乘 10,份量回到 9,900 筆,比例就回到真實的 1%。
類別權重怎麼算?
BigQuery ML 的 AUTO_CLASS_WEIGHTS 用「總筆數 ÷(這一類的筆數 × 類別數)」計算。10,000 筆交易裡有 100 筆盜刷時,盜刷的權重是 50、正常交易約 0.505,兩類加權後的總份量都是 5,000,模型會把兩類看得一樣重。
過取樣要在切資料之前還是之後?
一定要在切資料之後,而且只對訓練集做。如果先複製再切,同一筆資料的分身會同時出現在訓練集和測試集,測試分數會假性變好,這是資料洩漏。驗證集和測試集要保持真實的比例。
SMOTE 是什麼?
SMOTE 是合成少數類別過取樣(Synthetic Minority Over-sampling Technique),它不是直接複製少數類別的資料,而是用相似樣本之間「內插」出新的資料點,讓少數類別變多,比單純複製比較不容易死背。
BigQuery ML 怎麼處理類別不平衡?
可以設 AUTO_CLASS_WEIGHTS=TRUE 讓它依各類比例自動算權重(預設是 FALSE),或用 CLASS_WEIGHTS 自己指定每一類的權重,兩者不能同時用。欠取樣可以在 SQL 裡用 FARM_FINGERPRINT 固定抽出一部分多數類別,評估時再用 ML.ROC_CURVE 找適合的門檻。
重點整理
- 類別不平衡:少數類別太少,模型會一直猜多數類別;全部猜正常也有 99% 準確率,所以先換評估指標
- 過取樣:少數類別複製多一點;小心死背,而且先切資料再複製
- 欠取樣+加權:多數類別丟掉一部分讓訓練變快,再乘回同樣倍數,比例才會回到真實;Google 速成課程推薦這招
- 類別權重:資料不動,少數類別的錯算重一點;BigQuery ML 用
AUTO_CLASS_WEIGHTS(預設關閉)或CLASS_WEIGHTS - 調門檻最快、不用重訓;AutoML 在意少數類別就選 AUC PR;不管哪一招,驗證集、測試集都要保持真實比例
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 第 3 篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切
- 第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
- 第 6 篇:ROC 曲線和 AUC 怎麼看?門檻怎麼調、AUC-PR 差在哪
- 第 7 篇:過度擬合是什麼?正則化、Dropout、提前停止 3 招解決
- 上一篇:第 8 篇:資料洩漏是什麼?模型考試作弊的 3 種常見情況
- 下一篇:第 10 篇:資料前處理怎麼做?標準化、遺失值、高基數類別
站上相關文章
- BigQuery 不就是查詢嗎?跟資料庫差在哪裡?能做什麼分析?
- BigQuery 計費方式完整介紹:費用結構、自動擴充與省錢技巧全攻略
- iPAS AI 應用規劃師初級認證考試 人工智慧概論 重點整理&簡報下載
- GCP 學習路徑 Learning Roadmap 和八大關卡
類別不平衡的關鍵,是讓模型「看得到」少數類別,又「不誤會」它有多常見。下一篇要講資料前處理:數字怎麼縮放、缺的資料怎麼補、類別太多怎麼辦。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。