資料前處理怎麼做?把數字縮放到差不多大小、把缺的值補好並做記號、把類別轉成數字,類別太多就用雜湊或嵌入。
這篇繼續用手搖飲料店當例子,不過這次是有 2,000 間分店的連鎖店。我們會把一張「原始資料表」一步一步整理成模型吃得下的樣子,每一步都帶數字算一次,最後看 BigQuery ML 哪些步驟會自動幫你做、哪些要自己寫。
為什麼你需要知道
- 模型只看得懂數字:「晴天」「雨天」、分店代碼「A0127」,模型都不認得,要先轉成數字
- 資料一定是髒的:溫度計會壞、店員會漏填、某天包場營業額暴增。Google 速成課程也提醒:夠大的資料集,幾乎一定有不合規則的怪值
- 前處理做錯,比模型選錯更傷:數字大小差太多,模型訓練得很慢;缺值亂補,模型學到錯的規律;前處理偷看了測試資料,就是第 8 篇的資料洩漏
- 證照必考:PMLE 考試指南第 2 區明列「探索與前處理資料」,第 5 區還有「確保訓練和上線的前處理一致」
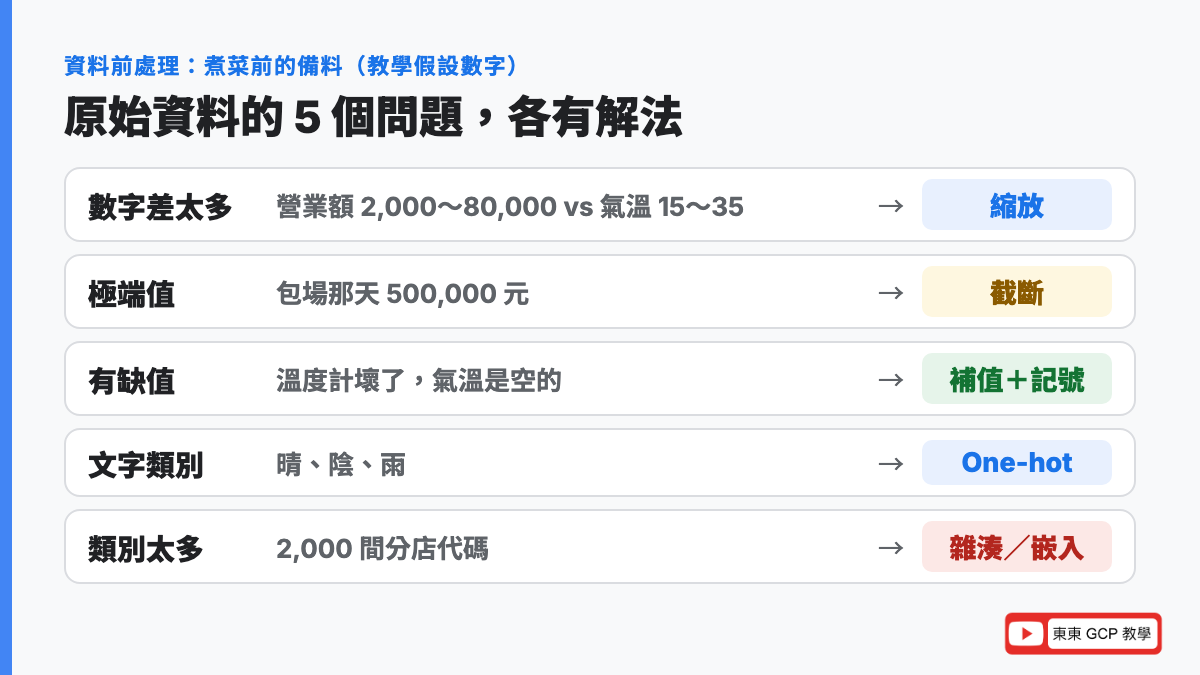
先看全貌:一張原始資料表有哪些問題
假設(教學用的數字)連鎖飲料店每間分店、每一天都有一筆紀錄,要預測當天賣幾杯:
| 欄位 | 範例 | 問題 | 處理方法 |
|---|---|---|---|
| 氣溫 | 15~35 度 | 有幾天溫度計壞了,沒有值 | 補值+做記號 |
| 前一天營業額 | 2,000~80,000 元 | 跟氣溫差了好幾千倍,大小不一 | 縮放(標準化) |
| 某天營業額 | 500,000 元 | 公司包場,極端值 | 截斷 |
| 天氣 | 晴、陰、雨 | 是文字,模型看不懂 | One-hot 編碼 |
| 分店代碼 | A0001~A2000 | 有 2,000 種,類別太多 | 雜湊分桶或嵌入 |
資料前處理(Data Preprocessing):訓練模型之前,把原始資料清乾淨、轉成數字、調整到適合的大小的這些步驟。
比喻:像煮菜前的備料。菜要洗、要切、要去掉壞掉的部分,大小切得差不多,才能一起下鍋。再好的廚師(模型),拿到沒洗的菜也煮不好。
下面一個問題、一個問題處理。
1. 數字大小差太多:縮放(Normalization)
白話是什麼
縮放:把不同特徵的數字,換算到差不多的範圍,例如都變成 0 到 1 之間,或都以 0 為中心。
比喻
像把不同國家的價錢換算成同一種貨幣。日幣 1,000 和美金 10,數字差 100 倍,但不換算的話,你會以為日幣的東西貴很多。
來龍去脈
Google 機器學習速成課程舉的例子:一個特徵從 154 到 24,917,482,另一個只從 5 到 22,範圍差太多了。縮放的好處:
- 訓練收斂比較快:數字範圍差很多時,模型在修正參數時會「彈來彈去」,很難穩定
- 模型不會偏心:沒縮放的話,數字大的特徵(營業額)很容易被模型看得比數字小的特徵(氣溫)重要
- 避免數字爆掉:數字太大時,計算可能超出電腦能表示的範圍,出現 NaN(不是數字)
四種常見做法,各算一次
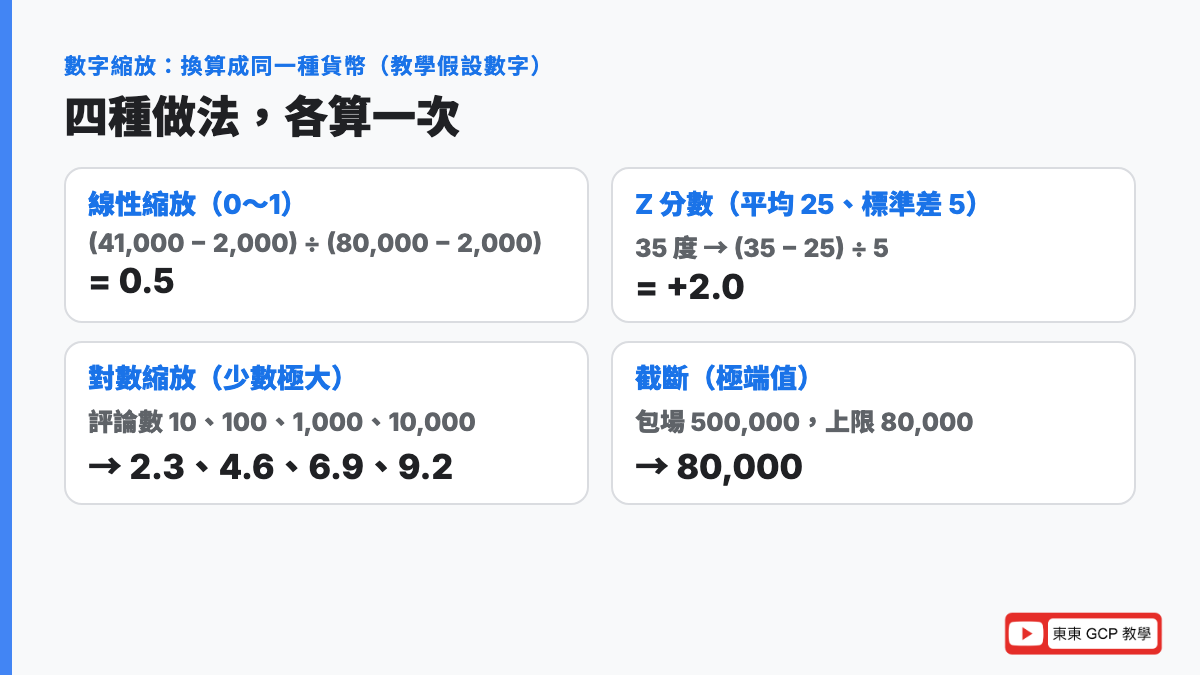
做法 1:線性縮放(Linear Scaling,也叫 Min-Max 縮放),換算到 0~1:
縮放後 = (原始值 − 最小值) ÷ (最大值 − 最小值)

前一天營業額 41,000 元,範圍 2,000~80,000:
= (41,000 − 2,000) ÷ (80,000 − 2,000)
= 39,000 ÷ 78,000
= 0.5
最小值變 0、最大值變 1、正中間變 0.5。
做法 2:Z 分數標準化(Z-score,也就是第 8 篇提過的標準化),換算成「跟平均差幾個標準差」:
Z 分數 = (原始值 − 平均) ÷ 標準差

氣溫平均 25 度、標準差 5 度:
35 度 → (35 − 25) ÷ 5 = +2.0(比平均熱 2 個標準差)
20 度 → (20 − 25) ÷ 5 = −1.0(比平均冷 1 個標準差)標準差白話說就是「數字通常離平均多遠」。標準差 5 度,代表大部分的日子落在平均上下 5 度左右。
做法 3:對數縮放(Log Scaling),把差很多倍的數字拉近:
分店的網路評論數:10、100、1,000、10,000 則
取自然對數 ln 之後:2.3、4.6、6.9、9.2
原本最大和最小差 1,000 倍,取對數後只差 4 倍。適合「少數很大、大多很小」的資料,例如評論數、粉絲數、收入。
做法 4:截斷(Clipping),把極端值壓回上限:
某天公司包場,營業額 500,000 元
平常最高 80,000 元 → 設上限 80,000
500,000 → 截成 80,000
速成課程說這個方法「很奇怪,但非常有效」:極端值少見,卻會把縮放後的數字全部擠成一團。
什麼時候用哪一種
依照 Google 速成課程的整理:
| 做法 | 公式 | 適合的資料 |
|---|---|---|
| 線性縮放 | (x − 最小) ÷ (最大 − 最小) | 數值在範圍內分布平均 |
| Z 分數 | (x − 平均) ÷ 標準差 | 大多集中在平均附近(鐘形) |
| 對數縮放 | ln(x) | 一邊拖著長長的尾巴(少數極大) |
| 截斷 | 超過上限就設成上限 | 有極端離群值 |
為什麼要學
兩個重點一定要記住:
- 最小值、最大值、平均、標準差,都只能用訓練集算,再套到驗證、測試和上線資料(第 8 篇的「先切再算」)
- 訓練和上線要用同一套算法。速成課程特別提醒:訓練時縮放了,預測時也要用同樣的方式縮放,結果才準
2. 資料有缺:遺失值(Missing Values)
白話是什麼
遺失值:某一筆資料的某個欄位沒有值,在資料庫裡通常顯示成 NULL(空的)。
比喻
像問卷有幾題沒填。整份丟掉很可惜,亂猜一個答案又可能猜錯。
來龍去脈
Google 速成課程把「漏填的值」列為資料不可靠的常見原因之一,例如有人忘了填房子的屋齡。處理方式有兩大類:
- 刪掉:缺值的那幾筆不要用。資料很多、缺得很少時可以這樣做
- 補值(Imputation):用一個合理的數字補上,常見的是平均數、中位數,文字類別則補最常出現的值
速成課程還建議:補值時另外加一欄「這格是補的」,讓模型知道哪些值是真的、哪些是猜的。
算一次給你看:平均數還是中位數?
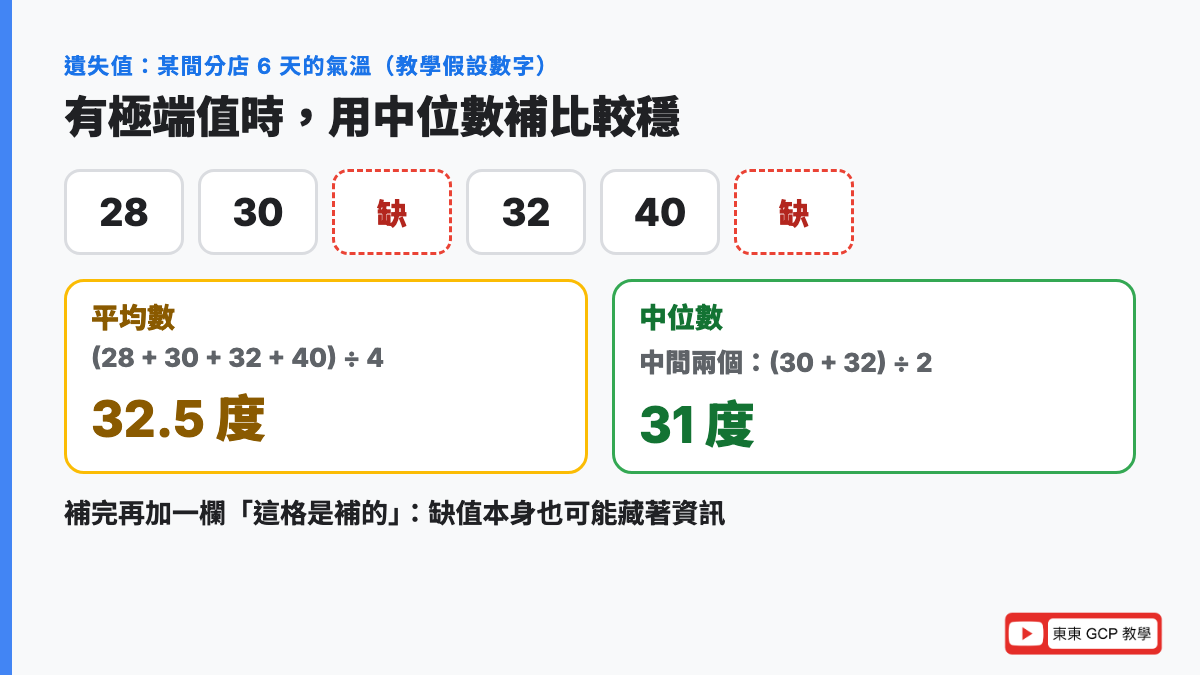
假設(教學用的數字)某間分店 6 天的氣溫,有 2 天溫度計壞了:
28、30、缺、32、40、缺用平均數補:
平均 = (28 + 30 + 32 + 40) ÷ 4 = 130 ÷ 4 = 32.5 度用中位數補(從小排到大,取正中間;有偶數個就取中間兩個的平均):
排序:28、30、32、40
中位數 = (30 + 32) ÷ 2 = 31 度
再加一欄記號:
| 天 | 氣溫(原始) | 氣溫(補值後) | 氣溫是補的 |
|---|---|---|---|
| 1 | 28 | 28 | 0 |
| 2 | 30 | 30 | 0 |
| 3 | 缺 | 31 | 1 |
| 4 | 32 | 32 | 0 |
| 5 | 40 | 40 | 0 |
| 6 | 缺 | 31 | 1 |
數字怎麼看
- 平均數 32.5 被那一天 40 度拉高了;中位數 31 比較不受極端值影響。資料有極端值時,中位數比較穩
- 「是補的」這一欄很有用:如果溫度計都在颱風天壞掉,那「缺值」本身就藏著資訊,模型可以學到
- 補值用的平均數、中位數,一樣只能用訓練集算
3. 文字類別:One-hot 編碼
白話是什麼
One-hot 編碼:一個有 N 種可能的類別,變成 N 個 0 或 1 的欄位,屬於哪一種,那一欄就是 1,其他都是 0。
比喻
像問卷的勾選題:晴、陰、雨三個框,只能勾一個。勾到的是 1,沒勾的是 0。
來龍去脈
One-hot 的意思是「只有一個是熱的(亮的)」。Google 速成課程的定義:每個類別用一串 N 個數字表示,剛好一個是 1,其他都是 0。
算一次給你看
| 天氣 | 天氣_晴 | 天氣_陰 | 天氣_雨 |
|---|---|---|---|
| 晴 | 1 | 0 | 0 |
| 陰 | 0 | 1 | 0 |
| 雨 | 0 | 0 | 1 |
為什麼不直接編成 1、2、3? 如果晴 = 1、陰 = 2、雨 = 3,模型會以為「雨是晴的 3 倍」「陰在晴和雨的正中間」。天氣沒有大小順序,用 1、2、3 會讓模型學到不存在的關係。
為什麼要學
BigQuery ML 遇到文字欄位,大部分模型會自動做 One-hot,你不用自己轉(後面會講)。但類別一多,One-hot 就會出問題,這就是下一段。
4. 類別太多:高基數類別(High Cardinality)
白話是什麼
基數(Cardinality):一個欄位有幾種不同的值。天氣只有 3 種,基數是 3;分店代碼有 2,000 種,基數是 2,000。高基數類別就是種類多到 One-hot 不好處理的類別欄位。
比喻
像問卷的勾選題有 2,000 個選項。表格會變得超大,而且大部分的框都是空的;有些選項全部問卷加起來只有一兩個人勾,根本看不出規律。
來龍去脈
速成課程舉的例子:英文單字約 50 萬個、德國的姓氏約 85 萬個。類別這麼多時,One-hot 通常是不好的選擇。分店代碼、會員編號、商品編號、郵遞區號,都是常見的高基數類別。
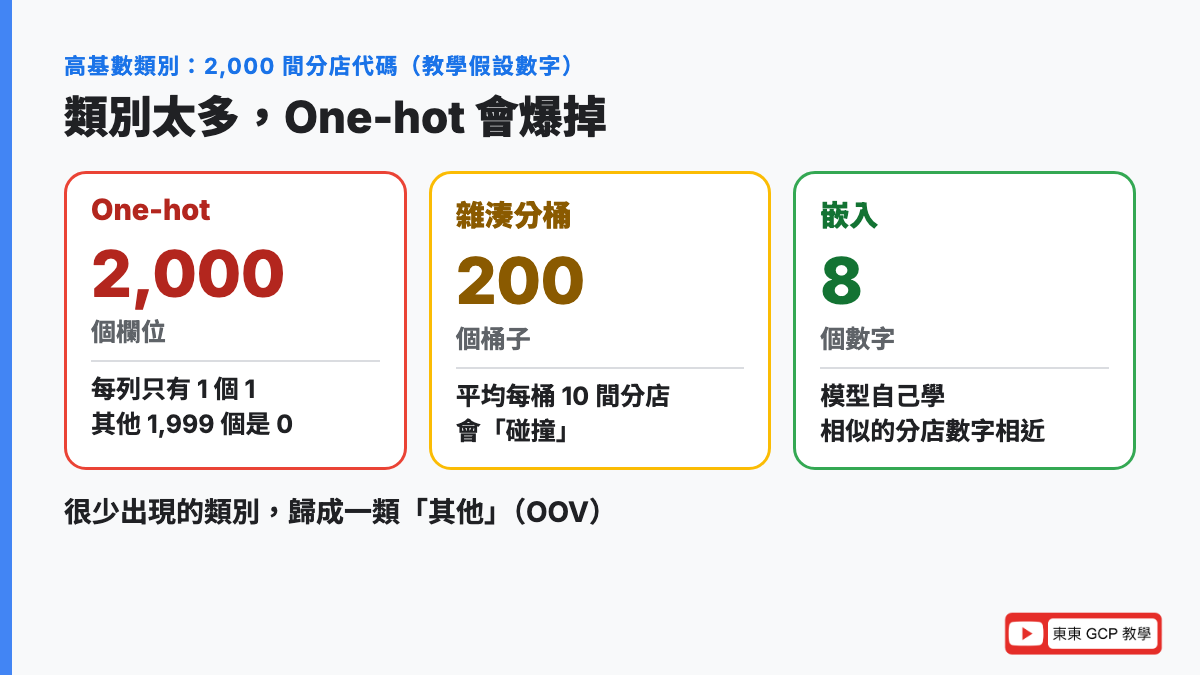
算一次給你看:三種做法要幾個欄位
| 做法 | 白話 | 欄位數 |
|---|---|---|
| One-hot | 每間分店一欄 | 2,000 欄(每列只有 1 個 1,其他 1,999 個都是 0) |
| 雜湊分桶 | 分店丟進 200 個桶子 | 200 欄 |
| 嵌入 | 每間分店用一小串數字描述 | 例如 8 個數字 |
雜湊分桶(Hash Bucketing):用一個固定的公式(雜湊函數)把每個分店代碼換成一個號碼,再除以桶子數取餘數,決定丟進哪個桶子。筆記裡的「One-Hot Hash Buckets」就是這個做法。
2,000 間分店 ÷ 200 個桶子 = 平均每桶 10 間分店- 好處:欄位從 2,000 降到 200;而且新開的分店也能算出桶號,不會沒地方放
- 代價:同一個桶子裡的 10 間分店,模型會把它們當成同一間,這叫碰撞(Collision)。桶子越多,碰撞越少,但欄位越多
嵌入(Embedding):讓模型自己學一小串數字來描述每間分店,例如 8 個數字。生意型態相似的分店,學出來的數字也會相近。速成課程說,類別很多時,嵌入通常比 One-hot 好得多,訓練比較快、預測也比較快。嵌入在第 11 篇特徵工程會細講。
另一個常用的小技巧:很少出現的類別(例如只出現幾次的分店),全部歸成一類「其他」,速成課程叫它詞彙外(Out-of-vocabulary,OOV)桶子,模型只要為它學一個權重。
為什麼要學
高基數類別處理不好,模型會變得又大又慢,還很容易對「出現很少次的類別」過度擬合(第 7 篇)。
補充:圖片資料怎麼前處理
筆記裡提到圖片資料要用 TFRecords 存在 Cloud Storage(Google 的雲端檔案儲存空間)。圖片的前處理常見的是:統一尺寸、把像素值從 0~255 縮放到 0~1。大量圖片要讀得快,會打包成 TFRecords 這種格式,第 13 篇會專門講。
五個問題一張表比完
| 問題 | 處理方法 | 一句話 | 注意 |
|---|---|---|---|
| 數字大小差很多 | 線性縮放、Z 分數 | 換算成同一種貨幣 | 統計值只用訓練集算 |
| 少數極大、大多很小 | 對數縮放 | 把差很多倍的數字拉近 | 數值要大於 0 |
| 極端值 | 截斷 | 超過上限就壓回上限 | 先確認是不是輸入錯誤 |
| 有缺值 | 刪除、補平均數/中位數、加記號 | 問卷沒填的題目 | 有極端值時用中位數 |
| 文字類別 | One-hot | 勾選題 | 不要編成 1、2、3 |
| 類別太多 | 雜湊分桶、嵌入、OOV | 2,000 個選項的勾選題 | 雜湊會碰撞 |
在 GCP 上怎麼做
GCP(Google Cloud Platform) 是 Google 的雲端服務,白話說就是租用 Google 機房裡的電腦和工具。
1. BigQuery ML:很多步驟會自動做
- BigQuery:Google 的大型資料倉庫,專門存放和分析超大量的表格資料
- BigQuery ML:讓你用 SQL(跟資料庫說話的語言)直接在 BigQuery 裡訓練模型
依照自動前處理的官方文件,你什麼都不寫,BigQuery ML 訓練時就會:
| 欄位類型 | 自動做什麼 |
|---|---|
| 數字(INT64、FLOAT64 等) | 標準化(大部分模型);提升樹、隨機森林不做 |
數字欄位的 NULL | 訓練和預測時都補平均數 |
| 文字、布林、日期等 | One-hot 編碼;提升樹、隨機森林改用標籤編碼(每種值給一個號碼) |
文字欄位的 NULL | 多開一個類別放它們;預測時遇到沒看過的新值,權重當 0 |
時間戳記 TIMESTAMP | 拆出星期幾、月份、幾點等,分別處理 |
想自己控制,就把前處理寫在 TRANSFORM 裡。下面把這篇的處理方法全部寫進去(教學用的範例):
CREATE MODEL `shop.daily_cups_prep`
TRANSFORM(
  ML.IMPUTER(temperature, 'median') OVER() AS temperature_filled,   -- 缺值補中位數
  IF(temperature IS NULL, 1, 0) AS temperature_missing,             -- 記號:這格是補的
  ML.MIN_MAX_SCALER(LEAST(yesterday_revenue, 80000)) OVER()
    AS revenue_scaled,                                              -- 截斷後縮放到 0~1
  weather,                                                          -- 文字,自動 One-hot
  CAST(ML.HASH_BUCKETIZE(store_id, 200) AS STRING) AS store_bucket, -- 2,000 間分店分 200 桶
  cups_sold)
OPTIONS(model_type='LINEAR_REG',
        input_label_cols=['cups_sold']) AS
SELECT temperature, yesterday_revenue, weather, store_id, cups_sold
FROM `shop.store_daily_train`;
逐行翻成白話:
ML.IMPUTER(temperature, 'median'):氣溫缺值補中位數(也可以選mean平均、most_frequent最常見)IF(temperature IS NULL, 1, 0):加一欄「是補的」記號LEAST(yesterday_revenue, 80000):超過 80,000 的壓回 80,000(截斷),再用ML.MIN_MAX_SCALER縮放到 0~1weather:直接放進去,BigQuery ML 自動 One-hotML.HASH_BUCKETIZE(store_id, 200):分店代碼分成 200 桶;轉成文字(CAST ... AS STRING),桶號才會被當成類別,而不是大小有意義的數字
依照官方文件,TRANSFORM 裡這類要看整欄資料才能算的函數(後面要加 OVER()),訓練時算出來的統計值,預測時會自動沿用。所以上線預測時,氣溫缺值一樣補訓練期間的中位數,不會用到新資料,也不會前後不一致。訓練完還可以用 ML.TRANSFORM 看處理後的資料長什麼樣子。
2. 資料很大時,用哪個工具做前處理
PMLE 考試指南寫得很明白:要依照資料量和複雜度選前處理工具,例子有 BigQuery(SQL)、Dataflow、Apache Spark 和記憶體內的 Python 工具。
| 情況 | 工具 | 白話 |
|---|---|---|
| 資料不大,筆電放得下 | pandas 等 Python 工具 | 在一台電腦的記憶體裡處理 |
| 大量表格資料,SQL 寫得出來 | BigQuery | 直接在資料倉庫裡用 SQL 處理 |
| 大量資料,要做成批次或即時的處理管線 | Dataflow | Google 全代管的資料處理服務,可以同時處理批次和串流資料 |
| 已經有 Spark 程式 | Dataproc 上跑 Spark | Google 代管的 Hadoop/Spark 叢集,站上有一篇介紹 |
串流(Streaming)白話就是「資料一直源源不絕地進來」,例如每一筆刷卡交易;批次(Batch)是「累積一大包再一次處理」,例如每天半夜跑一次。
舊題庫可能還會看到 Vertex AI,現在叫 Gemini Enterprise Agent Platform。
Google Cloud 在 2026 年 4 月 22 日把 Vertex AI 改名(官方對照表)。前處理好的特徵要給很多模型共用時,可以放進 Feature Store on Gemini Enterprise Agent Platform(原 Vertex AI Feature Store)。
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這篇的內容對應到:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 1 區:用低程式碼方式打造 AI 方案(約 13%) | 用 BigQuery ML 做特徵工程 |
| 第 2 區:跨團隊管理資料與模型(約 16%) | 探索與前處理資料、依資料量與複雜度選前處理工具 |
| 第 5 區:自動化與協調 ML 管線(約 18%) | 確保訓練和上線的前處理一致 |
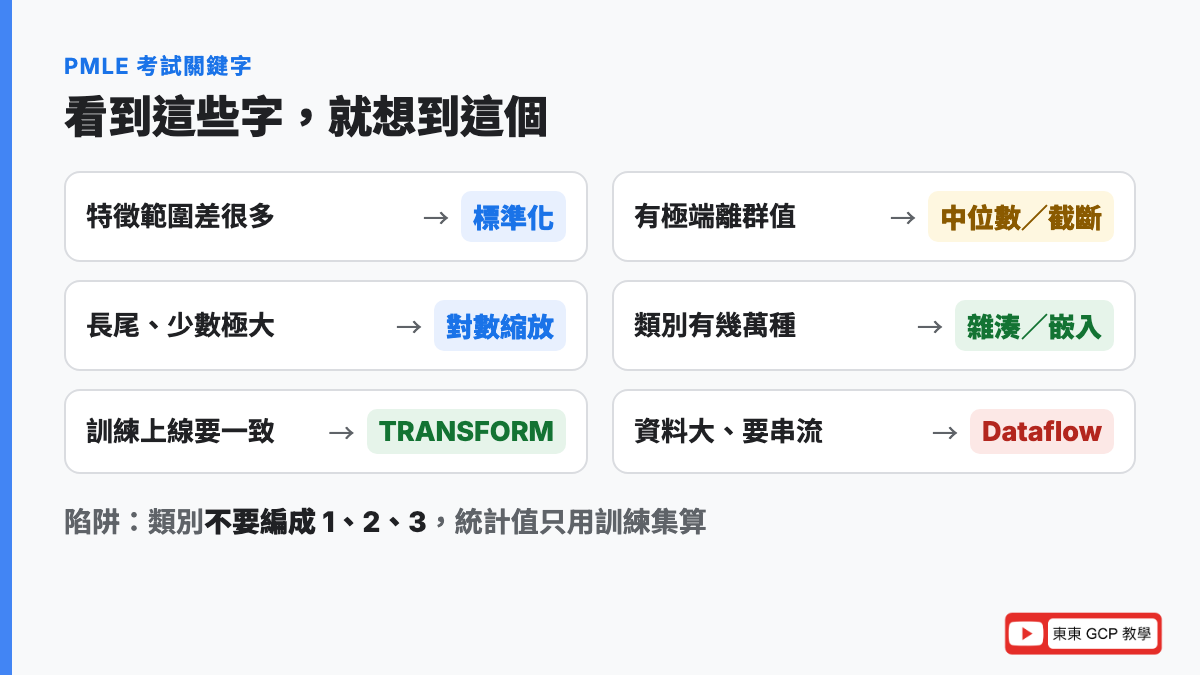
看到這些字,就想到這個
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「特徵範圍差很多」「訓練收斂很慢」 | 標準化/縮放 |
| 「少數值特別大」「長尾分布」 | 對數縮放 |
| 「有極端離群值」 | 截斷;補值改用中位數 |
| 「有缺值」 | 刪除或補值,並加一欄記號 |
| 「類別欄位轉數字」「沒有大小順序」 | One-hot,不要編成 1、2、3 |
| 「類別有幾萬、幾十萬種」 | 雜湊分桶或嵌入 |
| 「預測時出現沒看過的新類別」 | 雜湊分桶、OOV 桶子 |
| 「訓練和上線的前處理要一致」 | BigQuery ML 的 TRANSFORM |
| 「資料量很大、要串流處理」 | Dataflow |
| 「已經有 Spark 程式」 | Dataproc |
三個常見陷阱
- 用全部資料算平均再切:縮放、補值用的統計值,只能用訓練集算
- 類別編成 1、2、3:沒有順序的類別要用 One-hot,否則模型會學到不存在的大小關係
- 上線時忘了做一樣的前處理:訓練時縮放過、上線時沒縮放,模型拿到的數字完全不一樣,表現會暴跌
練習情境(自己出的練習,不是真實考題)
一家電商用 BigQuery ML 訓練模型,預測訂單會不會退貨。特徵包括商品價格(50~80,000 元)、顧客編號(約 300 萬個)、付款方式(4 種)。上線後發現,預測服務收到的價格沒有經過和訓練時一樣的縮放,結果很差。應該怎麼調整?
判斷過程:
- 「訓練和上線的前處理不一致」→ 把縮放寫進 BigQuery ML 的
TRANSFORM,訓練時的統計值預測時自動沿用 - 「顧客編號 300 萬個」→ 高基數,不要 One-hot,改用雜湊分桶(
ML.HASH_BUCKETIZE)或嵌入,或考慮這個特徵到底有沒有用 - 「付款方式 4 種」→ 文字欄位,BigQuery ML 自動 One-hot
- 「價格範圍很大」→ 標準化;如果少數商品特別貴,考慮對數縮放
常見問答
資料前處理是什麼?
資料前處理是訓練模型之前,把原始資料清乾淨、轉成數字、調整到適合大小的步驟,包括縮放數字、補遺失值、把文字類別轉成數字、處理極端值等。就像煮菜前的備料,菜洗好切好,才能一起下鍋。
標準化和正規化差在哪?
這兩個詞在不同教材裡用法不一樣。常見的說法是:線性縮放(Min-Max)把數字換算到 0~1,Z 分數標準化把數字換算成「跟平均差幾個標準差」。Google 速成課程把這些統稱為 normalization,並依資料分布建議用哪一種。
什麼時候要做特徵縮放?
當不同特徵的數字範圍差很多時,例如營業額幾萬、氣溫幾十。縮放可以讓模型訓練收斂得比較快,也避免模型偏向數字大的特徵。BigQuery ML 大部分模型會自動標準化數字欄位,但提升樹和隨機森林不做,因為樹狀模型不受數字大小影響。
遺失值要刪掉還是補值?
資料很多、缺得很少,可以直接刪;缺得多就要補值。數字常用平均數或中位數補,有極端值時中位數比較穩;文字類別補最常出現的值。Google 速成課程建議補值後另外加一欄記號,讓模型知道哪些值是補的。
One-hot 編碼是什麼?為什麼不能直接編成 1、2、3?
One-hot 編碼把一個有 N 種值的類別,變成 N 個 0 或 1 的欄位,屬於哪一種那一欄就是 1。如果直接編成 1、2、3,模型會以為類別之間有大小和倍數關係,例如「雨是晴的 3 倍」,學到不存在的規律。
高基數類別是什麼?要怎麼處理?
高基數類別是種類非常多的類別欄位,例如會員編號、商品編號、郵遞區號。用 One-hot 會產生幾千、幾萬個欄位。常見處理方法是雜湊分桶(把類別丟進固定數量的桶子)、嵌入(讓模型學一小串數字描述每個類別),以及把很少出現的類別歸成一類「其他」。
雜湊分桶有什麼缺點?
不同的類別可能被分到同一個桶子,這叫碰撞,模型會把它們當成同一個類別。例如 2,000 間分店分成 200 個桶子,平均每個桶子有 10 間分店。桶子越多碰撞越少,但欄位也越多,要在兩者之間取捨。
BigQuery ML 會自動做哪些前處理?
依照官方文件,大部分模型會自動標準化數字欄位、數字缺值補平均數、文字等欄位做 One-hot 編碼、文字缺值另開一類,時間戳記拆成星期幾、月份等。想自己控制可以寫在 TRANSFORM 裡,例如 ML.IMPUTER、ML.MIN_MAX_SCALER、ML.HASH_BUCKETIZE,訓練時算出的統計值預測時會自動沿用。
重點整理
- 縮放:數字範圍差很多時,用線性縮放(0~1)或 Z 分數;長尾用對數、極端值用截斷;統計值只用訓練集算
- 遺失值:刪除或補值;有極端值用中位數;補完加一欄記號
- One-hot:沒有順序的類別變成多個 0/1 欄位,不要編成 1、2、3
- 高基數類別:One-hot 太大,用雜湊分桶(會碰撞)、嵌入或 OOV 桶子
- BigQuery ML 自動標準化、補平均、One-hot;自己控制寫進
TRANSFORM,訓練和上線自動一致;資料很大選 BigQuery、Dataflow 或 Dataproc
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 第 3 篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切
- 第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
- 第 6 篇:ROC 曲線和 AUC 怎麼看?門檻怎麼調、AUC-PR 差在哪
- 第 7 篇:過度擬合是什麼?正則化、Dropout、提前停止 3 招解決
- 第 8 篇:資料洩漏是什麼?模型考試作弊的 3 種常見情況
- 上一篇:第 9 篇:類別不平衡怎麼辦?過取樣、欠取樣與 Upweighting
- 下一篇:第 11 篇:特徵工程入門:特徵交叉、詞嵌入、資料增強(撰寫中)
站上相關文章
- BigQuery 不就是查詢嗎?跟資料庫差在哪裡?能做什麼分析?
- Dataproc 是什麼?架構與用法介紹
- GCP Data Engineer 證照怎麼準備
- GCP 學習路徑 Learning Roadmap 和八大關卡
資料前處理沒有一個步驟是炫技的,但每一步都決定模型拿到的是「乾淨的食材」還是「沒洗的菜」。下一篇的特徵工程,會在這個基礎上,教你怎麼把資料變得更有用。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。