過度擬合是什麼?就是模型把訓練資料背得太熟,練習題考滿分、遇到新資料就失準,常用正則化、Dropout、提前停止解決。
這篇繼續用手搖飲料店的銷售紀錄當例子,先教你怎麼一眼看出模型在「死背」,再把 3 個解法一個一個算給你看:正則化怎麼扣分、Dropout 怎麼隨機關掉神經元、提前停止要停在第幾輪。
為什麼你需要知道
- 訓練分數越高,不代表模型越好:一個在練習資料上幾乎零誤差的模型,上線後可能錯得一塌糊塗。不懂過度擬合,你會把最會死背的模型當成最好的
- 這是機器學習最常見的問題:Google 機器學習速成課程特別提醒,過度擬合是實務上天天遇到的事,不是課本裡的假設
- 解法很多,方向卻常常搞反:模型死背時,有人反而加更多層、訓練更久,越修越糟
- 證照必考:PMLE 考題很愛描述「訓練準確率 99%、驗證只有 75%」,問你下一步該做什麼
先複習:我們的飲料店資料
第 3 篇〈特徵、標籤、超參數是什麼?〉和第 4 篇〈訓練集、驗證集、測試集怎麼切?〉用的例子是這樣的:
- 店長有 1,000 天的銷售紀錄(教學用的假設數字)
- 每天記錄氣溫、是不是假日(特徵),以及賣出幾杯(標籤,也就是要預測的答案)
- 照時間切成 800 天訓練集、100 天驗證集、100 天測試集
這篇的重點,就是比較模型在訓練集(練習題)和驗證集(模擬考)上的表現差多少。
過度擬合(Overfitting):練習題滿分,考試不及格
白話是什麼
過度擬合:模型把訓練資料背得太熟,連裡面的雜訊和巧合都當成規律記下來,所以遇到沒看過的新資料就失準。
比喻
就像只背考古題答案的學生。考古題每一題都答得出來,但正式考試題目換個數字,他就不會了,因為他背的是「答案」,不是「觀念」。
Google 速成課程的比喻是:過度擬合的模型,像一個在實驗室表現很好、拿到真實世界卻毫無用處的發明。
來龍去脈
擬合(fit)原本是「合身」的意思,像量身訂做衣服。模型訓練就是讓一條規則去「貼合」資料。
衣服做得合身是好事,但如果做得跟你今天的姿勢一模一樣,連手肘彎的角度都照抄,明天你換個姿勢就穿不下了。這就是「過度」擬合:貼得太緊,貼到只適合這一批資料。
依照 Google 速成課程,過度擬合的原因大致有兩個:
- 訓練資料不夠有代表性:跟真實世界的資料長得不一樣
- 模型太複雜:複雜到有能力把每一筆資料都背下來
為什麼要學
模型上線後面對的永遠是「沒看過的資料」。能不能在新資料上表現好,叫做泛化能力(Generalization),這才是模型真正的價值。過度擬合,就是泛化能力的頭號敵人。
欠擬合(Underfitting):連練習題都考不好
白話是什麼
欠擬合:模型太簡單,連訓練資料裡的規律都沒學到,練習題和考試都考不好。
比喻
像一個學生只讀了目錄就去考試,什麼題目都只會回答「看情況」。
來龍去脈
「欠」就是不夠。依照 Google 機器學習詞彙表,常見原因有:特徵選錯、訓練輪數太少或學習率太低、正則化太強、神經網路層數太少。
注意「正則化太強」這一項:等一下要介紹的解法用過頭,就會從過度擬合掉到欠擬合。
為什麼要學
過度擬合和欠擬合的解法方向剛好相反。先判斷是哪一種,才不會越修越糟。
算一次給你看:三個模型,一眼看出誰在死背
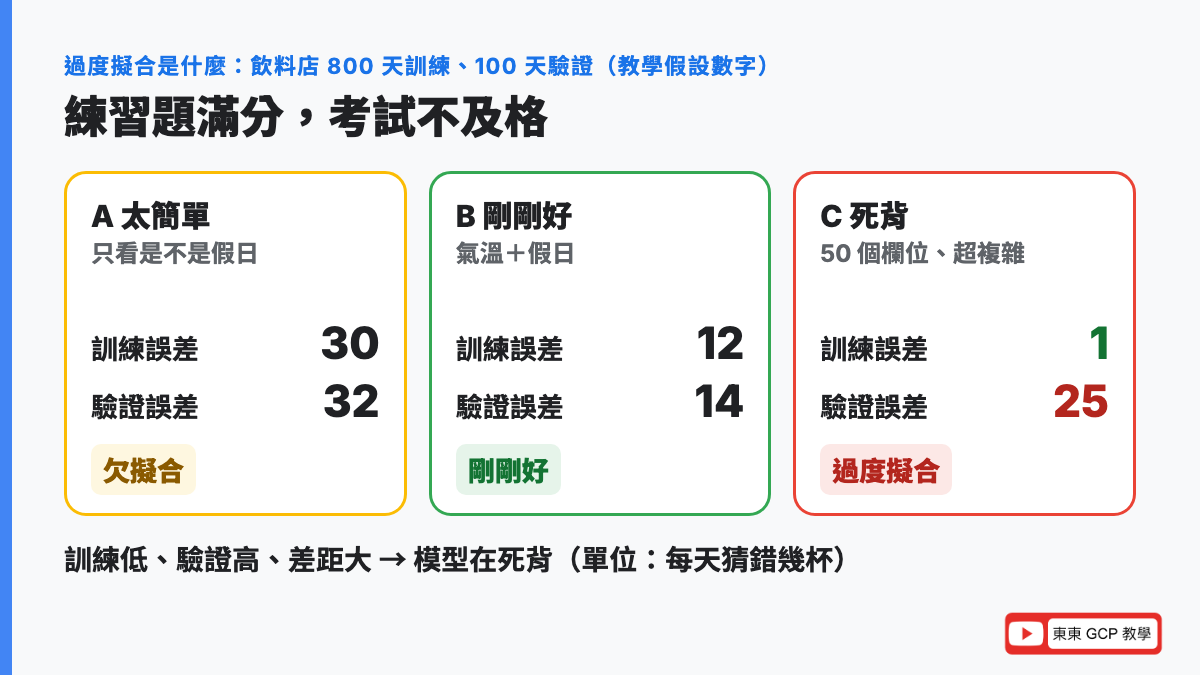
假設(教學用的數字)店長請三個人各做一個模型,都用同樣 800 天訓練、100 天驗證。誤差的意思是「平均每天猜錯幾杯」,越小越好:
| 模型 | 用了什麼 | 訓練誤差 | 驗證誤差 | 差距 | 診斷 |
|---|---|---|---|---|---|
| A 太簡單 | 只看是不是假日 | 30 杯 | 32 杯 | 2 杯 | ❌ 欠擬合 |
| B 剛剛好 | 氣溫+假日 | 12 杯 | 14 杯 | 2 杯 | ✅ 剛好 |
| C 死背 | 50 個欄位(包括哪個店員上班、隔壁有沒有施工)、非常複雜的模型 | 1 杯 | 25 杯 | 24 杯 | ❌ 過度擬合 |
數字怎麼看
- 只看訓練誤差:C 只差 1 杯,看起來最強
- 看驗證誤差:C 差 25 杯,比 B 的 14 杯爛很多
- 看兩者的差距:C 差了 24 杯,這就是過度擬合最明顯的訊號
判斷口訣:
| 訓練誤差 | 驗證誤差 | 診斷 |
|---|---|---|
| 高 | 高(差不多) | 欠擬合:模型太簡單 |
| 低 | 低(差不多) | 剛剛好 |
| 低 | 高(差很多) | 過度擬合:模型在死背 |
C 為什麼會這樣?因為它記住了「上個月 15 號小美上班、隔壁施工,那天賣了 83 杯」這種巧合。這些巧合在訓練資料裡剛好成立,但明天不會再發生。
用曲線抓出過度擬合
白話是什麼
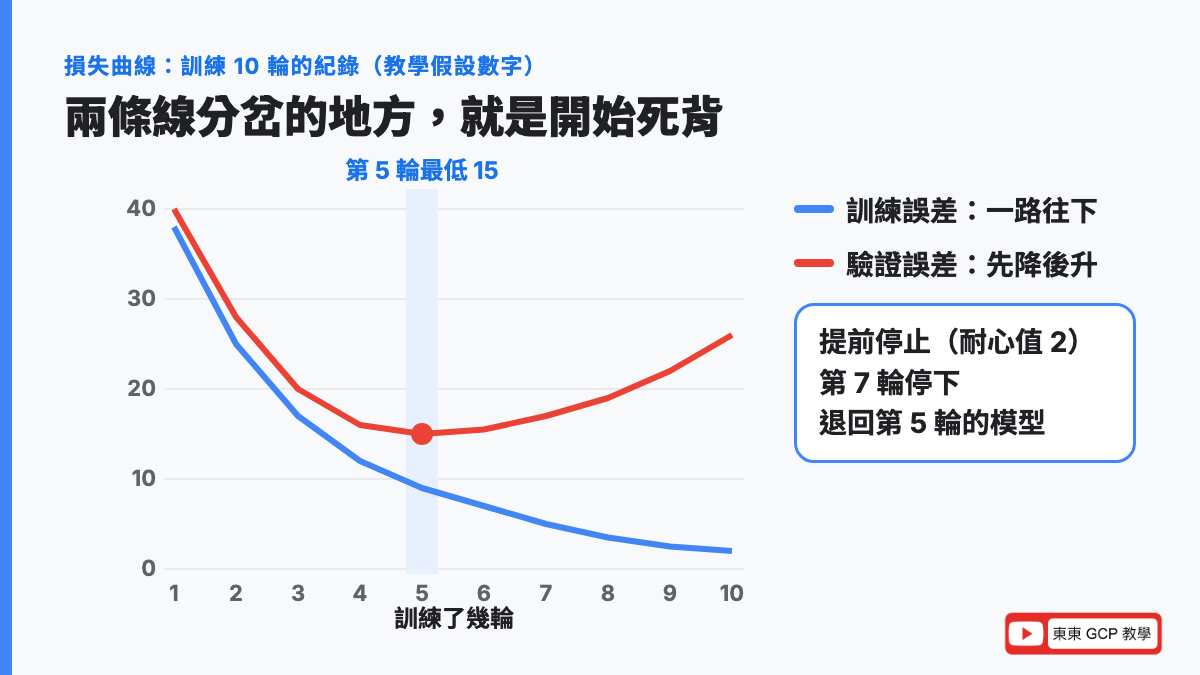
損失曲線(Loss Curve):橫軸是訓練了幾輪,縱軸是誤差(損失)。訓練集一條、驗證集一條,兩條畫在一起,Google 速成課程叫它泛化曲線(Generalization Curve)。
訓練輪數(Epoch):整份訓練資料從頭到尾看完一遍,叫做一輪。第 3 篇介紹超參數時講過。
算一次給你看:訓練 10 輪的紀錄
假設(教學用的數字)用一個比較複雜的模型訓練 10 輪,每一輪結束都記錄兩個誤差:
| 第幾輪 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| 訓練誤差 | 38 | 25 | 17 | 12 | 9 | 7 | 5 | 3.5 | 2.5 | 2 |
| 驗證誤差 | 40 | 28 | 20 | 16 | 15 | 15.5 | 17 | 19 | 22 | 26 |
數字怎麼看
- 第 1~5 輪:兩條一起往下降,模型在學「真正的規律」
- 第 5 輪:驗證誤差最低,只差 15 杯
- 第 6 輪以後:訓練誤差繼續降到 2,驗證誤差卻一路往上爬到 26。模型開始背巧合了
Google 速成課程的說法是:兩條線一開始走勢相似,之後分岔,訓練的繼續下降,驗證的開始上升,就是過度擬合的訊號。
解法 1:正則化(Regularization),對「太複雜」額外扣分
白話是什麼
正則化:訓練時除了看猜錯多少,再對「模型太複雜」額外扣分,逼模型選比較簡單的規則。
比喻
像老師規定:寫作文超過 800 字,每多 100 字扣 1 分。學生就不會把所有想到的東西全塞進去,只留最重要的論點。
來龍去脈
Regular 是「規則、規律」的意思,正則化就是讓模型變得比較有規律、比較單純。
這個想法可以追溯到 14 世紀的一位修士奧坎(William of Occam)提出的奧坎剃刀(Occam’s razor):能用簡單的解釋,就不要用複雜的。Google 速成課程也引用這個原則:簡單的模型,在新資料上通常表現比較好。
模型的「複雜」,用權重來衡量。第 3 篇講過,權重(Weight)就是模型對每個特徵的「重視程度」,是模型自己學出來的參數。權重越大,代表模型越依賴那個特徵。
公式
依照 Google 速成課程,訓練的目標從「讓誤差最小」,變成:
讓(誤差 + λ × 複雜度)最小

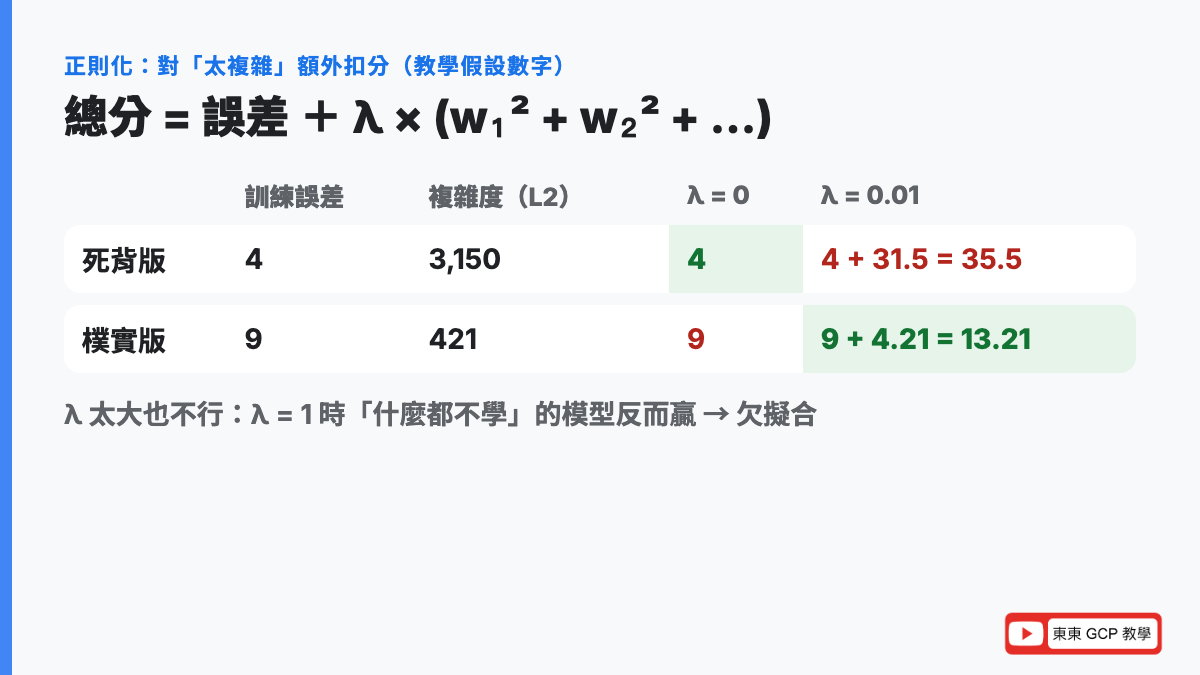
L2 正則化的複雜度 = w₁² + w₂² + … + wₙ²(每個權重平方後加起來)- w 是權重,λ(希臘字母 lambda,念「藍達」)是正則化強度,也叫正則化率
- λ 是超參數,要你自己設定(第 3 篇講過,超參數是訓練前人設定的旋鈕)
算一次給你看
假設(教學用的數字)訓練完有兩個候選模型,都用 4 個特徵:
| 特徵 | 死背版的權重 | 樸實版的權重 |
|---|---|---|
| 氣溫 | 5.0 | 4.0 |
| 是不是假日 | 30 | 20 |
| 隔壁有沒有施工 | −40 | −2 |
| 小美有沒有上班 | 25 | 1 |
| 訓練誤差 | 4 | 9 |
死背版很重視「隔壁施工」和「小美上班」這種巧合,訓練誤差比較低。
先算兩個模型的複雜度(L2):
死背版 = 5² + 30² + (−40)² + 25² = 25 + 900 + 1,600 + 625 = 3,150
樸實版 = 4² + 20² + (−2)² + 1²   = 16 + 400 + 4 + 1       = 421
再用不同的 λ 算總分(越低越好):
| λ | 死背版:4 + λ × 3,150 | 樸實版:9 + λ × 421 | 會選誰 |
|---|---|---|---|
| 0(不正則化) | 4 | 9 | 死背版 ❌ |
| 0.01 | 4 + 31.5 = 35.5 | 9 + 4.21 = 13.21 | 樸實版 ✅ |
數字怎麼看
- λ = 0:只看訓練誤差,死背版贏,模型會過度擬合
- λ = 0.01:死背版的大權重被重罰(31.5 分),樸實版只被扣 4.21 分,樸實版贏
- λ 調太大也不行:假設 λ = 1,死背版 3,154、樸實版 430。這時一個「所有權重都是 0、每天都猜平均值」的模型,訓練誤差 100、複雜度 0,總分只有 100,反而贏了。模型什麼都不學,就變成欠擬合
Google 速成課程的整理:λ 高,正則化強,過度擬合的機會降低;λ 低,過度擬合的機會升高。λ 要靠驗證集一個一個試(第 3 篇講的超參數調整)。
L1 和 L2 差在哪
L2 是把權重平方加起來;L1 是把權重的絕對值(去掉負號)加起來:
樸實版的 L1 複雜度 = |4| + |20| + |−2| + |1| = 4 + 20 + 2 + 1 = 27兩者的差別在「怎麼對待小權重」:
- L2:權重 20 平方是 400,權重 1 平方只有 1。L2 主要在壓大權重,小權重幾乎不管,所以權重會變小,但不會剛好變成 0
- L1:每一單位的權重扣一樣多。依照 Google 機器學習詞彙表,L1 會把不重要的特徵權重壓到剛好 0,等於自動把那個特徵刪掉
| L1 正則化 | L2 正則化 | |
|---|---|---|
| 複雜度怎麼算 | 權重絕對值加總 | 權重平方加總 |
| 樸實版算出來 | 27 | 421 |
| 效果 | 沒用的特徵權重變成 0(自動挑特徵) | 大權重被壓小,但不會變 0 |
| 常見別名 | Lasso 迴歸 | Ridge 迴歸 |
| 什麼時候用 | 特徵很多,懷疑很多是雜訊 | 特徵都有點用,只是不想讓某幾個太霸道 |
| BigQuery ML 參數 | L1_REG | L2_REG |
為什麼要學
正則化幾乎是每個模型都有的設定。不設的話,在 BigQuery ML 裡,線性模型的 L1_REG、L2_REG 預設都是 0,也就是完全不正則化。
解法 2:Dropout,訓練時隨機關掉一些神經元
白話是什麼
先認識兩個名詞:
- 神經網路(Neural Network):一層一層排起來的小計算單元,前一層的輸出傳給下一層,最後算出答案。深度學習用的就是它
- 神經元(Neuron):神經網路裡的每一個小計算單元
Dropout:訓練的每一步,隨機讓一部分神經元暫時不工作,逼剩下的神經元自己學會把事情做好。
比喻
像籃球隊練習時,每次隨機讓 2 個人坐板凳。球隊就不能永遠只靠某一個明星球員,每個人都得會傳球、會防守。到了正式比賽,全員上場,整隊的實力反而更平均、更穩。
來龍去脈
Drop out 是「退出、中途離開」的意思。這個方法出自 2014 年一篇論文〈Dropout: A Simple Way to Prevent Neural Networks from Overfitting〉,標題就寫明了它是為了解決過度擬合。
依照 Google 機器學習詞彙表:Dropout 是一種用在神經網路的正則化,每次訓練步驟隨機拿掉一層裡固定比例的神經元,拿掉越多,正則化越強。它的效果,類似同時訓練了一大群比較小的網路再綜合起來。
算一次給你看
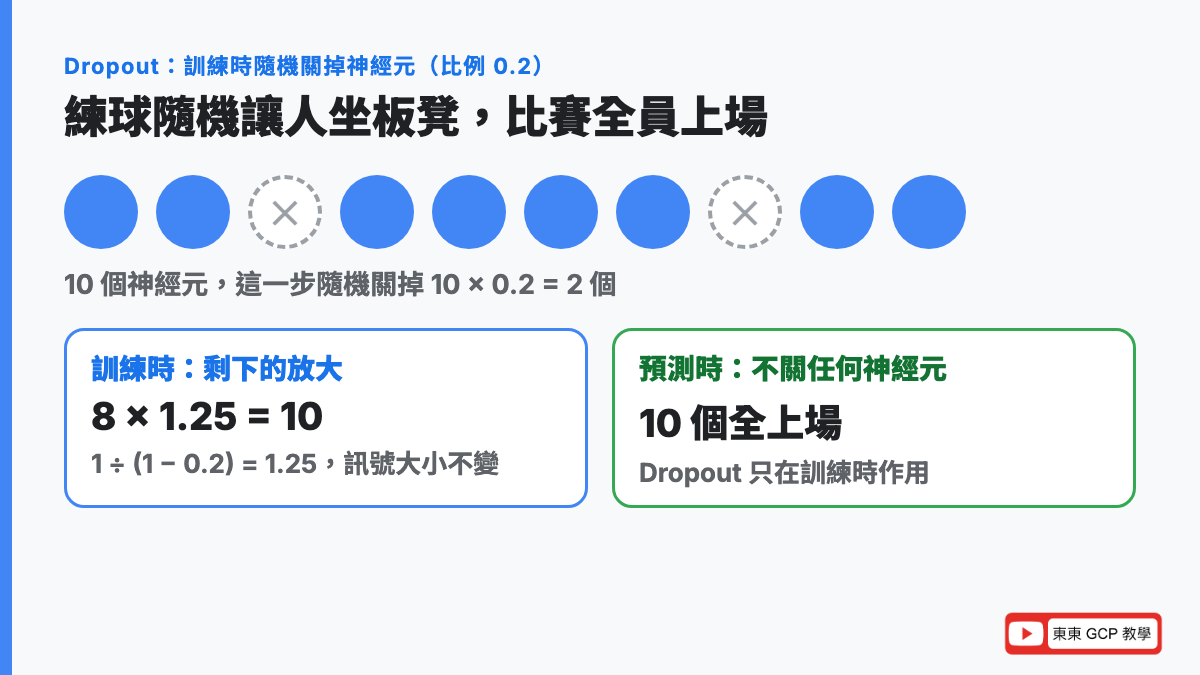
假設某一層有 10 個神經元,每個都輸出 1,加起來是 10。設定 Dropout 比例 0.2(20%):
每一步大約關掉:10 × 0.2 = 2 個
剩下工作的:10 − 2 = 8 個
少了 2 個,總和會從 10 掉到 8,下一層收到的訊號就變弱了。所以常見的做法(例如 Keras 這個深度學習工具)會把剩下的輸出放大:
放大倍數 = 1 ÷ (1 − 0.2) = 1 ÷ 0.8 = 1.25
放大後的總和 = 8 × 1.25 = 10
這樣下一層收到的訊號大小,跟沒有 Dropout 時差不多。
數字怎麼看
- Dropout 比例越大(例如 0.5):每次關掉一半,正則化越強,但太大模型會學不起來(欠擬合)
- 比例越小(例如 0.1):效果比較溫和
- 0 就是不用 Dropout。BigQuery ML 深度神經網路模型的
DROPOUT預設就是 0 - 預測時不會關掉任何神經元:Dropout 只在訓練時作用,正式上線時全員上場
為什麼要學
Dropout 只用在神經網路。考題看到「深度神經網路(DNN)過度擬合」,Dropout 幾乎一定是選項之一。
解法 3:提前停止(Early Stopping),驗證分數不進步就停
白話是什麼
提前停止:訓練過程中一直盯著驗證誤差,它不再變好,就停止訓練,不要等到模型把訓練資料完全背熟。
比喻
像煮麵。麵熟了就要撈起來,你不會因為「再煮久一點,麵會更軟」就一直煮下去,煮過頭就爛了。
來龍去脈
模型訓練越久,訓練誤差幾乎一定越來越低;但前面的損失曲線已經看到,過了某一輪,驗證誤差反而會變差。提前停止就是在「變差」的那一刻踩煞車。
Google 速成課程把它歸類為正則化的一種,特色是不用計算複雜度,直接在驗證誤差開始上升時結束訓練。速成課程也提醒:提前停止快速,但很少是最好的做法,效果通常不如認真調好 λ 的正則化。
算一次給你看:耐心值設 2,會停在哪
實務上不會「驗證誤差一變差就停」,因為誤差可能只是小抖一下。常見做法是設一個耐心值(Patience):連續幾輪沒有比最好的成績更好,才停。
用前面那 10 輪的紀錄,耐心值設 2:
第 5 輪:驗證誤差 15,目前最好的成績 → 記住這一輪的模型
第 6 輪:15.5,沒比 15 好 → 沒進步 1 次
第 7 輪:17,還是沒比 15 好 → 沒進步 2 次,達到耐心值,停止
最後:退回第 5 輪的模型(驗證誤差 15)
數字怎麼看
- 原本要跑 10 輪,第 7 輪就停,省下 3 輪的時間和費用
- 最後拿到的模型驗證誤差是 15,比跑滿 10 輪的 26 好很多
- 耐心值太小(例如 0):誤差稍微抖一下就停,可能停太早
- 耐心值太大(例如 10):等於沒有提前停止
為什麼要學
提前停止是最便宜的防過度擬合方法:不用改模型、不用多算,還能省訓練時間。雲端上訓練是照時間計費的,早點停就是省錢。
3 招一張表比完
| 正則化(L1/L2) | Dropout | 提前停止 | |
|---|---|---|---|
| 白話 | 對太複雜額外扣分 | 訓練時隨機關掉神經元 | 驗證不進步就停 |
| 比喻 | 作文字數上限 | 練球隨機讓人坐板凳 | 麵熟了就撈起來 |
| 適用模型 | 幾乎所有模型 | 只用在神經網路 | 會一輪一輪訓練的模型 |
| 要調的超參數 | λ(正則化強度) | Dropout 比例 | 耐心值 |
| 用過頭會怎樣 | λ 太大 → 欠擬合 | 比例太大 → 欠擬合 | 停太早 → 欠擬合 |
| BigQuery ML 參數 | L1_REG、L2_REG | DROPOUT(DNN 模型) | EARLY_STOP、MIN_REL_PROGRESS |
其他常見的方法:
- 收集更多、更有代表性的資料:資料越多,巧合越難被當成規律
- 簡化模型、刪掉沒用的特徵:例如拿掉「哪個店員上班」
- 資料增強(Data Augmentation):把現有資料稍微變化(例如圖片翻轉),變出更多訓練資料,第 11 篇會講
在 GCP 上怎麼做
GCP(Google Cloud Platform) 是 Google 的雲端服務,白話說就是租用 Google 機房裡的電腦和工具。
1. BigQuery ML:三招都是一行設定
- BigQuery:Google 的大型資料倉庫,專門存放和分析超大量的表格資料
- BigQuery ML:讓你用 SQL(跟資料庫說話的語言)直接在 BigQuery 裡訓練模型
下面用飲料店的資料,訓練一個深度神經網路(DNN)的迴歸模型,三招一起開(教學用的範例):
CREATE MODEL `shop.daily_cups_dnn`
OPTIONS(model_type='DNN_REGRESSOR',
        input_label_cols=['cups_sold'],
        hidden_units=[32, 16],
        dropout=0.2,
        l2_reg=0.01,
        early_stop=TRUE,
        min_rel_progress=0.01,
        max_iterations=50) AS
SELECT temperature, is_holiday, cups_sold
FROM `shop.daily_sales`;
翻成白話:
hidden_units=[32, 16]:神經網路有兩層,第一層 32 個神經元、第二層 16 個dropout=0.2:每一步隨機關掉 20% 的神經元(DNN 模型官方文件:預設 0)l2_reg=0.01:L2 正則化,λ = 0.01early_stop=TRUE、min_rel_progress=0.01:每一輪的損失至少要改善 1%,否則就停止(官方預設就是開啟、1%)max_iterations=50:最多訓練 50 輪(預設 20)
看損失曲線,用 ML.TRAINING_INFO:
SELECT iteration, loss, eval_loss
FROM ML.TRAINING_INFO(MODEL `shop.daily_cups_dnn`)
ORDER BY iteration;loss:這一輪在訓練資料上的損失eval_loss:這一輪在保留下來的評估資料上的損失
把兩欄畫成兩條線,就是上面那張泛化曲線。eval_loss 一路往上爬、loss 一路往下掉,就是過度擬合。依照官方文件,如果訓練時設定 DATA_SPLIT_METHOD='NO_SPLIT'(不切資料),eval_loss 會整欄是空的,也就看不出有沒有過度擬合。
依照線性與邏輯迴歸的官方文件,幾個要注意的預設值:
| 設定 | 預設 | 白話 |
|---|---|---|
L1_REG、L2_REG | 0 | 預設不正則化 |
EARLY_STOP | TRUE | 預設有提前停止 |
MIN_REL_PROGRESS | 0.01 | 損失改善不到 1% 就停 |
MAX_ITERATIONS | 20 | 最多跑 20 輪 |
λ 和 Dropout 比例設多少才好?可以交給 BigQuery ML 的超參數調整,用 HPARAM_RANGE 或 HPARAM_CANDIDATES 讓它自動試,第 3 篇有完整範例。
2. Agent Platform 自訂訓練(原 Vertex AI Training)
如果模型是自己用 Python 寫的,可以放到 Google Cloud 的機器學習平台上訓練。這個平台名字最近改了:
舊題庫可能還會看到 Vertex AI Training,現在叫 Gemini Enterprise Agent Platform Managed Training。
Google Cloud 在 2026 年 4 月 22 日把 Vertex AI 改名為 Gemini Enterprise Agent Platform(簡稱 Agent Platform),底下功能跟著改名(官方對照表)。功能本身是延續的。
以常見的深度學習工具 Keras 為例,三招都寫在程式裡:
model = keras.Sequential([
    keras.layers.Dense(32, activation="relu",
                       kernel_regularizer=keras.regularizers.l2(0.01)),  # L2 正則化
    keras.layers.Dropout(0.2),                                           # Dropout 20%
    keras.layers.Dense(1),
])

early_stop = keras.callbacks.EarlyStopping(
    monitor="val_loss",          # 盯著驗證誤差
    patience=2,                  # 耐心值 2
    restore_best_weights=True)   # 停下來後退回最好的那一輪

model.fit(x_train, y_train,
          validation_data=(x_val, y_val),
          epochs=50, callbacks=[early_stop])
patience=2 和 restore_best_weights=True,就是前面「耐心值 2、退回第 5 輪」的算法。各參數的說明可以看 Keras 官方文件的 EarlyStopping、Dropout 與 Regularizers。
λ、Dropout 比例要試很多組時,可以用 Agent Platform 的超參數調整服務自動搜尋;訓練過程的損失曲線,可以用 TensorBoard(一個畫訓練曲線的工具)來看,第 22 篇會講。
| 舊名稱 | 現在的名稱 |
|---|---|
| Vertex AI | Gemini Enterprise Agent Platform(Agent Platform) |
| Vertex AI Training | Gemini Enterprise Agent Platform Managed Training |
| Vertex AI Experiments | Experiments on Agent Platform |
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這篇的內容對應到:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 1 區:用低程式碼方式打造 AI 方案(約 13%) | 用 BigQuery ML 建立模型 |
| 第 2 區:跨團隊管理資料與模型(約 16%) | 評估模型(看訓練與驗證的差距) |
| 第 3 區:把原型擴展成正式模型(約 21%) | 排除模型訓練失敗的問題、超參數調整 |
考題通常給你一組「訓練分數 vs 驗證分數」或一條損失曲線,問你是哪種問題、下一步該做什麼。
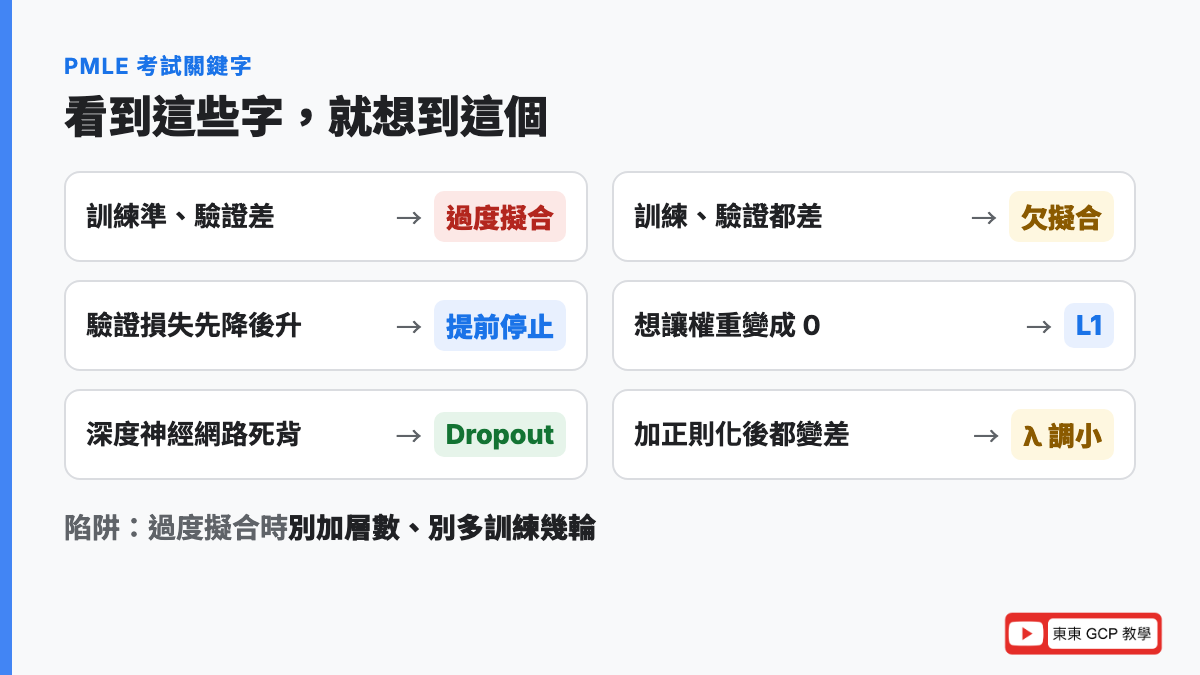
看到這些字,就想到這個
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「訓練準確率很高,驗證/測試很低」 | 過度擬合 → 正則化、Dropout、提前停止、更多資料、簡化模型 |
| 「訓練和驗證都很差」 | 欠擬合 → 更複雜的模型、加特徵、降低正則化、訓練久一點 |
| 「驗證損失先降後升」 | 提前停止 |
| 「想讓不重要特徵的權重變成 0」「特徵選擇」 | L1 正則化 |
| 「權重太大」「想整體壓小權重」 | L2 正則化 |
| 「深度神經網路過度擬合」 | Dropout |
| 「加了正則化後,訓練和驗證都變差」 | λ 太大 → 調小正則化強度 |
| 「BigQuery ML 線性模型要加正則化」 | L1_REG/L2_REG(預設 0) |
三個常見陷阱
- 過度擬合時「加層數、加神經元」:這是讓模型更複雜,方向剛好相反
- 過度擬合時「訓練更多輪」:損失曲線已經在分岔了,越訓練越糟
- 以為 Dropout 預測時也會關神經元:Dropout 只在訓練時作用,上線預測時全部神經元都會工作
練習情境(自己出的練習,不是真實考題)
一個團隊在 Agent Platform 上用自訂訓練跑深度神經網路,判斷商品圖片有沒有瑕疵。訓練 30 輪後,訓練準確率 99%,驗證準確率只有 76%;從損失曲線看,驗證損失在第 8 輪最低,之後一路上升。在不增加資料的前提下,最適合的兩個做法是什麼?
判斷過程:
- 「訓練 99%、驗證 76%」→ 差距很大,過度擬合
- 「驗證損失第 8 輪最低之後上升」→ 加上提前停止,盯
val_loss,退回最好的那一輪 - 「深度神經網路」→ 加 Dropout(或 L2 正則化)
- 錯誤選項通常是:增加層數、訓練更多輪、拿掉正則化
常見問答
過度擬合是什麼?
過度擬合是模型把訓練資料背得太熟,連雜訊和巧合都當成規律,所以訓練誤差很低,但遇到新資料誤差很高。就像只背考古題答案的學生,題目換個數字就不會了。
過度擬合和欠擬合差在哪?
過度擬合是模型太複雜、在死背:訓練表現很好、驗證表現差很多。欠擬合是模型太簡單、沒學到規律:訓練和驗證表現都不好。兩者的解法方向相反,前者要簡化或加正則化,後者要加特徵或讓模型更複雜。
怎麼判斷模型有沒有過度擬合?
比較訓練誤差和驗證誤差。訓練誤差低、驗證誤差高、兩者差距很大,就是過度擬合。也可以畫損失曲線:訓練損失持續下降,驗證損失卻開始上升,兩條線分岔的地方就是開始過度擬合的時候。
正則化是什麼?L1 和 L2 差在哪?
正則化是在訓練時對「模型太複雜」額外扣分,逼模型選簡單的規則。L2 把權重平方加總,會把大權重壓小但不會變成 0;L1 把權重絕對值加總,會把不重要特徵的權重壓到剛好 0,等於自動挑特徵。
Dropout 是什麼?預測時也會隨機關掉神經元嗎?
Dropout 是用在神經網路的正則化方法,訓練的每一步隨機讓一部分神經元暫時不工作,逼網路不要只依賴少數神經元。預測時不會關掉任何神經元,Dropout 只在訓練時作用。
提前停止要怎麼設?
常見做法是盯著驗證損失,設定一個耐心值,例如連續 2 輪沒有比最好的成績更好就停止,並退回驗證損失最低的那一輪。Keras 的 EarlyStopping 用 patience 和 restore_best_weights 設定;BigQuery ML 用 EARLY_STOP 和 MIN_REL_PROGRESS。
正則化強度 λ 要設多少?
沒有固定答案,要用驗證集試。λ 太小,正則化沒效果,還是會過度擬合;λ 太大,模型被罰到什麼都不敢學,會變成欠擬合。可以用 BigQuery ML 或 Agent Platform 的超參數調整自動搜尋。
BigQuery ML 怎麼防止過度擬合?
線性和邏輯迴歸可以設 L1_REG、L2_REG(預設都是 0),並使用 EARLY_STOP(預設開啟);深度神經網路模型還可以設 DROPOUT。訓練完用 ML.TRAINING_INFO 比較 loss 和 eval_loss,看兩條曲線有沒有分岔。
重點整理
- 過度擬合=背太熟:訓練誤差低、驗證誤差高、差距大;欠擬合=學太少:兩個都高。解法方向相反
- 正則化對太複雜扣分:L2 壓小大權重,L1 把沒用特徵的權重變 0;λ 太大會欠擬合
- Dropout 訓練時隨機關掉神經元(只用在神經網路),預測時全員上場
- 提前停止盯驗證損失,設耐心值,退回最好的那一輪;最便宜但不一定最好
- BigQuery ML:
L1_REG、L2_REG預設 0,EARLY_STOP預設開啟,DNN 有DROPOUT;用ML.TRAINING_INFO看loss和eval_loss
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 第 3 篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切
- 第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
- 上一篇:第 6 篇:ROC 曲線和 AUC 怎麼看?門檻怎麼調、AUC-PR 差在哪
- 下一篇:第 8 篇:資料洩漏是什麼?模型考試作弊的 3 種常見情況
站上相關文章
- [[AI 教學] 正則化 (Regularization):過度擬合 (Overfitting) 的解決方法](https://dongdonggcp.com/2025/08/05/ai-tutorial-regularization-the-solution-for-overfitting/)
- End-to-end Training 是什麼?
- iPAS AI 應用規劃師初級認證考試 人工智慧概論 重點整理&簡報下載
- 在 GCP 建立含 GPU 的 AI 開發環境
過度擬合看懂了,你就知道為什麼模型評估一定要看「沒看過的資料」。下一篇要講的資料洩漏,是另一種讓分數看起來很漂亮、上線卻翻車的陷阱。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。