機器學習的資料隱私怎麼保護?DLP 找出並遮掉個資、聯邦學習讓資料留在手機、VPC Service Controls 防止外洩。
前幾篇都在教你怎麼把資料整理好、加工好,讓模型學得更準。這篇要處理另一件一樣重要的事:資料裡面有「人」。
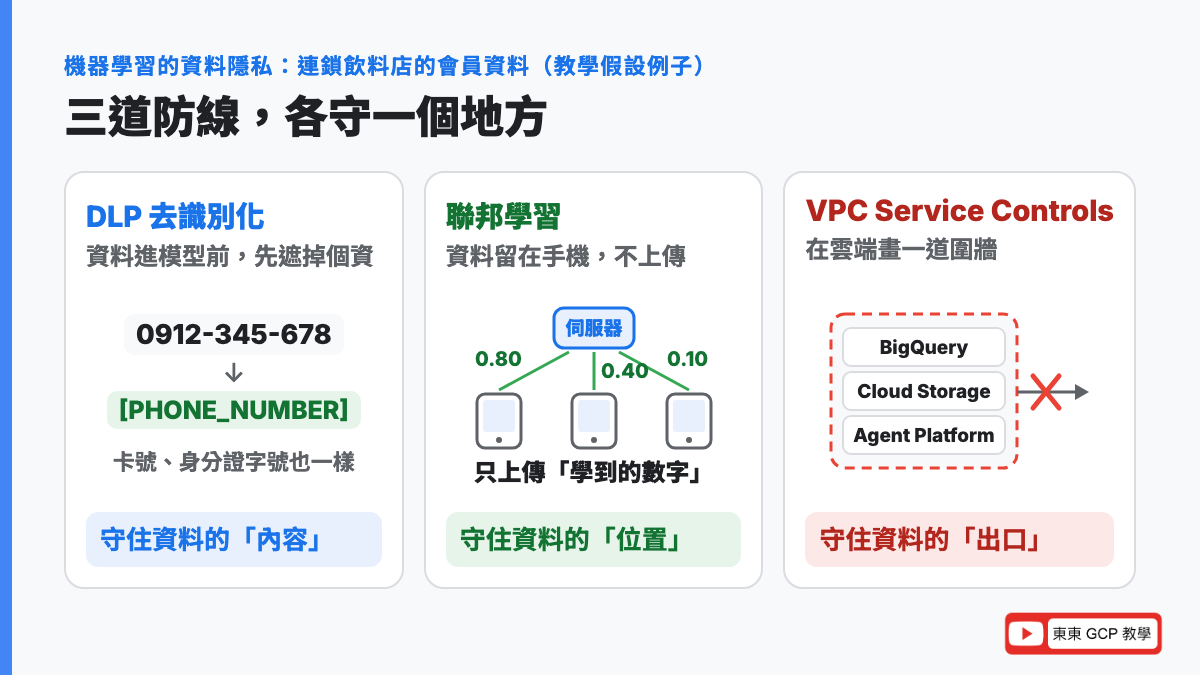
一樣用有 2,000 間分店、50 萬名會員的連鎖飲料店當例子(教學假設),一次處理三個問題:
- 會員資料要拿去訓練「誰下個月不會再來」的模型,但不想讓資料團隊看到誰是誰 → DLP 去識別化
- App 想學客人在手機上的使用習慣,但這些紀錄不想、也不該上傳 → 聯邦學習
- 資料和模型都放在雲端,要確保沒有人能把它們搬走 → VPC Service Controls
為什麼你需要知道
- 模型會「記住」資料:訓練資料裡有個資,模型可能把它記下來。Google Cloud 的聯邦學習架構文件就特別提到,要用額外的技術,確保最後的模型不會記住任何一位使用者的資料
- 生成式 AI 風險更大:聊天機器人可能在回答裡說出看過的敏感資料,客人也可能把卡號直接打進對話框,所以 Google 另外做了 Model Armor 來把關(後面會講)
- 法律有規定:台灣有《個人資料保護法》,歐盟有 GDPR。Google 的官方文件也把 GDPR、HIPAA(美國醫療資料法規)、PCI DSS(信用卡資料安全標準)列為常見的使用情境
- 證照必考:PMLE 考試指南第 2.1 節明列「確保資料隱私、處理敏感資訊(例如個資)」,第 6.1 節要你會防止「資料外洩、惡意提示詞、把敏感資料分享給大型語言模型」
先搞懂:什麼是個資?
白話是什麼
個資(個人資料):能認出「這是誰」的資料。英文常寫成 PII(Personally Identifiable Information,可識別個人的資訊)。
比喻
像包裹上的收件人標籤:姓名、電話、地址,任何人看一眼就知道這是誰的包裹。
來龍去脈
台灣《個人資料保護法》第 2 條列了一長串:姓名、出生年月日、身分證字號、指紋、聯絡方式、財務情況……最後還有一句很關鍵:「其他得以直接或間接方式識別該個人之資料」。
「間接」兩個字是重點:有些資料單獨看認不出是誰,組合起來就認得出來。
直接識別 vs 間接識別
Google 的風險分析文件把會認出人的資料分成兩種:
| 直接識別資料(Identifier) | 準識別資料(Quasi-identifier) | |
|---|---|---|
| 白話 | 一看就知道是誰 | 單獨看不知道,組合起來就知道 |
| 飲料店會員表裡 | 姓名、手機、身分證字號、Email、信用卡號 | 年齡、居住的行政區、性別 |
| 怎麼處理 | 刪掉、遮掉、換成代號 | 切粗一點(例如年齡改成年齡區間),再檢查還認不認得出來 |
美國學者 Latanya Sweeney 在 2000 年的研究估計,光靠「郵遞區號+性別+出生日期」三個欄位,就能認出約 87% 的美國人。
所以只刪掉姓名,遠遠不夠。
為什麼要學
機器學習要大量資料,而最有價值的資料(消費、醫療、金融)幾乎都跟人有關。先分清楚哪些欄位會認出人,後面三招才知道要保護什麼。
1. DLP 去識別化:資料進模型前,先把個資遮掉
白話是什麼
DLP(Data Loss Prevention,資料外洩防護)在 Google Cloud 上是一組 API:自動找出資料裡的個資,再把它去識別化(De-identification),也就是改成認不出是誰的樣子。
API 是程式跟服務溝通的窗口,像點餐櫃台:你照格式把需求遞進去,它把結果遞出來。
比喻
像新聞畫面打馬賽克:事情的經過還看得懂,只是認不出是誰。
對模型來說也一樣。「客人抱怨被重複扣款」這件事要留著讓模型學,但客人的卡號是幾號,模型根本不需要知道。
來龍去脈
DLP 原本是資安業界的說法,指防止機密資料流出公司的工具,例如擋下夾帶客戶名單的 Email。
Google Cloud 的這套服務原本就叫 Cloud DLP,2023 年起歸到 Sensitive Data Protection(敏感資料保護)這個產品底下。官方總覽現在的寫法是「Sensitive Data Protection 的 Cloud Data Loss Prevention API(DLP API)」。
舊題庫可能還會看到 Cloud DLP、DLP API,現在的產品名稱是 Sensitive Data Protection。
API 的名字沒變,還是叫 Cloud Data Loss Prevention API,網址也還是dlp.googleapis.com。看到 DLP 和 Sensitive Data Protection,指的是同一套東西。
它怎麼找到個資:infoType
DLP 用一個個「偵測器」來找個資,每一種偵測器叫一個 infoType(資訊類型)。依照官方 infoType 清單,內建的就有這些:
| infoType | 找什麼 |
|---|---|
PHONE_NUMBER | 電話號碼 |
EMAIL_ADDRESS | |
CREDIT_CARD_NUMBER | 信用卡號 |
TAIWAN_ID_NUMBER | 台灣身分證字號 |
TAIWAN_PASSPORT | 台灣護照號碼 |
找到之後,下一步就是「要怎麼遮」。
去識別化的方法,套在會員表上
官方的方法清單分成七大類。套到飲料店的會員表(教學用的資料):
| 欄位 | 原始資料 | 方法 | 處理後 | 還原得回來嗎 |
|---|---|---|---|---|
| 姓名 | 王小明 | 刪除(Redaction) | (空白) | 不能 |
| 手機 | 0912-345-678 | 遮罩(Masking) | ####-###-678 | 不能 |
| 會員編號 | M0012345 | 加密令牌化(Crypto-based tokenization) | 一串代號,例如 AWttmG… | 有金鑰才能 |
| 年齡 | 27 | 分桶(Bucketing) | 20~29 歲 | 不能 |
| 加入日期 | 2024-03-15 | 日期偏移(Date shifting) | 2024-04-02 | 不能 |
| 客服留言 | 卡號 4111 1111 1111 1111 被重複扣款 | 取代(Replacement)成類型名稱 | 卡號 [CREDIT_CARD_NUMBER] 被重複扣款 | 不能 |
第七類是時間擷取(Time extraction),例如只留下年份。
日期偏移是把日期往前或往後隨機挪幾天。同一位會員的所有日期可以設定成挪一樣多,所以「加入多久之後才第一次消費」這種間隔還在,模型照樣學得到。
最安全的做法,是模型用不到的欄位就不要給。 姓名、手機對「預測誰會流失」幾乎沒有幫助,直接刪掉就好;需要串資料、之後還要找回本人的欄位,才用令牌化。
令牌化(Tokenization):換成號碼牌
白話:把真正的值換成一個代號,代號本身看不出原本是什麼。
比喻:像衣帽間的號碼牌。你把外套交出去,拿到一張 37 號的牌子。別人撿到這張牌,也不知道外套是誰的;只有櫃台對得回去。
來龍去脈:token 原意是代幣、憑證。官方文件說,這個做法也叫假名化(Pseudonymization),像作家用筆名發表作品,讀者不知道本名。
DLP 的令牌化是用加密做的。加密就是用一把金鑰把資料鎖成亂碼,有同一把金鑰才解得開。官方建議把金鑰放在 Cloud KMS(Key Management Service,金鑰管理服務),就是 Google 雲端上專門保管金鑰的保險箱。
為什麼要學:機器學習最常遇到兩個需求,令牌化剛好都能滿足:
- 還要能串資料:會員表和訂單表都有會員編號。換成代號之後,同一個人在兩張表的代號一樣,照樣可以合併(JOIN,把兩張表依同一欄對起來)
- 之後要找回本人:模型預測「代號
AWttmG…下個月可能不會再來」,行銷要發優惠券給他,有權限的系統用金鑰還原成會員編號就好
三種令牌化,差在哪
| 確定性加密(AES-SIV) | 格式保留加密(FPE) | 加密雜湊(HMAC-SHA-256) | |
|---|---|---|---|
| 白話 | 同一個值,每次都換成同一串代號 | 加密後「長得跟原本一樣」 | 單向絞碎,變不回來 |
| 16 碼的卡號會變成 | 一串長度不同的亂碼代號 | 另一組 16 位數字 | 一串固定長度的亂碼 |
| 能還原嗎 | 能(要有金鑰) | 能(要有金鑰) | 不能 |
| 同一個值,代號一樣嗎 | 一樣 | 一樣 | 一樣 |
| 適合 | 大部分情況的首選 | 舊系統規定格式、長度不能變 | 不需要還原,只要能串資料、能計數 |
三種都會讓「同一個值換成同一個代號」,所以都能串資料。差別在能不能還原、格式會不會變。
名字怎麼來:AES(Advanced Encryption Standard,進階加密標準)是現在最常見的加密標準,SIV 這種用法讓同樣的輸入每次都得到同樣的結果,所以叫「確定性」加密。SHA-256 是常見的雜湊公式,HMAC 是「再加上一把金鑰」的做法。
加密雜湊像把水果丟進果汁機:打成汁就變不回原樣,但同樣的水果每次打出來都一樣。第 10 篇的雜湊分桶也是「固定公式換成號碼」,這裡多加了一把金鑰,別人就算知道公式,沒有金鑰也算不出同樣的結果。
筆記裡的 FPE:官方現在不建議預設就用
格式保留加密(Format-Preserving Encryption,FPE):加密之後字元種類和長度都不變。例如把一組手機號碼,換成另一組「看起來也像手機號碼」的數字。
它是為了舊系統而生的:很多舊系統規定卡號一定要是 16 位數字,換成英數字代號就會出錯。
舊題庫、舊筆記常寫「用 FPE 做令牌化」,現在官方文件特別提醒:除非一定要保留原本的字元和長度,否則不要用 FPE。
官方的方法清單說,FPE 可能跑得很慢,對字元種類和長度也有限制;確定性加密(AES-SIV)沒有這些限制,速度也快得多。假名化文件也提到,FPE 的安全保證比 AES-SIV 少。
考試的判斷很簡單:題目強調「格式、長度不能變」才選 FPE,其他要還原的情況選 AES-SIV。
去識別化之後就安全了嗎?算一次 k-匿名
白話:k-匿名(k-anonymity)是一種檢查方式:表裡每個人,至少要跟另外 k−1 個人的準識別資料一模一樣。k 越大,越難把人挑出來。
比喻:躲在人群裡。你只知道對方是「穿制服的高二男生」,全班有 20 個人符合,你認不出是哪一個;如果全校只有一個人符合,一下就被認出來了。
來龍去脈:1998 年由 Samarati 和 Sweeney 提出。官方文件說,它是為了「量化資料有多容易被認出來」,同時在隱私和資料還有沒有用之間取得平衡。
為什麼要學:去識別化不是「做了就好」,要量才知道夠不夠。Sensitive Data Protection 的風險分析(Risk analysis)可以直接幫你算 BigQuery 資料表的 k 值。
公式
k = 準識別資料完全一樣的每一組裡,人數最少的那一組有幾個人
被認出來的機率最多 = 1 ÷ k準識別資料完全一樣的一群人,官方文件叫等價類別(Equivalence class),下面簡稱「一組」。
帶數字算一次
假設(教學用的數字)會員表已經刪掉姓名、手機,只剩年齡和行政區兩個準識別資料:
| 會員 | A | B | C | D | E | F | G | H |
|---|---|---|---|---|---|---|---|---|
| 年齡 | 23 | 27 | 25 | 29 | 34 | 38 | 31 | 46 |
| 行政區 | 大安 | 大安 | 大安 | 大安 | 信義 | 信義 | 信義 | 信義 |
第 1 步:直接用原本的年齡
每個人的「年齡+行政區」都不一樣,每一組只有 1 個人:
k = 1
被認出來的機率最多 = 1 ÷ 1 = 100%
你只要知道同事「34 歲、住信義區」,就能在表裡找到他整份消費紀錄。
第 2 步:年齡每 10 歲切一段(分桶)
| 組別 | 成員 | 人數 |
|---|---|---|
| 20~29 歲、大安區 | A、B、C、D | 4 |
| 30~39 歲、信義區 | E、F、G | 3 |
| 40~49 歲、信義區 | H | 1 |
k = 最小的那一組 = min(4, 3, 1) = 1大部分人都藏好了,但 H 是全表唯一 40 幾歲的,還是一眼被認出來。
第 3 步:把 30 歲以上合成一段
| 組別 | 成員 | 人數 |
|---|---|---|
| 20~29 歲、大安區 | A、B、C、D | 4 |
| 30 歲以上、信義區 | E、F、G、H | 4 |
k = min(4, 4) = 4
被認出來的機率最多 = 1 ÷ 4 = 25%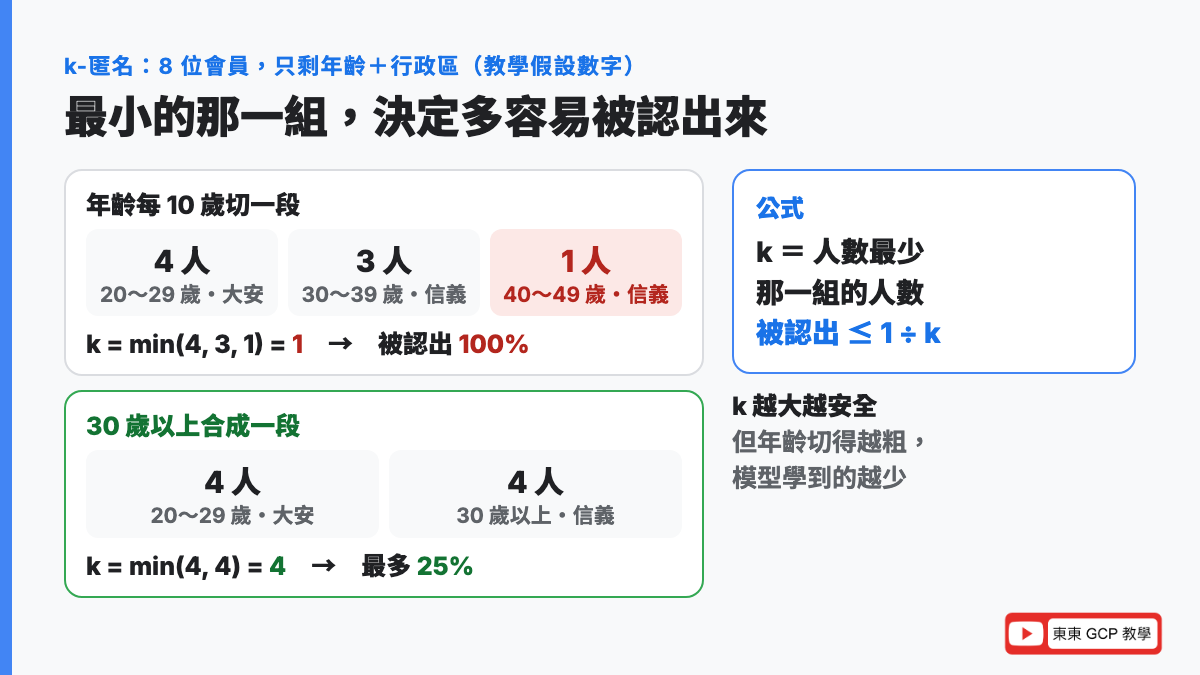
數字怎麼看
- k = 1:至少有一個人是「獨一無二」的,知道他的年齡和住哪就認得出來
- k 越大越安全:k = 4 代表就算鎖定了那一組,猜對是誰的機會最多 25%
- 但 k 越大,資料越模糊:「30 歲以上」把 31 歲和 46 歲混在一起,模型就學不到這兩個年紀的人口味不一樣。這就是隱私和模型準確度之間的取捨
- 一個人就能拉低整張表:k 看的是最小的那一組,只要有一個特別的人,k 就掉到 1。除了把區間切粗,也可以把這種很少見的資料拿掉
- 要多大才夠:沒有標準答案,要看資料多敏感,跟公司的資安、法務一起決定
k-匿名還有一個漏洞:如果同一組的 4 個人,模型全都標成「會流失」,就算認不出是誰,也知道「住信義區、30 歲以上的會員都會流失」。所以官方文件還有 l-多樣性(l-diversity),檢查同一組裡的敏感資訊夠不夠多樣。
為什麼要學
PMLE 第 2.1 節直接考「處理個資」。題目看到「PII」「信用卡號」「去識別化」,答案幾乎都是 Sensitive Data Protection,再依「要不要還原」「格式能不能變」挑方法。
2. 聯邦學習:資料不離開手機,只交出「學到的東西」
先看問題:資料一定要集中嗎?
傳統的機器學習,要把資料全部集中到一台機器或一個資料中心,再來訓練。Google 研究團隊 2017 年的文章第一段就這樣寫。
飲料店的 App 想做「猜你想點」。最有用的線索,是客人在手機上滑了哪些飲料、看了多久、最後沒點的是哪幾杯。
但要把每個人的滑動紀錄都上傳到伺服器(負責接收資料、跑程式的那台電腦),客人會不舒服,法務也會擔心。
白話是什麼
聯邦學習(Federated Learning):資料留在每個人自己的手機上,讓模型跑去資料那裡學。手機只把「學到的東西」交回來,伺服器再把大家的成果合起來,變成一個更好的共用模型。
比喻
像連鎖店的店長心得。總部想改進 SOP(標準作業流程),但不想把 2,000 間分店的帳本都收上來。
於是每位店長看完自己店的帳,寫一張「心得小抄」交給總部;總部把所有小抄整理成新版 SOP,再發回各店。帳本從頭到尾沒離開過分店。
來龍去脈
- 名字的由來:Google 研究人員在論文裡說,這種學習是由一群「鬆散結盟」(federation)的裝置一起完成,再由中央伺服器協調。就像聯邦國家,各州自己管自己,但一起組成一個國家
- 實際的例子:2017 年 Google 在 Android 的 Gboard 鍵盤上測試。手機在本機記下「跳出來的搜尋建議,你有沒有點」,再用這些紀錄改進下一版的建議模型
- 不影響手機使用:訓練只在手機閒置、正在充電、連著免費 Wi-Fi 的時候進行
- 省網路:他們提出的聯邦平均(Federated Averaging)演算法,跟直接搬用傳統做法比,網路傳輸量可以少 10~100 倍
四個步驟
- 伺服器把目前的模型發給手機
- 每支手機用自己的資料,在手機上訓練
- 手機只把「模型更新」加密傳回去
- 伺服器把大家的更新平均成新版模型,再回到第 1 步
模型更新是什麼?第 3 篇說過,模型裡有很多權重(代表每個線索有多重要的數字)。手機訓練完,這些數字會變,傳回去的就是新的數字,不是點餐紀錄本身。
算一次給你看:聯邦平均
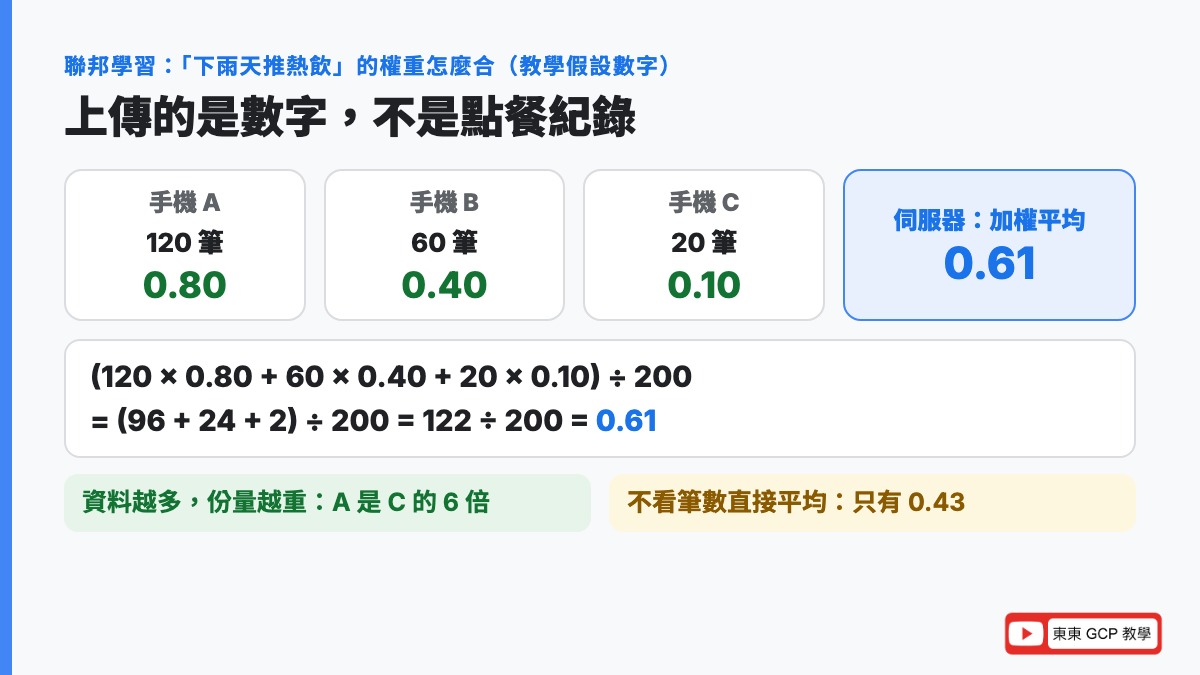
假設(教學用的數字)模型裡有一個權重,代表「下雨天推薦熱飲」這個線索有多重要。伺服器發下去的版本是 0.50,三支手機各自用自己的紀錄訓練:
| 手機 | 這支手機上的點餐紀錄 | 訓練後的權重 |
|---|---|---|
| A | 120 筆(下雨天幾乎都點熱飲) | 0.80 |
| B | 60 筆 | 0.40 |
| C | 20 筆(點飲料不太看天氣) | 0.10 |
聯邦平均會依照每支手機的資料筆數加權:
新權重 = (n₁ × w₁ + n₂ × w₂ + n₃ × w₃) ÷ (n₁ + n₂ + n₃)

n = 這支手機有幾筆資料
w = 這支手機訓練出來的權重
代入:
新權重 = (120 × 0.80 + 60 × 0.40 + 20 × 0.10) ÷ (120 + 60 + 20)
      = (96 + 24 + 2) ÷ 200
      = 122 ÷ 200
      = 0.61
如果不管筆數、直接平均:
(0.80 + 0.40 + 0.10) ÷ 3 = 1.30 ÷ 3 ≈ 0.43數字怎麼看
- 0.61 比原本的 0.50 大:整體來說,「下雨天推熱飲」這個線索變得更重要,下一版模型在下雨天會更常推熱飲
- 資料越多,份量越重:手機 A 有 120 筆,份量是手機 C 的 6 倍。只有 20 筆的手機,練出來的結果比較不穩,給它小一點的份量很合理
- 跟直接平均差很多:0.61 和 0.43 差了快 0.2。這也是 TensorFlow Federated 的函數叫
build_weighted_fed_avg(加權聯邦平均)的原因,後面會看到 - 伺服器從頭到尾只拿到 6 個數字:三個筆數、三個權重,200 筆點餐紀錄一筆都沒有上傳
- 真實的模型有幾百萬個權重,每一個都這樣平均,而且會一輪一輪重複很多次
聯邦學習也不是百分之百安全
「資料沒有上傳」不等於「什麼都沒洩漏」。模型更新多少還帶著資料的影子,所以通常會再加兩道保護:
- 安全聚合(Secure Aggregation):用加密技術,讓伺服器只解得開所有人的平均。Google 的設計是要有幾百、幾千支手機參與才解得開,看不到任何一支手機自己的更新
- 差分隱私(Differential Privacy):在結果裡加一點刻意的雜訊,讓最後的模型不會記住任何一個人的資料
差分隱私的比喻,BigQuery 官方文件講得很好懂:一家小餐廳半夜 1 點本來沒人,如果人潮統計圖上突然多出一位,大家就知道「有個客人半夜 1 點來過」。差分隱私就是讓統計結果看不出任何一個人有沒有在裡面。
兩種聯邦學習
Google Cloud 的架構文件把它分成兩種:
| 跨裝置(Cross-device) | 跨機構(Cross-silo) | |
|---|---|---|
| 參與的是誰 | 手機、車子、穿戴裝置 | 公司、醫院、銀行 |
| 數量 | 幾千到幾億 | 通常一百個以內 |
| 隨時都在線上嗎 | 只有一小部分在線上 | 幾乎都在 |
| 例子 | 語音辨識、健身紀錄、圖片分類 | 幾家銀行一起抓詐騙、幾家醫院一起做診斷模型 |
silo 是「穀倉」的意思:每家機構的資料,就像一座一座分開的穀倉,彼此不互通。
什麼時候不適合
Google 的文章也說,聯邦學習不能解決所有問題:
- 資料本來就在雲端:Google 舉的例子是 Gmail 的垃圾信過濾。換成飲料店,訂單本來就存在公司的資料庫,直接集中訓練就好,不用繞一圈
- 需要人工仔細標答案:例如辨認狗的品種,要有人一張一張標好,這種資料不會自然出現在手機上
- 工程師看不到原始資料:檢查資料品質、找錯誤都變難,網路傳輸量也是限制
為什麼要學
舊題庫的經典情境:「指紋」「臉部」「鍵盤輸入」這類資料不能離開裝置,答案就是聯邦學習。新版考試指南沒有直接點名它,但「資料不能集中時怎麼訓練」,一樣是第 2.1 節「確保資料隱私」會用到的判斷。
3. VPC Service Controls:在雲端服務外面,畫一道圍牆
先看問題:權限設好了,還不夠嗎?
在 Google Cloud 上,誰能讀哪份資料,是由 IAM(Identity and Access Management,身分與存取權管理)決定的。它像員工識別證:刷卡才進得了特定房間。
但識別證有兩種情況擋不住:
- 識別證被偷:程式用的服務帳戶(Service Account,給程式用的帳號)有一把金鑰(一個檔案,等於這個帳號的密碼)。金鑰不小心傳到網路上,駭客在自己家裡就能用它讀你的資料
- 有權限的人亂搬:資料科學家本來就能讀會員表,他把整張表複製到自己的私人專案(Project,Google Cloud 上裝資源的單位,像一本獨立的帳本),IAM 不會攔
白話是什麼
VPC Service Controls:在 Google Cloud 的服務(例如 BigQuery、Cloud Storage、Agent Platform)外面,畫一道服務邊界(Service perimeter)。邊界裡面可以自由使用,但:
- 從邊界外面來的請求,就算帶著真的金鑰,也會被擋下
- 資料不能被複製到邊界外面
比喻
像銀行金庫大樓的保全大門。識別證(IAM)決定你能進哪個房間;保全大門決定「外面的人進不進得來」「東西能不能帶出大樓」。
就算有人撿到員工識別證,人在大樓外面也刷不進來。
來龍去脈
- 名字拆開看:VPC 是 Virtual Private Cloud(虛擬私有雲),就是你在 Google Cloud 上的私人網路;Service Controls 是「對服務做管制」
- 為什麼需要它:以前資料放在公司自己的機房,外面有實體圍牆和防火牆。上雲之後,BigQuery、Cloud Storage 這些是 Google 代管的服務,大家透過網路上的 API 使用,原本那套網路圍牆管不到它們。官方文件說,很多公司從機房搬上雲時,想在雲端重現原本「以網路為界」的保護方式,VPC Service Controls 就是在做這件事
- 它是 IAM 之外獨立的一層:官方建議兩個一起用,這叫縱深防禦(Defense in depth):一層被突破,還有下一層
別跟第 8 篇搞混:資料外洩(data exfiltration)不是資料洩漏(data leakage)。
第 8 篇的資料洩漏,是答案不小心混進訓練資料,讓模型「考試作弊」、分數虛高;這篇的資料外洩,是資料被搬出公司,是資安事件。中文只差一個字,英文完全不同。
要認識的四個名詞
| 名詞 | 白話 | 金庫大樓比喻 |
|---|---|---|
| 服務邊界(Service perimeter) | 被保護的專案和服務的範圍 | 大樓的外牆 |
| 存取層級(Access level) | 放行的條件,例如「從公司的 IP 位址來」 | 訪客名單 |
| 輸入/輸出規則(Ingress/Egress rules) | 允許特定的人或資料「進來」或「出去」的例外 | 事先申請好的搬貨單 |
| 模擬測試模式(Dry run mode) | 違規的請求只記錄、不阻擋,用來先試設定 | 保全先站崗觀察一週,只記錄不攔人 |
IP 位址是網路上的門牌號碼,每台連上網路的電腦都有一個。
五個情境:哪些會被擋?
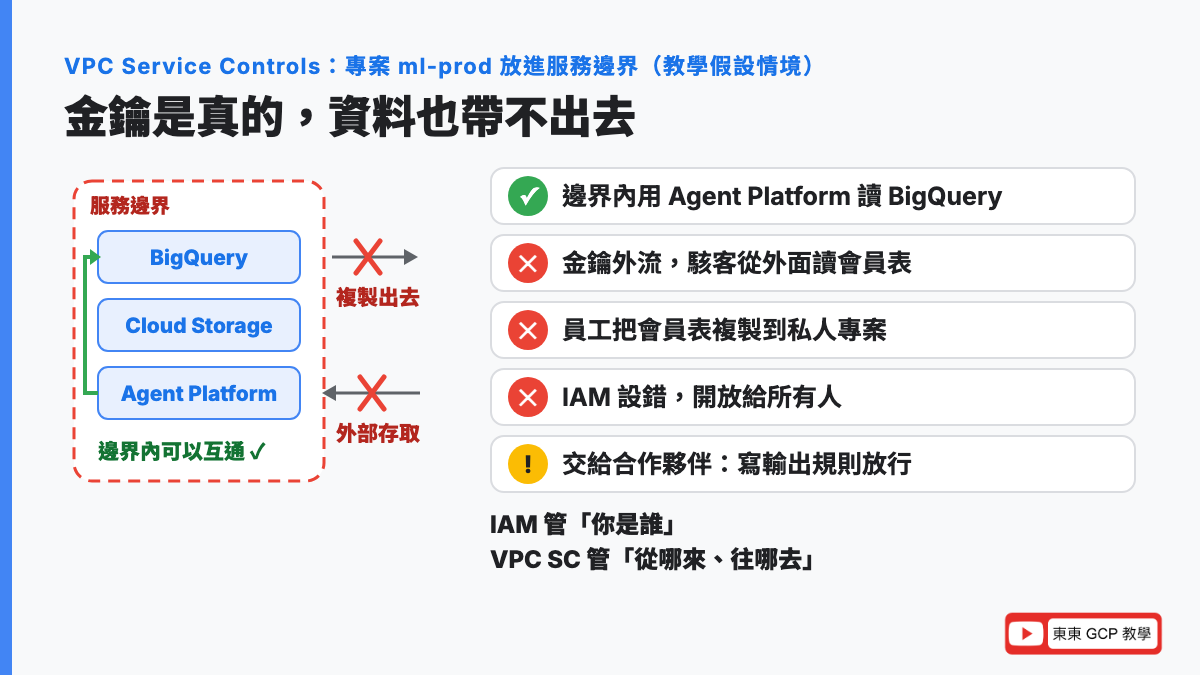
假設(教學用的情境)飲料店把會員資料(BigQuery)、訓練資料(Cloud Storage)、模型(Agent Platform)都放在專案 ml-prod,並把它放進服務邊界:
| 情境 | IAM 權限 | VPC Service Controls |
|---|---|---|
| 1. 資料科學家從公司網路,用 Agent Platform 讀 BigQuery 會員表訓練模型 | 有 | ✅ 放行 |
| 2. 服務帳戶金鑰外流,駭客從自己的電腦讀會員表 | 有(金鑰是真的) | ❌ 擋下:請求來自邊界外 |
3. 員工用 bq 指令(BigQuery 的指令列工具)把會員表複製到自己的私人專案 | 有 | ❌ 擋下:資料不能複製到邊界外 |
| 4. IAM 設錯,不小心把資料開放給所有人 | 設錯了 | ❌ 擋下:邊界外的人還是讀不到 |
| 5. 要把訓練好的模型交給合作的外送平台 | 有 | 預設擋下;寫一條輸出規則明確放行這一件 |
第 2~4 種,都是官方文件列出的風險:偷來的憑證、內部人員或被入侵的程式搬資料、IAM 設定錯誤。
跟 IAM、防火牆差在哪
| IAM | VPC Service Controls | 防火牆規則 | |
|---|---|---|---|
| 管什麼 | 你是誰、能做什麼 | 從哪裡來、資料能往哪裡去 | 網路流量能不能進出虛擬機器 |
| 保護對象 | 所有 Google Cloud 資源 | Google 代管的服務(BigQuery、Cloud Storage、Agent Platform……) | 你網路裡的虛擬機器 |
| 比喻 | 員工識別證 | 大樓保全大門 | 每間辦公室門口的門禁 |
虛擬機器(VM)是在雲端上租來的一台電腦。防火牆怎麼設,可以看站上的防火牆規則教學。
兩個限制
- 要有「組織」才能用:VPC Service Controls 的設定是掛在 Google Cloud 的組織(Organization,公司層級的最上層,底下才是資料夾和專案)底下。用個人 Gmail 開的帳號沒有組織,就沒辦法設。組織是什麼,可以看Organization Policy 那篇
- 主要管「資料」,不保證管住「中繼資料」:官方文件說,它不是設計來全面控管中繼資料(描述資料的資料,例如 Cloud Storage 值區的名稱)的移動,這部分要靠 IAM
為什麼要學
PMLE 第 6.1 節明寫要防止「資料外洩」(data exfiltration)。題目出現「防止資料被複製到專案外」「憑證外流也不能讓資料被讀走」,答案幾乎都是 VPC Service Controls。
三招一張表比完
| DLP 去識別化 | 聯邦學習 | VPC Service Controls | |
|---|---|---|---|
| 保護什麼 | 資料內容裡的個資 | 資料的位置:不集中 | 資料的出口:不外流 |
| 一句話比喻 | 打馬賽克 | 店長交心得、不交帳本 | 大樓保全大門 |
| 什麼時候用 | 訓練資料裡有個資 | 資料不能或不想集中 | 雲端上的資料、模型怕被搬走 |
| 要小心 | 準識別資料組合起來還是認得出人 | 更新也可能洩漏,要搭配安全聚合、差分隱私 | 不能取代 IAM、要有組織 |
三招不是三選一。實務上常常一起用:先用 DLP 把訓練資料遮好,再把整個專案放進服務邊界。
在 GCP 上怎麼做
GCP(Google Cloud Platform) 是 Google 的雲端服務,白話說就是租用 Google 機房裡的電腦和工具。
1. Sensitive Data Protection:先找、再遮、再量
依照官方總覽,它有四種服務:
| 服務 | 白話 | 適合 |
|---|---|---|
| 探索(Discovery) | 定期掃整個組織、資料夾或專案,產生「資料剖析」,告訴你哪些表、哪些欄位有個資 | 不知道個資藏在哪 |
| 檢查(Inspection) | 對單一資料表或值區做深度掃描,列出每一筆個資的確切位置 | 客服留言這種「偶爾夾帶個資」的文字 |
| 去識別化(De-identification) | 用前面那些方法把個資遮掉 | 訓練前的處理 |
| 風險分析(Risk analysis) | 算 BigQuery 資料表的 k 值等指標 | 確認遮得夠不夠 |
值區(Bucket)是 Cloud Storage 裡裝檔案的容器,像雲端上的一個資料夾。
放到機器學習的流程裡,順序是這樣:
- 探索:找出哪些 BigQuery 資料表有個資
- 鎖住原始資料:用 IAM 只讓少數人讀原始資料表
- 去識別化:產生一份遮好的訓練用資料
- 風險分析:算 k 值,太小就把區間切粗,或拿掉太少見的資料
- 訓練:資料團隊只用遮好的那一份,在 BigQuery ML(用 SQL 在 BigQuery 裡訓練模型)或 Agent Platform 上訓練
不想寫程式的話,BigQuery 的網頁主控台也可以直接對單一資料表發起檢查。
用 DLP API 遮掉客服留言裡的個資
依照去識別化文件的格式,先把要求寫成一個 request.json 檔(教學用的範例):
{
  "item": {
    "value": "我的手機是 0912-345-678,卡號 4111 1111 1111 1111 被重複扣款"
  },
  "inspectConfig": {
    "infoTypes": [
      {"name": "PHONE_NUMBER"},
      {"name": "CREDIT_CARD_NUMBER"},
      {"name": "TAIWAN_ID_NUMBER"}
    ]
  },
  "deidentifyConfig": {
    "infoTypeTransformations": {
      "transformations": [
        {"primitiveTransformation": {"replaceWithInfoTypeConfig": {}}}
      ]
    }
  }
}
再用一行指令送出去:
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json; charset=utf-8" \
  -d @request.json \
  "https://dlp.googleapis.com/v2/projects/PROJECT_ID/content:deidentify"
逐行翻成白話:
item.value:要檢查的文字,這裡是一則客服留言inspectConfig.infoTypes:要找哪幾種個資。官方文件提醒要明確列出來,沒寫的話會用一組預設的類型去掃,可能多花時間replaceWithInfoTypeConfig:找到的個資,換成它的類型名稱content:deidentify:DLP API 的「去識別化」功能curl:在終端機(打指令的視窗)送出網路請求的工具gcloud auth print-access-token:gcloud 是 Google Cloud 的指令列工具,這段是用你登入的身分,拿一張臨時的通行證PROJECT_ID:換成你的專案 ID
偵測到的話,回傳的文字會變成:
我的手機是 [PHONE_NUMBER],卡號 [CREDIT_CARD_NUMBER] 被重複扣款模型照樣學得到「客人留了電話、在抱怨重複扣款」,但學不到任何一個真的號碼。
2. 聯邦學習:在 GKE 上用 TensorFlow Federated
Google Cloud 架構中心有一份參考架構,教你自己搭聯邦學習平台,主要用到兩個東西:
- GKE(Google Kubernetes Engine):Google 代管的 Kubernetes(一套管理大量容器的開源系統),用來大量執行容器(把程式和它需要的環境打包在一起的小箱子)。不熟的話可以先看Kubernetes 是什麼
- TensorFlow Federated(TFF):Google 開源的聯邦學習程式工具包
跨裝置的情境,架構裡還要加上 FCP(Federated Compute Platform)的服務,負責協調每一輪由哪些手機參與。
TFF 的寫法長這樣(依照 TFF 官方範例簡化):
import tensorflow_federated as tff

# 建立「加權聯邦平均」的訓練流程
trainer = tff.learning.algorithms.build_weighted_fed_avg(
    model_fn,
    client_optimizer_fn=tff.learning.optimizers.build_sgdm(learning_rate=0.02))

state = trainer.initialize()                  # 伺服器準備第 1 版模型
for i in range(10):                           # 跑 10 輪
    result = trainer.next(state, phone_data)  # 發下去、各自訓練、加權平均
    state = result.state                      # 換成新版模型
逐行翻成白話:
build_weighted_fed_avg:weighted 是「加權」,fed_avg 是「聯邦平均」,就是前面算過的那個公式model_fn:告訴它模型長什麼樣子client_optimizer_fn:每支手機在自己身上怎麼訓練;learning_rate(學習率,第 3 篇的超參數)是每次調整權重的幅度trainer.next(...):跑一輪前面說的四個步驟phone_data:各支手機的資料。練習的時候,是用程式在一台電腦上模擬很多支手機
3. VPC Service Controls:先模擬、再上鎖
要保護機器學習的專案,邊界裡通常會放這三個服務:
| 服務名稱 | 是什麼 |
|---|---|
bigquery.googleapis.com | BigQuery |
storage.googleapis.com | Cloud Storage |
aiplatform.googleapis.com | Agent Platform(API 名稱沿用舊的 aiplatform) |
設定指令(教學用的範例,依照 gcloud 官方說明):
# 第 1 步:先用模擬測試模式建立邊界(違規只記錄、不阻擋)
gcloud access-context-manager perimeters dry-run create ml_perimeter \
  --perimeter-title="ml-perimeter" \
  --perimeter-type="regular" \
  --perimeter-resources="projects/123456789012" \
  --perimeter-restricted-services="bigquery.googleapis.com,storage.googleapis.com,aiplatform.googleapis.com" \
  --policy=POLICY_ID

# 第 2 步:看過記錄、確定不會擋到正常工作,再正式生效
gcloud access-context-manager perimeters dry-run enforce ml_perimeter \
  --policy=POLICY_ID
逐行翻成白話:
access-context-manager:Access Context Manager(存取情境管理員),管理服務邊界和存取層級的工具dry-run create:用模擬測試模式建立一道新的邊界--perimeter-resources:要放進邊界的專案。要填專案「編號」(一串數字),不是專案名稱--perimeter-restricted-services:要保護的服務,就是上面那張表--policy:組織的存取政策編號dry-run enforce:把模擬的設定轉成正式生效
依照 Agent Platform 的官方文件,放進邊界之後,這些東西都不能離開邊界:
- AutoML(自動幫你挑模型的功能)或自訂模型的訓練資料
- 你建立的模型
- 線上推論(即時一筆一筆預測)的請求、批次推論(一次預測一大批)的結果
- Gemini 模型
同一份文件也提醒:把 Agent Platform 放進邊界後,從網際網路存取(包括用網頁主控台)預設都會被擋,除非列進允許的名單。Pipelines、自訂訓練、私人端點(只在內部網路開放的預測網址)這幾個功能,還要多做網路設定。這就是為什麼一定要先模擬、再上鎖。
4. 生成式 AI 的新考點:Model Armor
Model Armor 是大型語言模型(LLM,例如 Gemini)的安檢門。依照官方文件,它在提示詞(使用者打進去的問題)送進模型前檢查一次,模型的回答送出去前再檢查一次。
它能做的事:
- 用 Sensitive Data Protection 找出並遮掉提示詞和回答裡的個資
- 擋下提示詞注入(Prompt injection,故意寫一段話騙模型不守規矩)
- 過濾仇恨、騷擾這類有害內容
飲料店的客服機器人就用得到:客人打「我的卡號是 4111…,幫我查扣款」,Model Armor 先把卡號遮掉,才交給 Gemini。
Agent Platform 改名了
舊題庫可能還會看到 Vertex AI,現在叫 Gemini Enterprise Agent Platform(簡稱 Agent Platform)。
Google Cloud 在 2026 年 4 月 22 日正式改名(官方對照表),2026 年 6 月 1 日起的 PMLE 考試指南也全面用新名稱。
| 舊名稱(舊題庫常見) | 現在的名稱 | 跟這篇的關係 |
|---|---|---|
| Cloud DLP(DLP API) | Sensitive Data Protection(API 仍叫 Cloud Data Loss Prevention API) | 找出、遮掉個資 |
| Vertex AI | Gemini Enterprise Agent Platform | 訓練、部署模型的平台,可以放進服務邊界 |
| Vertex AI Workbench | Gemini Enterprise Agent Platform Workbench | 網頁版的程式筆記本,考試指南 2.2 要你會做安全設定 |
| Vertex AI Pipelines | Gemini Enterprise Agent Platform Pipelines | 放進服務邊界要多做網路設定 |
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這篇的內容對應到:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 2 區:跨團隊管理資料與模型(約 16%) | 2.1 確保資料隱私、處理敏感資訊(例如個資);2.2 設定和使用筆記本環境時,套用協作與安全的最佳做法 |
| 第 6 區:監控 AI 方案(約 13%) | 6.1 防止資料或模型被無意間利用或外洩(例如資料外洩、惡意提示詞、把敏感資料分享給 LLM),並選用 Regex、安全過濾器、Model Armor 等工具 |
Regex(正規表示式)是用規則比對文字的方法,例如「連續 16 位數字」就可能是卡號。
2.2 的筆記本(Notebook)是在網頁上邊寫程式、邊看結果的工具,例如 Agent Platform Workbench。它也可以放進服務邊界,跟這篇的 VPC Service Controls 是同一套做法。
聯邦學習在新版指南裡沒有被點名,但在舊題庫很常見,看到「資料不能離開裝置」還是要認得出來。
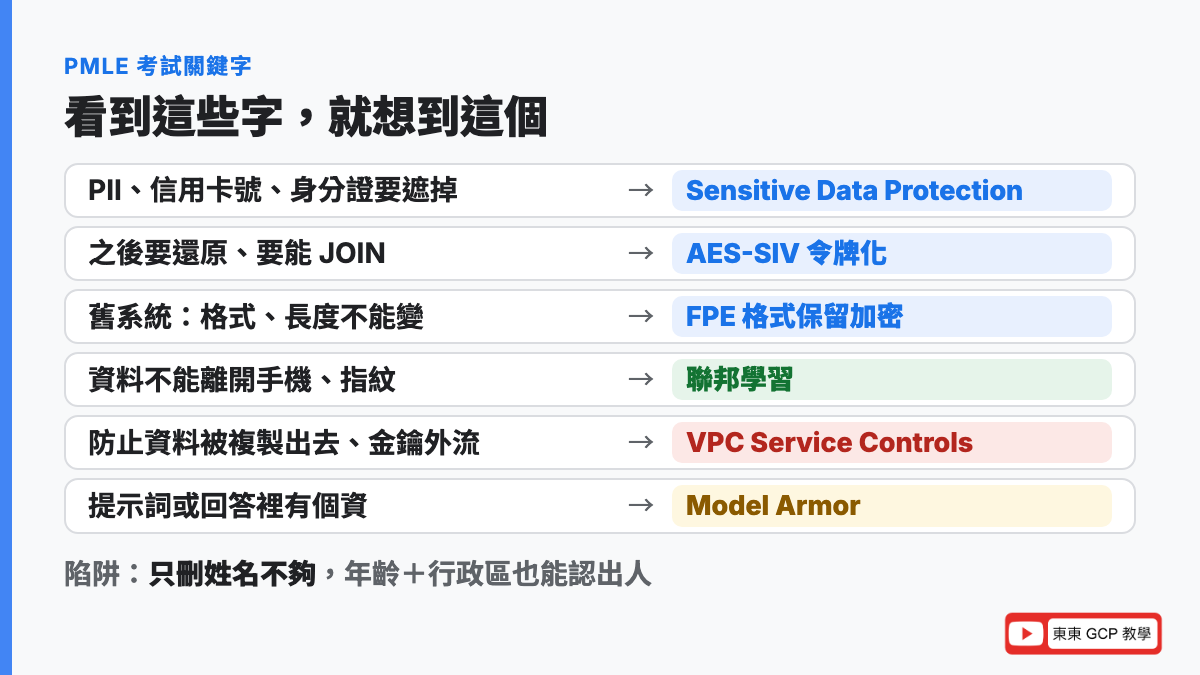
看到這些字,就想到這個
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「PII」「個資」「信用卡號」「身分證」「去識別化」 | Sensitive Data Protection(DLP API) |
| 「之後要還原」「要能 JOIN」「同一個人代號要一樣」 | 確定性加密(AES-SIV)令牌化 |
| 「舊系統」「格式、長度不能變」 | FPE(格式保留加密) |
| 「不需要還原」 | 加密雜湊,或直接刪除 |
| 「生日、郵遞區號組合起來認得出人」「重新識別風險」 | 分桶+k-匿名風險分析 |
| 「資料不能離開裝置」「指紋」「鍵盤」「醫院之間不能交換資料」 | 聯邦學習 |
| 「防止資料被複製到專案外」「金鑰外流」「data exfiltration」 | VPC Service Controls |
| 「先確認不會影響現有服務」 | VPC Service Controls 的模擬測試模式(dry run) |
| 「提示詞或回答裡有個資」「提示詞注入」 | Model Armor |
| 「誰可以讀這份資料」 | IAM(VPC Service Controls 不能取代它) |
六個常見陷阱
- 以為 IAM 設好就夠了:IAM 管「你是誰」,金鑰外流、有權限的人亂搬,要靠 VPC Service Controls 再加一層
- 只刪姓名就說去識別化完成:年齡、行政區這類準識別資料組合起來,還是認得出人,要做風險分析
- 預設就選 FPE:官方建議沒有格式需求時,用 AES-SIV
- 雜湊之後還想還原:雜湊是單向的,要還原只能選可逆的加密
- 以為聯邦學習什麼都不會洩漏:模型更新也可能透露資訊,要搭配安全聚合、差分隱私
- 把資料外洩當成資料洩漏:exfiltration 是資料被搬走(資安),leakage 是答案混進訓練資料(第 8 篇)
練習情境(自己出的練習,不是真實考題)
一家連鎖飲料店想用客服留言訓練「客訴分類」模型。留言存在 BigQuery,裡面偶爾有客人自己打的手機號碼和信用卡號。模型只需要知道客訴的類型,不需要知道是誰。應該怎麼做?
判斷過程:
- 「留言裡偶爾有個資」→ 用 Sensitive Data Protection 檢查,再去識別化
- 「不需要知道是誰」→ 不用還原,直接取代成類型名稱就好,不必用令牌化
- 原始留言表用 IAM 限制只有少數人能讀,資料團隊只拿遮好的那一份
同一家店的 App 想做「猜你想點」,最有用的是客人在手機上滑菜單的紀錄,但法務要求這些紀錄不能離開手機。App 有幾十萬名使用者,同一時間只有一部分在線上。應該怎麼做?
判斷過程:
- 「紀錄不能離開手機」→ 聯邦學習
- 「幾十萬名使用者、只有一部分在線上」→ 跨裝置聯邦學習,要有服務負責挑每一輪參與的手機(GKE+TFF+FCP)
- 再加上安全聚合或差分隱私,避免從模型更新反推回個人
資料科學團隊在 Agent Platform 上用 BigQuery 的會員表訓練模型。資安團隊擔心有人把會員表複製到公司以外的專案,也擔心服務帳戶金鑰外流。但資料團隊不希望設定一上線,工作就被突然擋住。應該怎麼做?
判斷過程:
- 「複製到公司以外」「金鑰外流」→ VPC Service Controls,把專案放進服務邊界,保護
bigquery、storage、aiplatform三個服務 - 「不希望突然被擋住」→ 先用模擬測試模式看記錄,確定沒問題再正式生效
- IAM 照樣要設好,只給每個人需要的權限
常見問答
機器學習的資料隱私要注意哪些事?
主要有三件事:訓練資料裡的個資要先找出來遮掉(DLP 去識別化);資料不能集中時,讓模型到資料那裡學(聯邦學習);雲端上的資料和模型,要防止被搬到外面(VPC Service Controls)。另外,只刪姓名不夠,年齡、行政區這類資料組合起來還是可能認出人,要做風險分析。
DLP 是什麼?跟 Sensitive Data Protection 一樣嗎?
DLP 是 Data Loss Prevention(資料外洩防護)的縮寫,在 Google Cloud 上是一組能自動找出並遮掉個資的 API。Cloud DLP 從 2023 年起歸到 Sensitive Data Protection 這個產品底下,API 名稱仍叫 Cloud Data Loss Prevention API。舊題庫寫 Cloud DLP、新文件寫 Sensitive Data Protection,指的是同一套東西。
去識別化、遮罩、令牌化、加密差在哪?
去識別化是總稱,指把資料改成認不出是誰。遮罩是把部分字元換成 # 或 * 這類符號,例如手機只留末三碼;令牌化是把真正的值換成一個代號,像衣帽間的號碼牌;加密是用金鑰把資料鎖成亂碼。DLP 的令牌化就是用加密做的,所以有金鑰的人可以還原,遮罩和刪除則還原不回來。
FPE 格式保留加密是什麼?什麼時候該用?
FPE 是加密後字元種類和長度都不變的加密方式,例如 16 位數的卡號加密後還是 16 位數字,主要是給規定格式不能變的舊系統用。官方文件提醒,除非一定要保留格式和長度,否則不要用 FPE,因為它可能很慢、限制多,安全保證也比確定性加密(AES-SIV)少。
去識別化之後就安全了嗎?k-匿名是什麼?
不一定。年齡、行政區這類準識別資料組合起來,還是可能認出人。k-匿名是一種檢查方式:準識別資料完全一樣的每一組裡,人數最少的那組有 k 個人,被認出來的機率最多就是 1 除以 k。例如 k 等於 4,最多 25%。k 越大越安全,但資料也越模糊。
聯邦學習是什麼?資料真的不會離開手機嗎?
聯邦學習是讓模型到每支手機上用本機資料訓練,手機只把模型更新(學完之後變動的數字)加密傳回伺服器,伺服器再依資料筆數加權平均成新版模型。原始資料不會上傳,但更新仍可能透露一點資訊,所以通常會搭配安全聚合和差分隱私,讓伺服器只看得到平均、模型也不會記住個人。
聯邦學習和分散式訓練差在哪?
分散式訓練是把已經集中在資料中心的資料,分給很多台機器一起算,目的是算得更快,資料都在你的掌控之下。聯邦學習的資料從頭到尾留在使用者的手機或各機構裡,目的是保護隱私,裝置數量多、網路慢、而且不一定隨時在線上,所以需要聯邦平均這類特別的演算法。
VPC Service Controls 是什麼?跟 IAM、防火牆差在哪?
VPC Service Controls 是在 BigQuery、Cloud Storage、Agent Platform 這些 Google 代管服務外面畫一道服務邊界,邊界外的請求會被擋下,資料也不能被複製到邊界外。IAM 管的是「你是誰、能做什麼」,防火牆管的是虛擬機器的網路流量,VPC Service Controls 管的是「從哪裡來、資料往哪裡去」。官方建議跟 IAM 一起用。
個人 Gmail 帳號可以用 VPC Service Controls 嗎?
不行。VPC Service Controls 的設定要掛在 Google Cloud 的組織(Organization)底下,組織是公司層級的最上層資源。用個人 Gmail 開的 Google Cloud 帳號沒有組織,所以沒辦法建立服務邊界。
資料外洩和資料洩漏一樣嗎?
不一樣。資料外洩(data exfiltration)是資料被搬出公司,是資安事件,用 VPC Service Controls 這類工具防範。資料洩漏(data leakage)是機器學習的問題,指答案不小心混進訓練資料,讓模型分數虛高。中文只差一個字,考試的英文用字完全不同。
Model Armor 是什麼?跟 DLP 有什麼關係?
Model Armor 是大型語言模型的安檢門,在提示詞送進模型前、模型回答送出去前各檢查一次。它會用 Sensitive Data Protection(也就是 DLP)找出並遮掉個資,也能擋下提示詞注入、過濾有害內容。PMLE 新版考試指南第 6.1 節有直接點名 Model Armor。
重點整理
- 個資不只姓名:準識別資料(年齡、行政區)組合起來也能認出人;台灣個資法也寫「直接或間接」識別
- DLP 去識別化:Cloud DLP 現在叫 Sensitive Data Protection;刪除、遮罩、令牌化、分桶擇一;要還原選 AES-SIV,格式不能變才用 FPE;用 k-匿名量化被認出的風險
- 聯邦學習:資料留在手機,只傳模型更新,伺服器依筆數加權平均;要再搭配安全聚合、差分隱私
- VPC Service Controls:在 Google 代管服務外畫服務邊界,擋外部存取和資料外洩;先用模擬測試模式,不能取代 IAM,要有組織才能用
- GCP 上:Vertex AI 已改名為 Gemini Enterprise Agent Platform;生成式 AI 的提示詞用 Model Armor 把關
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 第 3 篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切
- 第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
- 第 6 篇:ROC 曲線和 AUC 怎麼看?門檻怎麼調、AUC-PR 差在哪
- 第 7 篇:過度擬合是什麼?正則化、Dropout、提前停止 3 招解決
- 第 8 篇:資料洩漏是什麼?模型考試作弊的 3 種常見情況
- 第 9 篇:類別不平衡怎麼辦?過取樣、欠取樣與 Upweighting
- 第 10 篇:資料前處理怎麼做?標準化、遺失值、高基數類別
- 上一篇:第 11 篇:特徵工程是什麼?特徵交叉、詞嵌入、資料增強一次看懂
- 下一篇:第 13 篇:訓練資料讀太慢?TFRecords、tf.data 與 prefetch 加速
站上相關文章
- 雲端的資訊安全防禦縱深,常用 GCP 資安服務介紹
- 使用 GCP Service Account 開發程式的小技巧和注意事項
- GCP Organization Policy 完全攻略:Google Cloud 安全工程師必備知識
- GCP 9 大資訊安全威脅與因應方案
- Kubernetes 是什麼?白話解釋 + 判斷你是否真的需要它
- GCP 防火牆規則如何設定?5 步驟完整攻略與實戰技巧
資料整理好、加工好,也要保護好,模型才能放心上線。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。