AutoML、BigQuery ML、自訂訓練怎麼選?會 SQL 選 BigQuery ML,免寫程式選 AutoML,要完全控制才選自訂訓練。
前面 13 篇把資料整理好、也知道怎麼餵進模型了。接下來的問題是:在 Google Cloud 上,到底要用哪個服務來訓練? 選項不只一個,選錯的代價是工程師寫了兩個月的東西,其實一行 SQL 就做得到;或是用了免寫程式的工具,做到一半發現它根本做不到你要的目標。
一樣用有 2,000 間分店的連鎖飲料店當例子(教學假設),這次一口氣有四個需求:
| 需求 | 資料長什麼樣 |
|---|---|
| A. 預測哪些會員下個月會流失 | 會員表、交易表,都已經在 BigQuery 裡 |
| B. 封膜照片檢查(封膜有沒有歪) | 200 萬張照片,放在 Cloud Storage |
| C. 客服留言自動分類(抱怨、詢問、稱讚) | 文字 |
| D. 自己設計的「猜你想點」推薦模型,研究團隊用 PyTorch 寫好了 | 程式碼+交易表 |
這篇結束時,你會知道四個需求各該走哪條路,以及為什麼。
為什麼你需要知道
- 選項比你想的多:Google 的訓練方式文件列了五條路:AutoML、無伺服器訓練、訓練叢集、Ray、BigQuery ML。再加上「根本不用訓練」的 Gemini 和預訓練 API,有六七種。沒有判斷標準,每次都用自己最熟的那一種,常常是最貴或最慢的
- 選錯很難回頭:用 AutoML 做到一半,發現要自訂損失函數,整個重來;用自訂訓練做一個 BigQuery ML 五分鐘能做完的事,白燒兩個月人力
- 證照必考:PMLE 考試指南第 1.1 節直接寫「用 BigQuery ML 或 AutoML 開發模型」,第 3.1 節寫「選擇產品(例如 Agent Platform AutoML、BigQuery ML、Agent Platform Pipelines)」。這是整張考卷最常出現的判斷題型
- 筆記裡的名稱很多已經過時:AutoML Tables、AutoML Natural Language、AutoML Vision Edge 這些名字舊題庫一直在用,現在有的改名、有的已經停用,這篇一併整理
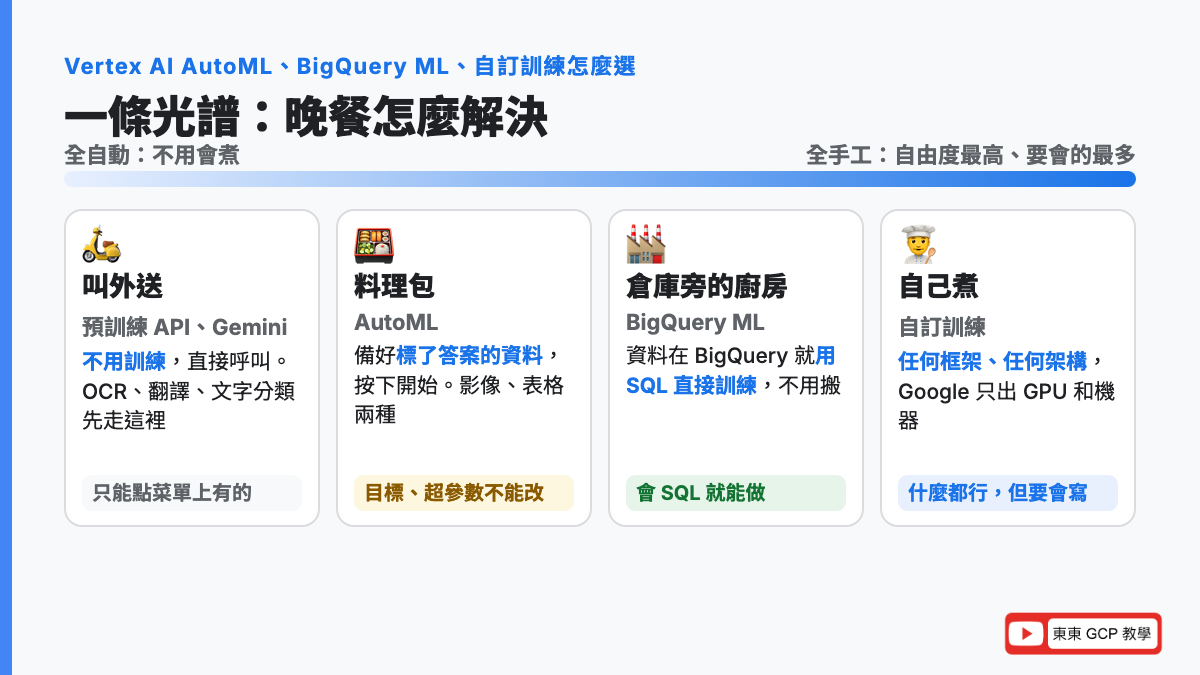
先搞懂:一條從「全自動」到「全手工」的光譜
白話是什麼
Google Cloud 的訓練服務不是三個各自獨立的東西,而是一條光譜:一端是你什麼都不用做、Google 全包;另一端是你什麼都自己來、Google 只出機器。
官方文件的說法:Agent Platform「提供一系列訓練方式,從全自動到全自訂」。
比喻:晚餐怎麼解決
| 做法 | 對應的服務 | 你要做什麼 | 能吃到什麼 |
|---|---|---|---|
| 叫外送、買便利商店 | 預訓練 API、Gemini、Model Garden 的現成模型 | 點餐 | 菜單上有的 |
| 買料理包回家加熱 | AutoML | 準備食材(資料)、按下開始 | 料理包有的那幾道 |
| 倉庫旁邊就有廚房 | BigQuery ML | 食材在哪就在哪煮,寫 SQL | 廚房配備的那些菜色 |
| 自己從頭煮 | 自訂訓練 | 買菜、備料、掌廚,Google 只出爐子 | 什麼都行 |
越往下,自由度越高、要會的事也越多。
來龍去脈:為什麼會變成一條光譜
早期 Google Cloud 的機器學習服務是一個一個分開的產品:AutoML Vision 管圖片、AutoML Tables 管表格、AutoML Natural Language 管文字、AI Platform 管自己寫的程式。2021 年 Google 把它們整合進 Vertex AI,變成同一個平台上的不同「訓練方式」。
2026 年 4 月,Vertex AI 又改名為 Gemini Enterprise Agent Platform(簡稱 Agent Platform)。這篇標題保留 Vertex AI,是因為大家還是用這個名字在搜尋;內文用新名稱,文末有對照表。
為什麼要學
考題不會問你「AutoML 是什麼」,而是給一個情境,問你「應該用哪個」。沒有這條光譜在腦子裡,每題都要猜。
第 0 步:先問「要不要自己訓練?」
在三個訓練選項之前,官方考試指南第 1.2 節還有一條更前面的路:用現成的。
- 預訓練 API:Google 已經訓練好、直接呼叫的服務。例如 Vision API 認圖片裡的文字、Document AI 讀發票、Translation API 翻譯。API 是「應用程式介面」,可以想成一個服務窗口,你把資料遞進去,它把結果遞出來。這些在第 23 篇會比較
- Gemini 和 Model Garden:Gemini 是 Google 的大型語言模型,Model Garden 是 Agent Platform 上的模型超市,有 Google 自家的和開源的模型可以直接用或微調
套回飲料店的需求 C(客服留言分類):這題以前的標準答案是 AutoML Natural Language,現在不是了。Google 在 2024 年 6 月公告,2024 年 9 月 15 日起 AutoML 的文字分類、實體擷取、情感分析不再開放訓練,既有模型到 2025 年 6 月 15 日停用,改用 Gemini 的提示詞和調校。
也就是說,留言分類這種事,現在先試「把留言丟給 Gemini,用提示詞請它分類」,不夠準再做調校。這是舊題庫和新考試差最多的地方之一。
1. BigQuery ML:資料在哪,就在哪訓練
白話是什麼
BigQuery ML 讓你用 SQL 在 BigQuery 裡面直接建模型、訓練、預測,資料不用搬出去。
先補兩個名詞:
- BigQuery 是 Google 的資料倉儲,專門存大量表格資料、用 SQL 查詢,站上有一篇BigQuery 跟資料庫差在哪
- SQL 是查詢表格資料的語言,資料分析師幾乎都會,像「把去年買超過 10 次的會員列出來」這種句子
比喻
倉庫旁邊直接蓋一間廚房。食材(資料)本來就堆在這裡,不用叫貨車載去別的地方煮,煮完的菜也直接放回倉庫。
來龍去脈
官方簡介講得很直白:以前做機器學習要會程式、會 ML 框架,這把一間公司裡「最懂資料的人」(資料分析師)排除在外。BigQuery ML 的目的是讓會 SQL 的人也能做,而且把 ML 帶到資料旁邊,不用把幾 TB 的資料搬去 Python 環境。
能做哪些模型
官方文件把 BigQuery ML 的模型分成四類:
| 類別 | 模型 | 白話 |
|---|---|---|
| BigQuery 內建訓練 | 線性迴歸、邏輯迴歸(第 2 篇)、K-means 分群、矩陣分解(推薦)、PCA(降維)、ARIMA_PLUS 時間序列預測、貢獻分析 | 最常用的那幾種,BigQuery 自己算 |
| 交給 Agent Platform 訓練(寫法還是 SQL) | 深度神經網路(DNN)、Wide & Deep、自動編碼器、提升樹(XGBoost)、隨機森林、AutoML | SQL 下指令,背後用 Agent Platform 的資源算 |
| 匯入外面訓練好的模型 | TensorFlow、TensorFlow Lite、ONNX(PyTorch、scikit-learn 可轉成這個格式)、XGBoost | 別處練好的模型,拿進 BigQuery 做預測 |
| 遠端模型 | 已部署在 Agent Platform 的模型、Gemini 這類大型語言模型 | SQL 裡直接呼叫,例如用 AI.GENERATE 讓 Gemini 幫每一列產生文字 |
時間序列預測還多了一個選項:不想自己管模型,可以用 AI.FORECAST 函數搭配內建的 TimesFM 模型(預覽階段)直接預測。
長什麼樣:三句 SQL
需求 A(會員流失預測),資料已經在 BigQuery,就是 BigQuery ML 的主場:
-- 1. 訓練:用邏輯迴歸預測 churned 欄位
CREATE MODEL `drink.churn_model`
OPTIONS (model_type = 'LOGISTIC_REG', input_label_cols = ['churned']) AS
SELECT visits_90d, avg_spend, days_since_last, member_months, churned
FROM `drink.member_features`;

-- 2. 評估:看準確率、精確率、召回率、AUC
SELECT * FROM ML.EVALUATE(MODEL `drink.churn_model`);

-- 3. 預測:對所有現有會員算流失機率
SELECT member_id, predicted_churned, predicted_churned_probs
FROM ML.PREDICT(MODEL `drink.churn_model`, TABLE `drink.member_features_today`);
第 5、6 篇講的混淆矩陣、ROC 曲線,BigQuery ML 也有對應的函數:ML.CONFUSION_MATRIX、ML.ROC_CURVE。要知道「每個特徵對這筆預測的貢獻」,用 ML.EXPLAIN_PREDICT(第 21 篇講可解釋 AI 時會再提)。
筆記裡寫的「BQML.PREDICT」「BQML.EXPLAIN_PREDICT」,正確的函數名稱是 ML.PREDICT 和 ML.EXPLAIN_PREDICT,BQML 只是產品的簡稱。
它的限制
官方比較表裡 BigQuery ML 有兩個「有限制」:
- 目標有限制:只能做它支援的那些模型,想自訂神經網路架構或損失函數做不到
- 資料量有配額:每個專案有 BigQuery ML 的配額上限
另外它的預測主要是批次(一次算一整張表)。要做即時的線上預測,可以把模型註冊到 Agent Platform 的 Model Registry 再部署成端點,第 17 篇會講。
為什麼要學
考題只要出現「資料分析師」「只會 SQL」「資料已經在 BigQuery」「不想搬資料」,答案幾乎都是 BigQuery ML。這是 PMLE 第 1.1 節的核心。
2. AutoML:給資料,Google 幫你選模型、調參數
白話是什麼
AutoML(自動化機器學習):你只要準備好標了答案的資料,它自動幫你做資料準備、挑模型、調超參數、部署。官方訓練總覽的說法是「免寫程式(code-free)建立模型」。
比喻
料理包。食材你準備(資料要自己收集、標好),但火候、調味、步驟全部包好了,加熱就能吃。好處是不用會煮;限制是只有料理包清單上的那幾道菜。
來龍去脈
AutoML 原本是一串獨立產品,筆記裡列的 AutoML Tables、AutoML Natural Language、AutoML Vision、AutoML Vision Edge、AutoML Forecasting 就是那個時代的名字。它們先被整合進 Vertex AI,現在叫 AutoML on Gemini Enterprise Agent Platform。
整合之後有兩個大變化:
| 舊產品 | 現在 |
|---|---|
| AutoML Tables | AutoML 表格(分類、迴歸)+ Tabular Workflows(可控版,下面講) |
| AutoML Forecasting | AutoML 表格的預測目標,另有 Tabular Workflow for Forecasting、BigQuery ML ARIMA_PLUS |
| AutoML Vision | AutoML 影像(分類、物件偵測) |
| AutoML Vision Edge | AutoML 影像的 Edge 模型,訓練完可匯出到裝置上跑 |
| AutoML Natural Language | 已停用(2024 年 9 月停止訓練、2025 年 6 月停用),改用 Gemini 提示詞和調校 |
| AutoML Video | 已停用(淘汰清單:2024 年 7 月淘汰、2025 年 7 月停用),改用 Gemini 的影片調校 |
現在能做什麼
官方訓練總覽列出的 AutoML 支援範圍:
| 資料類型 | 能做的目標 |
|---|---|
| 影像 | 分類、物件偵測 |
| 表格 | 分類、迴歸、預測(時間序列) |
表格的四種目標,官方表格資料文件用零售商的例子說明:
- 二元分類:是或不是(會不會買訂閱)
- 多類別分類:三種以上分一類(客戶屬於哪個人物誌)
- 迴歸:一個數字(下個月會花多少錢)
- 預測:一串數字(未來 3 個月每天的需求量)
要多少資料:算一次
AutoML 不用寫程式,但資料量有最低要求。官方初學者指南給了經驗法則:
影像:每個類別至少 100 張,目標 1,000 張;最少的類別要有最多類別的 10% 以上。
需求 B 封膜檢查,2 個類別(正常、有問題)
最低:100 × 2 = 200 張
建議:1,000 × 2 = 2,000 張
手上有 200 萬張 → 遠遠超過,沒問題
但如果「有問題」的照片只有 500 張、「正常」的有 199 萬張
500 ÷ 1,990,000 ≈ 0.03%,遠低於 10% → 要處理類別不平衡(第 9 篇)表格(列數 × 特徵數的倍數):
- 分類:50 × 特徵數
- 迴歸:200 × 特徵數
- 預測:5,000 × 特徵數,而且時間序列識別欄至少要有 10 個不同的值
需求 A 會員流失,用 20 個特徵做分類
最低列數 = 50 × 20 = 1,000 列
50 萬名會員 → 綽綽有餘數字怎麼看:分類要的資料最少,迴歸要 4 倍,預測要 100 倍。因為預測要學的是「一整段時間的走勢」,資料不夠它看不出季節性。
訓練預算:節點小時
AutoML 影像訓練要先設預算,單位是節點小時(node hour):一台訓練機器跑一小時算一個節點小時。官方影像訓練文件寫的是「毫節點小時」(milli node hour,千分之一節點小時),雲端模型的範圍是 8,000 到 800,000 毫節點小時:
8,000 毫節點小時 = 8 節點小時(最低)
800,000 毫節點小時 = 800 節點小時(最高)
實際花費「等於或低於」這個預算,訓練提早收斂就提早停。這是 AutoML 少數能控制的東西之一:官方比較表說你能控制的只有「訓練小時預算」和「提前停止」。
Edge 模型:訓練完帶走
需求 B 如果要在每間分店的機器上即時判斷、不連網路,AutoML 影像可以訓練 Edge 模型,然後匯出成:
- TF Lite:在手機、小型裝置上跑
- Edge TPU TF Lite:給 Google 的 Edge TPU 晶片
- Core ML:iPhone、Mac
- TensorFlow.js:在瀏覽器裡跑
- 容器:TF SavedModel 包成 Docker 容器
官方特別提醒:Edge 模型不能在 Agent Platform 上提供預測,一定要部署到外部裝置。舊題庫的「AutoML Vision Edge」就是這個,現在的關鍵字是「Edge 模型」「匯出 TF Lite」。
想多控制一點:Tabular Workflows
表格資料還有一個「進階版 AutoML」叫 Tabular Workflows。它把 AutoML 拆成一條管線(資料切分、特徵工程、架構搜尋、訓練、集成、蒸餾),每一步都能自己決定要控制還是交給它。官方列的好處:支援多 TB、最多 1,000 欄的資料集,可以跳過架構搜尋來省時間,可以自己選硬體。
這是 AutoML 和自訂訓練之間的中間地帶,考題出現「想用 AutoML 但資料很大、想控制某些步驟」就是它。
它的限制
官方比較表裡 AutoML 的三個「有限制」:
- 目標有限制:只能做它預先定義的那幾種
- 超參數不能自己調:它有自動調,但你改不了數值
- 資料量有限制:依資料類型不同
為什麼要學
AutoML 是「快速原型」的工具,官方文件說可以用它「在投入開發前快速探索新資料集,例如找出哪些特徵最有用」。考題看到「最少的工程投入」「團隊沒有 ML 專業」「快速驗證」,就是它。
3. 自訂訓練:你寫程式,Google 出機器
白話是什麼
自訂訓練(custom training):你自己寫訓練程式(用任何框架),打包成容器,交給 Agent Platform 跑。它負責開機器、裝 GPU、跑完關機。
容器(container)是把程式和它需要的所有東西打包成一個標準箱子,到哪台機器都能跑,站上有一篇容器是什麼。
比喻
自己從頭煮。想做什麼菜都行、想怎麼調味都行,但你要會煮。Google 只負責爐子(機器、GPU、TPU),而且用完才收錢。
來龍去脈
AutoML 和 BigQuery ML 再方便,總有做不到的事:研究團隊設計的新架構、特殊的損失函數、要用 PyTorch、要幾十張 GPU 一起訓練。官方文件的說法:「如果 AutoML 不符合需求,你可以提供自己的訓練程式碼,在 Agent Platform 的代管基礎設施上執行,對模型架構和訓練邏輯有完全的控制。」
需求 D(研究團隊的 PyTorch 推薦模型)就是典型:程式已經寫好了,只缺機器。
兩種跑法
官方訓練總覽把自訂訓練分成兩種模式:
| 無伺服器訓練(Serverless Training) | 訓練叢集(Training Clusters) | |
|---|---|---|
| 白話 | 要用才開機器,跑完就收 | 先包下一批機器,隨時可用 |
| 比喻 | 叫計程車 | 包月租車 |
| 適合 | 實驗、原型、不需要保證馬上有機器的正式工作 | 大規模、長時間、不能排隊等的關鍵訓練 |
| 收費 | 用多少付多少 | 保留期間都算 |
| 硬體 | 自己指定機型、GPU | 可保留 A100、H100 這類高階 GPU |
無伺服器(serverless)不是沒有伺服器,是「伺服器你看不到、不用管」。
另外還有 Ray on Agent Platform:用開源的 Ray 框架做分散式運算,適合本來就用 Ray 的團隊。
自訂訓練的細節(預建容器、分散式訓練、GPU 和 TPU 怎麼選)第 16 篇專門講。
為什麼要學
考題看到「自訂損失函數」「PyTorch」「研究團隊已經寫好程式」「需要完全控制」「分散式訓練」,就是自訂訓練。這是 PMLE 第 3.2 節的主軸。
四個問題,決定走哪條路
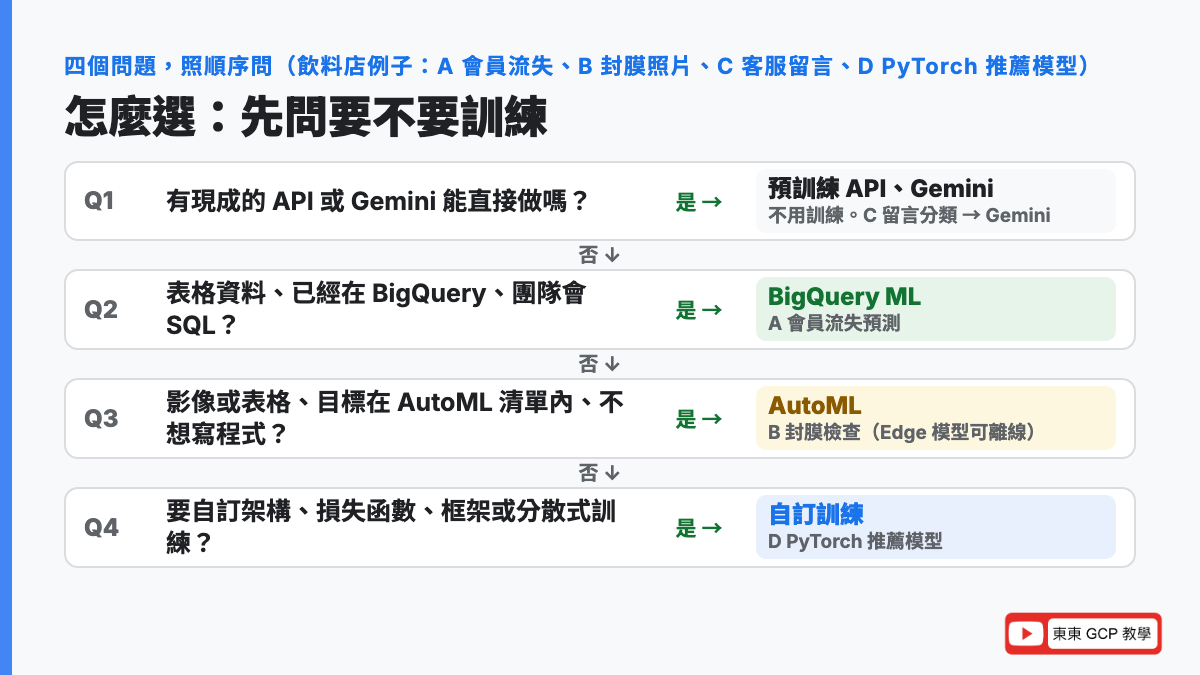
| 問題 | 答「是」就走 | 飲料店的例子 |
|---|---|---|
| Q1. 有現成的 API 或 Gemini 能直接做嗎? | 預訓練 API、Gemini、Model Garden,不用訓練 | 需求 C 客服留言分類 → Gemini 提示詞 |
| Q2. 資料是表格、已經在 BigQuery、團隊會 SQL? | BigQuery ML | 需求 A 會員流失 |
| Q3. 資料是影像或表格、目標在 AutoML 清單內、不想寫程式? | AutoML | 需求 B 封膜檢查 |
| Q4. 需要自訂架構、損失函數、特定框架、分散式? | 自訂訓練 | 需求 D PyTorch 推薦模型 |
兩個補充:
- 問題有順序:Q1 排第一,是因為新版考試指南把「用現成模型」放在第 1 區。能不訓練就不訓練,最省
- 中間地帶很多:BigQuery ML 裡可以用 SQL 叫 AutoML(
model_type = 'AUTOML_CLASSIFIER'),也可以匯入 TensorFlow 模型;Tabular Workflows 是可控的 AutoML。考題有時會出這種「混搭」
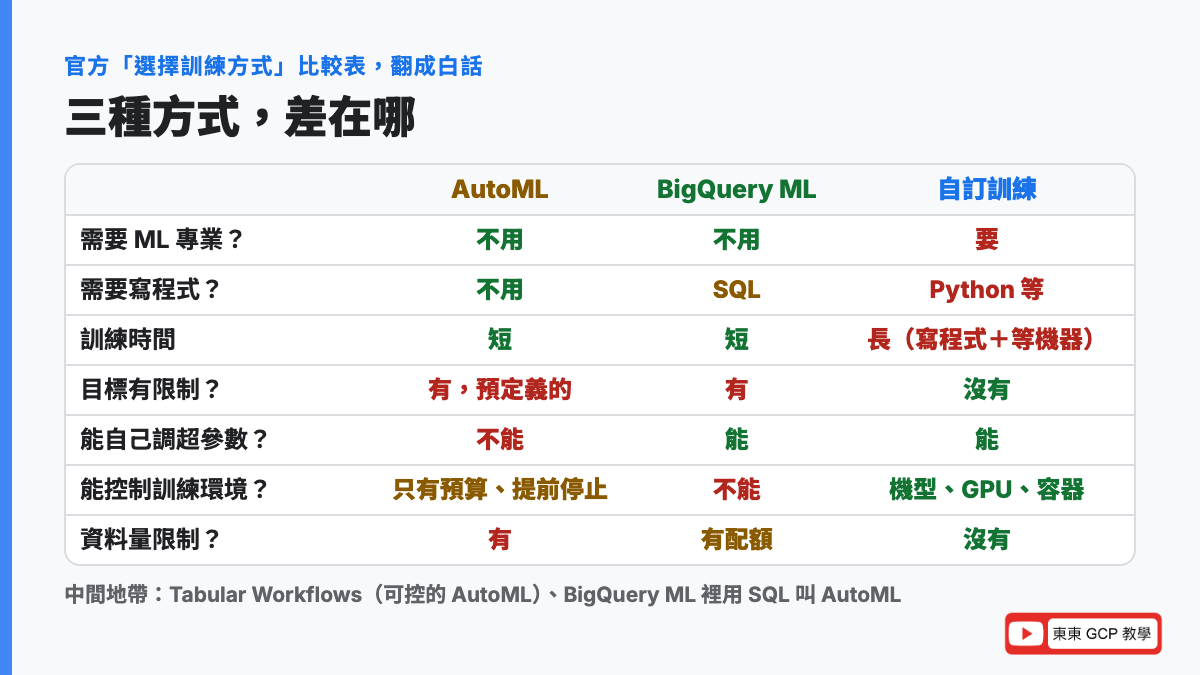
官方比較表(翻成白話)
Google 的訓練方式文件有一張比較表,整理成這樣:
| AutoML | BigQuery ML | 自訂訓練(無伺服器) | |
|---|---|---|---|
| 需要 ML 專業? | 不用 | 不用 | 要,自己寫訓練程式、處理資料 |
| 需要寫程式? | 不用 | 要(SQL) | 要(Python 等) |
| 訓練時間 | 短,不用開發 | 短,用 BigQuery 的算力 | 長,要寫程式+等機器 |
| 目標有限制? | 有,只能選預定義的 | 有 | 沒有 |
| 能自己調超參數? | 不能 | 能 | 能 |
| 能控制訓練環境? | 很少(預算、提前停止) | 不能 | 能(機型、硬碟、容器) |
| 資料量限制? | 有 | 有配額 | 沒有 |
在 GCP 上怎麼做
1. BigQuery ML 的流程
- 資料整理成一張表(特徵欄+標籤欄),第 10、11 篇的前處理和特徵工程可以直接用 SQL 或
TRANSFORM子句做 CREATE MODEL訓練,ML.EVALUATE看分數,ML.PREDICT批次預測- 要線上預測,把模型註冊到 Agent Platform Model Registry,部署成端點(第 17 篇)
收費是 BigQuery 的算力費用;呼叫遠端模型(例如 Gemini)另外算 Agent Platform 的費用。站上有一篇 BigQuery 計費方式。
2. AutoML 的流程
- 在 Agent Platform 建資料集:影像從 Cloud Storage 匯入(CSV 或 JSON Lines 列出檔案和標籤),沒標的可以在主控台上標;表格從 BigQuery 或 CSV 匯入
- 選目標(分類、迴歸、預測、物件偵測)、設訓練預算、按開始
- 看評估指標(第 5、6 篇那些),部署成端點,或匯出 Edge 模型
3. 自訂訓練的流程
- 寫訓練程式,用預建容器(支援 PyTorch、TensorFlow、scikit-learn、XGBoost)或自己做容器
- 建 CustomJob:指定機型、GPU、資料路徑(第 13 篇講的
/gcs/) - 模型存到 Cloud Storage,註冊到 Model Registry
第 16 篇會把每一步展開。
4. 改名對照
| 舊名稱(筆記、舊題庫) | 現在的名稱 |
|---|---|
| Vertex AI | Gemini Enterprise Agent Platform(Agent Platform) |
| Vertex AI AutoML | AutoML on Gemini Enterprise Agent Platform |
| AutoML Tables、Vision、Natural Language(獨立產品) | 整合進 AutoML;文字已停用改 Gemini |
| Vertex AI Training、custom training | Gemini Enterprise Agent Platform Managed Training;無伺服器的叫 Serverless Training |
| Vertex AI Model Registry | Gemini Enterprise Agent Platform Model Registry |
| BigQuery ML、BQML | 名稱沒變 |
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這篇的內容對應到:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 1 區:設計低程式碼 AI 方案(約 13%) | 1.1 用 BigQuery ML 或 Agent Platform AutoML 開發模型(分類、迴歸、預測、分群);用 BigQuery ML 做特徵工程、產生預測;用 AutoML 訓練。1.2 用 Google Cloud AI API 或基礎模型建方案:從 Model Garden 選模型、用產業 API(Document AI、Vision API、Translate API) |
| 第 3 區:把原型放大成 ML 模型(約 21%) | 3.1 依成本、複雜度、延遲、擴展性建模型:選產品(Agent Platform AutoML、BigQuery ML、Agent Platform Pipelines)。3.2 用不同 SDK 訓練(Agent Platform 自訂訓練、GKE 上的 Kubeflow、AutoML、Tabular Workflows) |
注意 3.2 直接點名 Tabular Workflows,新版考試把它當成一個獨立選項。
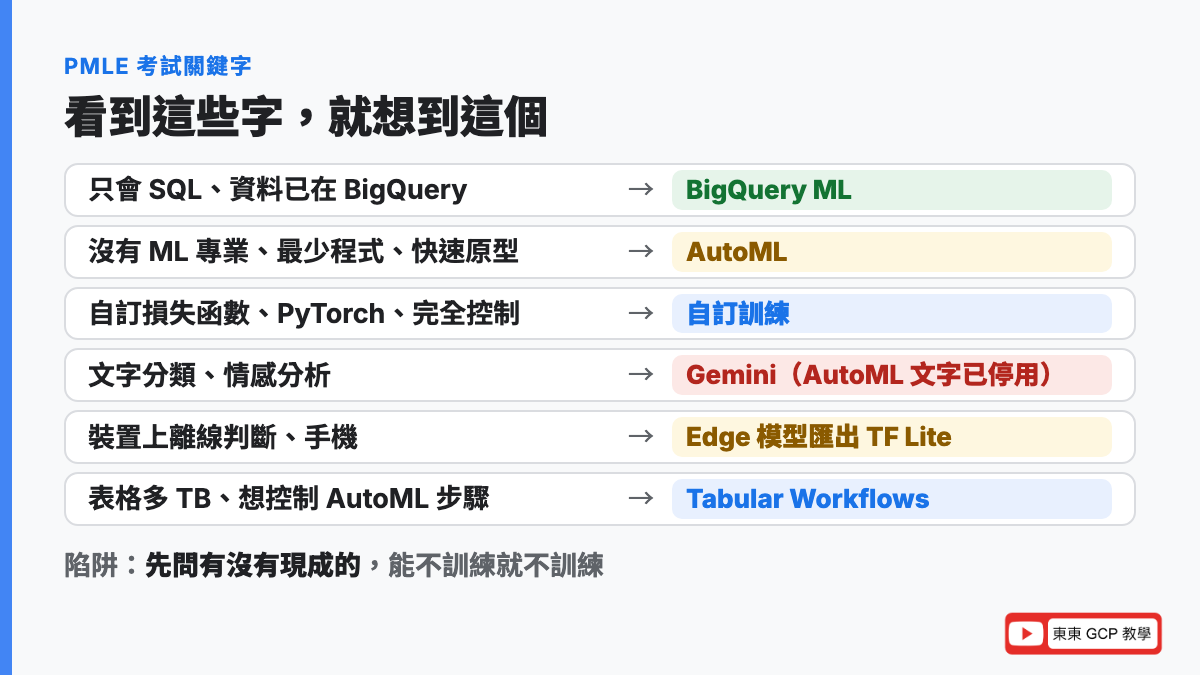
看到這些字,就想到這個
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「資料分析師」「只會 SQL」「資料已在 BigQuery」「不想搬資料」 | BigQuery ML |
| 「時間序列預測」+「SQL」 | BigQuery ML ARIMA_PLUS(或 AI.FORECAST 搭 TimesFM) |
| 「沒有 ML 專業」「最少的程式」「快速原型」「找出重要特徵」 | AutoML |
| 「圖片分類」「物件偵測」「不想寫程式」 | AutoML 影像 |
| 「裝置上判斷」「離線」「低延遲」「手機」 | AutoML Edge 模型,匯出 TF Lite |
| 「文字分類」「情感分析」「實體擷取」 | Gemini 提示詞或調校(AutoML 文字已停用) |
| 「OCR」「翻譯」「發票辨識」 | 預訓練 API,不用訓練 |
| 「自訂損失函數」「自訂架構」「PyTorch」「研究團隊寫好程式」「完全控制」 | 自訂訓練 |
| 「幾十張 GPU」「分散式」「保證有機器」「H100」 | 自訂訓練的訓練叢集 |
| 「表格資料多 TB」「1,000 欄」「想控制 AutoML 的某些步驟」 | Tabular Workflows |
| 「用 SQL 但想要 AutoML 的效果」 | BigQuery ML 的 AUTOML_CLASSIFIER/REGRESSOR |
六個常見陷阱
- 文字分類選 AutoML Natural Language:2025 年 6 月已停用,現在是 Gemini
- 只會 SQL 的團隊選自訂訓練:題目強調團隊能力時,答案跟著能力走
- 需要自訂損失函數還選 AutoML:AutoML 連超參數都不能改,更別說損失函數
- Edge 模型拿去 Agent Platform 部署:官方明寫不行,Edge 模型只能部署到外部裝置
- 資料量不夠硬用 AutoML:影像每類至少 100 張,表格分類至少 50 × 特徵數列
- 直接跳到訓練,沒先問有沒有現成的:新版考試第 1.2 節就是在考「能不能不訓練」
練習情境(自己出的練習,不是真實考題)
飲料店的資料團隊有三位資料分析師,都很熟 SQL,沒有人寫過 Python。會員和交易資料都在 BigQuery。老闆要在兩週內看到「哪些會員會流失」的預測結果。應該怎麼做?
判斷過程:
- 「只會 SQL」「資料在 BigQuery」「兩週」→ BigQuery ML
- 流失是「會或不會」→ 二元分類,
LOGISTIC_REG(或BOOSTED_TREE_CLASSIFIER) - 用
ML.EVALUATE看召回率(第 5 篇),ML.PREDICT批次算出名單
同一家店想用封膜照片訓練瑕疵偵測模型,團隊沒有電腦視覺經驗,但有 5 萬張標好的照片。模型要裝在每間分店的機器上,沒有網路也要能判斷。應該怎麼做?
判斷過程:
- 「沒有電腦視覺經驗」「照片已標好」→ AutoML 影像
- 「裝在分店機器上」「沒有網路」→ 訓練 Edge 模型,匯出 TF Lite(或容器)
- 5 萬張 ÷ 2 類 = 每類 2.5 萬張,遠超過建議的 1,000 張
研究團隊用 PyTorch 設計了一個新的推薦模型,有自訂的損失函數,需要 8 張 GPU 平行訓練,而且這是每週都要重訓的正式工作,不能排隊等機器。應該怎麼做?
判斷過程:
- 「PyTorch」「自訂損失函數」→ 自訂訓練
- 「8 張 GPU」→ 分散式訓練(第 16 篇)
- 「正式工作、不能排隊」→ 訓練叢集(保留機器),不是無伺服器訓練
常見問答
Vertex AI AutoML、BigQuery ML、自訂訓練怎麼選?
先問有沒有現成的 API 或 Gemini 能直接做,有就不用訓練。要訓練的話:資料是表格、已經在 BigQuery、團隊會 SQL,用 BigQuery ML;資料是影像或表格、目標在 AutoML 支援清單內、不想寫程式,用 AutoML;需要自訂模型架構、損失函數、特定框架或分散式訓練,用自訂訓練。官方的訓練方式文件有一張比較表,差別在需不需要 ML 專業、要不要寫程式、目標有沒有限制、能不能調超參數。
BigQuery ML 是什麼?能做哪些模型?
BigQuery ML 讓你用 SQL 在 BigQuery 裡直接訓練和使用模型,資料不用搬出去。內建的有線性迴歸、邏輯迴歸、K-means、矩陣分解、PCA、ARIMA_PLUS 時間序列;透過 Agent Platform 訓練的有 DNN、Wide & Deep、提升樹、隨機森林、AutoML;也能匯入 TensorFlow、ONNX、XGBoost 模型,或遠端呼叫 Gemini。預測用 ML.PREDICT,評估用 ML.EVALUATE,解釋用 ML.EXPLAIN_PREDICT。
AutoML 是什麼?現在支援哪些資料?
AutoML 是免寫程式的機器學習:你提供標好的資料,它自動做資料準備、選模型、調超參數、部署。目前官方訓練總覽列的支援範圍是影像(分類、物件偵測)和表格(分類、迴歸、預測)兩種資料類型。舊題庫的 AutoML Tables、AutoML Vision 都已整合進來,AutoML Natural Language 和 AutoML Video 都已停用,改用 Gemini。
AutoML Natural Language 還能用嗎?
不能。Google 在 2024 年 6 月公告,2024 年 9 月 15 日起 AutoML 的文字分類、實體擷取、情感分析不再開放訓練,既有模型到 2025 年 6 月 15 日停用,改用 Gemini 的提示詞和模型調校。舊題庫看到文字分類選 AutoML Natural Language,現在的答案是 Gemini。
AutoML Vision Edge 是什麼?
舊名稱,現在叫 AutoML 影像的 Edge 模型。訓練時選 Edge 類型,訓練完可以匯出成 TF Lite、Edge TPU TF Lite、Core ML、TensorFlow.js 或容器,部署到手機、工廠機台這類裝置上,離線也能判斷。官方特別提醒 Edge 模型不能在 Agent Platform 上提供預測,一定要部署到外部裝置。
AutoML 要多少資料?
官方初學者指南的經驗法則:影像每個類別至少 100 張,目標 1,000 張,最少的類別要有最多類別的 10% 以上;表格分類至少 50 乘以特徵數的列數,迴歸 200 乘以特徵數,預測 5,000 乘以特徵數,而且時間序列識別欄至少 10 個不同的值。例如 20 個特徵的分類模型至少要 1,000 列。
什麼時候一定要用自訂訓練?
AutoML 和 BigQuery ML 做不到的時候:需要自訂的模型架構或損失函數、要用特定框架(PyTorch、JAX)、研究團隊已經寫好程式、需要多台機器或多張 GPU 分散式訓練、需要完全控制訓練環境。官方比較表裡自訂訓練在「目標限制」和「資料量限制」兩項都是「沒有」。
AutoML 和自訂訓練可以混用嗎?
可以,中間地帶不少。Tabular Workflows 是可控的 AutoML,把流程拆成資料切分、特徵工程、架構搜尋、訓練等步驟,每步可以自己決定要控制還是交給它,支援多 TB、1,000 欄的資料。BigQuery ML 裡也能用 SQL 叫 AutoML(model_type 設 AUTOML_CLASSIFIER),或匯入自己訓練的 TensorFlow 模型做預測。
無伺服器訓練和訓練叢集差在哪?
都是自訂訓練。無伺服器訓練是要用才開機器、跑完就收、用多少付多少,適合實驗和不需要保證馬上有機器的工作;訓練叢集是先保留一批專屬的高階 GPU(例如 A100、H100),隨時可用不用排隊,適合大規模、長時間、不能等的關鍵訓練。Google 兩種都幫你管硬體維護和作業系統更新。
一定要訓練模型嗎?
不一定,而且新版考試把「不訓練」排在第一區。Google 有預訓練 API(Vision API 認圖、Document AI 讀文件、Translation API 翻譯)和 Gemini 這類基礎模型,很多任務直接呼叫就能做。考試指南第 1.2 節就是「用 Google Cloud AI API 或基礎模型建方案」。先確認現成的做不到,再考慮訓練。
Vertex AI AutoML 改名了嗎?
是。Vertex AI 在 2026 年 4 月改名為 Gemini Enterprise Agent Platform,AutoML 現在叫 AutoML on Gemini Enterprise Agent Platform,Vertex AI Training 改叫 Agent Platform Managed Training,Model Registry 改叫 Agent Platform Model Registry。BigQuery ML 名稱沒變。舊題庫的名稱對應到現在的服務,功能基本一樣。
重點整理
- 一條光譜:預訓練 API/Gemini(外送)→ AutoML(料理包)→ BigQuery ML(倉庫旁的廚房)→ 自訂訓練(自己煮)。越往後自由度越高、要會的越多
- 先問要不要訓練:Gemini、Model Garden、預訓練 API 能做就不訓練,新版考試第 1.2 節
- BigQuery ML:資料在 BigQuery、團隊會 SQL;內建迴歸、分群、時間序列,也能叫 AutoML、匯入 TF/ONNX、遠端呼叫 Gemini;函數是
ML.PREDICT不是 BQML.PREDICT - AutoML:免寫程式;現在只有影像(分類、物件偵測)和表格(分類、迴歸、預測);文字、影片已停用改 Gemini;資料最低量影像每類 100 張、表格分類 50 × 特徵數;Edge 模型匯出 TF Lite 到裝置上跑
- 自訂訓練:自訂架構、損失函數、框架、分散式;無伺服器訓練(叫計程車)vs 訓練叢集(包月租車)
- 中間地帶:Tabular Workflows(可控的 AutoML)、BigQuery ML 叫 AutoML
- Vertex AI 已改名 Gemini Enterprise Agent Platform,AutoML Tables/Vision/NL 這些獨立產品名都已成為歷史
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 第 3 篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切
- 第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
- 第 6 篇:ROC 曲線和 AUC 怎麼看?門檻怎麼調、AUC-PR 差在哪
- 第 7 篇:過度擬合是什麼?正則化、Dropout、提前停止 3 招解決
- 第 8 篇:資料洩漏是什麼?模型考試作弊的 3 種常見情況
- 第 9 篇:類別不平衡怎麼辦?過取樣、欠取樣與 Upweighting
- 第 10 篇:資料前處理怎麼做?標準化、遺失值、高基數類別
- 第 11 篇:特徵工程是什麼?特徵交叉、詞嵌入、資料增強一次看懂
- 第 12 篇:機器學習的資料隱私怎麼保護?DLP、聯邦學習、VPC Service Controls
- 上一篇:第 13 篇:訓練資料讀太慢?TFRecords、tf.data 與 prefetch 加速
- 下一篇:第 15 篇:BigQuery ML 入門:只會 SQL 也能訓練模型
站上相關文章
- Vertex AI 核心功能 Agent Builder、Model Builder 和 Model Garden 介紹
- BigQuery 是資料庫嗎?跟資料庫差在哪
- BigQuery 計費方式完整介紹
- 容器技術是什麼?從零開始看懂 Docker 與容器化應用
- 不會寫程式,可以轉職雲端架構師嗎?
- GCP 學習路徑 Roadmap
知道該用哪個工具,才不會拿大砲打蚊子。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。