模型部署怎麼選?要即時回應就部署到端點做線上預測,一次算一大批就用批次預測不用端點,換新版本用流量分割慢慢切。
模型訓練好了(第 14 到 16 篇),接下來要讓它真的能用:App 要能問它「這位會員會不會流失」,行銷部門要能拿到一整張名單。這篇講的就是「模型怎麼上線」:兩種拿到預測的方式、端點怎麼設、新舊版本怎麼換、機器怎麼自動增減、要花多少錢。
一樣用有 2,000 間分店、50 萬名會員的連鎖飲料店當例子(教學假設),兩個模型:
- 猜你想點推薦模型:會員一打開 App 就要看到推薦,等不了
- 會員流失預測模型:行銷部門每週一早上要一張「這週該追誰」的名單
為什麼你需要知道
- 模型不上線等於沒做:訓練完的模型只是 Cloud Storage 裡的一個檔案,要有人能呼叫它才有價值
- 部署比訓練更花錢:訓練跑完機器就收掉;線上端點的機器只要部署著就一直算錢,不管有沒有人用。選錯方式,一個月帳單比訓練貴十倍
- 筆記裡的名稱改了:Vertex AI Endpoints、Online Prediction、Batch Prediction 現在叫 Agent Platform Inference、線上推論、批次推論;更早的 AI Platform Prediction 已在 2025 年 4 月關閉
- 證照必考:PMLE 考試指南第 4 區「服務與擴展模型」佔 20%,4.1 部署批次和線上推論、容器、Model Registry、推出策略(A/B 測試、金絲雀部署)、前後處理;4.2 擴展線上服務、公開和私人端點、硬體選擇
先搞懂:推論是什麼、兩種拿法
白話是什麼
推論(inference):把新資料丟進訓練好的模型,拿到它的輸出。以前叫預測(prediction),Google 的文件現在統一用「推論」,這篇兩個詞混用,意思一樣。
Google 的推論總覽說,拿推論有兩種方法:
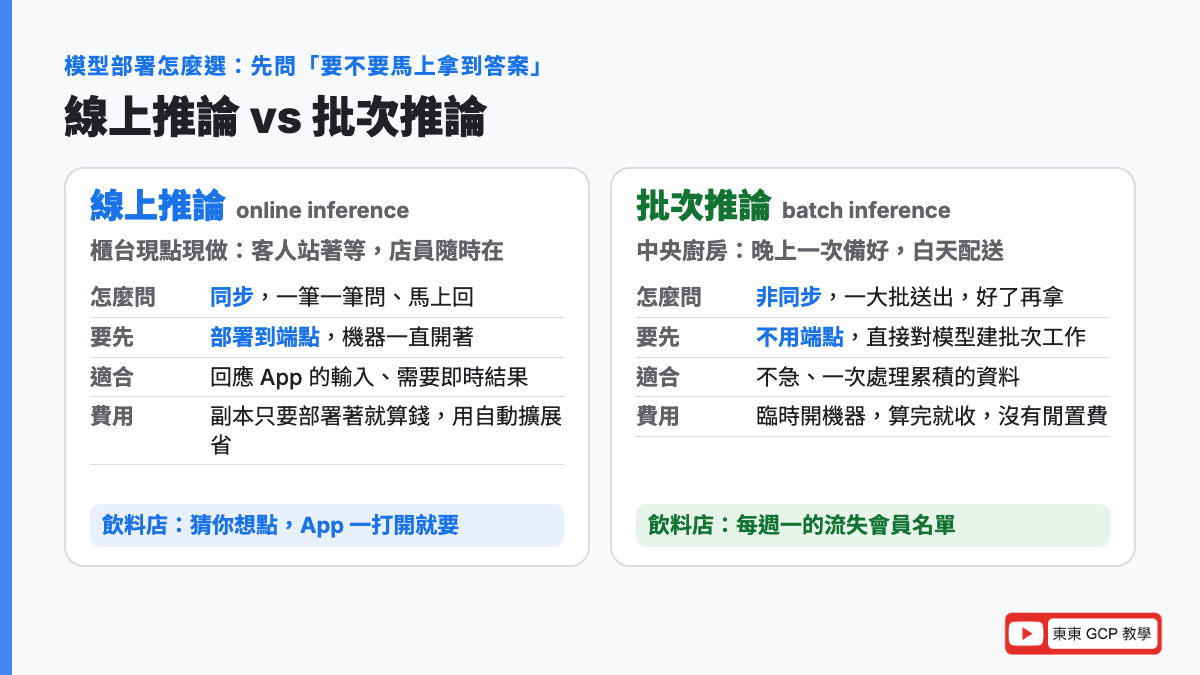
| 線上推論(online inference) | 批次推論(batch inference) | |
|---|---|---|
| 白話 | 一筆一筆問,馬上回答 | 一大批一起算,算完通知你 |
| 官方定義 | 同步請求,送給已部署到端點的模型 | 非同步請求,不用部署,直接對模型送一個批次推論工作 |
| 什麼時候用 | 回應應用程式的輸入、需要即時結果 | 不需要立刻回應、想用一次請求處理累積的資料 |
| 飲料店 | 猜你想點 | 會員流失名單 |
同步是「送出請求、站在那裡等答案」;非同步是「送出請求先走,好了再來拿」。
比喻
- 線上推論是櫃台現點現做:客人站在櫃台等,店員要隨時在、飲料機要隨時開著,就算半夜沒客人也要有人顧店
- 批次推論是中央廚房:晚上把明天 2,000 間店的食材一次備好,白天配送。不用隨時待命,但客人現在點的東西拿不到
來龍去脈
線上推論要先部署(deploy):把模型放到一台或多台隨時開著的機器上,等請求進來。這些機器叫端點(endpoint),本質上是一個網址,應用程式把資料 POST 過去就拿到答案。
批次推論不用端點:你告訴 Agent Platform「模型在這、資料在那(BigQuery 表或 Cloud Storage 檔案)、結果放哪」,它臨時開機器算完、把結果寫到你指定的地方、機器收掉。
為什麼要學
考題最常考的判斷就是這個:看到「即時」「App 回應」「低延遲」選線上;看到「每天晚上」「整批」「不急」選批次。選錯不只考試扣分,實務上帳單差十倍。
1. 線上推論:端點怎麼設
部署時決定的三件事
官方部署文件說,部署模型時會建三種資源,各決定一件事:
| 資源 | 決定什麼 | 白話 |
|---|---|---|
| Endpoint(端點) | 在哪個區域跑 | 櫃台開在哪 |
| Model(模型) | 用哪個容器(ModelContainerSpec) | 飲料機是哪一台 |
| DeployedModel(已部署的模型) | 用什麼運算資源(機型、GPU、副本數) | 幾個店員、幾台機器 |
副本(replica)就是「跑著同一個模型的一台機器」,開 3 個副本就是 3 台機器同時接請求。
官方提醒:部署後這些設定不能改,要改就重新部署。例外是擴展設定(最少/最多副本數、擴展指標)可以不重新部署直接改。
端點有四種
官方端點類型文件的比較表,整理成白話:
| 專用公開端點(推薦) | 共用公開端點 | 專用私人端點(Private Service Connect,推薦) | 私人端點(VPC 對等互連) | |
|---|---|---|---|---|
| 誰能連 | 網際網路 | 網際網路 | 只有你的內網 | 只有你的內網 |
| 跟別人共用網路嗎 | 不共用,有自己的網路層 | 共用 | 不共用 | 不共用 |
| 請求大小上限 | 10 MB | 1.5 MB | 10 MB | 10 MB |
| 逾時 | 可設到 1 小時 | 60 秒 | 可設到 1 小時 | 60 秒 |
| 每分鐘請求數配額 | 無上限 | 30,000 | 無上限 | 無上限 |
| 串流回應 | 有 | 無 | 有 | 無 |
| 流量分割 | 有 | 有 | 有 | 無 |
| VPC Service Controls(第 12 篇) | 不支援 | 支援 | 支援 | 支援 |
怎麼選:
- 一般情況選專用公開端點,官方說它更快、跟其他使用者的流量隔離、請求可以更大、逾時更長
- 公司內部系統呼叫、不想走公網 → Private Service Connect 端點
- 要放進 VPC Service Controls 的邊界 → 共用公開或私人端點
- 微調過的 Gemini 模型只能部署到共用公開端點
Private Service Connect(私人服務連線)是讓你的內網直接接到 Google 的服務,不經過公開網際網路,不需要公開 IP。
容器:預建、自訂、還是自訂推論例程
跟訓練一樣(第 16 篇),模型要包在容器裡才能跑:
- 預建推論容器:Google 準備好的 TensorFlow(含效能最佳化版)、PyTorch、scikit-learn、XGBoost 容器,模型檔放 Cloud Storage 就能用
- 自訂容器:自己寫 HTTP 伺服器。官方要求:監聽
AIP_HTTP_PORT環境變數指定的埠、提供健康檢查路徑(10 秒內回 200 才算活著)和推論路徑、請求格式是{"instances": [...]}、回應是{"predictions": [...]} - 自訂推論例程(Custom Prediction Routine,CPR):中間地帶。官方說明:你只寫前處理和後處理的 Python 程式(實作 Predictor 介面),HTTP 伺服器和 Dockerfile 它幫你準備,還能先在本機部署測試
前處理是「資料進模型前先整理」(例如第 10 篇的標準化),後處理是「模型輸出後再加工」(例如把機率換成「高/中/低」風險等級,或套商業規則)。考試指南 4.1 直接寫「開發推論前處理和後處理的解決方案」,答案就是 CPR 或自訂容器。
筆記裡的「自訂預測例程(CPR)」現在的正式名稱是 custom inference routine,縮寫沒變。
Model Registry:模型的倉庫
Model Registry 是集中管理模型的地方:匯入模型、管版本、貼別名(例如把要上線的版本標成 default)、從這裡部署到端點或跑批次推論、看評估結果。
- 自訂訓練的模型要先匯入才會出現;AutoML 的模型訓練完自動進來;BigQuery ML 的模型用
model_registry = 'VERTEX_AI'註冊(第 15 篇) - 官方部署文件寫明:模型要在 Model Registry 看得到才能部署
2. 流量分割:新版本怎麼換上去
問題
推薦模型 v2 訓練好了,離線評估比 v1 好。但離線好不代表上線好(第 8 篇的資料洩漏、第 20 篇的偏差都可能讓分數虛高)。直接全換,萬一 v2 有問題,所有會員同時受影響。
白話是什麼
流量分割(traffic split):同一個端點上放兩個以上的模型,設定每個模型接多少比例的請求。
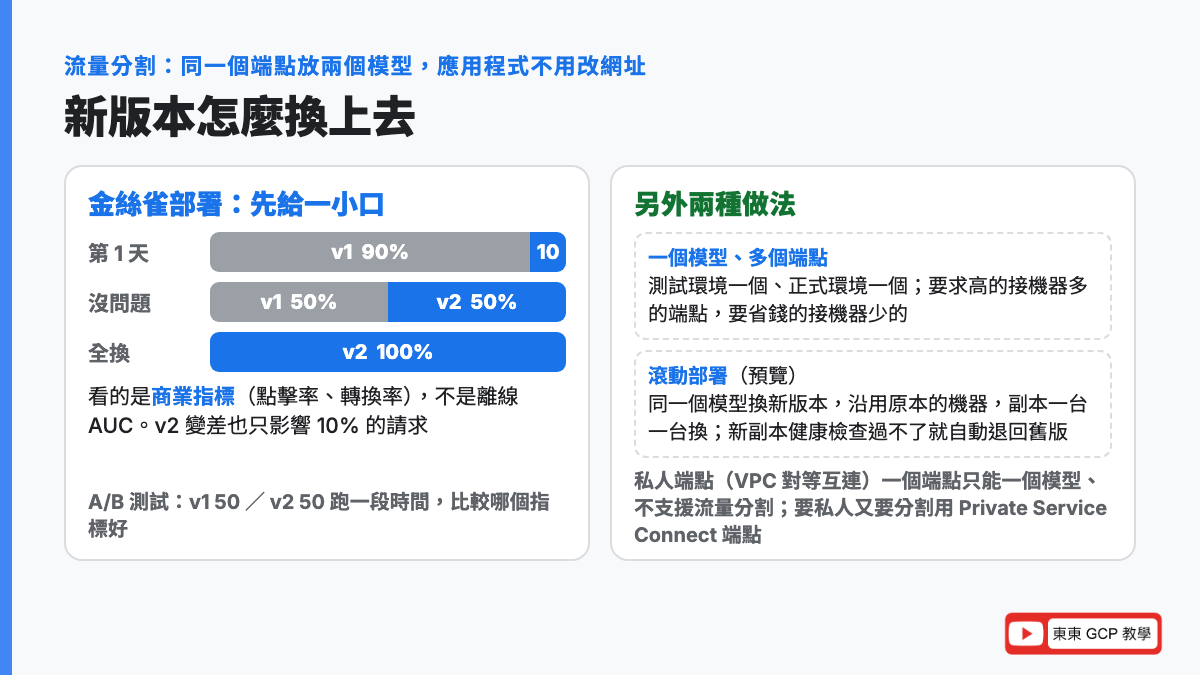
官方的說法:把新模型加到同一個端點,先服務一小部分流量,逐步提高比例,直到 100%。好處是應用程式不用改端點網址,也不會突然大變。
比喻
新配方的珍奶,先在 10% 的訂單裡用新配方,看客人反應和退貨率,沒問題再 50%、再 100%。客人還是走同一個櫃台,不知道後面換了配方。
兩種常見用法
| 用法 | 白話 | 怎麼設 |
|---|---|---|
| 金絲雀部署(canary deployment) | 新版本先吃一小口流量,觀察沒問題再加 | v1 90%、v2 10% → 50/50 → 0/100 |
| A/B 測試(A/B testing) | 兩個版本各接一半,比較哪個商業指標好 | v1 50%、v2 50%,持續一段時間 |
金絲雀這個名字來自礦工帶金絲雀下礦坑,鳥先倒就知道有毒氣:用一小部分流量當探子。
考試指南 4.1 直接點名「實作模型推出策略(例如 A/B 測試和金絲雀部署)來比較模型版本」,在 Agent Platform 上的做法就是流量分割。
反過來:一個模型、多個端點
官方也列了「一個模型部署到多個端點」的理由:測試環境和正式環境用不同資源;不同應用程式有不同的效能要求(SLO,服務水準目標),要求高的部署到機器多的端點,要省錢的部署到機器少的端點。
滾動部署(預覽功能)
要同一個模型換新版本、沿用原本的機器,可以用滾動部署:新版本的副本一台一台換掉舊的,流量依「準備好的副本數」比例逐漸移過去。新副本的健康檢查一直不過,就自動退回舊版本。
算一次給你看:金絲雀怎麼看數字
推薦模型 v1 的點擊率(推薦的飲料真的被點)是 8%,v2 離線評估說會到 10%。上線用 90/10 流量分割,一天 100 萬次推薦:
v2 分到的流量 = 1,000,000 × 10% = 100,000 次
v2 實際點擊率 7.5% → 7,500 次點擊
v1 的 900,000 次 × 8% = 72,000 次點擊
v2 實際比 v1 差(7.5% < 8%),但只影響了 10 萬次,損失是 100,000 × (8% − 7.5%) = 500 次點擊。如果直接全換,損失是 1,000,000 × 0.5% = 5,000 次。
數字怎麼看:
- 分給新版本的比例越小,風險越小,但要更久才累積到夠多樣本做判斷。10% 一天 10 萬次,統計上已經夠;如果一天只有 1,000 次推薦,10% 只有 100 次,要跑好幾天
- 看的指標要是商業指標(點擊率、轉換率),不是離線的 AUC。這就是 A/B 測試的意義
3. 自動擴展:機器怎麼自己增減
白話是什麼
自動擴展(autoscaling):請求變多就自動加副本,變少就減,你只設上下限。
官方自動擴展文件的規則:
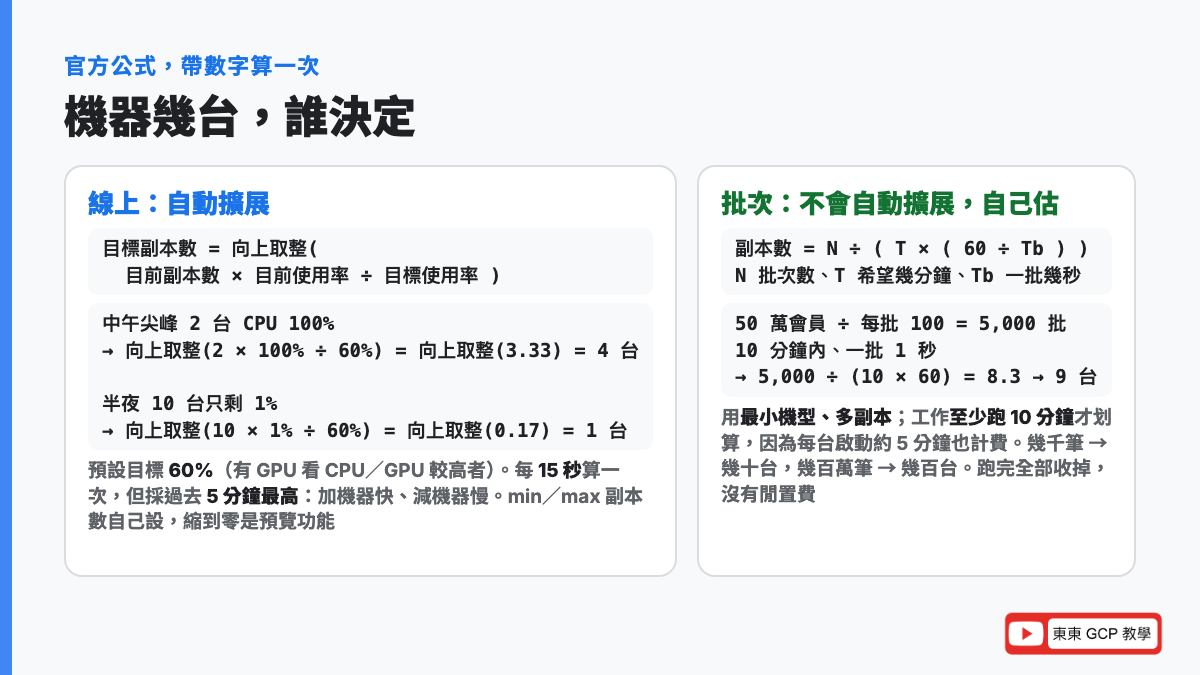
- 預設目標:沒有 GPU 的部署,讓 CPU 使用率維持 60%;有 GPU 的部署,看 CPU 或 GPU 使用率較高的那個維持 60%
- 可以用
autoscalingMetricSpecs改指標和目標,例如 GPU 的accelerator/duty_cycle目標 70% - 設
minReplicaCount(最少幾台)和maxReplicaCount(最多幾台) - 每 15 秒算一次目標副本數,但採用過去 5 分鐘內最高的那個目標。所以突然的尖峰會讓它 15 秒內加機器,但要等尖峰過了 5 分鐘才會減
筆記裡的「自動擴展根據流量/CPU 調整 minReplicaCount」就是這個。
算一次給你看
官方給的公式:
目標副本數 = 向上取整(目前副本數 × 目前使用率 ÷ 目標使用率)向上取整是小數一律進位(3.33 → 4)。
推薦模型現在 2 個副本,中午尖峰 CPU 衝到 100%:
目標 = 向上取整(2 × 100% ÷ 60%)= 向上取整(3.33)= 4 個副本半夜 10 個副本,使用率掉到 1%:
目標 = 向上取整(10 × 1% ÷ 60%)= 向上取整(0.17)= 1 個副本但如果你設了 minReplicaCount = 2,半夜最少還是 2 台。
數字怎麼看:
- 目標使用率設低(例如 40%),機器會多開、反應快但貴;設高(例如 80%),省錢但尖峰時延遲可能飆高
- 新機器開起來要時間(官方說調整副本數之後還有啟動延遲),所以不能把 minReplicaCount 設到剛好,要留餘裕
- 每個副本只跑一個容器,容器如果只用一條執行緒,多核心機器也吃不滿,使用率上不去就不會擴展。官方建議從「一個核心一個 worker」開始調
縮到零(預覽功能)
官方文件有一節「Scale To Zero」,沒流量時副本降到 0,不算錢。目前是預覽階段,用之前要確認你的區域和機型支援。沒有這個功能的話,線上端點最少 1 個副本一直在算錢,這是線上和批次最大的費用差別。
機型怎麼選
官方的運算資源文件:
- 線上推論沒有公式,建議把模型放到幾種機型上實測延遲、成本、併發、吞吐量,有範例筆記本可以跑
- 每個副本會保留約 1 個 vCPU 給系統,所以單核機器等於沒得用
- 大機器可能總成本更低:因為副本數少。GPU 每小時貴,但延遲低、總成本可能反而低
- 推論也支援 Spot VM 和預留,跟訓練一樣(第 16 篇)
- GPU 選項從 T4、L4 到 A100、H100 都有,也支援 TPU 做線上推論
4. 批次推論:不用端點,算完就走
怎麼做
官方批次推論文件:建一個 BatchPredictionJob,指定模型、輸入、輸出、機型、副本數。
輸入格式:
| 格式 | 說明 |
|---|---|
| BigQuery 表 | 直接指定 專案.資料集.表,最適合表格資料。會員流失名單就用這個 |
| JSON Lines | 每行一筆 JSON,放 Cloud Storage |
| TFRecord(第 13 篇) | 放 Cloud Storage,要自己切成多個檔,檔數至少等於副本數 |
| CSV | 可以,但官方不建議用在吞吐量敏感的工作,因為 CSV 不能自動分區 |
| 檔案清單 | 一行一個 Cloud Storage 路徑,給圖片這類資料 |
三個限制:
- 輸入、輸出、模型要在同一個區域(或多區域)
- 批次推論不會自動擴展:資料一開始就知道多少,系統直接切給
starting_replica_count個副本,max_replica_count會被忽略 - BigQuery ML 的模型要先註冊到 Model Registry 才能這樣跑
副本數怎麼算:算一次
官方建議:用最小的機型、靠增加副本數來提高吞吐量(比換大機器更線性、更好預測)。而且工作至少跑 10 分鐘才划算,因為每個副本啟動要約 5 分鐘,這 5 分鐘也算錢。
官方公式:
副本數 = N ÷ (T × (60 ÷ Tb))
N:批次數(筆數 ÷ 每批筆數)
T:希望幾分鐘跑完
Tb:一個副本處理一批要幾秒
飲料店 50 萬名會員,每批 100 筆,希望 10 分鐘內跑完,實測一個副本 1 秒處理一批:
N = 500,000 ÷ 100 = 5,000 批
副本數 = 5,000 ÷ (10 × (60 ÷ 1)) = 5,000 ÷ 600 ≈ 8.3 → 9 個副本數字怎麼看:
- 官方的經驗值:幾千筆 → 副本數幾十;幾百萬筆 → 幾百
- 想 5 分鐘跑完就要 17 個副本,但每個副本啟動就要 5 分鐘,不划算。批次推論不是越快越好,是夠用就好
- 跑完機器就收掉,沒有閒置費用。這就是流失名單用批次的理由:一週跑一次,每次十幾分鐘,其他時間一毛不花
5. 不一定要用 Agent Platform 的端點
考試指南 4.1 列了四個部署的地方:「Agent Platform、Model Garden、Cloud Run、GKE」。
| 地方 | 白話 | 什麼時候 |
|---|---|---|
| Agent Platform 端點 | 這篇講的,全代管的 ML 服務 | 自訂模型、AutoML 模型、要流量分割和監控(第 20 篇) |
| Model Garden | 模型超市,Gemini 和開源模型(Llama、Gemma)一鍵部署 | 用現成的大模型,不自己訓練 |
| Cloud Run | Google 的無伺服器容器平台,現在也有 GPU(L4、RTX PRO 6000),沒流量可以縮到零,約 5 秒啟動 | 輕量的模型服務、自己包的 API、想省閒置費用 |
| GKE | 自己管 Kubernetes 叢集,站上有Kubernetes 是什麼 | 要完全控制、已經有 Kubernetes 團隊、超大規模 |
Cloud Run 的 GPU 規則:一個執行個體一張 GPU,L4 至少要配 4 個 CPU 和 16 GiB 記憶體,不用預留。
在 GCP 上怎麼做
線上推論的流程
- 模型進 Model Registry(匯入、AutoML 自動、BQML 註冊)
- 建端點(選專用公開,或 Private Service Connect)
- 部署:選模型版本、機型、GPU、minReplicaCount/maxReplicaCount、流量比例
- 應用程式對端點網址送
{"instances": [...]},拿到{"predictions": [...]}。專用端點用use_dedicated_endpoint=True - 換版本:加第二個模型到同一端點,調流量比例;或用滾動部署
- 不用了解除部署,不然副本一直算錢
gcloud ai endpoints deploy-model ENDPOINT_ID \
  --region=asia-east1 \
  --model=MODEL_ID \
  --display-name=recsys-v2 \
  --machine-type=n1-standard-4 \
  --min-replica-count=2 \
  --max-replica-count=10 \
  --traffic-split=0=90,DEPLOYED_MODEL_V1_ID=10
批次推論的流程
- 模型在 Model Registry
- 資料整理成 BigQuery 表(或 JSON Lines、TFRecord 放 Cloud Storage),跟模型同區域
- 建 BatchPredictionJob:機型用小的、副本數用公式估
- 結果寫到 BigQuery 表或 Cloud Storage,行銷部門直接查
- 要定期跑,接 Cloud Scheduler 或 Pipelines(第 18、19 篇)
改名對照
| 舊名稱(筆記、舊題庫) | 現在 |
|---|---|
| AI Platform Prediction | 2025 年 4 月關閉 |
| Vertex AI Prediction、Vertex AI Endpoints | Gemini Enterprise Agent Platform Inference |
| Online Prediction、Batch Prediction | Online Inference、Batch Inference(線上推論、批次推論) |
| Custom Prediction Routine(CPR) | Custom Inference Routine,縮寫 CPR 沿用 |
| Vertex AI Model Registry | Gemini Enterprise Agent Platform Model Registry |
| Vertex AI Feature Store(線上特徵服務,第 23 篇) | 舊版(Legacy)2027 年 2 月停用,改用 Feature Store V2 |
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這篇的內容對應到:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 4 區:服務與擴展模型(約 20%) | 4.1 用適當的服務(Agent Platform、Model Garden、Cloud Run、GKE)部署批次和線上推論;用預建和自訂容器打包不同框架的模型;在 Model Registry 組織和版本化模型;推出策略(A/B 測試、金絲雀部署);推論的前處理和後處理。4.2 用 Feature Store 管理特徵;部署到公開和私人端點;選硬體(CPU、GPU、TPU、邊緣);依吞吐量擴展服務後端;調整模型讓訓練和服務更有效率 |
看到這些字,就想到這個
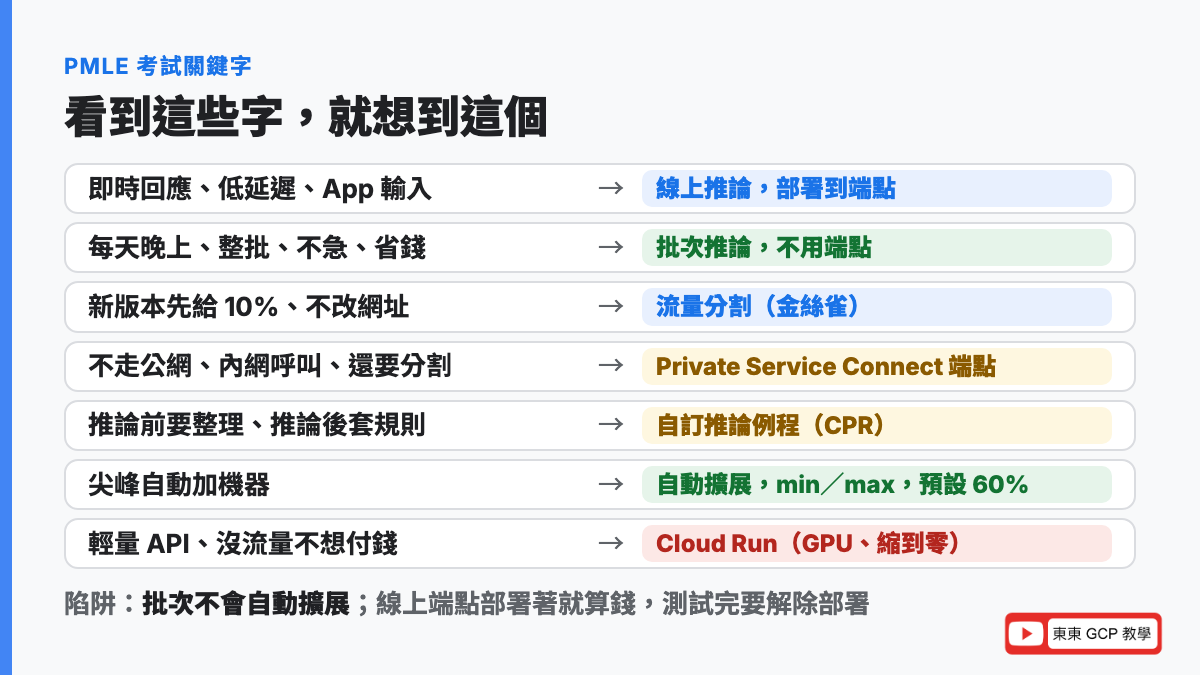
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「即時」「App 回應」「低延遲」「同步」 | 線上推論,部署到端點 |
| 「每天晚上」「整批」「不急」「幾百萬筆」「省錢」 | 批次推論,不用端點 |
| 「新版本逐步切換」「不改應用程式網址」「先給 10%」 | 流量分割(金絲雀) |
| 「比較兩個版本的商業指標」 | A/B 測試,流量分割各 50% |
| 「同一模型換版本、沿用機器、失敗自動退回」 | 滾動部署 |
| 「測試和正式環境分開」「不同 SLO」 | 一個模型部署到多個端點 |
| 「不經過公開網際網路」「內網呼叫」 | Private Service Connect 端點 |
| 「請求超過 1.5 MB」「逾時超過 60 秒」「串流」 | 專用公開端點(不是共用) |
| 「尖峰時自動加機器」 | 自動擴展,設 min/max replica,預設 60% |
| 「推論前要整理資料、推論後要套規則」 | 自訂推論例程(CPR)或自訂容器 |
| 「自訂容器的健康檢查」 | 健康路徑 10 秒內回 200,監聽 AIP_HTTP_PORT |
| 「沒流量時不想付錢的輕量 API」 | Cloud Run(縮到零) |
| 「批次推論副本數」 | 小機型+多副本,至少跑 10 分鐘,公式 N ÷ (T × 60 ÷ Tb) |
| 「批次推論輸入是 CSV 很慢」 | 改 BigQuery 表或 JSON Lines(CSV 不能自動分區) |
| 「模型不在清單裡不能部署」 | 先進 Model Registry |
六個常見陷阱
- 每週跑一次的名單用線上端點:副本 24 小時算錢,批次推論跑十幾分鐘就收掉
- 要即時回應卻選批次:批次是非同步,App 等不到
- 新版本直接全量換:沒有流量分割,出問題全部受影響
- 私人端點(VPC 對等互連)想做流量分割:官方明寫一個私人端點只能一個模型、不支援流量分割;要私人又要分割,用 Private Service Connect 端點
- 批次推論設了 max_replica_count 以為會自動擴展:批次不會,只看 starting_replica_count
- 部署了忘記解除:測試完的端點放著,每個月默默扣錢
練習情境(自己出的練習,不是真實考題)
飲料店的推薦模型要在 App 裡即時顯示,尖峰在中午和晚上,半夜幾乎沒人用。工程師部署了 v2,想先確認不會比 v1 差。應該怎麼做?
判斷過程:
- 「即時」→ 線上推論,專用公開端點
- 「尖峰、半夜沒人」→ 自動擴展,minReplicaCount 設小(例如 1 或 2)、maxReplicaCount 設大
- 「先確認 v2」→ 流量分割,v1 90%、v2 10%,看點擊率,沒問題再加
行銷部門每週一早上要一張「可能流失的會員」名單,50 萬名會員的特徵表在 BigQuery。應該怎麼做?
判斷過程:
- 「每週一次」「整張表」→ 批次推論,不用端點
- 「BigQuery」→ 輸入直接指定 BigQuery 表,輸出也寫 BigQuery
- 副本數用公式估,小機型、跑 10 分鐘左右;接 Cloud Scheduler 每週自動跑
公司的 ERP 系統(在自家機房)要呼叫模型,資安要求不能經過公開網際網路,而且之後要能做新舊版本的流量分割。應該用哪種端點?
判斷過程:
- 「不經過公網」→ 私人的兩種
- 「要流量分割」→ 私人端點(VPC 對等互連)不支援,選 Private Service Connect 專用私人端點
常見問答
模型部署怎麼選線上預測還是批次預測?
看要不要馬上拿到答案。應用程式要即時回應(App 一打開就推薦、客服機器人回話)用線上推論:先把模型部署到端點,機器一直開著,同步回應。一次處理累積的大量資料、不急著要(每週名單、每晚重算分數)用批次推論:不用端點,建一個批次推論工作,臨時開機器算完寫到 BigQuery 或 Cloud Storage,機器收掉。線上端點只要部署著就算錢,批次只付跑的時間。
端點是什麼?有哪幾種?
端點是部署好的模型對外的網址,應用程式把資料送過去就拿到預測。四種:專用公開端點(推薦,10 MB、逾時可到 1 小時、串流、流量隔離)、共用公開端點(1.5 MB、60 秒、每分鐘 30,000 次)、Private Service Connect 專用私人端點(推薦,內網、不走公網、支援流量分割)、私人端點(VPC 對等互連,一個端點只能一個模型、不支援流量分割)。專用公開端點不支援 VPC Service Controls。
流量分割是什麼?怎麼做金絲雀部署?
同一個端點放兩個以上的模型,設定每個接多少比例的請求。金絲雀部署是新版本先接一小部分(例如 10%),看商業指標沒問題再逐步加到 100%,應用程式不用改網址。A/B 測試則是兩版各接一半,比較哪個指標好。要換同一個模型的新版本、沿用原本機器,可以用滾動部署(預覽),健康檢查失敗會自動退回。
自動擴展怎麼運作?
你設最少和最多副本數,Agent Platform 依使用率自動增減。預設目標是 CPU 使用率 60%,有 GPU 則看 CPU 或 GPU 較高者;可以改成 GPU duty cycle 之類的指標和目標。每 15 秒用公式「向上取整(目前副本數 × 目前使用率 ÷ 目標使用率)」算目標,但採用過去 5 分鐘內最高的目標,所以加機器快、減機器慢。縮到零目前是預覽功能。批次推論不會自動擴展。
批次推論的副本數要設多少?
官方建議用最小的機型、靠增加副本數提高吞吐量,而且工作至少跑 10 分鐘才划算,因為每個副本啟動約 5 分鐘也計費。公式是副本數 = 批次數 ÷(希望的分鐘數 × 60 ÷ 一個副本處理一批的秒數)。例如 50 萬筆、每批 100 筆、10 分鐘、每批 1 秒,算出約 9 個副本。幾千筆大約幾十個副本,幾百萬筆大約幾百個。
自訂推論例程(CPR)是什麼?
介於預建容器和自訂容器之間:你只寫前處理和後處理的 Python 程式(實作 Predictor 介面,需要時再加 Handler),HTTP 伺服器和 Dockerfile 由 Agent Platform SDK 幫你產生,還能先在本機部署測試。前處理像把輸入標準化、呼叫外部服務補資料,後處理像把模型輸出轉成業務格式或套商業規則。考試指南 4.1 的「推論前處理和後處理」就是指這個。
自訂推論容器有什麼要求?
要自己跑一個 HTTP 伺服器,監聽 AIP_HTTP_PORT 環境變數指定的埠;提供健康檢查路徑,10 秒內回 200 才算健康,否則會被視為不健康;提供推論路徑,請求格式是 {“instances”: […]},回應是 {“predictions”: […]}。映像檔要放在 Artifact Registry。
一定要用 Vertex AI 的端點嗎?
不一定。考試指南列了四個地方:Agent Platform 端點(全代管、有流量分割和監控)、Model Garden(Gemini 和開源模型一鍵部署)、Cloud Run(無伺服器容器,有 L4 和 RTX PRO 6000 GPU,沒流量可縮到零,適合輕量服務)、GKE(自己管 Kubernetes,要完全控制或超大規模)。輕量 API 想省閒置費用,Cloud Run 常是更便宜的選擇。
部署後哪些設定可以改?
官方說部署時決定的區域、容器、運算資源部署後不能改,要改就重新部署。例外是擴展設定:最少副本數、最多副本數、必要副本數和擴展指標可以用 mutateDeployedModel 直接改,不用重新部署;機型不能改。
Vertex AI Endpoints 改名了嗎?
是。Vertex AI 在 2026 年 4 月改名為 Gemini Enterprise Agent Platform,Vertex AI Prediction 和 Endpoints 現在叫 Agent Platform Inference,Online Prediction 和 Batch Prediction 改稱 Online Inference 和 Batch Inference,Model Registry 改叫 Agent Platform Model Registry。更早的 AI Platform Prediction 已在 2025 年 4 月 7 日關閉,所有模型和部署都已刪除。
重點整理
- 兩種推論:線上(同步、先部署到端點、低延遲、機器一直算錢)vs 批次(非同步、不用端點、處理累積資料、跑完收機器)
- 部署的三件事:端點決定區域、模型決定容器、DeployedModel 決定機器;部署後只有擴展設定能改
- 端點四種:專用公開(推薦)、共用公開(1.5 MB、60 秒)、Private Service Connect(推薦,內網)、私人(VPC 對等互連,不能流量分割)
- 流量分割:同一端點多模型;金絲雀 90/10 逐步加,A/B 各 50;一模型多端點分測試/正式;滾動部署換版本沿用機器
- 自動擴展:預設 60%,目標副本 = 向上取整(目前 × 使用率 ÷ 目標);每 15 秒看 5 分鐘最高;批次不自動擴展
- 批次副本數:小機型多副本、至少跑 10 分鐘;N ÷ (T × 60 ÷ Tb)
- 容器:預建、自訂(AIP_HTTP_PORT、健康檢查 10 秒)、CPR 只寫前後處理
- 別的地方:Model Garden、Cloud Run(GPU、縮到零)、GKE;Vertex AI Prediction 現在叫 Agent Platform Inference
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 第 3 篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切
- 第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
- 第 6 篇:ROC 曲線和 AUC 怎麼看?門檻怎麼調、AUC-PR 差在哪
- 第 7 篇:過度擬合是什麼?正則化、Dropout、提前停止 3 招解決
- 第 8 篇:資料洩漏是什麼?模型考試作弊的 3 種常見情況
- 第 9 篇:類別不平衡怎麼辦?過取樣、欠取樣與 Upweighting
- 第 10 篇:資料前處理怎麼做?標準化、遺失值、高基數類別
- 第 11 篇:特徵工程是什麼?特徵交叉、詞嵌入、資料增強一次看懂
- 第 12 篇:機器學習的資料隱私怎麼保護?DLP、聯邦學習、VPC Service Controls
- 第 13 篇:訓練資料讀太慢?TFRecords、tf.data 與 prefetch 加速
- 第 14 篇:Vertex AI AutoML、BigQuery ML、自訂訓練怎麼選?
- 第 15 篇:BigQuery ML 入門:只會 SQL 也能訓練模型
- 上一篇:第 16 篇:Vertex AI 自訂訓練:容器、分散式訓練、GPU 與 TPU
- 下一篇:第 18 篇:MLOps 是什麼?Vertex AI Pipelines、Kubeflow、TFX 介紹
站上相關文章
- 容器技術是什麼?從零開始看懂 Docker 與容器化應用
- Kubernetes 是什麼?白話解釋+判斷你是否真的需要它
- Vertex AI 核心功能 Agent Builder、Model Builder 和 Model Garden 介紹
- GCP Cloud Armor 完整教學
- GCP 帳單爆炸防護指南
模型上線的方式選對,帳單和使用者體驗才會都好看。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。