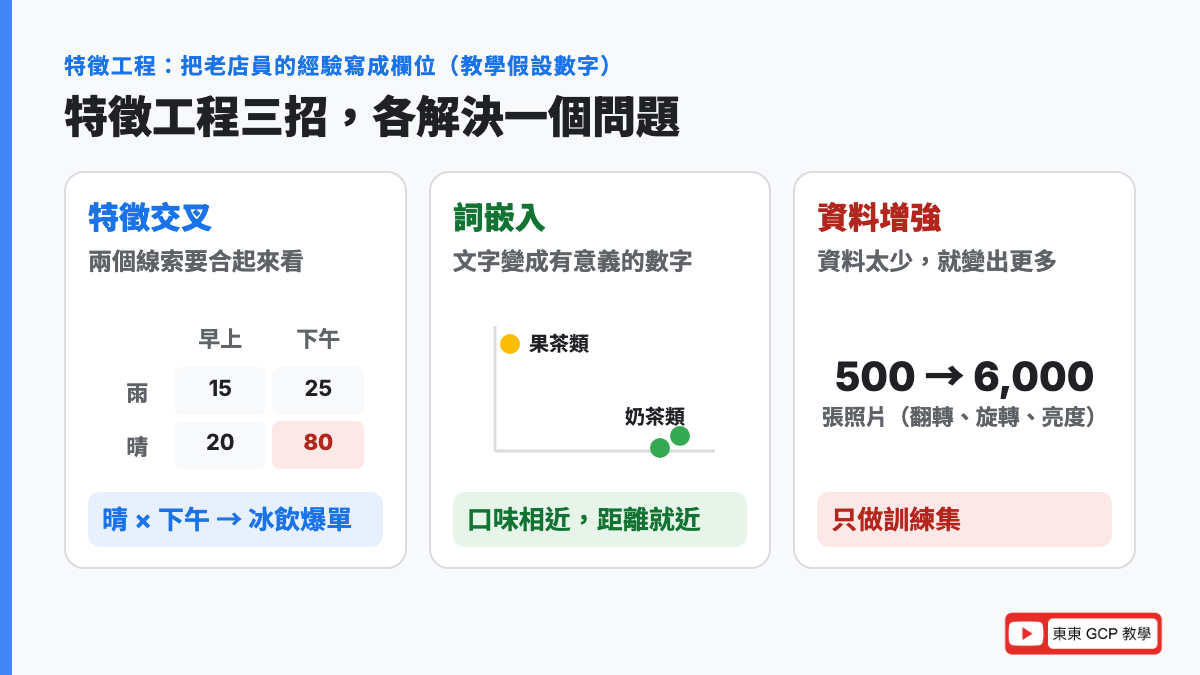
特徵工程是什麼?就是把原始資料加工成更好用的線索:把特徵組合起來、把文字變成有意義的數字、把少量資料變多。
上一篇把資料洗乾淨、切好,這篇要教你怎麼「加工」。一樣用有 2,000 間分店的連鎖飲料店當例子,一次處理三個任務:
- 預測每小時會賣幾杯冰飲 → 特徵交叉
- 客人打「想喝有奶味的」,就找到口味相近的飲料 → 詞嵌入
- 拍照辨識是哪一款飲料,但照片很少 → 資料增強
為什麼你需要知道
- 特徵做得好,比模型選得好更重要:第 3 篇說過,模型是靠特徵(線索)在判斷。線索給得好,簡單的模型也能很準
- 簡單的模型學不會「組合效果」:「晴天的下午冰飲會爆單」這種要兩個條件一起看的規律,很多模型自己看不出來
- 文字和圖片不能直接丟給模型:模型只看得懂數字,文字要變成「有意義的數字」,圖片太少還要想辦法變多
- 證照必考:PMLE 考試指南第 1 區明列「用 BigQuery ML 做特徵工程」,第 2 區要你會處理表格、文字、圖片等不同資料,還有在 Feature Store 建立和整合特徵
先搞懂:特徵工程是什麼?
白話是什麼
特徵工程(Feature Engineering):用你對問題的了解,把原始資料加工、組合成新的特徵,讓模型更容易看出規律。
比喻
把老店員的經驗,寫成模型看得到的欄位。
做了十年的店員知道「晴天的下午,冰飲會爆單」。但資料表裡只有「天氣」「時段」兩欄,模型不一定知道這兩欄要合起來看。你幫它多做一欄「晴天下午」,它一下就學會了。
來龍去脈
「工程」兩個字,意思是像蓋房子一樣有方法地打造。早期的機器學習模型能力有限,準不準很大一部分看人幫它做了哪些特徵,所以「做特徵」變成一門專門的功夫。
後來的神經網路(模仿人腦神經元連結、一層一層計算的模型)可以自己找出一部分特徵組合。Google 速成課程也說,神經網路能在訓練時自動找到有用的組合,只是比較花運算資源。
所以特徵工程沒有消失,只是分工變了。站上 End-to-end Training 那篇講的,就是「讓模型自己學特徵」的做法。
跟資料前處理差在哪
| 資料前處理(第 10 篇) | 特徵工程(這篇) | |
|---|---|---|
| 比喻 | 洗菜、切菜 | 配菜、調味 |
| 在做什麼 | 把資料清乾淨、轉成數字、調到適合的大小 | 用原本的資料做出新的線索 |
| 例子 | 縮放、補遺失值、One-hot | 特徵交叉、嵌入、資料增強 |
兩者的界線不是很硬。Google 速成課程把「分桶」也算成特徵工程;嵌入在上一篇是「類別太多」的解法,在這篇是「讓相近的東西靠在一起」的方法。
記住大方向就好:前處理讓資料能用,特徵工程讓資料好用。
1. 特徵交叉(Feature Cross):把兩個線索合起來看
白話是什麼
特徵交叉:把兩個(或更多)類別特徵組合成一個新特徵,每一種組合都是一個新的類別。例如「天氣 × 時段」,就變成「晴_下午」「雨_早上」這樣的組合。
比喻
像一張棋盤:橫的一排是天氣,直的一排是時段,每個交叉點是一格。
模型可以為每一格各記一個數字,不用只記「晴天加幾分」「下午加幾分」。
來龍去脈
「交叉」就是棋盤的意思:兩張清單一橫一直排開,每個交叉點是一種組合,數學上叫笛卡兒積(Cartesian product)。
Google 速成課程說,特徵交叉是為了讓線性模型也能處理「要組合起來才看得出來」的規律。
線性模型就是第 2 篇線性迴歸那一類:每個特徵配一個權重(代表這個特徵有多重要的分數),乘一乘再加起來。它簡單、快、好解釋,但只會加法。
算一次給你看:為什麼加法不夠用
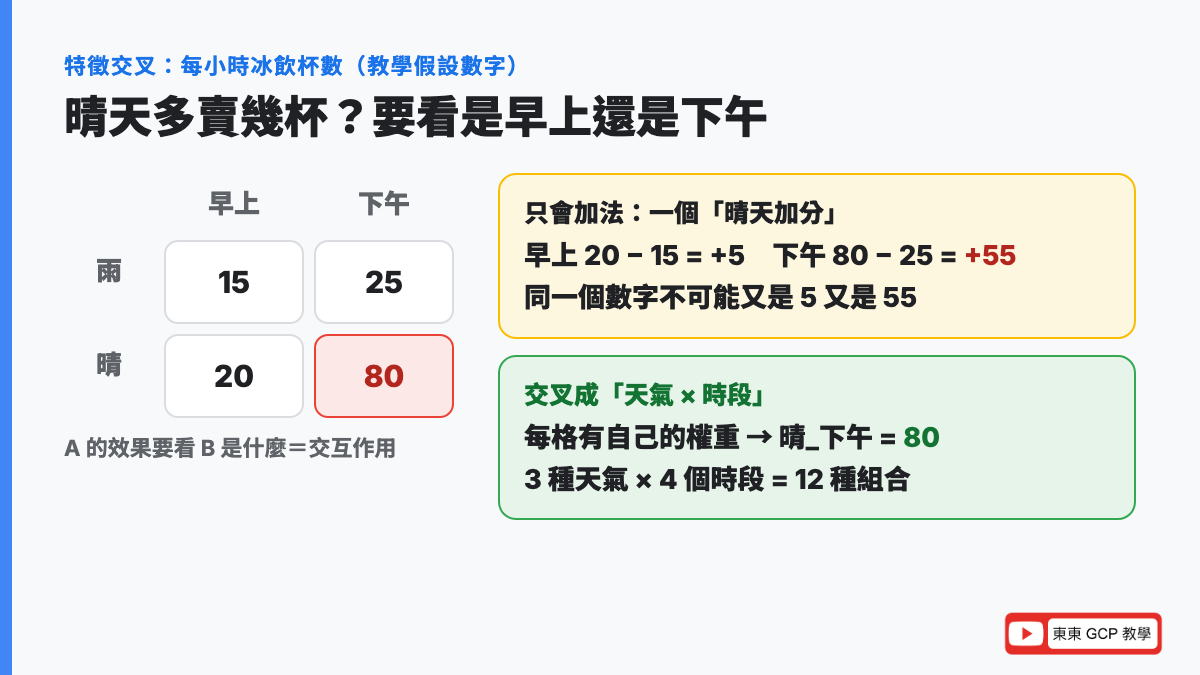
假設(教學用的數字)某間分店每小時平均賣出的冰飲杯數:
| 早上 | 下午 | |
|---|---|---|
| 雨天 | 15 杯 | 25 杯 |
| 晴天 | 20 杯 | 80 杯 |
模型如果只有「天氣」「時段」兩個特徵,它要學一個數字叫「晴天多賣幾杯」。問題來了:
晴天多賣幾杯?
早上:20 − 15 = 5 杯
下午:80 − 25 = 55 杯
同一個「晴天加分」,不可能同時是 5 又是 55。這種「A 的效果要看 B 是什麼」的情況,叫做交互作用(Interaction)。
只會加法的模型學不到交互作用。硬要用加法,算出來最好的折衷是四格都猜錯 12.5 杯。
加上特徵交叉「天氣 × 時段」之後,四種組合各有自己的權重:
| 組合 | 模型可以直接學到 |
|---|---|
| 雨_早上 | 15 杯 |
| 雨_下午 | 25 杯 |
| 晴_早上 | 20 杯 |
| 晴_下午 | 80 杯 |
四格全部對上。老店員的經驗「晴天下午冰飲爆單」,就這樣被寫成了一個特徵。
組合有幾種?兩邊相乘
天氣 3 種(晴、陰、雨)× 時段 4 種(早上、中午、下午、晚上)= 12 種組合用第 10 篇的 One-hot 表示,就是 12 個 0 或 1 的欄位。例如「雨_下午」那一欄是 1,其他 11 欄都是 0。
經緯度也能交叉:先分桶,再交叉
分店的位置是經度、緯度兩個數字。直接丟給模型,它只能學到「越往東生意越好」這種一直線的關係。但商圈是一塊一塊的,熱鬧的商圈旁邊可能就是安靜的住宅區。
解法分兩步:
- 分桶(Binning,也叫 Bucketing):把連續的數字切成幾段,每一段變成一個類別。比喻:把年齡切成「學生、上班族、退休族」來看。Google 速成課程說,數字跟答案沒有一直線的關係、或數字一團一團聚在一起時,分桶很好用
- 交叉:經度切 4 段 × 緯度切 4 段 = 16 格,就像把地圖畫成 4 × 4 的棋盤,每一格(大約一個街區)學自己的權重
只分桶、不交叉,模型學到的是一條條直的長條(某個經度範圍)和橫的長條(某個緯度範圍)。交叉之後,才是一格一格的街區。
小心:交叉太多會「稀疏」
稀疏(Sparse)白話是「一大張表,幾乎都是 0」。速成課程提醒:一個有 100 種值的特徵,交叉一個有 200 種值的特徵,會變成 20,000 種組合。
換成飲料店(教學用的數字):
會員 10 萬人 × 飲料 50 款 = 5,000,000 種組合大部分會員只點過三、四款,500 萬格裡絕大多數永遠不會出現。資料這麼少,模型很難學到東西,反而容易過度擬合(第 7 篇)。
常見的處理方式:
- 只交叉有道理的組合:靠領域知識(老店員的經驗)挑
- 交叉後再雜湊分桶:像第 10 篇的雜湊,把組合丟進固定數量的桶子。TensorFlow 的
HashedCrossing就是這樣做 - 改用嵌入或神經網路:讓模型自己學組合(下一段就講嵌入)
數字的版本:多項式轉換
特徵交叉處理的是類別。如果是數字,對應的做法叫多項式轉換(Polynomial Transform),例如把氣溫平方,或把「氣溫 × 濕度」做成新特徵。
比喻:悶不悶熱,要看氣溫和濕度一起。速成課程說,這讓線性模型也能畫出曲線,不只是直線。
為什麼要學
特徵交叉是「用簡單模型做出聰明效果」的經典招式。PMLE 題目裡出現「線性模型學不到兩個特徵的組合效果」「經緯度」這類情境,答案常常就是它。
2. 詞嵌入(Word Embedding):讓意思相近的詞靠在一起
先看問題:One-hot 看不出誰跟誰像
上一篇說,類別要用 One-hot 轉成數字。假設菜單只有三款飲料:
| 飲料 | One-hot |
|---|---|
| 珍珠奶茶 | (1, 0, 0) |
| 鮮奶茶 | (0, 1, 0) |
| 檸檬綠茶 | (0, 0, 1) |
算任兩杯的「距離」(公式下面會講),結果全部一樣:
珍奶 ↔ 鮮奶茶:√(1² + 1²) = √2 ≈ 1.41
珍奶 ↔ 檸檬綠:√(1² + 1²) = √2 ≈ 1.41
在 One-hot 眼裡,珍奶跟鮮奶茶的差別,和珍奶跟檸檬綠茶一樣大。但喝過的人都知道,前兩杯像多了。
Google 速成課程的例子是 5,000 道菜:One-hot 讓每道菜都變成一串 5,000 個數字,又長、又看不出熱狗和沙威瑪比較像,模型要學的權重也跟著暴增。
白話是什麼
嵌入(Embedding):用一小串數字來描述一個東西,意思相近的東西,數字也相近。對「詞」做這件事,就叫詞嵌入。
這一小串數字叫向量(Vector),白話就是「一串排好順序的數字」,像地圖上的座標 (x, y)。串裡有幾個數字,就叫幾個維度(Dimension)。
比喻
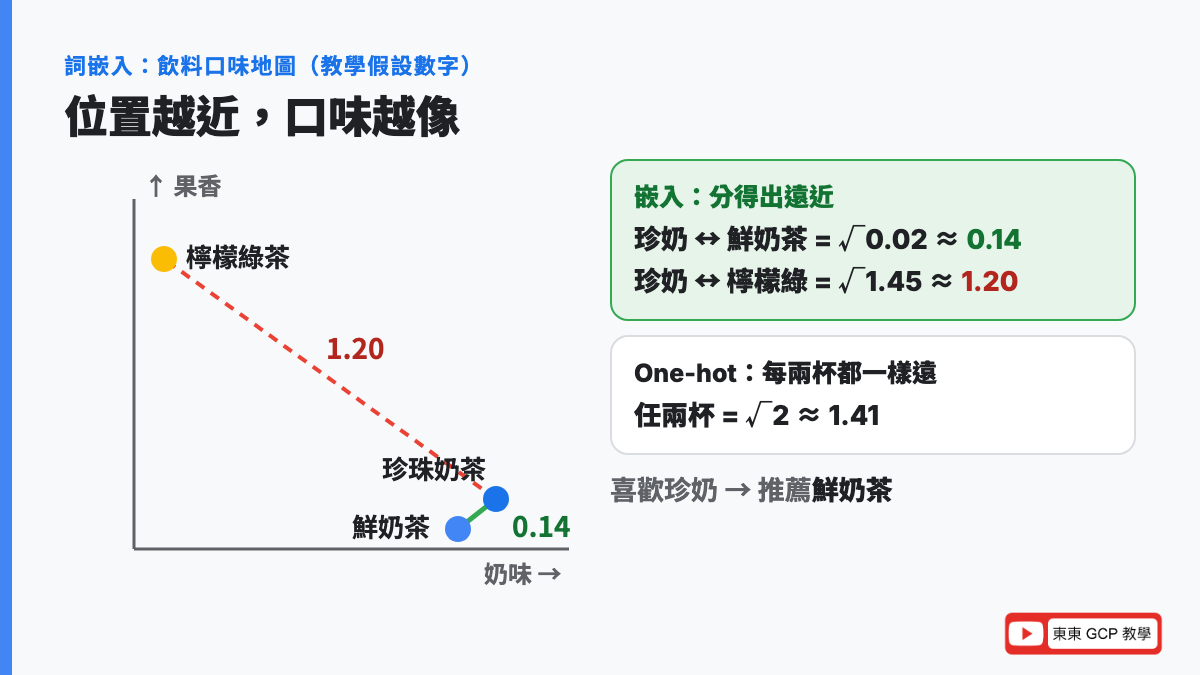
像一張飲料口味地圖。橫軸是「奶味」、直軸是「果香」,每杯飲料在地圖上都有一個位置(教學用的數字):
| 飲料 | 奶味 | 果香 | 座標(嵌入向量) |
|---|---|---|---|
| 珍珠奶茶 | 0.9 | 0.1 | (0.9, 0.1) |
| 鮮奶茶 | 0.8 | 0.0 | (0.8, 0.0) |
| 檸檬綠茶 | 0.0 | 0.9 | (0.0, 0.9) |
奶茶類會擠在右下角,果茶類在左上角。位置越近,口味越像。
來龍去脈
「嵌入」的英文 embed 是「鑲進去」的意思:把每個詞鑲進一張地圖裡,給它一個座標。
最有名的早期做法,是 2013 年 Google 研究人員提出的 word2vec(word to vector,把詞變成向量)。想法很直覺:出現在相似句子裡的詞,意思也相近。
速成課程的例子:「他們騎著驢子走進峽谷」「他們騎著馬走進峽谷」,驢子和馬出現在一樣的位置,所以它們的座標會靠在一起。
算一次給你看 1:哪杯跟珍奶最像?
兩點之間的距離,用國中學過的畢氏定理算,這叫歐氏距離(Euclidean distance):
距離 = √[(奶味差)² + (果香差)²]

珍奶 ↔ 鮮奶茶 = √[(0.9 − 0.8)² + (0.1 − 0.0)²]
             = √(0.01 + 0.01) = √0.02 ≈ 0.14

珍奶 ↔ 檸檬綠 = √[(0.9 − 0.0)² + (0.1 − 0.9)²]
             = √(0.81 + 0.64) = √1.45 ≈ 1.20
算一次給你看 2:餘弦相似度
另一種常見的量法叫餘弦相似度(Cosine similarity),看兩個向量指的方向像不像,跟距離遠近無關:
餘弦相似度 = (A₁ × B₁ + A₂ × B₂) ÷ (A 的長度 × B 的長度)
長度 = 這個點離原點 (0, 0) 多遠

珍奶的長度 = √(0.9² + 0.1²) = √0.82 ≈ 0.906
鮮奶茶的長度 = √(0.8² + 0²) = 0.8

珍奶 vs 鮮奶茶 = (0.9 × 0.8 + 0.1 × 0) ÷ (0.906 × 0.8)
              = 0.72 ÷ 0.725 ≈ 0.99

珍奶 vs 檸檬綠 = (0.9 × 0 + 0.1 × 0.9) ÷ (0.906 × 0.9)
              = 0.09 ÷ 0.815 ≈ 0.11
數字怎麼看
- 距離:越小越像,0 代表一模一樣。0.14 比 1.20 小很多,所以喜歡珍奶的客人,該推薦鮮奶茶,不是檸檬綠茶
- 餘弦相似度:越接近 1 越像,接近 0 代表沒什麼關係。珍奶和鮮奶茶 0.99,和檸檬綠只有 0.11,結論一樣
- 跟 One-hot 比:One-hot 每兩杯都是 1.41,分不出遠近;嵌入分得出來,這就是它的價值
真實世界的嵌入長什麼樣子
- 維度很多:速成課程說,詞嵌入常見 256、512、1,024 維。Google 現在的
gemini-embedding-001模型預設是 3,072 維 - 每一維看不懂:真實模型學出來的維度,很少像「奶味」「果香」這麼好懂。但「相近的東西靠在一起」這件事一樣成立
- 跟任務有關:速成課程舉例,「早餐麥片」和「早餐香腸」在「依時段推薦菜色」的模型裡很近,在「葷素分類」的模型裡就很遠
嵌入從哪裡來?
| 做法 | 白話 | 適合 |
|---|---|---|
| 自己訓練 | 在神經網路裡放一層嵌入層,訓練時順便學出每個東西的座標 | 自己的分店、會員、商品編號(第 10 篇的高基數類別) |
| 用現成的 | 直接用大公司拿海量資料訓練好的模型來轉 | 文字、圖片,例如顧客評論 |
新舊說法:word2vec 現在還用嗎?
word2vec 是「靜態嵌入」,現在主流是會看前後文的「情境嵌入」。
速成課程說,word2vec 已經大多被其他模型取代,但拿來理解概念還是很好用。它的限制是每個詞只有一個座標:「蘋果」不管出現在「蘋果牛奶」還是「蘋果手機」,座標都一樣。情境嵌入(Contextual embedding)會看前後文,同一個詞在不同句子裡給不同的座標。BERT、Transformer 都是這類做法(Transformer 是現在大型語言模型的基本架構)。現在的文字嵌入模型,例如 Google Cloud 上的 Gemini 嵌入模型,是把整段文字一起轉成一串數字。
嵌入可以拿來做什麼
依照 BigQuery 官方文件,常見的用途:
- 語意搜尋:客人打「不要太甜、有奶味」,找出意思最接近的飲料,就算字面上完全不一樣
- 推薦:找出跟這杯最像的其他飲料
- 分類、分群:把評論分成正評負評、把相似的評論放在一起
- 找異常:找出跟其他都不像的那一筆
生成式 AI 常說的 RAG(Retrieval-Augmented Generation,檢索增強生成)也是建在嵌入上:先用嵌入找出跟問題最相關的資料,再交給 Gemini 這類模型寫出答案。
為什麼要學
文字、圖片這類資料,幾乎都要先變成嵌入才能進模型;高基數類別也常用嵌入處理。現在的生成式 AI 應用,背後也幾乎都有「嵌入+找相似」這一步。
3. 資料增強(Data Augmentation):照片太少,就變出更多
白話是什麼
資料增強:把現有的訓練資料做一些合理的小變化,例如翻轉、旋轉、調亮度,變出更多「長得不太一樣、但答案一樣」的訓練資料。
比喻
像認朋友:同一個朋友,戴帽子、側臉、在昏暗的餐廳裡,你都要認得出來。如果你只看過對方一張正面大頭照,換個角度可能就認不出來了。
資料增強就是幫模型多看幾種角度和光線。
來龍去脈
「增強」(augment)是「擴充、加量」的意思。TensorFlow 官方教學的定義:用隨機、但合理的變化(例如旋轉圖片),增加訓練資料的多樣性。
會需要它,是因為拍照、標註都很花錢。資料太少,模型就會把那幾張照片背起來,換一張新照片就認不得,這就是第 7 篇的過度擬合。用程式「變」出新照片,幾乎不用成本。
算一次給你看
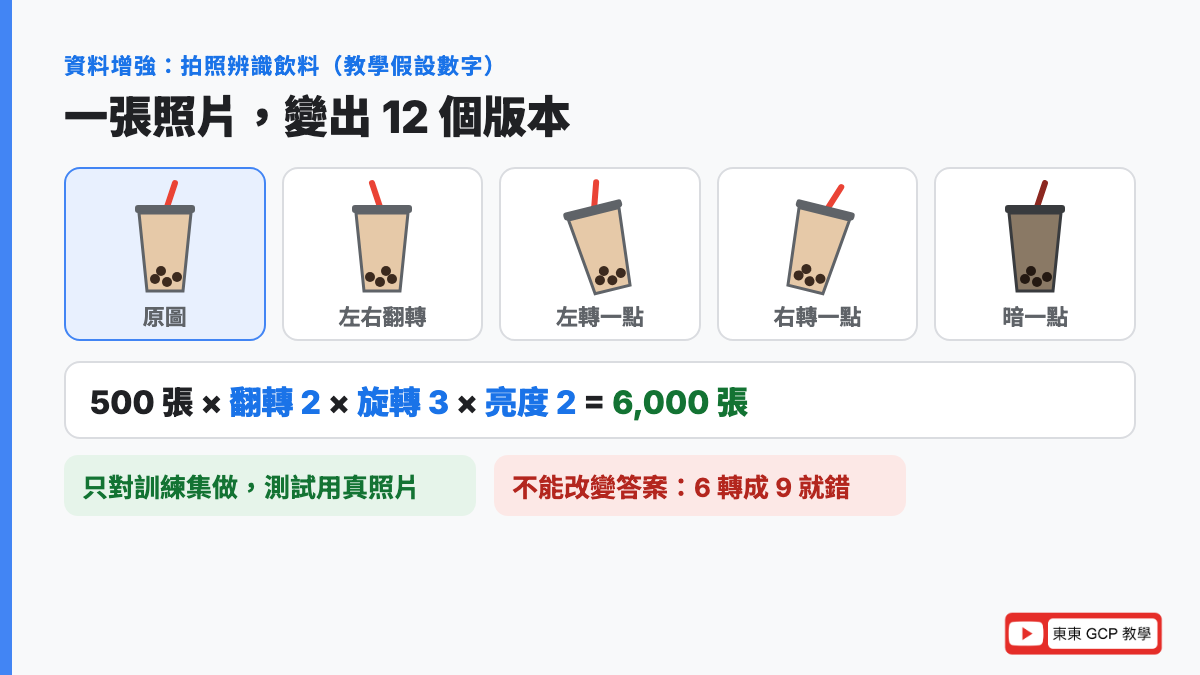
假設(教學用的數字)飲料店想做「拍照辨識是哪一款飲料」的模型,有 10 款飲料,每款只拍了 50 張:
原始照片:10 款 × 50 張 = 500 張每張照片做三種變化:
左右翻轉:不翻、翻 → 2 種
旋轉:左轉一點、不轉、右轉一點 → 3 種
亮度:原本、暗一點 → 2 種

每張可以變出:2 × 3 × 2 = 12 個版本
總共:500 × 12 = 6,000 張實際上變化是隨機的。模型每看完一輪全部的照片(叫一個回合,Epoch),下一輪拿到的又是隨機變過的新版本,所以看到的樣子比 6,000 種還多。
兩條一定要守的規則
- 只對訓練集做。TensorFlow 教學明寫:資料增強只應該用在訓練集。驗證集、測試集要用真實的照片打分數,否則分數會灌水,跟第 8 篇的資料洩漏是同一類問題
- 變化不能改變答案。左右翻轉一杯珍奶,還是珍奶;但亮度調太亮,紅茶看起來像奶茶,答案就被改掉了。同理,辨識數字的模型不能把 6 轉 180 度,那會變成 9
筆記說的「放進 tf.data 管道」是什麼意思
先認識幾個名詞:
- TensorFlow:Google 開發的機器學習程式工具包。Keras 是它裡面比較好上手的一層,用來組模型
- tf.data:TensorFlow 讀資料、整理資料的流水線,資料一批一批從硬碟讀出來、整理好,送去給模型
- CPU、GPU:CPU 是電腦的一般大腦,什麼都能做;GPU 是顯示卡上的晶片,特別擅長同時做大量計算,訓練模型主要靠它
TensorFlow 教學列了兩種放資料增強的位置:
| 做法 A:放進模型裡 | 做法 B:放進 tf.data 流水線 | |
|---|---|---|
| 在哪裡算 | GPU,跟模型一起算 | CPU,跟 GPU 訓練同時進行 |
| 存模型時 | 增強層會跟著存下來 | 不會跟著模型存下來 |
| 預測時 | 自動停用,不會亂變 | 本來就只套在訓練資料上 |
| 適合 | 想簡單、部署時前處理跟著模型走 | 不想讓 GPU 閒著等資料 |
部署是把訓練好的模型放上線給大家用。做法 A 的好處是:上線時不用在伺服器(負責接收照片、回傳預測結果的那台電腦)另外寫一份前處理程式。
做法 B 的寫法(教學用的範例):
import tensorflow as tf
from tensorflow.keras import layers

data_augmentation = tf.keras.Sequential([
    layers.RandomFlip("horizontal"),   # 隨機左右翻轉
    layers.RandomRotation(0.05),       # 隨機旋轉,最多 0.05 × 360 = 18 度
    layers.RandomBrightness(0.2),      # 隨機調亮或調暗一點
])

# 只對訓練集做增強,再預先準備下一批
train_ds = train_ds.map(lambda x, y: (data_augmentation(x, training=True), y))
train_ds = train_ds.prefetch(tf.data.AUTOTUNE)
逐行翻成白話:
RandomFlip、RandomRotation、RandomBrightness:三種隨機變化,對應上面算的翻轉、旋轉、亮度train_ds.map(...):把訓練集的每一批照片,都丟進增強流水線;training=True是告訴它「現在在訓練,要隨機變」prefetch(預先準備):CPU 做增強的同時,GPU 繼續訓練上一批,誰都不用等誰。讀資料加速第 13 篇會細講
為什麼要學
圖片、聲音這類資料,最常遇到的就是「資料太少、過度擬合」。PMLE 題目看到「圖片很少」「訓練分數很高、驗證分數很低」,資料增強是很常見的答案。
三招一張表比完
| 特徵交叉 | 詞嵌入 | 資料增強 | |
|---|---|---|---|
| 解決什麼 | 兩個特徵要合起來看 | 類別、文字看不出遠近 | 資料太少、過度擬合 |
| 常用在 | 表格資料、線性模型 | 文字、高基數類別 | 圖片、聲音 |
| 一句話比喻 | 棋盤格 | 口味地圖 | 認朋友的各種角度 |
| 要小心 | 組合太多會稀疏 | 嵌入跟任務有關 | 只做訓練集、不能改答案 |
在 GCP 上怎麼做
GCP(Google Cloud Platform) 是 Google 的雲端服務,白話說就是租用 Google 機房裡的電腦和工具。
1. BigQuery ML:用 SQL 做特徵交叉
- BigQuery:Google 的大型資料倉庫,專門存放和分析超大量的表格資料
- BigQuery ML:讓你用 SQL(跟資料庫說話的語言)直接在 BigQuery 裡訓練模型
依照手動前處理的官方文件,BigQuery ML 有現成的特徵工程函數:
| 函數 | 做什麼 |
|---|---|
ML.FEATURE_CROSS | 特徵交叉(類別),最多 10 個特徵 |
ML.BUCKETIZE | 依你給的切點分桶 |
ML.QUANTILE_BUCKETIZE | 分桶,讓每一桶的筆數差不多 |
ML.POLYNOMIAL_EXPAND | 多項式轉換(數字) |
把這篇的冰飲例子寫進 TRANSFORM(教學用的範例):
CREATE MODEL `shop.iced_cups_fe`
TRANSFORM(
  ML.FEATURE_CROSS(STRUCT(weather, time_slot)) AS weather_x_slot,  -- 天氣 × 時段
  ML.FEATURE_CROSS(STRUCT(
    ML.BUCKETIZE(longitude, [121.50, 121.55, 121.60]) AS lon,
    ML.BUCKETIZE(latitude, [25.00, 25.05, 25.10]) AS lat
  )) AS area,                                                       -- 經緯度切成 16 格
  weather,
  time_slot,
  iced_cups)
OPTIONS(model_type='LINEAR_REG',
        input_label_cols=['iced_cups']) AS
SELECT weather, time_slot, longitude, latitude, iced_cups
FROM `shop.hourly_sales_train`;
逐行翻成白話:
ML.FEATURE_CROSS(STRUCT(weather, time_slot)):STRUCT是把幾個欄位包成一組,這裡把天氣和時段包起來交叉,結果像「晴_下午」ML.BUCKETIZE(longitude, [121.50, 121.55, 121.60]):經度用 3 個切點切成 4 段;緯度也一樣- 外面再包一層
ML.FEATURE_CROSS:4 段 × 4 段 = 16 格街區 - 原本的
weather、time_slot也留著:模型同時有「單看天氣」和「組合起來看」兩種線索 model_type='LINEAR_REG':用線性迴歸,就是前面說「只會加法」的那種模型,所以才特別需要特徵交叉- 寫在
TRANSFORM裡,上線預測時會自動用同樣的方式交叉和分桶,不會前後不一致(第 10 篇講過)
2. BigQuery:用 SQL 把顧客評論變成嵌入
-- 步驟 1:建一個遠端模型,指到 Agent Platform 上的嵌入模型
CREATE OR REPLACE MODEL `shop.embedding_model`
  REMOTE WITH CONNECTION `us.my_connection`
  OPTIONS(ENDPOINT = 'gemini-embedding-001');

-- 步驟 2:把每則評論轉成一串數字
SELECT *
FROM AI.GENERATE_EMBEDDING(
  MODEL `shop.embedding_model`,
  (SELECT review_id, review_text AS content FROM `shop.reviews`));
逐行翻成白話:
- 遠端模型(Remote model):BigQuery 裡的一個「捷徑」,真正的計算交給 Agent Platform 上的嵌入模型
- 連線(Connection):讓 BigQuery 有權限去呼叫其他服務的通行證
AI.GENERATE_EMBEDDING:把content欄位的文字轉成嵌入,結果放在embedding欄位- 要找最像的評論或飲料,可以接著用
VECTOR_SEARCH(向量搜尋,預設就是用上面算過的歐氏距離);只比少數幾筆,可以用AI.SIMILARITY(餘弦相似度)
評論是中文,要選支援多語言的模型。 依照官方文件,gemini-embedding-001 支援多語言,text-embedding-005 專攻英文和程式碼。
舊文章可能看到
ML.GENERATE_TEXT_EMBEDDING或ML.GENERATE_EMBEDDING。
官方文件現在建議新的查詢改用AI.GENERATE_EMBEDDING,功能一樣、輸出的欄位名稱比較簡單。舊教材常見的 textembedding-gecko 模型,官方文件已提醒之後可能停用;現在 Agent Platform 列出的 Google 文字嵌入模型是gemini-embedding-001和gemini-embedding-2。
3. Agent Platform:自己寫程式訓練
需要自訂模型時,在 Google 的機器學習平台上寫 TensorFlow/Keras 程式。這個平台最近改名了:
舊題庫可能還會看到 Vertex AI,現在叫 Gemini Enterprise Agent Platform(簡稱 Agent Platform)。
Google Cloud 在 2026 年 4 月 22 日正式改名(官方對照表),2026 年 6 月 1 日起的 PMLE 考試指南也全面用新名稱。
| 舊名稱(舊題庫常見) | 現在的名稱 | 跟這篇的關係 |
|---|---|---|
| Vertex AI | Gemini Enterprise Agent Platform | 整個平台 |
| Vertex AI Workbench | Gemini Enterprise Agent Platform Workbench | 網頁版的程式筆記本,試做特徵 |
| Vertex AI Training | Gemini Enterprise Agent Platform Managed Training | 跑自訂訓練 |
| Vertex AI Feature Store | Feature Store on Gemini Enterprise Agent Platform | 存放做好的特徵 |
| Vertex AI Vector Search | Vector Search on Gemini Enterprise Agent Platform | 大量嵌入找相似 |
在程式裡,三招各有對應的 Keras 工具:特徵交叉用 HashedCrossing、嵌入用 StringLookup 搭配 Embedding、資料增強用 RandomFlip 這類隨機層。
舊題庫可能還會看到
tf.feature_column.crossed_column、embedding_column。
TensorFlow 官方已經不建議新程式使用 feature column,除了安全性修正不會再更新,改用 Keras 前處理層:crossed_column換成HashedCrossing,embedding_column換成StringLookup+Embedding。
4. 做好的特徵放哪裡:Feature Store
考試指南第 2 區有一項「在 Feature Store 建立和整合特徵」。Feature Store(特徵商店)白話是「特徵的共用倉庫」。
像「晴_下午」這種做好的特徵存一份,訓練和上線預測都從這裡拿,不同團隊、不同模型也能共用,不用每個人各做一次。它跟其他資料服務怎麼選,第 23 篇會比較。
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這篇的內容對應到:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 1 區:用低程式碼方式打造 AI 方案(約 13%) | 用 BigQuery ML 做特徵工程或特徵選擇 |
| 第 2 區:跨團隊管理資料與模型(約 16%) | 整理與探索不同資料型態(表格、文字、圖片);在 Feature Store 建立和整合特徵 |
| 第 5 區:自動化與協調 ML 管線(約 18%) | 確保訓練和上線的前處理一致 |
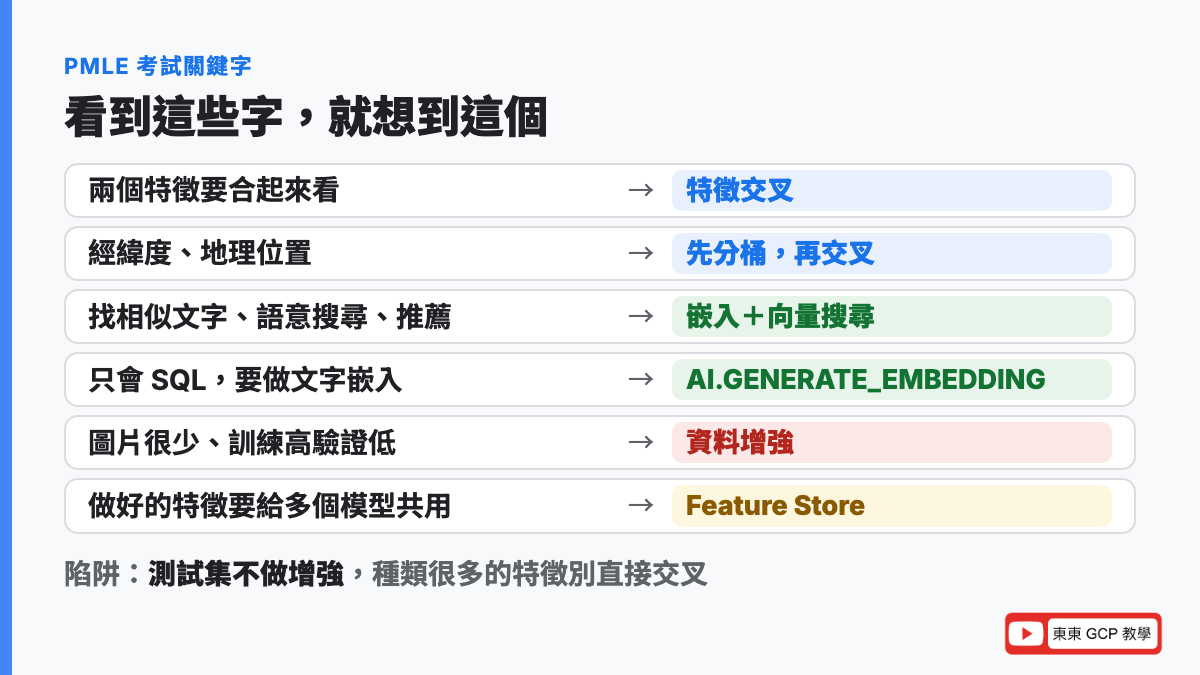
看到這些字,就想到這個
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「兩個特徵合起來才有意義」「線性模型學不到組合效果」 | 特徵交叉 |
| 「經緯度」「地理位置」 | 先分桶、再交叉 |
| 「交叉後組合太多」「太稀疏」 | 雜湊(HashedCrossing)、少交叉、改用嵌入 |
| 「數字和答案是曲線關係」 | 多項式轉換 |
| 「找相似的文字/商品」「語意搜尋」「推薦」 | 嵌入+向量搜尋 |
| 「同一個詞在不同句子意思不同」 | 情境嵌入(不是 word2vec) |
| 「只會 SQL、要做文字嵌入」 | BigQuery AI.GENERATE_EMBEDDING |
| 「圖片很少」「訓練很高、驗證很低」 | 資料增強 |
| 「GPU 在等資料」 | 增強放進 tf.data,搭配 prefetch |
| 「部署時前處理要跟著模型走」 | 增強層、前處理層放進模型裡;BigQuery ML 用 TRANSFORM |
| 「特徵要給多個模型共用」 | Feature Store |
五個常見陷阱
- 驗證集、測試集也做增強:增強只做訓練集,打分數要用真實資料
- 兩個種類很多的特徵直接交叉:組合會爆炸、太稀疏,要先想清楚或改用雜湊、嵌入
- 增強改變了答案:翻轉、旋轉、亮度要合理,6 轉成 9 就錯了
- 想用 One-hot 比相似度:One-hot 每兩個類別距離都一樣,要比相似要用嵌入
- 中文資料選了只支援英文的嵌入模型:例如
text-embedding-005,要改選多語言模型
練習情境(自己出的練習,不是真實考題)
一家連鎖飲料店想做「拍照辨識飲料品項」的模型,每款飲料只有幾十張照片。訓練準確率 98%,驗證準確率只有 65%。部署時希望前處理跟著模型一起走,不用在伺服器另外寫程式。應該怎麼做?
判斷過程:
- 「訓練很高、驗證很低」→ 過度擬合;「照片很少」→ 資料增強
- 「前處理要跟著模型走」→ 把
RandomFlip、RandomRotation等增強層放進模型裡(做法 A),存模型時一起存下來,預測時自動停用 - 驗證集維持真實照片,不做增強
同一家店想讓客人在 App 輸入「想喝有奶味、不要太甜」,就推薦口味相近的飲料。飲料說明都在 BigQuery,團隊只會 SQL。應該怎麼做?
判斷過程:
- 「找口味相近」「字面不一樣也要找得到」→ 嵌入+向量搜尋
- 「資料在 BigQuery、只會 SQL」→ 建遠端模型,用
AI.GENERATE_EMBEDDING把飲料說明轉成嵌入,再用VECTOR_SEARCH找最近的 - 「中文」→ 選
gemini-embedding-001這類支援多語言的模型
常見問答
特徵工程是什麼?
特徵工程是用你對問題的了解,把原始資料加工、組合成新的特徵,讓模型更容易看出規律。常見的做法有特徵交叉(把兩個特徵組合起來)、嵌入(把文字或類別變成有意義的數字)、資料增強(把少量資料變多)。就像把老店員的經驗,寫成模型看得到的欄位。
特徵工程和資料前處理差在哪?
資料前處理是把資料清乾淨、轉成數字、調到適合的大小,像洗菜切菜;特徵工程是用原本的資料做出新的線索,像配菜調味。兩者界線不是很硬,例如分桶有人歸在前處理、有人歸在特徵工程。大方向是:前處理讓資料能用,特徵工程讓資料好用。
特徵交叉是什麼?什麼時候要用?
特徵交叉是把兩個以上的類別特徵組合成一個新特徵,例如天氣乘上時段,變成晴_下午、雨_早上等組合。當「一個特徵的效果要看另一個特徵是什麼」時就該用,例如晴天早上只多賣 5 杯、晴天下午多賣 55 杯。線性模型只會加法,加上特徵交叉才學得到這種組合效果。
特徵交叉的組合太多怎麼辦?
組合數是兩邊相乘,例如 100 種乘 200 種就有 20,000 種,大部分組合幾乎沒有資料,模型容易過度擬合。可以只交叉有道理的組合、交叉後再雜湊分桶到固定數量的桶子(例如 TensorFlow 的 HashedCrossing),或改用嵌入、神經網路讓模型自己學組合。
詞嵌入是什麼?跟 One-hot 差在哪?
詞嵌入是用一小串數字(向量)描述一個詞,意思相近的詞,數字也相近。One-hot 讓每兩個類別的距離都一樣,看不出珍奶比較像鮮奶茶還是檸檬綠茶;嵌入則會讓珍奶和鮮奶茶靠得很近。嵌入的數字也短得多,One-hot 有幾千種類別就要幾千欄,嵌入常見只要幾百個數字。
word2vec 現在還有人用嗎?
Google 速成課程說 word2vec 已經大多被其他模型取代,但拿來理解概念還是很好用。它是靜態嵌入,每個詞只有一個座標,「蘋果牛奶」和「蘋果手機」的蘋果長一樣。現在主流是會看前後文的情境嵌入,例如 BERT、Transformer,以及 Google Cloud 上的 Gemini 嵌入模型。
嵌入向量要幾個維度?
沒有固定答案。Google 速成課程說詞嵌入常見 256、512 或 1,024 維;gemini-embedding-001 預設是 3,072 維,也可以用 output_dimensionality 參數設小一點。維度越多能記的細節越多,但也越佔空間、算得越慢,要在品質和成本之間取捨。
資料增強是什麼?驗證集和測試集要做嗎?
資料增強是把訓練資料做合理的小變化,例如翻轉、旋轉、調亮度,變出更多訓練資料,用來對付資料太少和過度擬合。只有訓練集要做,驗證集和測試集要用真實資料打分數,否則分數會灌水。變化也不能改變答案,例如辨識數字時不能把 6 轉成 9。
深度學習還需要特徵工程嗎?
需要,但分工不一樣了。神經網路可以自己學出一部分特徵組合,例如用嵌入層學出類別的座標,但比較花運算資源,也需要更多資料。表格資料搭配簡單模型時,人工做的特徵交叉、分桶還是很有效;圖片資料雖然不太需要手工特徵,資料增強還是常用。
BigQuery 怎麼產生文字嵌入?ML.GENERATE_EMBEDDING 和 AI.GENERATE_EMBEDDING 差在哪?
先在 BigQuery 建一個遠端模型,指到 Agent Platform 上的嵌入模型(例如 gemini-embedding-001),再用 AI.GENERATE_EMBEDDING 把文字欄位轉成嵌入。官方文件說 AI.GENERATE_EMBEDDING 和 ML.GENERATE_EMBEDDING 功能一樣,但輸出的欄位名稱比較簡單,新的查詢建議用 AI.GENERATE_EMBEDDING。
重點整理
- 特徵工程:把老店員的經驗寫成模型看得到的欄位;前處理讓資料能用,特徵工程讓資料好用
- 特徵交叉:兩個類別特徵組合成新特徵(像棋盤格),讓線性模型學到交互作用;經緯度先分桶再交叉;組合太多會稀疏
- 詞嵌入:用一小串數字描述詞,意思近、距離就近;word2vec 是靜態嵌入,現在主流是看前後文的情境嵌入
- 資料增強:翻轉、旋轉、調亮度把資料變多;只做訓練集、不能改變答案;可以放進模型或 tf.data 流水線
- GCP 上:BigQuery ML 用
ML.FEATURE_CROSS、ML.BUCKETIZE,文字嵌入用AI.GENERATE_EMBEDDING;Vertex AI 已改名為 Gemini Enterprise Agent Platform,做好的特徵放 Feature Store
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 第 3 篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切
- 第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
- 第 6 篇:ROC 曲線和 AUC 怎麼看?門檻怎麼調、AUC-PR 差在哪
- 第 7 篇:過度擬合是什麼?正則化、Dropout、提前停止 3 招解決
- 第 8 篇:資料洩漏是什麼?模型考試作弊的 3 種常見情況
- 第 9 篇:類別不平衡怎麼辦?過取樣、欠取樣與 Upweighting
- 上一篇:第 10 篇:資料前處理怎麼做?標準化、遺失值、高基數類別
- 下一篇:第 12 篇:機器學習的資料隱私怎麼保護?DLP、聯邦學習、VPC Service Controls
站上相關文章
- End-to-end Training(端到端訓練)是什麼?
- 生成式 AI 是什麼?跟機器學習差在哪裡?
- BigQuery 不就是查詢嗎?跟資料庫差在哪裡?能做什麼分析?
- Vertex AI 核心功能 Agent Builder、Model Builder 和 Model Garden 介紹
- GCP 學習路徑 Learning Roadmap 和八大關卡
前處理讓食材乾淨,特徵工程讓菜有味道;這兩篇合起來,就是模型拿到好資料的完整準備。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。