訓練資料讀太慢,多半是 GPU 在等資料:把小檔打包成 TFRecords,再用 tf.data 的 prefetch 邊讀邊訓練。
前面 12 篇都在講「資料怎麼整理」:切資料集、處理遺失值、做特徵、遮個資。這篇講的是最後一步:資料怎麼餵進模型。餵得慢,前面做得再好,模型也只能乾等。
一樣用有 2,000 間分店的連鎖飲料店當例子(教學假設)。這次要訓練的是「封膜檢查」模型:每杯飲料封膜後拍一張照片,讓模型判斷封膜有沒有歪、有沒有漏。總共 200 萬張照片,每張裁切後約 50 KB,全部放在 Google 的雲端儲存空間 Cloud Storage,加起來約 100 GB。
為什麼你需要知道
- GPU 按小時計費:訓練用的 GPU、TPU 都是租的,它在等資料的每一秒都在燒錢。GPU 使用率只有 30%,等於你付了 100% 的錢只用到三成
- 最常見的誤會:訓練太慢就換更貴的 GPU,結果一點都沒變快。因為瓶頸不在「算」,在「讀」。這篇教你先判斷是哪一種慢
- 筆記裡的三個關鍵字,舊題庫很常考:「大型 CSV 要分割檔案+平行 interleave」「TensorFlow 圖片用 TFRecords+tf.data」「TPU 輸入瓶頸用 prefetch」。這篇把三個全部講清楚
- 證照必考:PMLE 考試指南第 3.2 節要你會「在 Cloud Storage 和 BigQuery 上組織訓練資料」「把資料送進訓練管線」「排除訓練失敗的問題」,第 3.3 節要你會選 CPU、GPU、TPU
先搞懂:訓練的時候,電腦到底在做什麼?
白話是什麼
模型訓練是一步一步做的,每一步叫一個訓練步驟(training step)。TensorFlow 官方的效能指南把一個步驟拆成三件事:
- 開檔:找到檔案、打開它
- 讀資料:把資料從硬碟或網路讀進記憶體,通常還要做前處理(解壓縮、縮放、裁切)
- 訓練:把這一批資料送進 GPU 算
幾個會一直出現的 IT 名詞先講一下:
- CPU(中央處理器):電腦的大腦,什麼都會做,但同一時間只能做幾件事
- GPU(圖形處理器):原本是畫遊戲畫面的晶片,擅長「同時做幾千個簡單算術」。訓練神經網路剛好就是大量的乘法和加法,所以 GPU 比 CPU 快很多倍
- TPU(張量處理器):Google 自己設計、專門為機器學習打造的晶片,比 GPU 更專、更快
- I/O(輸入輸出):讀硬碟、走網路、開檔案,這些「搬資料」的動作統稱 I/O
比喻:一個廚師、一個倉庫
把訓練想成餐廳出菜:
- GPU 是廚師,炒菜超快
- 資料是食材,放在遠處的中央倉庫(Cloud Storage)
- CPU 是助手,負責跑腿和切菜(前處理)
傻做法是這樣:廚師每炒一盤菜,都先自己走去倉庫拿食材,拿回來自己切,切完才下鍋。走路 36 秒、切菜 18 秒、炒菜 24 秒。你算算,廚師真正在炒菜的時間只有三成,其他時間都在走路和切菜。
這就是「GPU 在等資料」。
來龍去脈:為什麼現在特別嚴重
這幾年 GPU、TPU 的運算速度翻了好幾倍,但硬碟和網路沒有跟著等比例變快。廚師越來越快,倉庫卻還是那麼遠,瓶頸自然從「算」移到「讀」。
資料放在雲端時更明顯。TensorFlow 官方文件點出遠端儲存(例如 Cloud Storage)和本機硬碟的兩個差別:
| 本機硬碟 | 遠端儲存(Cloud Storage) | |
|---|---|---|
| 開檔到讀到第一個位元組的時間(time-to-first-byte) | 很短 | 可能長上好幾個數量級 |
| 讀取頻寬 | 一個檔就能用滿 | 總頻寬很大,但單一檔案只用得到一小部分 |
用倉庫的比喻:雲端倉庫很大、門很多,但每次開門都要等保全確認(開檔慢),而且一個人一次只能走一道門(單檔頻寬小)。所以同時派很多人走不同的門,才用得滿。
兩種慢:輸入受限 vs 運算受限
| 輸入受限(input-bound) | 運算受限(compute-bound) | |
|---|---|---|
| 白話 | GPU 在等資料 | 資料早就準備好,GPU 算不過來 |
| 比喻 | 廚師在等食材 | 食材堆滿檯面,廚師炒不完 |
| 怎麼看出來 | GPU 使用率低、忽高忽低 | GPU 使用率接近 100% |
| 解法 | 這篇講的全部:prefetch、平行讀取、TFRecords、快取 | 換更快的 GPU/TPU、加大批次、多台機器一起算(第 16 篇) |
怎麼知道自己是哪一種? 最簡單是看 GPU 使用率(NVIDIA 顯卡用 nvidia-smi 指令就看得到)。要看得更細,TensorFlow 有 Profiler 工具,會直接告訴你每一步有幾成時間在等輸入。Cloud TPU 的效能指南也說,排除 TPU 效能問題的第一步就是先做 profile。
為什麼要學
不先分清楚是哪一種慢,就會做白工:輸入受限時換 GPU 沒用,運算受限時改讀檔也沒用。考試更是直接考這個判斷:題目說「GPU 使用率很低」,答案絕對不是「換更大的 GPU」。
1. tf.data:把「餵資料」變成一條生產線
白話是什麼
tf.data 是 TensorFlow 內建的一組工具,專門用來建輸入管線(input pipeline)。
管線這個詞在 IT 界很常見,意思是「一連串接好的處理步驟」,資料像水一樣從頭流到尾,每一站做一件事。tf.data 的管線就是:讀檔 → 解析 → 前處理 → 打亂 → 分批 → 送進模型。
比喻:便當工廠的輸送帶
傻做法是一個人從頭做到尾:拿米、裝飯、放菜、蓋盒、裝箱。輸送帶的做法是每一站站一個人,各做一件事,便當一個接一個往下傳。
重點不是「步驟變少」,而是每一站可以同時做事:裝飯的人在裝第 10 個便當時,放菜的人正在放第 9 個,裝箱的在裝第 8 個。
來龍去脈
早期用 TensorFlow 讀資料,很多人是自己寫 Python 迴圈,一筆一筆讀進來再丟給模型。這樣做又慢又難平行,而且每個人寫法都不一樣。TensorFlow 後來把這件事標準化成 tf.data:你描述「資料從哪來、要怎麼處理」,它負責排程、開多執行緒、管理緩衝區。
執行緒(thread)是程式裡可以同時跑的工作線,多開幾條就能同時做幾件事;緩衝區(buffer)是一塊暫存空間,先做好的東西放在這裡等人拿。
一條管線長什麼樣
以封膜照片為例,一條標準的 tf.data 管線大概是這樣(看不懂程式沒關係,下面一行一行翻譯):
files = tf.data.Dataset.list_files("gs://drink-ml/sealing/*.tfrecord")
ds = files.interleave(tf.data.TFRecordDataset, num_parallel_calls=tf.data.AUTOTUNE)
ds = ds.map(parse_and_resize, num_parallel_calls=tf.data.AUTOTUNE)
ds = ds.shuffle(10_000).batch(64).prefetch(tf.data.AUTOTUNE)| 這一行 | 白話 |
|---|---|
list_files(...) | 列出 Cloud Storage 上所有封膜照片的打包檔(gs:// 開頭就是 Cloud Storage 的路徑) |
interleave(TFRecordDataset, ...) | 同時打開好幾個檔案,交錯著讀 |
map(parse_and_resize, ...) | 每一張照片解析、縮放,而且好幾張同時做 |
shuffle(10_000) | 先拿 10,000 張放進袋子打亂,讓模型不會照固定順序學 |
batch(64) | 每 64 張包成一批 |
prefetch(AUTOTUNE) | 先把下一批準備好,GPU 一要就有 |
tf.data.AUTOTUNE 的意思是「要開幾條線你自己決定」,TensorFlow 會在執行時動態調整。官方文件建議大多數情況直接用它。
2. 四招加速:各治一種慢
TensorFlow 效能指南整理的做法,用廚房比喻一次看懂。
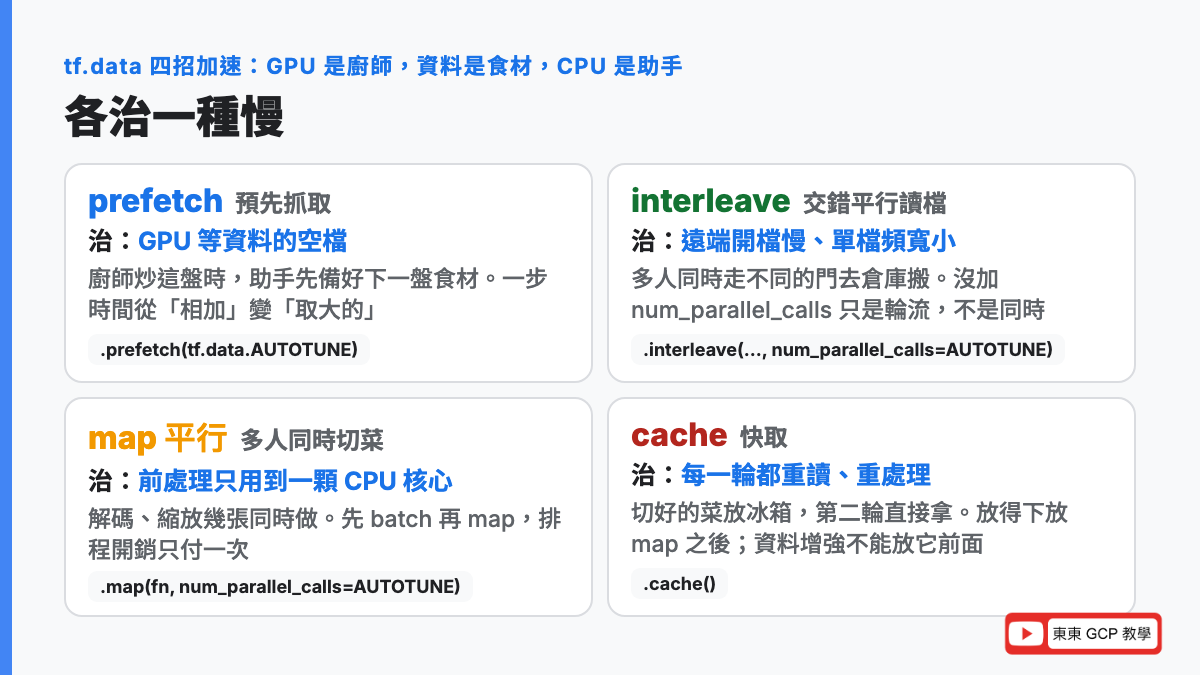
第 1 招:prefetch(預先抓取)
白話:GPU 在算這一批的時候,背景同時把下一批讀好、放在緩衝區。
比喻:助手在廚師炒這盤菜時,就先把下一盤的食材拿到檯面旁邊。廚師炒完回頭,食材已經在了。
原理:官方文件寫得很清楚,prefetch 讓「資料準備」和「模型運算」重疊,一步的時間從「準備時間+訓練時間」變成「兩者取大的那個」。
怎麼用:管線最後加 .prefetch(tf.data.AUTOTUNE)。要預先抓幾批?官方說至少等於一個訓練步驟會吃掉的批次數,用 AUTOTUNE 讓它自己調最省事。
第 2 招:interleave(交錯平行讀檔)
白話:同時打開好幾個檔案,輪流從每個檔各拿一點。
比喻:一個人去倉庫搬,一次只能走一道門;派四個人同時去,四道門一起走。雲端倉庫「開門慢、單門窄」的問題就靠這招解。
兩個參數:
cycle_length:同時開幾個檔案輪著讀num_parallel_calls:真正平行開幾條線去讀。沒設這個,interleave 只是「輪流」不是「同時」,官方文件實測:只輪流沒有加速,加了平行才有
對應筆記那條「大型 CSV 要分割檔案」:一個 50 GB 的 CSV 只有一個檔,再多人也只能排隊走同一道門。先切成 100 個 500 MB 的檔,interleave 才有東西可以平行。第 3 節會再講。
第 3 招:map 平行化(多人同時切菜)
白話:解碼圖片、縮放、資料增強這些前處理,一次做很多張,不要一張做完才做下一張。
比喻:切菜只有一個助手,就算廚師再快也要等;開四個助手同時切,速度直接變四倍。
怎麼用:.map(fn, num_parallel_calls=tf.data.AUTOTUNE)。官方給的簡單原則是「開到 CPU 核心數」,用 AUTOTUNE 讓它自己抓。
進階:先 batch 再 map。每叫一次前處理函數都有固定的排程開銷。官方的做法是把函數改成「一次處理一整批」(向量化),然後 batch 放在 map 前面,開銷只付一次。官方實測從 0.24 秒降到 0.05 秒,差了近 5 倍。
第 4 招:cache(快取)
白話:第一輪訓練讀過、處理過的資料,存在記憶體或本機硬碟;第二輪起直接拿,不用再去倉庫。
比喻:切好的菜放冰箱,明天不用再切一次。
快取(cache)在 IT 界到處都是,意思都一樣:把算過、拿過的東西先存一份在比較近的地方,下次直接用。
兩個規則:
- 放得下就放在 map 之後:連前處理都省掉
- 放不下就放在 map 之前,或乾脆事先處理好:如果 map 會讓資料變大(例如把壓縮的 JPEG 解成原始像素,一張會大十幾倍),200 萬張解開放不進記憶體,就只快取讀檔那段,解碼每輪重做。或者在訓練前先用別的工具(第 23 篇會講的 Dataflow)把資料處理好存成檔案
另外一個小提醒:資料增強不要放在 cache 前面。第 11 篇講過,資料增強的重點是每一輪看到的照片都有一點不一樣,快取起來就每輪都一樣了。
四招一張表
| 招式 | 治什麼慢 | 比喻 | 關鍵參數 |
|---|---|---|---|
| prefetch | GPU 等資料的空檔 | 先備好下一盤食材 | prefetch(AUTOTUNE) |
| interleave | 遠端開檔慢、單檔頻寬小 | 多人同時走不同的門 | num_parallel_calls=AUTOTUNE |
| map 平行 | 前處理只用到一顆 CPU 核心 | 多個助手同時切菜 | num_parallel_calls=AUTOTUNE,先 batch 再 map |
| cache | 每一輪都重讀、重處理 | 切好的菜放冰箱 | cache() 放 map 之後(放得下)或之前 |
3. 算一次給你看:一個步驟到底花多久
繼續用封膜照片的例子,數字是教學假設:
- 每批 64 張照片
- 開檔+讀資料:0.6 秒(照片在 Cloud Storage)
- 前處理(解碼、縮放):0.3 秒
- GPU 訓練這一批:0.4 秒
- 總共跑 1,000 步
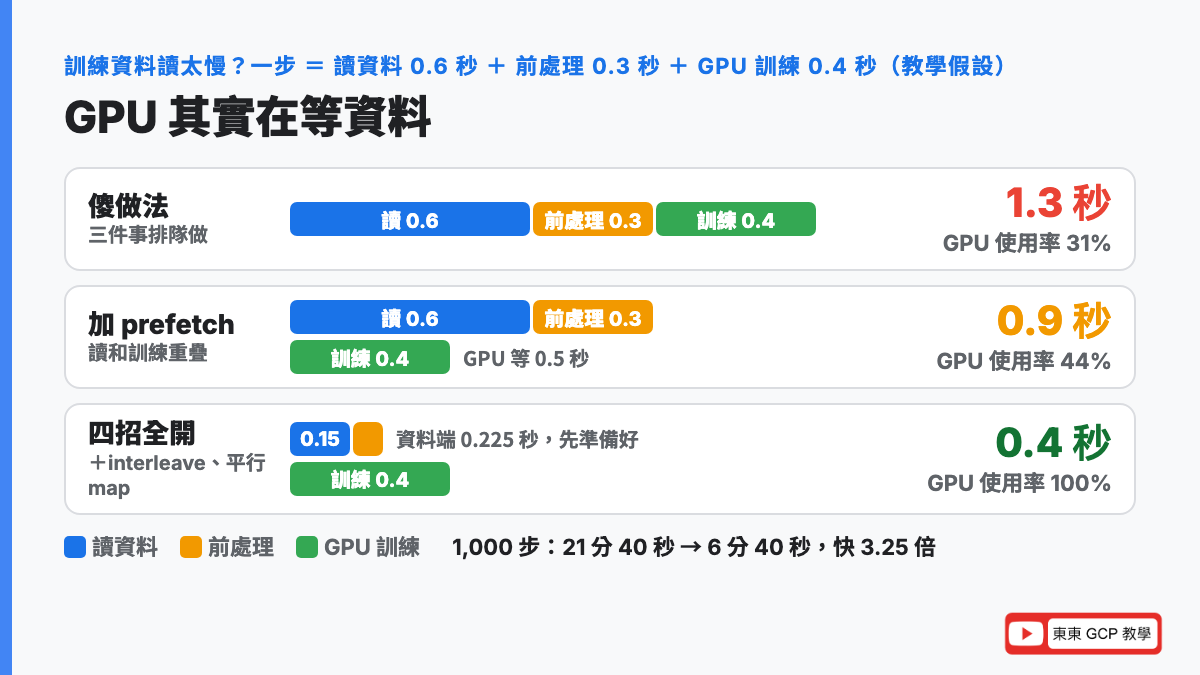
傻做法:三件事排隊做
一步的時間 = 讀資料 + 前處理 + 訓練
          = 0.6 + 0.3 + 0.4
          = 1.3 秒
1,000 步 = 1,300 秒 ≈ 21 分 40 秒。
GPU 使用率 = 訓練時間 ÷ 一步的時間 = 0.4 ÷ 1.3 ≈ 31%。你付了 100% 的 GPU 錢,它只工作三成。
加 prefetch:讀資料和訓練重疊
一步的時間 = max(讀資料 + 前處理, 訓練)
          = max(0.6 + 0.3, 0.4)
          = max(0.9, 0.4)
          = 0.9 秒
max 是「取大的那個」。因為兩邊同時進行,誰慢就等誰。
1,000 步 = 900 秒 = 15 分。GPU 使用率 = 0.4 ÷ 0.9 ≈ 44%。
有進步,但 GPU 還是在等,因為「準備資料」那邊 0.9 秒比「訓練」0.4 秒慢。瓶頸還在資料端。
再加 interleave 和平行 map:把資料端壓下來
- 4 個檔同時讀,讀資料 0.6 秒 → 約 0.15 秒
- 4 顆 CPU 核心同時做前處理,0.3 秒 → 約 0.075 秒
一步的時間 = max(0.15 + 0.075, 0.4)
          = max(0.225, 0.4)
          = 0.4 秒
1,000 步 = 400 秒 ≈ 6 分 40 秒。GPU 使用率 = 0.4 ÷ 0.4 = 100%。
三種做法比一比
| 做法 | 一步時間 | 1,000 步 | GPU 使用率 | 比傻做法快 |
|---|---|---|---|---|
| 傻做法 | 1.3 秒 | 21 分 40 秒 | 31% | 1 倍 |
| 加 prefetch | 0.9 秒 | 15 分 | 44% | 1.4 倍 |
| 四招全開 | 0.4 秒 | 6 分 40 秒 | 100% | 3.25 倍 |
程式沒改模型一行,光改讀資料的方式,就快了 3 倍多,GPU 的錢也只付三分之一。
數字怎麼看
- 資料端時間 > 訓練時間:輸入受限,繼續在資料端下功夫(更多平行、打包 TFRecords、加快取)
- 資料端時間 < 訓練時間:變成運算受限,再加速資料也不會更快。例子裡資料端已經壓到 0.225 秒,再壓到 0.1 秒,一步還是 0.4 秒。這時要換更快的 GPU、加大批次,或多台機器一起算
- 換了更快的 GPU 之後要重算:假設 GPU 升級後訓練時間從 0.4 秒變 0.2 秒,資料端的 0.225 秒馬上又變成瓶頸。所以硬體升級後,輸入管線通常要再調一次
- 0.6 秒的讀資料裡,開檔佔了多少? 檔案又小又多,開檔開銷會吃掉大半。這就是下一節 TFRecords 要解的問題
4. TFRecords:把 200 萬個小檔打包成幾百個大箱
先看問題:小檔案為什麼慢
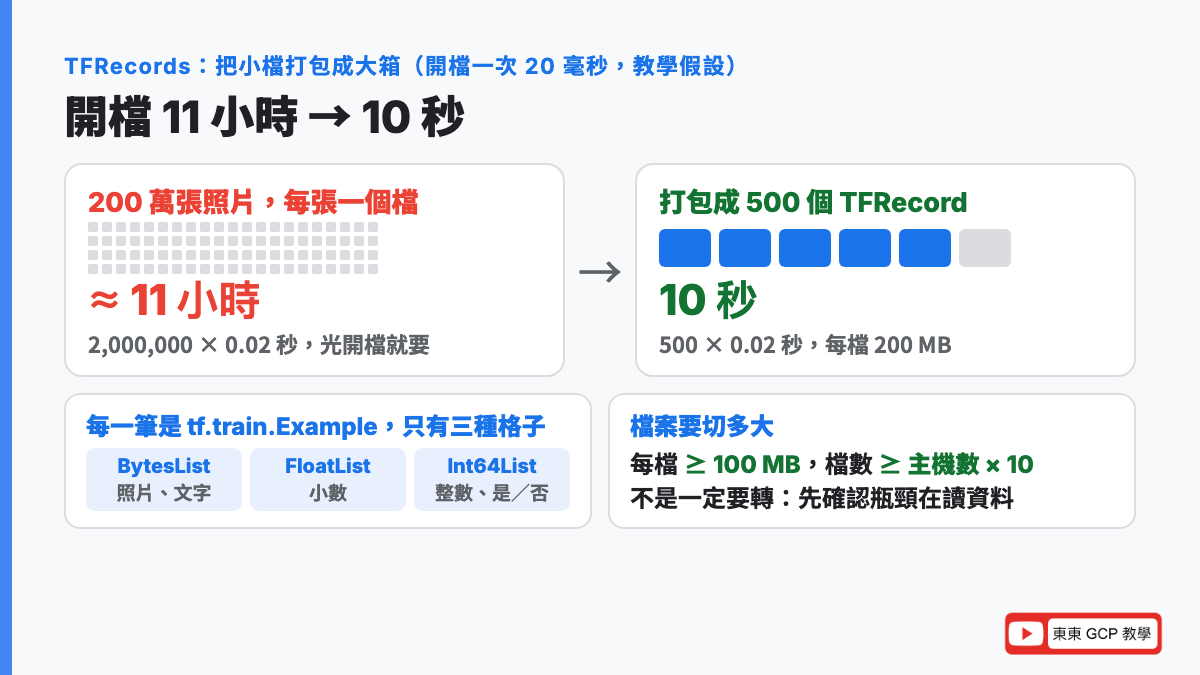
Cloud Storage 每打開一個檔案都有固定的開銷(前面講的 time-to-first-byte)。假設每次開檔要 20 毫秒(0.02 秒,教學假設):
200 萬張照片,每張一個檔
開檔總時間 = 2,000,000 × 0.02 秒 = 40,000 秒 ≈ 11 小時
光是「開檔」就要 11 個小時,還沒開始讀內容。
如果把 200 萬張照片打包成 500 個大檔(每個 200 MB):
開檔總時間 = 500 × 0.02 秒 = 10 秒從 11 小時變 10 秒。這就是打包的威力。
白話是什麼
TFRecord 是 TensorFlow 的檔案格式,把很多筆資料一筆接一筆存成二進位紀錄。TensorFlow 官方教學的定義就一句話:「一種儲存一連串二進位紀錄的簡單格式」。
二進位(binary)是電腦原生的 0 和 1,不是給人看的文字。好處是電腦讀的時候不用再「翻譯」(像 CSV 要把文字 “0.57” 轉成數字),直接用。
比喻:散裝水果 vs 整箱
200 萬顆水果一顆一顆裝袋,倉庫出貨要開 200 萬次門。改成 500 箱,每箱 4,000 顆,開 500 次門就搬完。
箱子裡每顆水果還是分開的(每筆資料獨立),只是運送單位變大了。
來龍去脈:Protocol Buffers 和 tf.train.Example
TFRecord 裡面每一筆紀錄,通常是一個叫 tf.train.Example 的東西,它是用 Protocol Buffers(簡稱 protobuf)寫的。
Protocol Buffers 是 Google 自家發明、用來把結構化資料序列化的格式。序列化(serialization)就是把程式裡的物件壓成一串位元組,方便存檔或傳輸,像把組合家具拆成平板裝箱,到了再組回來。
tf.train.Example 本質上是一張「欄位名稱 → 值」的對照表,官方寫法是 {"string": tf.train.Feature}。而值的型態只有三種:
| 型態 | 裝什麼 | 封膜照片的例子 |
|---|---|---|
| BytesList | 文字、原始位元組 | image:JPEG 檔的原始內容;store_id:分店編號 “TP-0231” |
| FloatList | 小數 | fill_level:裝杯高度 0.93 |
| Int64List | 整數、布林值 | label:封膜正常 0、有問題 1;shot_hour:拍攝時段 14 |
比喻:一個標準便當盒只有三種格子(主菜格、配菜格、湯格),不管裝什麼菜都只能放進這三種格子。好處是任何人拿到便當盒都知道怎麼打開。
為什麼叫 Example:機器學習裡一筆訓練資料習慣叫一個「樣本」(example),這個格式就是「一個樣本長什麼樣」的標準容器。
重要:不是一定要轉成 TFRecord
官方教學特別加了一段提醒:這些結構是選用的。除非你用 tf.data,而且「讀資料」確認是訓練的瓶頸,否則沒有必要把現有程式改成 TFRecord。
這是考試的陷阱之一:看到「訓練很慢」不要反射性選「轉 TFRecord」。先確認是不是輸入受限(前面「先搞懂」那一節講的),而且是不是「小檔太多」造成的。
檔案要切多大、切幾個:算一次
TensorFlow 官方教學給了兩個經驗法則:
- 檔案數至少是「同時讀資料的主機數」的 10 倍,才有足夠的平行度
- 每個檔至少 10 MB,最好 100 MB 以上,prefetch 才有效果
套在封膜照片上:
資料量 100 GB,打算用 4 台機器一起訓練
檔案數至少 = 4 × 10 = 40 個
每檔大小 = 100 GB ÷ 40 = 2.5 GB
2.5 GB 遠超過 100 MB,可以切更細。切成 500 個檔,每檔 200 MB:500 ≥ 40,200 MB ≥ 100 MB,兩個規則都滿足。
數字怎麼看:
- 檔太少(例如只有 4 個):4 台機器各讀一個,平行度不夠,而且有一台讀完了其他還在讀
- 檔太小(例如每檔 1 MB):又回到開檔開銷太大的問題,prefetch 一次抓不到多少東西
- 官方說如果算出來每檔小於 10 MB,就要減少檔案數,在「平行度」和「單檔效率」之間取捨
怎麼寫、怎麼讀
寫:用 tf.io.TFRecordWriter,把每張照片包成 tf.train.Example、序列化、寫進去。200 萬張要轉,通常不會在一台機器上跑,而是用 Dataflow 這類批次處理服務平行轉(第 23 篇會比較 Dataflow 和 Dataproc)。
讀:tf.data.TFRecordDataset(檔案清單, num_parallel_reads=...)。num_parallel_reads 就是同時讀幾個檔,Cloud TPU 的效能指南直接點名這個參數是解決「TPU 在等資料」的方法。
為什麼要學
這是舊題庫最常見的情境之一:「大量圖片放在 Cloud Storage,用 TensorFlow 訓練,I/O 是瓶頸」,標準答案就是「轉成 TFRecord,用 tf.data 讀」。但新版考試更強調判斷:你要能說出為什麼小檔慢、檔要切多大、什麼情況不用轉。
5. 大型 CSV 也一樣:先切檔,再 interleave
筆記裡「大型 CSV:分割檔案+Parallel Interleave」這條,道理跟 TFRecord 完全一樣,只是方向相反:TFRecord 是「太多小檔要合併」,大 CSV 是「一個巨檔要拆開」。
CSV 是最常見的表格文字檔,每行一筆資料、欄位用逗號分開,Excel 可以直接開。
假設飲料店 5 年的銷售紀錄是一個 50 GB 的 CSV:
- 一個檔:只能從頭讀到尾,一條線,interleave 沒有東西可以平行
- 切成 100 個 500 MB 的檔:
interleave同時開 8 個、16 個檔讀,速度直接乘上去
tf.data 讀 CSV 有兩個工具,官方指南都有:
tf.data.experimental.make_csv_dataset:高階、方便,會自己猜欄位型態,支援一次給多個檔案、自動分批和打亂tf.data.experimental.CsvDataset:低階、要自己指定每欄型態,但控制更細
另外一個思路:表格資料量真的很大,很多時候直接放進 BigQuery 比切 CSV 更省事,用 SQL 處理完再接訓練。BigQuery ML 第 15 篇會講,資料服務怎麼選第 23 篇會比。
6. TPU 特別要注意的事
TPU 算得比 GPU 更快,所以更容易輸入受限。Cloud TPU 效能指南把「輸入受限的模型」列為第一個效能問題,解法就是確保資料源源不絕地送進去:用 TFRecordDataset 的 num_parallel_reads 平行讀檔,加上 prefetch。
另外有一個 TPU 專屬的細節:批次大小。
- 一顆 TPU 裝置(例如 v2-8、v3-8)有 8 個核心,TPU 會把一批資料平均切給 8 個核心。你設批次 128,每個核心拿到 128 ÷ 8 = 16 筆
- 每個核心內部用的是 8 × 128 的向量暫存器在做矩陣乘法,所以官方建議批次大小要能被 8 或 128 整除
- 記憶體放得下的話,用越大的批次越好
核心(core)可以想成「一顆晶片裡面有幾個獨立的工作單位」,8 核心就是 8 個人同時算。
套回例子:批次 64 可以被 8 整除,沒問題;如果設 100,100 ÷ 8 = 12.5,切不平均,效率會打折。
在 GCP 上怎麼做
1. 資料放哪裡:Cloud Storage 還是 BigQuery
Google 的訓練文件建議,以下情況把訓練資料放 Cloud Storage:
- 非結構化資料:圖片、文字、影片
- 已經是 TFRecord 這類格式的結構化資料
- 很大的檔案,例如原始影片
- 要做分散式訓練(多台機器一起)
Cloud Storage 是 Google 的雲端檔案儲存服務,存東西的單位叫 bucket(中文版文件叫「值區」),可以想成一個超大的雲端資料夾。
表格資料則通常放 BigQuery(Google 的資料倉儲,用 SQL 查詢),站上有一篇BigQuery 跟資料庫差在哪可以先看。
同一個區域:訓練程式碼需求文件明寫,要讀 Cloud Storage 讀得快,bucket 要放在跟訓練同一個區域(region,就是 Google 機房所在的地理位置,例如台灣 asia-east1)。資料在美國、訓練在台灣,等於廚房在台北、倉庫在洛杉磯。
2. 訓練程式怎麼讀 Cloud Storage:掛成資料夾
在 Agent Platform(原 Vertex AI,後面會講改名)跑無伺服器訓練時,Google 會用 Cloud Storage FUSE 把你的 bucket 掛載成訓練機器上的資料夾,路徑是 /gcs/你的bucket名稱/。
掛載(mount)就是把一個遠端的儲存空間接上來,讓程式用「開本機檔案」的方式讀它。對程式來說,/gcs/drink-ml/sealing/part-0001.tfrecord 跟硬碟上的檔案沒兩樣。
with open('/gcs/drink-ml/labels.csv', 'r') as f:
    lines = f.readlines()
好處(官方列的):
- 資料是串流進訓練工作,不是先整包下載,啟動更快
- 大檔案連續讀取的吞吐量高,分散式訓練也適合
官方的效能建議:
- 檔案要大而少,減少查找和開檔的延遲(跟 TFRecord 的道理一樣)
- 用分散式訓練把頻寬用滿
- 常用的檔案開快取
- 檢查點(checkpoint)和日誌寫本機硬碟,不要直接寫 Cloud Storage。檢查點是訓練中途存的模型進度,像遊戲存檔
- 不要重新命名資料夾(這個操作在 Cloud Storage FUSE 不是一次完成的,中斷會留一半);不要沒事就
close()或flush(),每次都會真的傳一次檔案、產生費用
不想用掛載,也可以用 TensorFlow 的 tf.io.gfile.GFile 直接讀 gs:// 路徑,或 Cloud Storage 的 Python 客戶端。這些都支援 ADC(應用程式預設憑證),意思是程式自動拿到訓練工作的身分,不用在程式裡寫任何密碼或金鑰。
3. 資料太大放不進記憶體
官方文件〈載入大型資料集〉那段說得很直接:訓練機器的記憶體可能裝不下整份資料,這時要串流或分批讀。TensorFlow 的 tf.data.Dataset 可以直接從 Cloud Storage 串流 TFRecord 或文字資料,這就是這篇從頭講到現在的東西。
另一條路是多台機器做資料平行(每台只讀一部分),第 16 篇講分散式訓練時會展開。
4. 前處理太重、CPU 跟不上
四招全開之後 GPU 還是在等,問題可能變成 CPU 不夠:解碼 200 萬張 JPEG 本身就很花 CPU。兩個方向:
- 訓練前先處理好:用 Dataflow 這類批次服務,把解碼、縮放做完存成 TFRecord,訓練時只剩「讀」
- tf.data service:TensorFlow 的進階功能,把整條 tf.data 管線搬到另一群機器上跑,訓練機器只負責算。概念像把備餐廚房獨立出來,主廚房只負責炒
5. Vertex AI 改名了
Vertex AI 在 2026 年 4 月改名為 Gemini Enterprise Agent Platform(簡稱 Agent Platform),訓練相關的服務跟著改,官方對照表:
| 舊名稱 | 新名稱 |
|---|---|
| Vertex AI Platform | Gemini Enterprise Agent Platform |
| Vertex AI Training | Gemini Enterprise Agent Platform Managed Training |
| Vertex AI Serverless Training | Gemini Enterprise Agent Platform Serverless Training |
| Vertex AI Training Clusters | Managed Training Clusters on Gemini Enterprise Agent Platform |
舊題庫寫「Vertex AI Training」「Vertex AI custom training」,現在叫 Agent Platform Managed Training 或 Serverless Training,做的事一樣:你給程式和資料,它幫你開機器、跑訓練、收模型。第 16 篇會專門講。
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這篇的內容對應到:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 2 區:跨團隊管理資料與模型(約 16%) | 2.1 組織不同類型的資料(表格、文字、圖片),讓實驗、訓練、服務都有效率 |
| 第 3 區:把原型放大成 ML 模型(約 21%) | 3.2 在 Google Cloud 上組織訓練資料(Cloud Storage、BigQuery);把結構化、非結構化資料送進訓練管線;排除訓練失敗的問題。3.3 評估 CPU、GPU、TPU 等運算選項;GPU 和 TPU 上的分散式訓練 |
新版指南沒有直接寫出 TFRecord、prefetch 這些字,但「送進訓練管線」「排除訓練問題」「選加速器」這些項目,考題一定會用「訓練太慢」「GPU 使用率低」的情境來問。
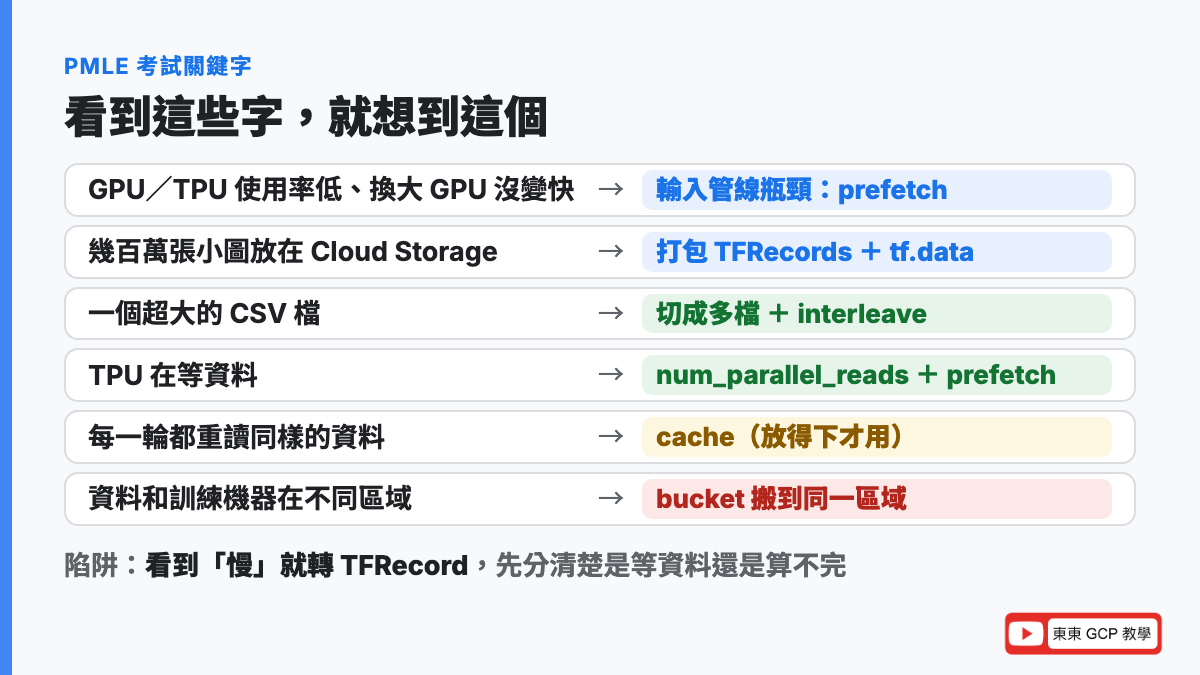
看到這些字,就想到這個
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「GPU/TPU 使用率低」「加速器閒置」「換更大的 GPU 沒變快」 | 輸入管線瓶頸:prefetch、interleave、平行 map |
| 「Profiler 顯示 input-bound」「在等資料」 | 同上,先從 prefetch 開始 |
| 「幾百萬張小圖片放在 Cloud Storage」「I/O 是瓶頸」 | 打包成 TFRecords+tf.data |
| 「一個很大的 CSV 檔」「單一檔案」 | 切成多個檔+parallel interleave |
| 「TPU 在等資料」「TPU 輸入瓶頸」 | prefetch、TFRecordDataset 的 num_parallel_reads |
| 「每一輪都重讀同樣的資料」「資料放得進記憶體」 | cache |
| 「資料放不進記憶體」 | 串流讀取,不要 cache;或多台機器資料平行 |
| 「前處理很重」「CPU 滿載」 | 訓練前先用 Dataflow 處理好;或 tf.data service |
| 「訓練機器和資料在不同區域」 | bucket 搬到同一個區域 |
| 「TPU 批次大小怎麼設」 | 8 或 128 的倍數,記憶體放得下的最大值 |
| 「訓練很慢」但沒說 GPU 使用率 | 先判斷是輸入受限還是運算受限,不要直接選 TFRecord |
六個常見陷阱
- GPU 使用率低就換更大的 GPU:那是運算受限的解法,輸入受限換了也沒用,還更貴
- 看到「慢」就轉 TFRecord:官方明說不是必要,先確認瓶頸在讀資料、而且是小檔太多
- interleave 沒加 num_parallel_calls:只是輪流讀,不是同時讀,官方實測沒有加速
- cache 放在資料增強後面:每一輪看到的都是同一批增強結果,資料增強白做
- cache 放不進記憶體還硬放:記憶體爆掉訓練直接失敗。放不下就只快取讀檔那段,或事先處理好
- TFRecord 檔切太小或太少:太小回到開檔開銷問題,太少平行度不夠。記住「每檔 100 MB 以上、檔數是主機數 10 倍以上」
練習情境(自己出的練習,不是真實考題)
飲料店的封膜檢查模型用一張 GPU 訓練,200 萬張照片每張一個檔放在 Cloud Storage。工程師發現 GPU 使用率只有 25%,於是換成更高階的 GPU,使用率掉到 12%,總訓練時間幾乎沒變。應該怎麼做?
判斷過程:
- 「GPU 使用率低、換 GPU 沒變快」→ 輸入受限,不是運算受限
- 「200 萬個小檔在 Cloud Storage」→ 開檔開銷太大,打包成 TFRecords(每檔 100 MB 以上)
- 用 tf.data 讀:
interleave平行開檔、map平行前處理、最後prefetch - 換回原本的 GPU 就夠了,省錢
同一家店要用 5 年的銷售紀錄(一個 50 GB 的 CSV)訓練需求預測模型,在 Agent Platform 上跑。讀資料非常慢,但 CPU 和 GPU 使用率都很低。應該怎麼做?
判斷過程:
- 「一個 50 GB 的 CSV」→ 單一檔案只能一條線讀,切成多個檔(例如 100 個 500 MB)
- 切完用
interleave加num_parallel_calls平行讀 - 確認 bucket 和訓練工作在同一個區域
- 另一個合理選項:資料放進 BigQuery,用 SQL 處理後再訓練(第 15 篇)
團隊改用 TPU 訓練影像模型,資料已經是 TFRecord。TPU 的 profile 顯示大部分時間在等輸入。批次大小設 100。應該調什麼?
判斷過程:
- 「TPU 在等輸入」→
TFRecordDataset加num_parallel_reads,管線尾端加prefetch(AUTOTUNE) - 「批次 100」→ 100 不能被 8 整除,8 核心分不平均,改成 128 或 256(記憶體放得下的最大值)
- 若前處理很重,考慮先用 Dataflow 處理好,或開 tf.data service
常見問答
訓練資料讀太慢怎麼辦?
先看 GPU 使用率。使用率低、忽高忽低,代表 GPU 在等資料,叫輸入受限,解法是改輸入管線:用 tf.data 的 prefetch 讓讀資料和訓練同時進行、interleave 平行開檔、map 加 num_parallel_calls 平行前處理、cache 快取第一輪讀過的資料。如果檔案又小又多,先打包成 TFRecords。使用率接近 100% 則是運算受限,要換更快的硬體或多台機器。
TFRecord 是什麼?
TFRecord 是 TensorFlow 的檔案格式,把很多筆資料一筆接一筆存成二進位紀錄,一個檔裡可以裝幾千、幾萬筆。每筆通常是一個 tf.train.Example,本質是「欄位名稱對應到值」的表,值只有 BytesList、FloatList、Int64List 三種型態。主要好處是把大量小檔合併成少量大檔,大幅減少開檔開銷,而且是二進位格式,讀的時候不用再轉換。
一定要把資料轉成 TFRecord 嗎?
不一定。TensorFlow 官方教學明說這些結構是選用的,除非你用 tf.data 而且確認「讀資料」是訓練瓶頸,否則不需要把現有程式改成 TFRecord。它解決的是「小檔太多、開檔開銷太大」這個特定問題;如果你的資料本來就是幾個大檔,或瓶頸在運算,轉了也不會變快。
tf.data 是什麼?跟直接用 Python 讀檔差在哪?
tf.data 是 TensorFlow 內建的輸入管線工具,你描述資料從哪來、要怎麼處理,它負責排程、開多執行緒、管理緩衝區。自己用 Python 迴圈讀檔是一筆做完才做下一筆,讀資料和訓練會互相等;tf.data 可以讓讀檔、前處理、訓練三件事同時進行,而且 prefetch、interleave、map 都可以設平行度,或用 AUTOTUNE 讓它自己調。
prefetch 是什麼?要設多少?
prefetch 是在 GPU 算這一批的時候,背景先把下一批讀好放在緩衝區。效果是一步的時間從「準備時間加訓練時間」變成「兩者取大的」。官方建議預先抓取的數量至少等於一個訓練步驟會消耗的批次數,實務上直接寫 prefetch(tf.data.AUTOTUNE) 讓 TensorFlow 在執行時動態調整就好。
interleave 和 map 的 num_parallel_calls 差在哪?
兩個都是「同時開幾條線」,但管的階段不同。interleave 的 num_parallel_calls 管「同時打開幾個檔案讀」,解決遠端儲存開檔慢、單檔頻寬小的問題;map 的 num_parallel_calls 管「同時對幾筆資料做前處理」,解決解碼、縮放只用到一顆 CPU 核心的問題。兩個都可以設 tf.data.AUTOTUNE。
cache 什麼時候不能用?
兩種情況。第一,資料處理後放不進記憶體或本機硬碟,例如 200 萬張 JPEG 解碼後變原始像素會大十幾倍,這時只能快取讀檔那段,或事先把資料處理好存檔。第二,cache 不能放在資料增強後面,因為資料增強的目的是每一輪看到的照片都略有不同,快取之後每輪都一樣,增強就白做了。
TFRecord 檔案要切多大、切幾個?
TensorFlow 官方的經驗法則:檔案數至少是同時讀資料的主機數的 10 倍,每個檔至少 10 MB,最好 100 MB 以上。例如 100 GB 資料用 4 台機器訓練,至少要 40 個檔;切成 500 個 200 MB 的檔兩個條件都滿足。檔太少平行度不夠,檔太小又回到開檔開銷太大的問題;如果算出來每檔不到 10 MB,就要減少檔案數。
大型 CSV 讀太慢怎麼辦?
一個巨大的 CSV 只有一個檔,不管開幾條線都只能排隊從頭讀。做法是先切成多個檔(例如 50 GB 切成 100 個 500 MB),再用 tf.data 的 interleave 加 num_parallel_calls 平行讀。tf.data 的 make_csv_dataset 可以一次接多個檔案。資料量真的很大時,另一個常見做法是直接放進 BigQuery 用 SQL 處理。
TPU 的批次大小為什麼要是 8 或 128 的倍數?
一顆 TPU 裝置有 8 個核心,會把一批資料平均切給 8 個核心,批次 128 每核心拿 16 筆;每個核心內部用 8 乘 128 的向量暫存器做矩陣乘法。所以 Cloud TPU 效能指南建議批次大小要能被 8 或 128 整除,而且在記憶體放得下的前提下用最大的批次。設 100 這種數字會切不平均,效率打折。
訓練資料放 Cloud Storage 怎麼讀最快?
四件事:bucket 和訓練工作放同一個區域;檔案大而少(打包成 TFRecord);用 tf.data 平行讀取加 prefetch;用分散式訓練把頻寬用滿。在 Agent Platform 上跑無伺服器訓練時,bucket 會用 Cloud Storage FUSE 掛載在 /gcs/ 底下,程式像讀本機檔案一樣讀。檢查點和日誌建議寫本機硬碟,不要直接寫 Cloud Storage。
Vertex AI Training 改名了嗎?
是。Vertex AI 在 2026 年 4 月改名為 Gemini Enterprise Agent Platform,Vertex AI Training 改叫 Gemini Enterprise Agent Platform Managed Training,Vertex AI Serverless Training 改叫 Gemini Enterprise Agent Platform Serverless Training。舊題庫看到 Vertex AI Training 或 custom training,就是現在的 Agent Platform Managed Training,功能一樣。
重點整理
- 先分清楚兩種慢:GPU 使用率低是輸入受限(在等資料),接近 100% 是運算受限。輸入受限換 GPU 沒用
- tf.data 四招:prefetch 讓讀資料和訓練重疊(一步時間從相加變取大)、interleave 加 num_parallel_calls 平行開檔、map 加 num_parallel_calls 平行前處理、cache 快取第一輪讀過的資料。全部可以用 AUTOTUNE
- 算一次:傻做法 0.6+0.3+0.4=1.3 秒;prefetch 後 max(0.9, 0.4)=0.9 秒;四招全開 max(0.225, 0.4)=0.4 秒,快 3.25 倍、GPU 使用率 31% → 100%
- TFRecords:把大量小檔打包成少量大檔,省掉開檔開銷;每檔 100 MB 以上、檔數是主機數的 10 倍以上;官方明說不是必要,先確認瓶頸
- 大 CSV 反過來:一個巨檔要先切成多檔,interleave 才有東西可以平行
- TPU:更容易輸入受限,用 num_parallel_reads+prefetch;批次大小是 8 或 128 的倍數
- GCP 上:資料放 Cloud Storage,bucket 跟訓練同一區域;Agent Platform 用 Cloud Storage FUSE 掛在 /gcs/;Vertex AI Training 現在叫 Agent Platform Managed Training
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 第 3 篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切
- 第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
- 第 6 篇:ROC 曲線和 AUC 怎麼看?門檻怎麼調、AUC-PR 差在哪
- 第 7 篇:過度擬合是什麼?正則化、Dropout、提前停止 3 招解決
- 第 8 篇:資料洩漏是什麼?模型考試作弊的 3 種常見情況
- 第 9 篇:類別不平衡怎麼辦?過取樣、欠取樣與 Upweighting
- 第 10 篇:資料前處理怎麼做?標準化、遺失值、高基數類別
- 第 11 篇:特徵工程是什麼?特徵交叉、詞嵌入、資料增強一次看懂
- 上一篇:第 12 篇:機器學習的資料隱私怎麼保護?DLP、聯邦學習、VPC Service Controls
- 下一篇:第 14 篇:Vertex AI AutoML、BigQuery ML、自訂訓練怎麼選?
站上相關文章
- 如何在 GCP 上建立含 GPU 的 AI 開發環境
- Google VM 平台 Compute Engine 是什麼?
- Dataflow 是什麼?跟 Apache Beam 有什麼關係?
- BigQuery 是資料庫嗎?跟資料庫差在哪
- Vertex AI 核心功能 Agent Builder、Model Builder 和 Model Garden 介紹
- GCP 帳單爆炸防護指南
資料整理好,也要餵得快,GPU 的錢才花得值。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。