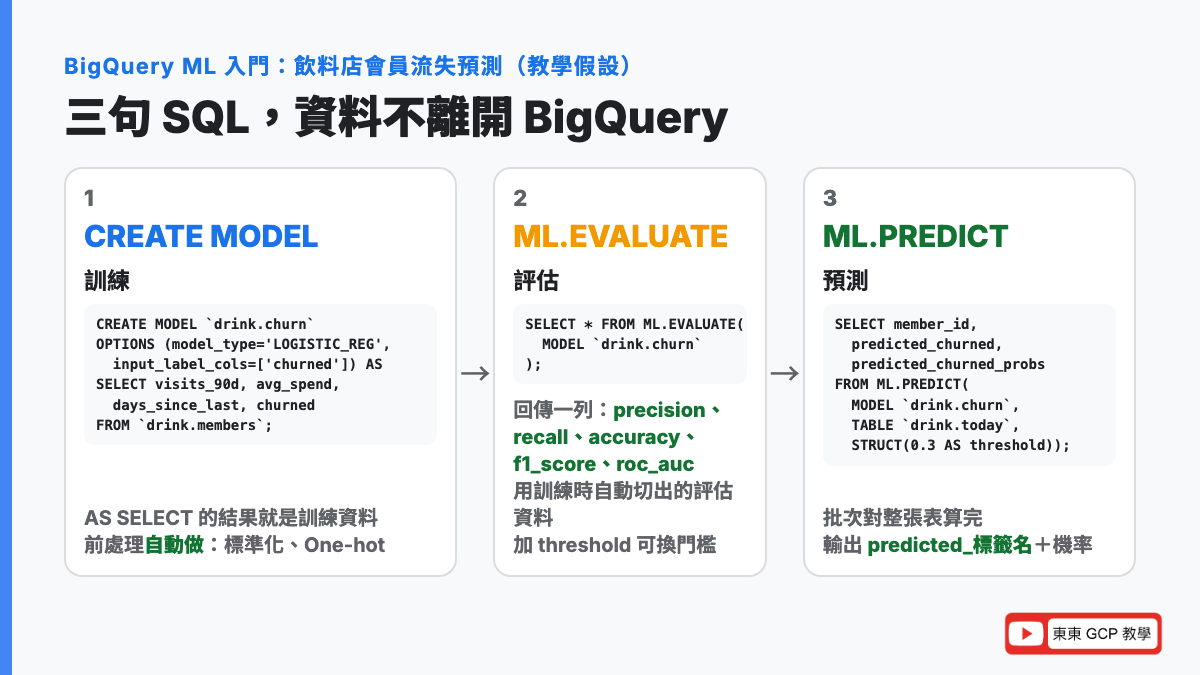
BigQuery ML 入門只要三句 SQL:CREATE MODEL 訓練、ML.EVALUATE 評估、ML.PREDICT 預測。
上一篇說,資料已經在 BigQuery、團隊會 SQL,就用 BigQuery ML。這篇就把它從頭到尾做一遍:怎麼寫、它背後幫你做了什麼、資料怎麼切、超參數怎麼調、要花多少錢。
一樣用有 2,000 間分店、50 萬名會員的連鎖飲料店當例子(教學假設),要做的是會員流失預測:哪些會員下個月不會再來?會員表和交易表都已經在 BigQuery 裡。
為什麼你需要知道
- 最低門檻的機器學習:Google 官方簡介說得很直接,以前做 ML 要會 Python 和 ML 框架,把「最懂資料的人」排除在外;BigQuery ML 讓會 SQL 的人也能做。官方的「需要什麼知識」那段寫著:用預設設定,沒什麼 ML 知識也能建模型
- 資料不用搬:幾 TB 的表搬去 Python 環境,光搬就要半天。BigQuery ML 把 ML 帶到資料旁邊
- 前面 14 篇學的東西都用得上:資料切分(第 4 篇)、評估指標(第 5、6 篇)、過度擬合(第 7 篇)、類別不平衡(第 9 篇)、前處理(第 10 篇)、特徵工程(第 11 篇)在 BigQuery ML 裡都有對應的開關。這篇會一個一個對回去
- 證照必考:PMLE 考試指南第 1.1 節整節都是它:用 BigQuery ML 建分類、迴歸、預測、分群模型;用 BigQuery ML 做特徵工程和特徵選擇;用 BigQuery ML 產生預測
先搞懂:BigQuery ML 是什麼
白話是什麼
BigQuery ML:在 BigQuery 裡用 SQL 指令建立、訓練、使用機器學習模型。模型跟表格一樣存在 BigQuery 的資料集裡。
幾個名詞先講:
- BigQuery:Google 的資料倉儲,存大量表格資料、用 SQL 查,站上有BigQuery 是什麼
- SQL:查詢表格的語言。
SELECT 姓名 FROM 會員表 WHERE 年齡 > 30這種句子 - 資料集(dataset):BigQuery 裡放表格的資料夾;表(table)就是一張表格;檢視(view)是存起來的查詢結果,看起來像表
- NULL:欄位裡的「空值」,代表沒填或不知道
比喻
倉庫旁邊的廚房(上一篇的比喻)。這篇要講的是這間廚房的爐子怎麼開、菜單上有什麼、哪些調味是自動的、瓦斯費怎麼算。
來龍去脈
BigQuery ML 剛推出時只有線性迴歸和邏輯迴歸兩種,現在官方清單已經有十幾種:監督式的線性/邏輯迴歸、DNN、Wide & Deep、提升樹、隨機森林、AutoML;非監督式的 K-means、矩陣分解、自動編碼器、PCA;時間序列的 ARIMA_PLUS;還能匯入外面訓練的模型、遠端呼叫 Gemini。
為什麼要學
這是 Google Cloud 上最快能看到結果的機器學習方式。會 SQL 的人,一個下午就能從資料表做出第一個模型。
1. 三句 SQL 做完一個模型
第 0 步:準備一張表
機器學習要的是「一列一個樣本、每欄一個特徵、其中一欄是答案」(第 3 篇)。先用 SQL 把會員表和交易表整理成這樣:
| member_id | visits_90d | avg_spend | days_since_last | member_months | city | churned |
|---|---|---|---|---|---|---|
| M001 | 12 | 65 | 3 | 18 | 台北 | 0 |
| M002 | 1 | 80 | 75 | 4 | 台中 | 1 |
| … |
visits_90d:最近 90 天來幾次;avg_spend:平均客單價;days_since_last:距離上次消費幾天;member_months:加入幾個月;city:城市churned:標籤,1 代表這位會員接下來一個月沒再來(流失),0 代表有來
答案欄怎麼來?用歷史資料「回頭看」:拿去年 6 月的會員狀態當特徵、7 月有沒有來當答案。這一步要小心資料洩漏(第 8 篇),特徵只能用 6 月以前知道的事。
第 1 句:CREATE MODEL 訓練
CREATE OR REPLACE MODEL `drink.churn_model`
OPTIONS (
  model_type = 'LOGISTIC_REG',
  input_label_cols = ['churned'],
  auto_class_weights = TRUE,
  enable_global_explain = TRUE
) AS
SELECT visits_90d, avg_spend, days_since_last, member_months, city, churned
FROM `drink.member_features`;
一行一行翻譯:
| 這一行 | 白話 |
|---|---|
CREATE OR REPLACE MODEL | 建一個模型,已經有同名的就覆蓋 |
model_type = 'LOGISTIC_REG' | 用邏輯迴歸(第 2 篇講的分類模型)。要做迴歸就改 LINEAR_REG,要用 XGBoost 改 BOOSTED_TREE_CLASSIFIER |
input_label_cols = ['churned'] | 哪一欄是答案 |
auto_class_weights = TRUE | 流失的會員比沒流失的少很多(第 9 篇的類別不平衡),這個開關會自動把少數類別加權。官方說明:依類別出現頻率的反比加權 |
enable_global_explain = TRUE | 訓練完順便算「哪些特徵整體最重要」,後面 ML.GLOBAL_EXPLAIN 會用到 |
AS SELECT ... | 訓練資料就是這個查詢的結果。沒選進來的欄位不會被用到 |
注意 member_id 沒有被 SELECT 進去。會員編號對「會不會流失」沒有意義,放進去只會讓模型記答案(第 7 篇過度擬合)。
第 2 句:ML.EVALUATE 評估
SELECT * FROM ML.EVALUATE(MODEL `drink.churn_model`);不給它資料,它會自動用訓練時切出來的評估資料算分數(切法下一節講)。分類模型會回傳一列:
| 欄位 | 就是第 5、6 篇的 |
|---|---|
precision | 精確率 |
recall | 召回率 |
accuracy | 準確率 |
f1_score | F1 |
log_loss | 對數損失(越小越好) |
roc_auc | AUC-ROC |
迴歸模型回傳的是 mean_absolute_error(MAE)、mean_squared_error、r2_score 這些(第 2 篇)。
要用別的門檻(第 6 篇),加 STRUCT(0.3 AS threshold) 這個參數;預設是 0.5。想看整張混淆矩陣用 ML.CONFUSION_MATRIX,想畫 ROC 曲線用 ML.ROC_CURVE。
第 3 句:ML.PREDICT 預測
SELECT member_id, predicted_churned, predicted_churned_probs
FROM ML.PREDICT(
  MODEL `drink.churn_model`,
  TABLE `drink.member_features_today`,
  STRUCT(0.3 AS threshold)
);- 輸入是今天的會員特徵表,欄位名稱要跟訓練時一樣
- 輸出多兩欄:
predicted_churned(預測的答案,0 或 1)和predicted_churned_probs(每個類別的機率)。欄位名稱規則是predicted_加上標籤欄的名字 threshold設 0.3:機率超過 30% 就判定會流失。流失預測寧可多抓(第 5 篇講的「追召回率」),門檻就調低
這是批次預測:一次對整張表算完,結果就是一張新的表,可以直接拿去寄挽留優惠。要做「會員一打開 App 就即時算」的線上預測,要走 Model Registry,第 17 篇講。
加碼:ML.EXPLAIN_PREDICT 看為什麼
SELECT * FROM ML.EXPLAIN_PREDICT(
  MODEL `drink.churn_model`,
  TABLE `drink.member_features_today`,
  STRUCT(3 AS top_k_features)
);官方說明:它是 ML.PREDICT 的加強版,每一列多回傳「哪幾個特徵對這筆預測貢獻最大」,top_k_features 預設 5 個。例如 M002 被判會流失,是因為 days_since_last = 75(75 天沒來)貢獻最大。第 21 篇可解釋 AI 會細講。
筆記裡寫的「BQML.PREDICT」「BQML.EXPLAIN_PREDICT」,正確名稱是 ML.PREDICT 和 ML.EXPLAIN_PREDICT。
2. 它幫你自動做了什麼:前處理
第 10 篇講的標準化、遺失值、One-hot,BigQuery ML 在 CREATE MODEL 時預設就自動做。官方自動前處理文件:
遺失值(NULL)怎麼補
| 欄位型態 | 自動補法 |
|---|---|
| 數字 | 用該欄的平均值補(訓練和預測都一樣) |
| 文字、布林(One-hot 過的) | 當成一個額外的類別「NULL」;預測時遇到沒看過的值,權重給 0 |
| 時間戳記 | 混合用:Unix 時間用平均值,其他拆出來的部分歸到 NULL 類別 |
套回例子:某位會員 avg_spend 是 NULL(從沒消費過),自動補成所有會員的平均客單價。這不一定是你要的(沒消費過跟平均客單價差很多),要自己控制就用下面的 TRANSFORM。
特徵怎麼轉換
| 輸入型態 | 自動轉換 | 例外 |
|---|---|---|
| 數字(INT64、FLOAT64…) | 標準化(第 10 篇:資料前處理怎麼做?標準化、遺失值、高基數類別 | 提升樹、隨機森林不做;K-means 由 STANDARDIZE_FEATURES 選項決定 |
| 文字、布林、日期 | One-hot 編碼(每個值一欄) | 提升樹、隨機森林改用標籤編碼(每個值換一個數字) |
| 陣列 | Multi-hot 編碼(每個元素一欄) | |
| 時間戳記 | 拆成年、月、星期幾等,數字的標準化、類別的 One-hot |
所以 city 這種文字欄直接丟進去就好,它會自動變成「台北、台中、高雄…」各一欄。
想自己控制:TRANSFORM 子句
第 11 篇講的特徵工程,用 TRANSFORM 寫在 CREATE MODEL 裡:
CREATE OR REPLACE MODEL `drink.churn_model_v2`
TRANSFORM (
  ML.QUANTILE_BUCKETIZE(avg_spend, 5) OVER () AS spend_bucket,
  ML.FEATURE_CROSS(STRUCT(city, spend_bucket)) AS city_x_spend,
  visits_90d, days_since_last, member_months, churned
)
OPTIONS (model_type = 'LOGISTIC_REG', input_label_cols = ['churned']) AS
SELECT * FROM `drink.member_features`;
ML.QUANTILE_BUCKETIZE(avg_spend, 5):客單價切成 5 個等人數的分桶(第 10 篇)ML.FEATURE_CROSS:城市 × 客單價桶的特徵交叉(第 11 篇)- 官方手動前處理文件列的函數還有
ML.STANDARD_SCALER、ML.MIN_MAX_SCALER、ML.BUCKETIZE、ML.IMPUTER(自己決定遺失值怎麼補)、ML.NGRAMS等
TRANSFORM 最大的好處:訓練時怎麼轉,ML.PREDICT 時自動用同樣的方式轉,連分桶的切點都沿用訓練時算的。這正是第 10 篇講的「訓練和上線前後不一致」(training-serving skew,第 20 篇會再講)的解法。官方特別寫了一句:分析函數在 TRANSFORM 裡用,訓練時收集的統計值會自動套用到預測輸入。
想把「轉換」和「訓練」分開管理,可以建一個只做轉換的模型(transform-only model),用 ML.TRANSFORM 看它轉出來的結果長什麼樣。
3. 資料怎麼切:AUTO_SPLIT 的規則
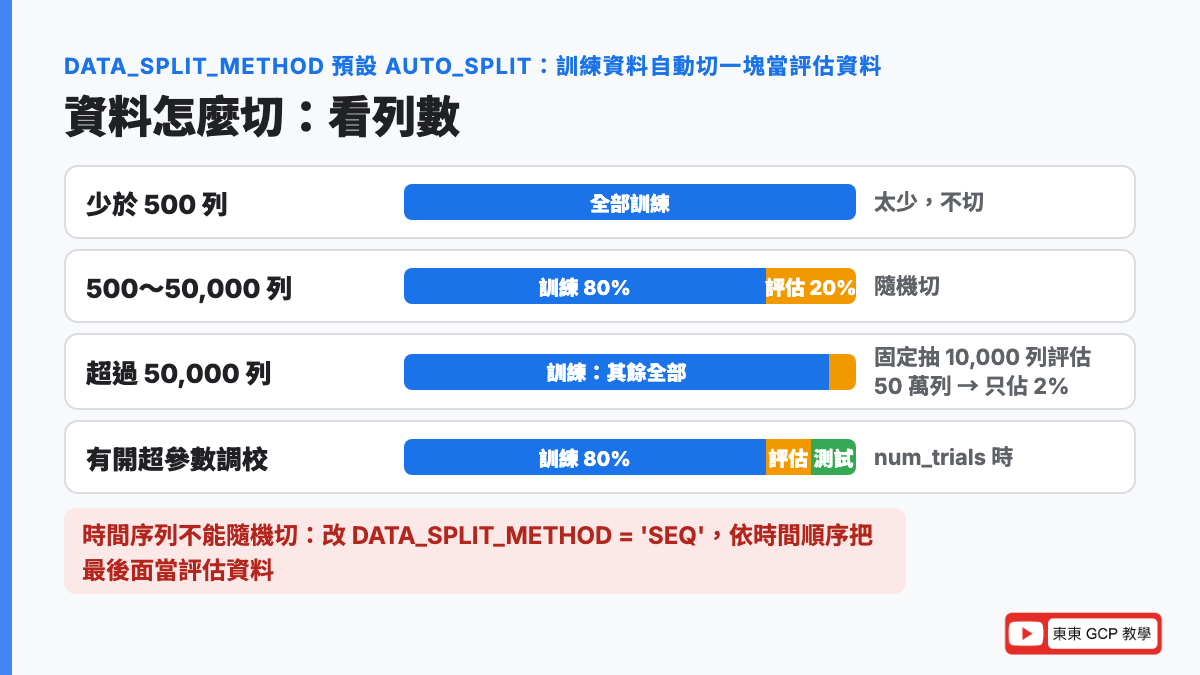
第 4 篇講過訓練集、驗證集要分開。BigQuery ML 用 DATA_SPLIT_METHOD 選項控制,官方說明的預設值是 AUTO_SPLIT,規則是:
| 輸入資料列數 | 怎麼切 |
|---|---|
| 少於 500 列 | 全部拿來訓練,不切 |
| 500 到 50,000 列 | 隨機 20% 當評估資料、80% 訓練 |
| 超過 50,000 列 | 隨機抽 10,000 列當評估資料,其餘訓練 |
| 有開超參數調校(超過 500 列) | 80% 訓練、10% 評估、10% 測試 |
算一次
飲料店 50 萬名會員 → 超過 50,000 列
評估資料 = 10,000 列(固定)
訓練資料 = 500,000 − 10,000 = 490,000 列
評估比例 = 10,000 ÷ 500,000 = 2%
資料越多,評估比例越小,因為 10,000 列已經夠算出穩定的分數,多切只是浪費訓練資料。
其他切法
| 選項 | 什麼時候用 |
|---|---|
RANDOM | 自己指定評估比例(DATA_SPLIT_EVAL_FRACTION) |
SEQ | 依順序切,最後面的當評估資料。第 4 篇講的時間序列不能亂切,就用這個,搭配 DATA_SPLIT_COL 指定時間欄 |
CUSTOM | 自己加一欄 TRUE/FALSE 標哪些是評估資料 |
NO_SPLIT | 全部訓練,自己另外準備評估資料給 ML.EVALUATE |
官方邏輯迴歸教學用的就是自己切:加一欄 dataframe,標 training、evaluation、prediction 三種,訓練時只選 training 的列,評估時把 evaluation 的列餵給 ML.EVALUATE。
評估資料的用途,官方寫得很清楚:用提前停止來避免過度擬合(第 7 篇)。每一輪訓練完看評估資料的損失有沒有進步,進步幅度小於 MIN_REL_PROGRESS 就停,開關是 EARLY_STOP(預設開)。
4. 超參數怎麼調
第 3 篇說超參數是「訓練前自己決定的設定」,例如正則化強度 L1_REG、L2_REG(第 7 篇)、學習率。手動一個一個試很累,BigQuery ML 的超參數調校讓它自己試:
CREATE OR REPLACE MODEL `drink.churn_model_tuned`
OPTIONS (
  model_type = 'LOGISTIC_REG',
  input_label_cols = ['churned'],
  num_trials = 20,
  l1_reg = HPARAM_RANGE(0, 1),
  l2_reg = HPARAM_CANDIDATES([0, 0.1, 1, 10])
) AS
SELECT * FROM `drink.member_features`;
num_trials = 20:試 20 組HPARAM_RANGE(0, 1):在 0 到 1 之間找HPARAM_CANDIDATES([...]):從這幾個值裡挑- 跑完用
ML.TRIAL_INFO看每一組的分數,ML.EVALUATE預設回傳最好的那組
支援調校的模型:線性/邏輯迴歸、K-means、矩陣分解、自動編碼器、提升樹、隨機森林、DNN、Wide & Deep。AutoML 本來就內建自動調校;ARIMA_PLUS 用 AUTO_ARIMA 自動找趨勢參數。
5. 不只分類:時間序列和分群
時間序列:ARIMA_PLUS
飲料店要預測每間分店未來 30 天的銷量,官方教學的寫法:
CREATE OR REPLACE MODEL `drink.sales_forecast`
OPTIONS (
  model_type = 'ARIMA_PLUS',
  time_series_timestamp_col = 'sale_date',
  time_series_data_col = 'daily_sales',
  time_series_id_col = 'store_id',
  holiday_region = 'TW'
) AS
SELECT sale_date, daily_sales, store_id FROM `drink.daily_sales`;

SELECT * FROM ML.FORECAST(MODEL `drink.sales_forecast`,
STRUCT(30 AS horizon, 0.8 AS confidence_level));time_series_id_col:一次幫 2,000 間分店各做一個模型holiday_region:把台灣的假日效應算進去(官方教學用美國假日舉例)ML.FORECAST的horizon = 30是預測未來 30 天,confidence_level = 0.8是給 80% 的預測區間(上下界)- 官方簡介提到,ARIMA_PLUS 會自動處理異常值、季節性、假日;
ML.EXPLAIN_FORECAST可以把趨勢、季節性拆開看
不想管模型,官方簡介說可以用 AI.FORECAST 函數搭內建的 TimesFM 模型(預覽階段)直接預測。
分群:K-means
不知道會員分幾種,想讓模型自己找(第 1 篇的非監督式學習):model_type = 'KMEANS',不用 input_label_cols,因為沒有答案。預測結果是每位會員屬於哪一群(CENTROID_ID),ML.CENTROIDS 看每一群的中心長什麼樣。
推薦:矩陣分解
「猜你想點」:model_type = 'MATRIX_FACTORIZATION',輸入是「誰買過什麼、評幾分」,ML.RECOMMEND 回傳每位會員對每種飲料的預測評分。官方定價頁註明矩陣分解只開放給 Editions 或有保留算力的客戶。
要更強的模型
BOOSTED_TREE_CLASSIFIER(XGBoost)、DNN_CLASSIFIER、AUTOML_CLASSIFIER 這些寫法一樣是 SQL,但官方簡介說它們是「在 Agent Platform 訓練」:BigQuery 把工作送去 Agent Platform(原 Vertex AI)算完再拿回來。你感覺不到差別,只有費用算法不同(下一節)。
6. 要花多少錢:算一次
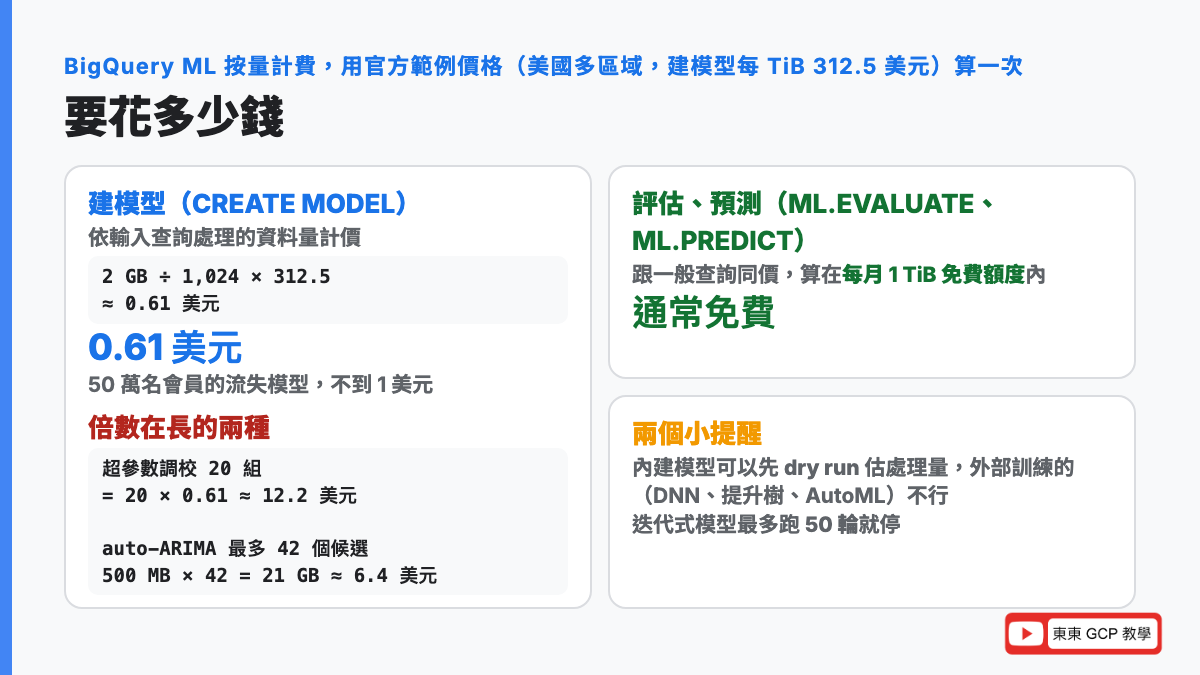
官方定價頁的 BigQuery ML 段落,重點是:
- 按量計費(on-demand)時,依「操作類型」收費:建模型、評估、檢查、預測各有價格
- 評估、檢查、預測跟一般查詢同價,而且算在每月 1 TiB 的免費額度裡
- 建模型(CREATE MODEL)是另一個價格,依輸入查詢處理的資料量計算
- 超參數調校:每一組試驗都是一次建模型,費用是所有試驗的總和
- 時間序列開 auto-ARIMA:會試很多候選模型,處理的位元組數要乘上候選模型數(
AUTO_ARIMA_MAX_ORDER設 5 時最多 42 個) - 迭代式模型最多跑 50 輪就停
- 用 Editions(買算力)的話,BigQuery ML 包含在裡面;外部訓練的模型(DNN、提升樹、AutoML)要另外用
ML_EXTERNAL類型的保留算力
官方頁面有一個計算範例,美國多區域的建模型價格是每 TiB 312.5 美元。套到飲料店(台灣區域價格請看定價頁,這裡用官方範例的數字):
會員特徵表 2 GB
建模型費用 = 2 ÷ 1,024 TiB × 312.5 美元 ≈ 0.61 美元

超參數調校 20 組試驗
= 20 × 0.61 ≈ 12.2 美元

ARIMA_PLUS 開 auto-ARIMA、AUTO_ARIMA_MAX_ORDER = 5
銷售表 500 MB × 42 個候選模型 = 21 GB 的處理量
≈ 21 ÷ 1,024 × 312.5 ≈ 6.4 美元數字怎麼看:
- 一個 2 GB 的表建模型不到 1 美元,這就是「最快看到結果」的代價,很便宜
- 超參數調校和 auto-ARIMA 是倍數在長,試驗組數和候選模型數決定費用
ML.PREDICT對 50 萬列預測,就是掃一次表的查詢費,通常在免費額度內- 內建模型可以先 dry run(試跑不執行)估處理量;外部訓練的模型不能
站上有一篇 BigQuery 計費方式,按量和 Editions 的差別那篇講得更細。
在 GCP 上怎麼做
1. 從哪裡下 SQL
官方簡介列的入口:Google Cloud 主控台的查詢編輯器、bq 命令列工具、REST API、BigQuery 裡的 Colab Enterprise 筆記本、外部工具(Jupyter、BI 平台)。會 Python 的人也可以用 BigQuery DataFrames(bigframes),官方教學每一步都有 SQL 和 DataFrames 兩種寫法。
2. 資料先進 BigQuery
CSV、Cloud Storage、串流、其他資料庫都有辦法,站上有一篇把資料上傳到 BigQuery 的各種方法。
3. 要線上預測:註冊到 Model Registry
ML.PREDICT 是批次。要做「App 一打開就即時算流失機率」,官方文件的做法是在 CREATE MODEL 加上:
OPTIONS (
  model_type = 'LOGISTIC_REG',
  input_label_cols = ['churned'],
  model_registry = 'VERTEX_AI',
  vertex_ai_model_id = 'churn_model'
)
模型會自動註冊到 Agent Platform 的 Model Registry,不用匯出、不用自己做服務容器,就能部署成端點做線上預測、管版本。需要 roles/aiplatform.admin 權限,而且要先開 Agent Platform API。部署的細節第 17 篇講。
4. 改名對照
| 舊名稱 | 現在 |
|---|---|
| BQML、BigQuery ML | 沒變 |
| BQML.PREDICT(筆記寫法) | ML.PREDICT |
| Vertex AI Model Registry | Gemini Enterprise Agent Platform Model Registry(SQL 選項名稱仍是 model_registry = 'VERTEX_AI') |
| 「在 Vertex AI 訓練」的外部模型 | 在 Agent Platform 訓練,寫法不變 |
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這篇的內容對應到:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 1 區:設計低程式碼 AI 方案(約 13%) | 1.1 用 BigQuery ML 建模型(分類、迴歸、預測、分群);用 BigQuery ML 做特徵工程或特徵選擇;用 BigQuery ML 產生預測;用 BigQuery 微調 Gemini |
| 第 3 區:把原型放大成 ML 模型(約 21%) | 3.1 選模型類型(ARIMA、DNN…)、選產品(BigQuery ML…) |
| 第 5 區:自動化與編排 ML 管線(約 18%) | 5.1 確保訓練和服務的前處理一致(TRANSFORM 子句就是這個) |
看到這些字,就想到這個
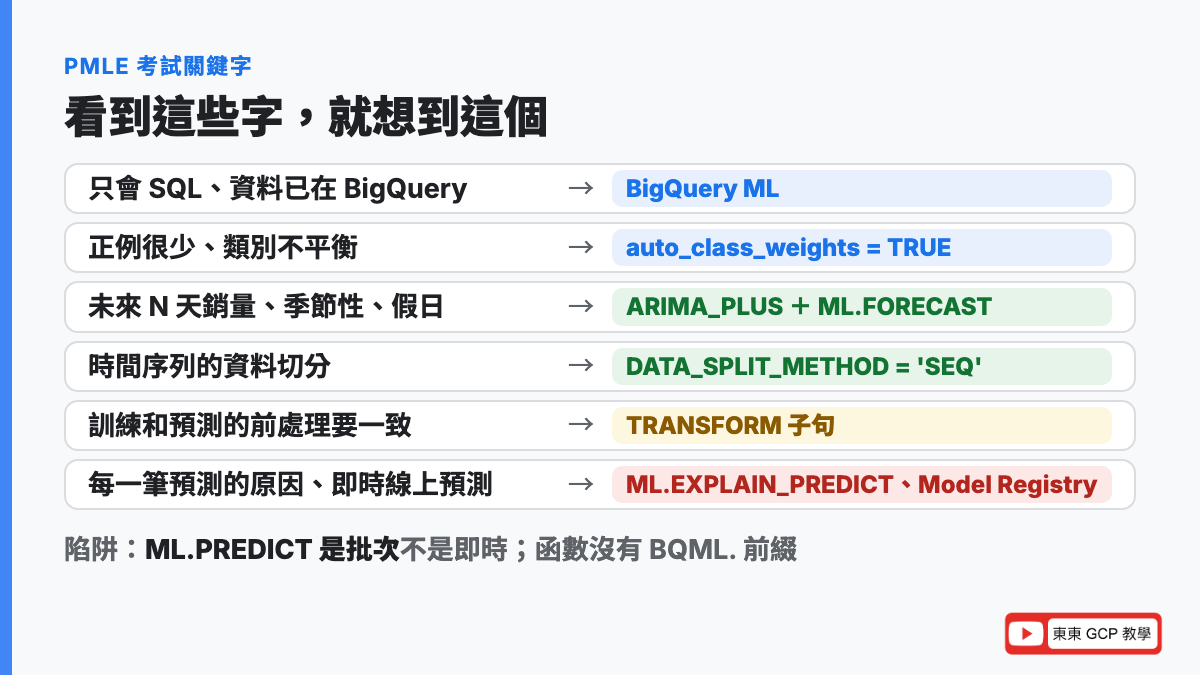
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「資料分析師」「只會 SQL」「資料在 BigQuery」「最快上線」 | BigQuery ML |
| 「是或不是」「會不會流失」 | LOGISTIC_REG(或 BOOSTED_TREE_CLASSIFIER) |
| 「預測金額」「連續數值」 | LINEAR_REG |
| 「未來 N 天銷量」「季節性」「假日」 | ARIMA_PLUS+ML.FORECAST;資料切分用 SEQ |
| 「會員分幾群」「沒有標籤」 | KMEANS |
| 「推薦商品」「誰買過什麼」 | MATRIX_FACTORIZATION+ML.RECOMMEND |
| 「正例很少」「不平衡」 | auto_class_weights = TRUE |
| 「訓練和預測的前處理要一致」「避免 skew」 | TRANSFORM 子句 |
| 「每一筆預測的原因」 | ML.EXPLAIN_PREDICT;整體重要性用 ML.GLOBAL_EXPLAIN |
| 「調整門檻」「寧可多抓」 | ML.PREDICT 或 ML.EVALUATE 的 threshold 參數 |
| 「自動找最佳正則化」 | num_trials+HPARAM_RANGE/HPARAM_CANDIDATES |
| 「用 SQL 但要 AutoML 的效果」 | AUTOML_CLASSIFIER/AUTOML_REGRESSOR |
| 「即時預測」「線上端點」 | model_registry = 'VERTEX_AI' 註冊到 Model Registry,部署端點 |
| 「控制建模型的費用」 | 內建模型先 dry run;減少試驗組數;注意 auto-ARIMA 的候選數 |
六個常見陷阱
- 把會員編號當特徵丟進去:模型會記答案,評估分數虛高、上線沒用
- 時間序列用預設的 AUTO_SPLIT:預設是隨機切,未來的資料會混進訓練集(第 4、8 篇),要用
SEQ - 訓練前自己在外面做標準化,預測時忘了做:訓練和上線不一致。放進 TRANSFORM 就不會忘
- 不平衡資料忘了
auto_class_weights:模型全猜「不流失」也有 95% 準確率,召回率卻是 0 - 以為 ML.PREDICT 是即時的:它是批次,線上預測要走 Model Registry 部署端點
- 超參數調校的費用當成一次:是試驗組數的倍數
練習情境(自己出的練習,不是真實考題)
飲料店的分析師要用 BigQuery 裡的會員資料預測流失,流失會員只佔 5%。她希望寧可多抓一些可能流失的人,也不要漏掉。應該怎麼設定?
判斷過程:
- 「BigQuery 裡」「分析師」→ BigQuery ML,
LOGISTIC_REG - 「只佔 5%」→
auto_class_weights = TRUE - 「寧可多抓」→ 追召回率,
ML.PREDICT的threshold調低(例如 0.3),用ML.EVALUATE加同樣的 threshold 確認召回率
同一家店要預測每間分店未來兩週的日銷量,資料是過去三年的每日銷售表。分析師直接用預設設定訓練,發現評估分數好得不像真的。問題出在哪?
判斷過程:
- 「好得不像真的」→ 懷疑資料洩漏(第 8 篇)
- 「時間序列」「預設設定」→ AUTO_SPLIT 是隨機切,未來的資料跑進訓練集
- 解法:用
ARIMA_PLUS這類時間序列模型,或一般模型改data_split_method = 'SEQ'依時間切
模型上線後,工程師發現預測結果跟訓練時差很多。追查發現訓練前分析師用 Python 把客單價做了分桶,但上線時的 SQL 沒有分桶。怎麼避免?
判斷過程:
- 「訓練和上線的前處理不一樣」→ 訓練/服務偏差(第 20 篇)
- 解法:把分桶寫進
CREATE MODEL的 TRANSFORM 子句(ML.QUANTILE_BUCKETIZE),ML.PREDICT會自動用訓練時的切點
常見問答
BigQuery ML 怎麼入門?
三句 SQL:CREATE MODEL 指定模型類型和標籤欄、用 SELECT 給訓練資料;ML.EVALUATE 看精確率、召回率、AUC 這些分數;ML.PREDICT 對一張表批次預測,輸出多兩欄 predicted_標籤名 和機率。資料全程留在 BigQuery,不用寫 Python。官方的邏輯迴歸教學用美國人口普查資料走一遍,照著做一個下午就能完成。
BigQuery ML 支援哪些模型?
內建的有線性迴歸、邏輯迴歸、K-means 分群、矩陣分解(推薦)、PCA、ARIMA_PLUS 時間序列、貢獻分析;透過 Agent Platform 訓練的有 DNN、Wide & Deep、自動編碼器、提升樹(XGBoost)、隨機森林、AutoML;還能匯入 TensorFlow、ONNX、XGBoost 模型,或遠端呼叫 Gemini。寫法都是 CREATE MODEL 加 model_type。
BigQuery ML 會自動做前處理嗎?
會。訓練時數字欄自動標準化(提升樹和隨機森林除外),文字、布林、日期欄自動 One-hot 編碼,時間戳記自動拆成年月星期等,NULL 數字補平均值、NULL 類別當成額外的類別。想自己控制就用 TRANSFORM 子句,裡面可以用 ML.STANDARD_SCALER、ML.BUCKETIZE、ML.FEATURE_CROSS、ML.IMPUTER 等函數,而且預測時會自動套用同樣的轉換。
BigQuery ML 的資料怎麼切訓練集和評估集?
預設 AUTO_SPLIT:少於 500 列全部訓練;500 到 50,000 列隨機切 20% 評估;超過 50,000 列固定抽 10,000 列評估;有開超參數調校則 80% 訓練、10% 評估、10% 測試。時間序列資料要改用 SEQ 依順序切,否則未來的資料會混進訓練集。也可以用 CUSTOM 自己標,或 NO_SPLIT 另外準備評估資料。
BigQuery ML 怎麼處理類別不平衡?
邏輯迴歸模型在 CREATE MODEL 加 auto_class_weights = TRUE,它會依每個類別出現頻率的反比加權,少數類別的每一筆都算比較重。另外在 ML.PREDICT 和 ML.EVALUATE 用 threshold 參數調門檻,流失預測這種寧可多抓的情境把門檻調低。
ML.PREDICT 和 ML.EXPLAIN_PREDICT 差在哪?
ML.PREDICT 只給預測結果和機率;ML.EXPLAIN_PREDICT 是它的加強版,每一列多回傳貢獻最大的幾個特徵和貢獻值,top_k_features 預設 5 個。想看模型整體哪些特徵最重要,訓練時開 enable_global_explain,再用 ML.GLOBAL_EXPLAIN 查。筆記裡的 BQML.PREDICT、BQML.EXPLAIN_PREDICT 是舊寫法,正確名稱是 ML.PREDICT、ML.EXPLAIN_PREDICT。
BigQuery ML 可以調超參數嗎?
可以。CREATE MODEL 設 num_trials 指定試幾組,超參數用 HPARAM_RANGE 給範圍或 HPARAM_CANDIDATES 給候選值,跑完用 ML.TRIAL_INFO 看每組分數。支援線性/邏輯迴歸、K-means、矩陣分解、自動編碼器、提升樹、隨機森林、DNN、Wide & Deep。費用是每一組試驗的總和。
BigQuery ML 能做時間序列預測嗎?
能。model_type 設 ARIMA_PLUS,指定時間欄和數值欄,用 time_series_id_col 可以一次對很多個序列(例如每間分店)各建一個模型,holiday_region 加入假日效應。預測用 ML.FORECAST 給 horizon(預測幾期)和 confidence_level(預測區間)。它會自動處理異常值、季節性、假日。不想管模型可以用 AI.FORECAST 搭內建的 TimesFM。
BigQuery ML 要多少錢?
按量計費時,評估和預測跟一般查詢同價,算在每月 1 TiB 免費額度內;建模型另外計價,依輸入查詢處理的資料量算,官方範例美國多區域是每 TiB 312.5 美元,2 GB 的表約 0.61 美元。超參數調校是試驗組數的倍數,auto-ARIMA 是候選模型數的倍數。用 Editions 的話 BigQuery ML 包在裡面,外部訓練的模型要用 ML_EXTERNAL 保留算力。
BigQuery ML 的預測是即時的嗎?
ML.PREDICT 是批次預測,一次對整張表算完。要做即時的線上預測,在 CREATE MODEL 加 model_registry = ‘VERTEX_AI’ 把模型註冊到 Agent Platform 的 Model Registry,不用匯出、不用自己做服務容器,就能部署成端點。
不會寫 SQL 能用 BigQuery ML 嗎?
官方簡介提到 Google Cloud 主控台有圖形介面可以操作模型(預覽階段),也可以用 BigQuery DataFrames 寫 Python。但 BigQuery ML 的設計初衷就是給會 SQL 的人,SQL 是它最完整的介面,建議至少學會 SELECT、WHERE、GROUP BY 這幾個基本句型。
重點整理
- 三句 SQL:
CREATE MODEL(model_type+input_label_cols+AS SELECT)→ML.EVALUATE(precision、recall、roc_auc…)→ML.PREDICT(predicted_標籤名+機率,threshold 可調) - 自動前處理:數字標準化、類別 One-hot、NULL 補平均值或當額外類別;要自己控制用 TRANSFORM,預測時自動套用同樣轉換,解決訓練/服務偏差
- 資料切分:AUTO_SPLIT 預設 < 500 全訓練、500~50,000 切 20%、> 50,000 抽 10,000 列;時間序列用 SEQ
- 不平衡:
auto_class_weights = TRUE;超參數:num_trials+HPARAM_RANGE/HPARAM_CANDIDATES - 其他模型:
ARIMA_PLUS+ML.FORECAST(時間序列)、KMEANS(分群)、MATRIX_FACTORIZATION(推薦)、BOOSTED_TREE/DNN/AUTOML(在 Agent Platform 訓練) - 費用:評估、預測同一般查詢價;建模型依處理量另計;調校和 auto-ARIMA 是倍數
- 線上預測:
model_registry = 'VERTEX_AI'註冊到 Model Registry 再部署端點;函數名稱是ML.PREDICT不是 BQML.PREDICT
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 第 3 篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切
- 第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
- 第 6 篇:ROC 曲線和 AUC 怎麼看?門檻怎麼調、AUC-PR 差在哪
- 第 7 篇:過度擬合是什麼?正則化、Dropout、提前停止 3 招解決
- 第 8 篇:資料洩漏是什麼?模型考試作弊的 3 種常見情況
- 第 9 篇:類別不平衡怎麼辦?過取樣、欠取樣與 Upweighting
- 第 10 篇:資料前處理怎麼做?標準化、遺失值、高基數類別
- 第 11 篇:特徵工程是什麼?特徵交叉、詞嵌入、資料增強一次看懂
- 第 12 篇:機器學習的資料隱私怎麼保護?DLP、聯邦學習、VPC Service Controls
- 第 13 篇:訓練資料讀太慢?TFRecords、tf.data 與 prefetch 加速
- 上一篇:第 14 篇:Vertex AI AutoML、BigQuery ML、自訂訓練怎麼選?
- 下一篇:第 16 篇:Vertex AI 自訂訓練:容器、分散式訓練、GPU 與 TPU
站上相關文章
- BigQuery 是什麼?功能、組成元件、特色和優勢完整介紹
- BigQuery 是資料庫嗎?跟資料庫差在哪
- 把資料上傳到 BigQuery 的各種方法和步驟
- BigQuery 計費方式完整介紹
- BigQuery 成功案例:Home Depot 導入 GCP 的案例解析
- GCP 證照 Data Engineer 怎麼考?
會 SQL 就能做機器學習,這是最低門檻的起點。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。