Vertex AI 自訂訓練是把訓練程式打包成容器,交給 Agent Platform 開機器、裝 GPU 或 TPU、跑完收機器。
第 14 篇說,AutoML 和 BigQuery ML 做不到的事(自訂架構、特定框架、幾十張 GPU)就走自訂訓練。這篇把它拆開:程式怎麼打包、機器怎麼選、多台怎麼分工、超參數怎麼自動調、要花多少錢。
一樣用有 2,000 間分店的連鎖飲料店當例子(教學假設):研究團隊用 PyTorch 寫好了「猜你想點」推薦模型,有自訂的損失函數,資料是 50 萬名會員三年的交易紀錄,放在 Cloud Storage。現在要把它放到雲端上跑。
為什麼你需要知道
- GPU 很貴,選錯更貴:一張高階 GPU 一小時的租金,比一台普通機器一天還貴。機型選錯、該用 Spot 沒用、4 張 GPU 跑出 1 張的效果,錢就這樣燒掉
- 這是「自己煮」的那條路:第 14 篇的比喻,Google 只出爐子。爐子有幾種、怎麼開、幾個人一起炒,都要自己決定
- 筆記裡的名稱全改了:Vertex AI Training 現在叫 Agent Platform Managed Training,底下分無伺服器訓練和訓練叢集;更早的 AI Platform Training 已經在 2025 年 4 月關閉
- 證照必考:PMLE 考試指南第 3.2 節「用不同 SDK 訓練模型(Agent Platform 自訂訓練、GKE 上的 Kubeflow…)」「排除訓練失敗」「超參數調校」,第 3.3 節「評估 CPU、GPU、TPU」「GPU 和 TPU 上的資料平行與模型平行分散式訓練」。整個第 3 區佔 21%,是最大的一區
先搞懂:自訂訓練是什麼
白話是什麼
自訂訓練(custom training):你自己寫訓練程式,用任何框架;Agent Platform 負責開虛擬機器、裝加速器、把你的程式跑起來、跑完把機器收掉,只收用到的時間。
虛擬機器(VM)是雲端上租來的一台電腦,站上有一篇 Compute Engine 是什麼。
比喻
自己煮,但廚房是租的、按小時算。你帶著食譜(程式)和食材(資料)進去,想用幾個爐(GPU)、幾間廚房(機器)自己說,煮完走人,只付用到的時間。
來龍去脈
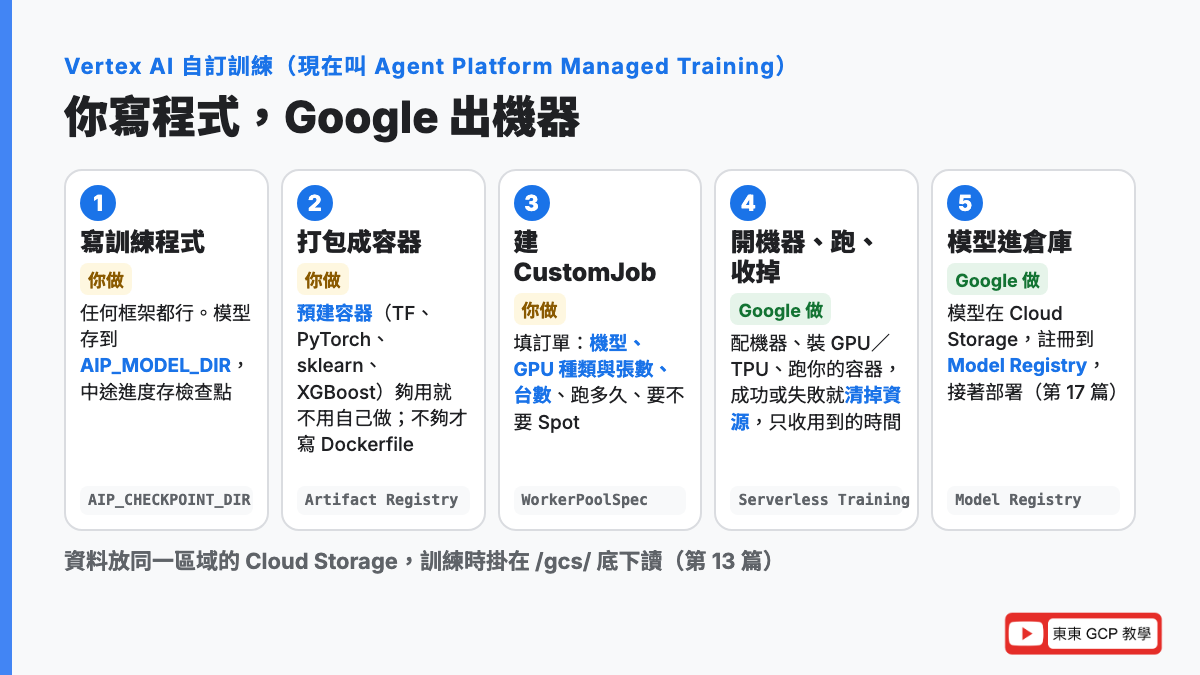
官方容器總覽描述的流程:
- 用你選的框架寫訓練程式
- 決定用預建容器還是自訂容器
- 資料放在 Agent Platform 讀得到的地方(Cloud Storage、Bigtable),跟訓練同一個專案和區域
- 建好 Docker 映像檔,推到 Artifact Registry
- 建自訂工作(CustomJob)送出
- Agent Platform 依設定開一台或多台機器(叫訓練執行個體),跑你的映像檔
- 成功或遇到無法復原的錯誤,就停掉所有程序、清掉資源
名稱的演變:最早叫 AI Platform Training(舊題庫還看得到,官方淘汰清單寫 2025 年 4 月 7 日關閉)→ Vertex AI custom training → 2026 年 4 月起叫 Gemini Enterprise Agent Platform Managed Training,底下分兩種跑法(第 6 節)。
為什麼要學
這是 PMLE 第 3 區的主軸,也是「能不能真的把一個研究模型放上雲端」的分水嶺。
1. 容器:預建的還是自己做
白話是什麼
容器(container):把程式和它需要的所有東西(框架、函式庫、系統工具)打包成一個標準箱子,到哪台機器都能原樣跑。Docker 是做這種箱子最常用的工具,箱子的設計圖叫 Dockerfile,做好的箱子叫映像檔(image)。站上有一篇容器是什麼。
比喻
出國比賽的行李箱。裡面裝好球拍、球鞋、水壺,到了場地打開就能上場,不用在當地到處找器材。
預建容器:Google 幫你裝好了
Google 提供預建容器,常用框架都有:TensorFlow、PyTorch、scikit-learn、XGBoost,分 CPU 和 GPU 版本,映像檔名稱像 pytorch-gpu.2-x、tf-gpu.2-17、xgboost-cpu.2-1。
用預建容器時,你不用碰 Docker,只要把訓練程式打包成 Python 套件放到 Cloud Storage,建工作時指定「用哪個預建容器」就好。
自訂容器:四種情況才需要
官方容器總覽列的好處,反過來就是「什麼時候要自己做」:
| 情況 | 例子 |
|---|---|
| 預建容器沒有你要的框架或版本 | 要用 tf-nightly 這種最新版、要用 JAX |
| 有非 ML 的相依套件或二進位檔 | 程式要呼叫某個 C++ 工具 |
| 想要更快啟動 | 相依套件事先裝好,不用每次啟動再裝 |
| 用任意框架做分散式訓練 | 預建容器以外的框架要多台跑 |
套回飲料店:研究團隊的 PyTorch 模型如果只用標準套件,預建的 PyTorch GPU 容器就夠;如果用了特殊的推薦系統函式庫,就要自訂。
做 GPU 容器有一個特別要求:官方建議用 nvidia/cuda 當基底映像檔,裡面已經裝好對應版本的 CUDA 和 cuDNN(NVIDIA 讓程式能用 GPU 的兩個基礎套件),環境變數也設好了。
自訂容器的流程
官方步驟:寫 Dockerfile(裝相依套件、複製訓練程式、設定進入點)→ 本機 build → 推到 Artifact Registry(Google 的映像檔倉庫,可以想成放 Docker 箱子的雲端儲物櫃)→ 建工作時用這個映像檔的網址。
為什麼要學
考題看到「預建容器不支援的框架」「特定版本」「非 ML 相依」就是自訂容器;看到「標準 TensorFlow/PyTorch 程式、最少設定」就是預建容器。
2. CustomJob:告訴 Google 要幾台、什麼機器
白話是什麼
自訂工作(CustomJob)是一張「訂單」,寫清楚:用哪個容器、幾台機器、每台什麼規格、幾張 GPU、跑多久要停。
官方文件的核心欄位是 WorkerPoolSpec(工作池規格):
| 欄位 | 白話 | 飲料店的推薦模型 |
|---|---|---|
machineSpec.machineType | 機型(CPU 幾核、記憶體多大) | n1-standard-16 |
machineSpec.acceleratorType | GPU 或 TPU 的種類 | NVIDIA_TESLA_T4 |
machineSpec.acceleratorCount | 每台機器幾張 | 2 |
replicaCount | 這種機器開幾台 | 1 |
containerSpec.imageUri 或 pythonPackageSpec | 自訂容器的映像檔,或預建容器+Python 套件 | 預建 PyTorch GPU 容器 |
scheduling.timeout | 最多跑多久 | 12 小時 |
用指令建一個工作長這樣:
gcloud ai custom-jobs create \
  --region=asia-east1 \
  --display-name=drink-recsys \
  --worker-pool-spec=machine-type=n1-standard-16,replica-count=1,accelerator-type=NVIDIA_TESLA_T4,accelerator-count=2,executor-image-uri=asia-docker.pkg.dev/vertex-ai/training/pytorch-gpu.2-4.py310:latest,local-package-path=.,script=train.py
程式裡拿得到的環境變數
訓練程式不用寫死路徑,Agent Platform 會給三個環境變數(程式啟動時可以讀到的設定值):
| 變數 | 用途 |
|---|---|
AIP_MODEL_DIR | 訓練完的模型存這裡(Cloud Storage 路徑),之後上傳到 Model Registry 會直接用 |
AIP_CHECKPOINT_DIR | 存檢查點(訓練中途的進度存檔) |
AIP_TENSORBOARD_LOG_DIR | 存 TensorBoard 的紀錄(第 22 篇) |
資料怎麼讀,第 13 篇講過:Cloud Storage 會掛在 /gcs/ 底下。
3. CPU、GPU 還是 TPU:怎麼選
三種硬體的白話
- CPU:電腦的大腦,什麼都會做,但同時只能做幾件事
- GPU:原本畫遊戲畫面的晶片,擅長同時做幾千個簡單算術,NVIDIA 做的最常見
- TPU:Google 自己設計、專門做機器學習的晶片。官方簡介說它專門做「大型矩陣運算」,有晶片上的高頻寬記憶體,可以接成一組(叫 slice)擴大規模。程式要先經過 XLA 編譯器翻成 TPU 能跑的機器碼
矩陣運算可以想成「一大批數字同時相乘相加」,神經網路的每一層就是在做這件事。
官方的選擇指南
Cloud TPU 簡介直接列了三種硬體各適合什麼:
| 適合的情況 | |
|---|---|
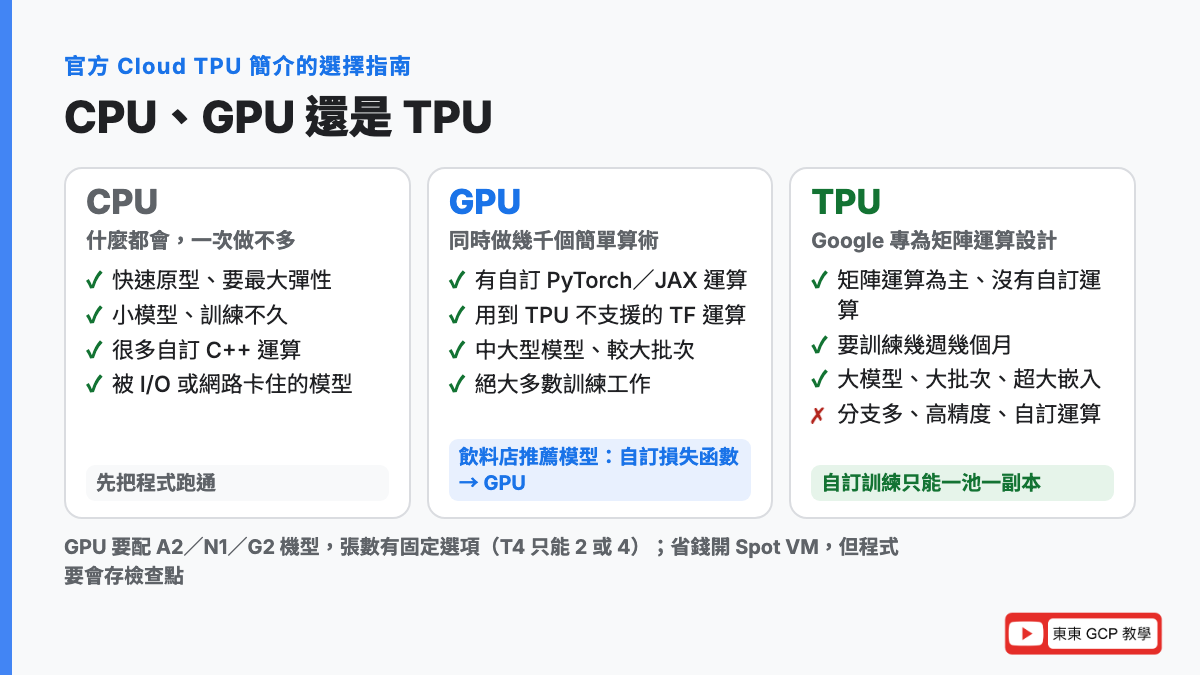
| CPU | 快速原型、需要最大彈性;小模型、訓練不久;很多自訂 C++ 運算;被 I/O 或網路頻寬卡住的模型 |
| GPU | 有很多自訂 PyTorch/JAX 運算、要部分在 CPU 跑;用到 TPU 不支援的 TensorFlow 運算;中大型模型、較大的批次 |
| TPU | 以矩陣運算為主;主訓練迴圈裡沒有自訂運算;要訓練幾週幾個月;大模型、大批次;進階推薦和排序系統常見的超大嵌入 |
TPU 不適合:需要頻繁分支或大量逐元素運算的程式、需要高精度算術、主訓練迴圈有自訂運算。
套回飲料店:推薦模型有自訂損失函數(自訂運算)、用 PyTorch,而且不是訓練幾週的規模 → GPU。要是改成標準架構、資料大到要訓練好幾天,才考慮 TPU。
GPU 有哪些、怎麼搭機型
官方運算資源文件列的 GPU(2026 年 10 月):從入門的 T4、L4,到 V100、A100(40GB/80GB),再到 H100、H200、B200、GB200 這些訓練大型語言模型用的。P100 在 2026 年 9 月 15 日停止支援。
三個規則:
- GPU 要配對的機型:A2、N1 或 G2 系列。例如 A100 配
a2-highgpu-1g(1 張)到a2-megagpu-16g(16 張),L4 配g2-standard-*,T4、V100 配n1-* - 張數有固定選項:T4 可以 2 張或 4 張,不能 3 張
- 機型要撐得起 GPU:官方的例子是
n1-standard-32(32 核、120 GB 記憶體)配 V100 至少要 4 張,因為每張 V100 最多只能搭配 12 核、76 GB,2 張不夠、3 張不行 - 機型太小(例如
n1-highmem-2)配 GPU,CPU 不夠可能連日誌都寫不出來
TPU 的設定方式
TPU 在自訂訓練裡只能用一個工作池、一個副本。各世代的設定:
| 世代 | 機型 | 備註 |
|---|---|---|
| v2、v3 | cloud-tpu+TPU_V2/TPU_V3,count 8(單顆)或 32 的倍數(Pod) | 第 13 篇講的「8 核心」就是這個 |
| v5e | ct5lp-hightpu-1t/4t/8t+tpuTopology | 需要 JAX 0.4.6+、TensorFlow 2.15+、PyTorch 2.1+ |
| v6e | ct6e+tpuTopology | 需要 Python 3.10+ |
| 7x | tpu7x-standard-4t+tpuTopology | 需要 Python 3.12+ |
控制費用的三個開關
官方運算資源文件開頭就講「管理成本與可用性」:
| 開關 | 白話 | 代價 |
|---|---|---|
| Spot VM | 用 Google 多出來的閒置機器,大幅折扣 | 隨時可能被收回,程式要會存檢查點、重啟後接著跑 |
| 預留(Reservation) | 先訂好機器,保證有 | 訂了就算錢 |
| Dynamic Workload Scheduler | 要 GPU 的工作先排隊,等有空再跑 | 不能馬上開始 |
Spot 和 Dynamic Workload Scheduler 都是在 CustomJob 的 scheduling.strategy 設定。
4. 分散式訓練:多台一起跑
白話是什麼
一台機器、一張 GPU 跑太慢,就讓很多台一起跑。分兩種分法:
| 資料平行(data parallelism) | 模型平行(model parallelism) | |
|---|---|---|
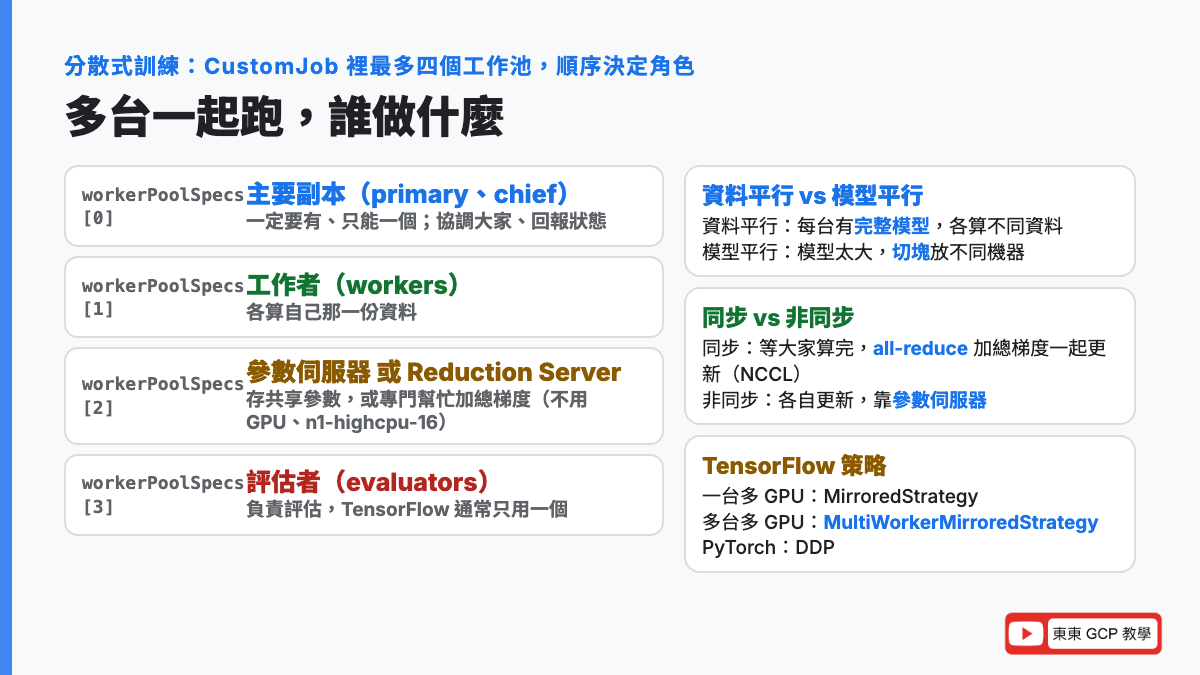
| 白話 | 每台拿到完整的模型,但各算不同的資料 | 模型太大一台裝不下,切成幾塊放不同機器 |
| 比喻 | 四個廚師各做同一道菜,食材分四份 | 一道菜太複雜,前菜一個人、主菜一個人 |
| 什麼時候 | 絕大多數情況 | 大型語言模型這種記憶體裝不下的 |
考試指南 3.3 兩個詞都點名了,但考題以資料平行為主。
同步還是非同步
TensorFlow 的分散式指南把資料平行再分兩種:
- 同步:所有機器各算一批,等大家都算完,把梯度(第 3 篇講的「該往哪調」)加總平均,一起更新。靠 all-reduce 演算法交換梯度,GPU 之間預設用 NVIDIA 的 NCCL 函式庫
- 非同步:各機器自己算、自己更新,靠參數伺服器(parameter server)存共同的模型參數。快但不穩
常見的策略
| 框架 | 策略 | 情況 |
|---|---|---|
| TensorFlow | MirroredStrategy | 一台機器、多張 GPU,同步 |
| TensorFlow | MultiWorkerMirroredStrategy | 多台機器、各多張 GPU,同步。筆記點名的就是它 |
| TensorFlow | TPUStrategy | TPU 上,跟 MirroredStrategy 同一套邏輯 |
| TensorFlow | ParameterServerStrategy | 非同步、參數伺服器架構 |
| PyTorch | DistributedDataParallel(DDP) | 多 GPU、多機器的同步資料平行 |
Agent Platform 怎麼分工
官方分散式訓練文件:你在 CustomJob 裡列出最多四個工作池(workerPoolSpecs[]),順序決定角色:
| 位置 | 角色 | 做什麼 |
|---|---|---|
workerPoolSpecs[0] | 主要副本(primary、chief) | 一定要有、只能一個。協調其他機器、回報整個工作的狀態 |
workerPoolSpecs[1] | 工作者(workers) | 各做自己那一份 |
workerPoolSpecs[2] | 參數伺服器或 Reduction Server | 存模型參數、協調共享狀態 |
workerPoolSpecs[3] | 評估者(evaluators) | 負責評估,TensorFlow 通常只用一個 |
Agent Platform 會把這個結構寫進 CLUSTER_SPEC 或 TF_CONFIG 環境變數,程式讀它就知道自己是誰、同伴在哪。
Reduction Server:讓 GPU 少花時間傳梯度
多台 GPU 同步訓練時,每一步都要把梯度傳來傳去,機器越多、傳得越久。Google 的 Reduction Server 是專門幫忙「加總梯度」的一群便宜機器,讓 GPU 專心算。
官方的條件:GPU 工作者、TensorFlow 或 PyTorch 的多機訓練、容器要支援(預建的 TF/PyTorch 容器,或自訂容器裝 NCCL 2.7 以上和 Google 的 fast socket)。做法是在第三個工作池放 Reduction Server 的映像檔(asia-docker.pkg.dev/vertex-ai-restricted/training/reductionserver:latest),不用 GPU,官方建議用 n1-highcpu-16 這種頻寬高的機型,而且 reducer 的總出口頻寬要跟 worker 相當。
算一次給你看:多 GPU 到底省多少
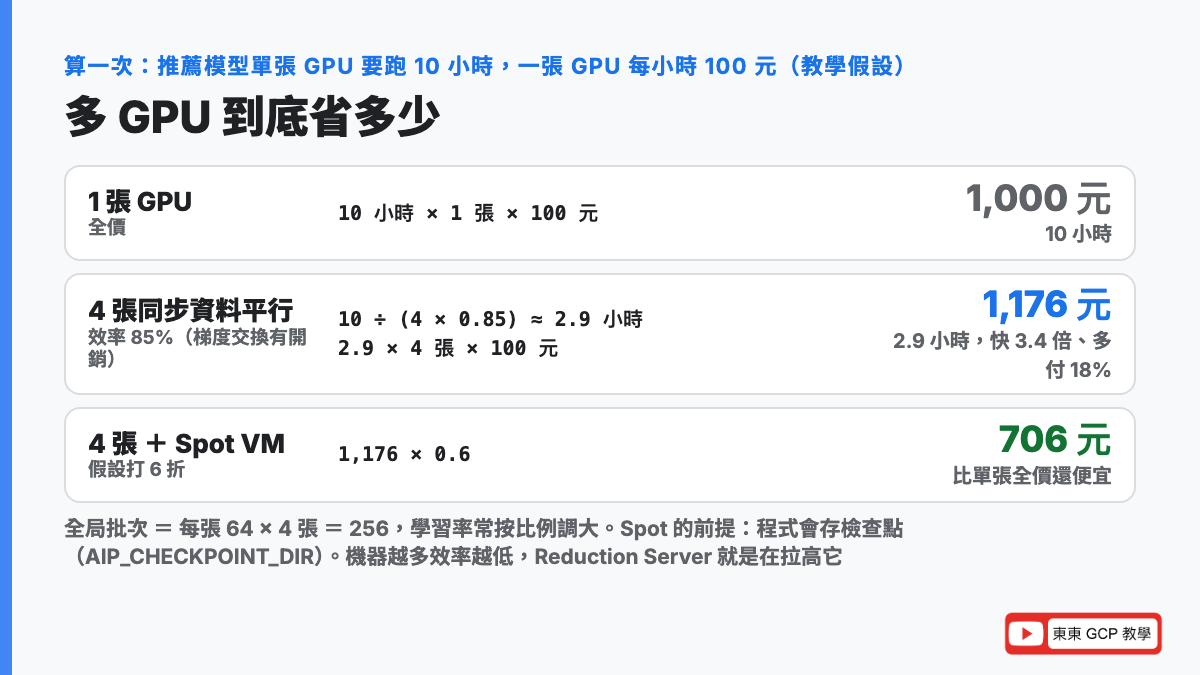
飲料店的推薦模型,單張 T4 要跑 10 小時。改成 4 張 GPU 做同步資料平行(數字是教學假設):
理想狀況:10 小時 ÷ 4 = 2.5 小時
實際有梯度交換的開銷,假設效率 85%
實際時間 = 10 ÷ (4 × 0.85) ≈ 2.9 小時
費用(假設一張 GPU 每小時 100 元,教學假設):
1 張 × 10 小時 × 100 元 = 1,000 元
4 張 × 2.9 小時 × 100 元 = 1,176 元
多付 18%,換 3.4 倍快
再開 Spot VM(假設打 6 折):
1,176 × 0.6 ≈ 706 元
比單張全價還便宜,而且快 3.4 倍批次大小也要跟著變:每張 GPU 一批 64 張,4 張同時算,全局批次變成 64 × 4 = 256。批次變大,常見的做法是學習率(第 3 篇)也按比例調大,不然收斂會變慢。
數字怎麼看:
- 效率 85% 是「梯度交換」吃掉的,機器越多、網路越慢,這個數字越低。Reduction Server 就是在拉高它
- 加 GPU 不會無限變快:16 張時效率可能掉到 60%,10 ÷ (16 × 0.6) ≈ 1 小時,但費用 16 × 1 × 100 = 1,600 元。要時間就加機器,要省錢就少機器+Spot
- Spot 的前提是程式會存檢查點(
AIP_CHECKPOINT_DIR),被收回時才不用從頭來
5. 超參數調校:讓 Google 幫你試
第 15 篇講過 BigQuery ML 用 num_trials 自動試超參數。自訂訓練也有對應的服務:超參數調校工作(HyperparameterTuningJob)。
官方定義的三種資料:輸入資料(訓練資料)、參數(模型訓練中學到的權重)、超參數(控制訓練過程本身的設定,例如幾層、每層幾個節點、學習率)。超參數在一次訓練中通常固定,要調它就得跑很多次訓練。
怎麼運作
- 你定義要調哪些超參數和範圍(例如學習率 0.0001 到 0.1、隱藏層 1 到 4 層)
- 定義目標指標和方向(例如最大化準確率、最小化損失)
- Agent Platform 跑很多次試驗(trial),每次用不同的值,記錄結果,用結果決定下一次試什麼
- 跑完回報最好的那組和每一次的摘要
程式要配合兩件事
- 每個要調的超參數做成命令列參數(程式啟動時從外面給的值),用
argparse接 - 用
cloudml-hypertune套件的report_hyperparameter_tuning_metric把每次的分數回報給 Agent Platform
演算法
預設是貝氏最佳化(Bayesian optimization):根據前幾次的結果,猜下一組最可能更好的值,比亂試省很多次。也可以選 GRID_SEARCH(格狀搜尋,所有組合都試)或 RANDOM_SEARCH(隨機)。官方還提到,對相似的模型反覆調校時,它會跨工作學習、越調越有效率。
另有條件式超參數:例如「訓練方法選 DNN 時才需要調層數」。
6. 兩種跑法:無伺服器訓練 vs 訓練叢集
第 14 篇提過,自訂訓練現在分兩種模式:
| 無伺服器訓練(Serverless Training) | 訓練叢集(Training Clusters) | |
|---|---|---|
| 白話 | 送出 CustomJob,Google 開機器、跑完收掉 | 先保留一批專屬的高階 GPU(A100、H100) |
| 比喻 | 叫計程車 | 包月租車 |
| 適合 | 實驗、原型、不需要保證馬上有機器的正式工作 | 大規模、長時間、不能排隊等的關鍵訓練 |
| 收費 | 用多少付多少 | 保留期間都算 |
訓練叢集的官方文件補充的特色:用開源的 Slurm 介面(高效能運算界的標準排程工具)管工作;自動處理硬體故障(偵測錯誤、重啟或更換節點、從檢查點續跑);內建 Llama、Gemma 這類模型的訓練配方。目前要聯絡業務申請才能用。
第三條路 Ray on Agent Platform:用開源的 Ray 框架做分散式 Python,本來就用 Ray 的團隊適合。
飲料店的推薦模型是每週重訓一次的正式工作、不能排隊 → 第 14 篇的練習情境選了訓練叢集;如果只是研究團隊的實驗,無伺服器訓練+Spot 就好。
在 GCP 上怎麼做
整條流程
- 寫程式:模型存到
AIP_MODEL_DIR,檢查點存到AIP_CHECKPOINT_DIR,程式能從檢查點續跑(Spot 被收回、機器重啟都靠這個,官方文件有一節就叫「確保能承受重啟」) - 選容器:標準框架用預建容器+Python 套件;特殊需求做自訂容器推到 Artifact Registry
- 資料:Cloud Storage 或 BigQuery,跟訓練同一區域(第 13 篇)
- 建 CustomJob:主控台、
gcloud ai custom-jobs create、Python SDK 都行;設機型、GPU、台數、timeout、Spot - 多台:第二個工作池放 workers,有需要在第三個放 Reduction Server
- 要調參:改建 HyperparameterTuningJob,程式加
cloudml-hypertune - 看進度:日誌在 Cloud Logging,TensorBoard 看曲線(第 22 篇)
- 跑完:模型在 Cloud Storage,註冊到 Model Registry,部署(第 17 篇)
權限
訓練工作預設用 Agent Platform 的服務代理身分存取同專案的 Cloud Storage;要限制存取範圍,可以指定自訂的服務帳戶(給程式用的身分,第 12 篇提過)。
改名對照
| 舊名稱(筆記、舊題庫) | 現在 |
|---|---|
| AI Platform Training | 2025 年 4 月關閉,改用 Agent Platform 自訂訓練 |
| Vertex AI Training、Vertex AI custom training | Gemini Enterprise Agent Platform Managed Training |
| Vertex AI Serverless Training | Gemini Enterprise Agent Platform Serverless Training |
| Vertex AI Training Clusters(VTC) | Managed Training Clusters on Gemini Enterprise Agent Platform |
| Ray on Vertex AI | Ray on Gemini Enterprise Agent Platform |
| Container Registry(舊的映像檔倉庫) | Artifact Registry |
| Cloud TPU API | 已淘汰,改透過 Compute Engine、GKE、Agent Platform 用 TPU |
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這篇的內容對應到:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 3 區:把原型放大成 ML 模型(約 21%) | 3.2 用不同 SDK 訓練模型(Agent Platform 自訂訓練、GKE 上的 Kubeflow、AutoML、Tabular Workflows);排除訓練失敗的問題;超參數調校。3.3 評估 CPU、GPU、TPU;用資料平行和模型平行在 GPU、TPU 上做分散式訓練 |
| 第 4 區:服務與擴展模型(約 20%) | 4.1 用預建和自訂容器打包不同框架的模型(容器的概念跟訓練端一樣) |
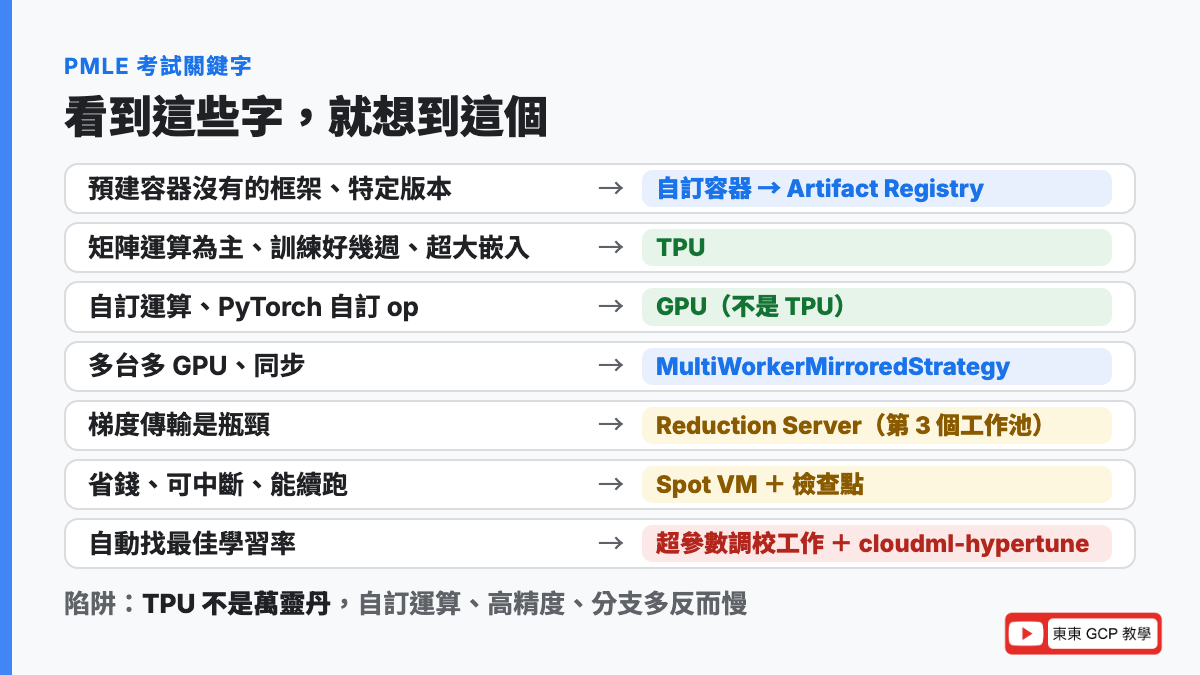
看到這些字,就想到這個
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「預建容器沒有的框架」「特定版本」「非 ML 相依」「啟動更快」 | 自訂容器 |
| 「標準 TensorFlow/PyTorch 程式」「最少設定」 | 預建容器+Python 套件 |
| 「矩陣運算為主」「訓練好幾週」「超大嵌入」「沒有自訂運算」 | TPU |
| 「自訂運算」「PyTorch/JAX 自訂 op」「TPU 不支援的 op」「中大型模型」 | GPU |
| 「快速原型」「小模型」「很多自訂 C++ 運算」 | CPU |
| 「一台多 GPU」 | MirroredStrategy |
| 「多台多 GPU」「同步」 | MultiWorkerMirroredStrategy(PyTorch 用 DDP) |
| 「模型太大裝不下一張 GPU」 | 模型平行 |
| 「梯度傳輸是瓶頸」「多節點 GPU 訓練變慢」 | Reduction Server(放第三個工作池) |
| 「省錢」「可以被中斷」「能從檢查點續跑」 | Spot VM |
| 「保證有機器」「不能排隊」「H100」 | 預留或訓練叢集 |
| 「GPU 不一定馬上有」「可以等」 | Dynamic Workload Scheduler |
| 「自動找最佳學習率」「試很多組」 | 超參數調校工作,cloudml-hypertune 回報指標 |
| 「訓練中途失敗要從頭來」 | 存檢查點到 AIP_CHECKPOINT_DIR |
| 「訓練機器讀不到資料」 | 資料和訓練同區域、服務帳戶權限 |
六個常見陷阱
- TPU 當萬靈丹:有自訂運算、需要高精度、分支多的程式,TPU 反而慢或跑不了
- GPU 張數亂填:T4 只能 2 或 4 張,填 3 會失敗;機型 CPU 太小配 GPU 連日誌都出不來
- 多 GPU 卻沒改程式:沒用分散式策略,4 張 GPU 只有 1 張在動
- 用 Spot 卻不存檢查點:被收回就從頭來,省的錢全賠回去
- 分散式工作池順序放錯:第 0 個一定是主要副本,第 2 個才是參數伺服器/Reduction Server
- 調校時忘了回報指標:沒呼叫
report_hyperparameter_tuning_metric,Agent Platform 不知道哪組好
練習情境(自己出的練習,不是真實考題)
研究團隊用 PyTorch 寫了推薦模型,有自訂損失函數,單張 GPU 要跑 10 小時。他們想在 3 小時內跑完,預算有限,而且這只是實驗,可以中斷重跑。應該怎麼設?
判斷過程:
- 「PyTorch」「自訂損失函數」→ GPU(不是 TPU),預建 PyTorch GPU 容器
- 「3 小時內」→ 4 張 GPU 同步資料平行(DDP),一台 4 張用
MirroredStrategy等級的設定就好,不用多台 - 「預算有限」「可以中斷」→ Spot VM,程式要存檢查點
- 無伺服器訓練即可,不需要訓練叢集
同一個模型要變成每週重訓的正式工作,資料成長到用 8 台機器、每台 8 張 GPU。工程師發現加了機器之後,每一步大部分時間在等梯度傳輸。應該怎麼做?
判斷過程:
- 「等梯度傳輸」「多節點 GPU」→ Reduction Server,放在
workerPoolSpecs[2],用n1-highcpu-16不配 GPU - 「正式工作」「每週」→ 考慮預留或訓練叢集保證有機器
- 容器要是預建 TF/PyTorch,或自訂容器裝 NCCL 2.7+
團隊要訓練一個標準架構的大型語言模型,要跑三週,沒有自訂運算,批次很大。應該選什麼硬體?
判斷過程:
- 「矩陣運算為主」「三週」「大批次」「沒有自訂運算」→ TPU
- 自訂訓練用 TPU:一個工作池、一個副本,選 v5e/v6e 機型+
tpuTopology - 框架版本要符合(v5e 要 TensorFlow 2.15+ 或 PyTorch 2.1+ 或 JAX 0.4.6+)
常見問答
Vertex AI 自訂訓練是什麼?
你自己寫訓練程式(任何框架),打包成容器,Agent Platform 負責開虛擬機器、裝 GPU 或 TPU、跑程式、跑完收機器,只收用到的時間。流程是:寫程式、選預建或自訂容器、資料放同區域的 Cloud Storage、建 CustomJob 指定機型和台數、模型存到 Cloud Storage。Vertex AI 在 2026 年 4 月改名為 Gemini Enterprise Agent Platform,這個服務現在叫 Agent Platform Managed Training。
預建容器和自訂容器怎麼選?
預建容器是 Google 裝好的 TensorFlow、PyTorch、scikit-learn、XGBoost 映像檔,分 CPU 和 GPU 版,標準程式直接用、不用碰 Docker。四種情況才需要自訂容器:預建的沒有你要的框架或版本、有非 ML 的相依套件或二進位檔、想預先裝好相依套件讓啟動更快、要用任意框架做分散式訓練。GPU 用的自訂容器建議以 nvidia/cuda 當基底映像檔。
訓練該用 CPU、GPU 還是 TPU?
官方 TPU 簡介的指南:CPU 適合快速原型、小模型、很多自訂 C++ 運算、被 I/O 卡住的模型;GPU 適合有自訂 PyTorch 或 JAX 運算、用到 TPU 不支援的運算、中大型模型;TPU 適合矩陣運算為主、主訓練迴圈沒有自訂運算、要訓練幾週、大模型大批次、超大嵌入。TPU 不適合分支多、需要高精度、有自訂運算的程式。
資料平行和模型平行差在哪?
資料平行是每台機器都有完整的模型,各算不同的資料,每步把梯度加總平均再更新,絕大多數情況用這種;模型平行是模型太大一張 GPU 裝不下,把模型切成幾塊放不同機器,大型語言模型才需要。資料平行又分同步(all-reduce 等大家算完一起更新,GPU 間用 NCCL)和非同步(參數伺服器,各自更新)。
MultiWorkerMirroredStrategy 是什麼?
TensorFlow 的分散式策略之一,做多台機器、每台多張 GPU 的同步資料平行訓練:每台都有模型的完整複本,用 all-reduce 交換梯度。一台機器多張 GPU 用 MirroredStrategy,TPU 用 TPUStrategy,非同步的參數伺服器架構用 ParameterServerStrategy。PyTorch 對應的是 DistributedDataParallel。Agent Platform 會把機器結構寫進 TF_CONFIG 環境變數給程式讀。
Reduction Server 是什麼?
Google 提供的一群專門幫忙加總梯度的機器,讓多台 GPU 同步訓練時 GPU 不用花時間互傳梯度。條件是 GPU 工作者、TensorFlow 或 PyTorch 多機訓練、容器支援(預建 TF/PyTorch 容器或裝了 NCCL 2.7 以上的自訂容器)。做法是在 CustomJob 的第三個工作池放 Reduction Server 映像檔,不用 GPU,官方建議 n1-highcpu-16 這種頻寬高的機型。
Spot VM 可以用來訓練嗎?
可以,而且是省錢的主要方法。Spot VM 是 Google 多出來的閒置機器,大幅折扣,但隨時可能被收回。前提是訓練程式要定期把檢查點存到 AIP_CHECKPOINT_DIR,被收回重啟後從檢查點續跑。在 CustomJob 的 scheduling.strategy 設定。要保證有機器則用預留,GPU 不急可以用 Dynamic Workload Scheduler 排隊等。
自訂訓練怎麼調超參數?
建超參數調校工作(HyperparameterTuningJob):定義要調的超參數和範圍、目標指標和方向(最大化準確率或最小化損失)、試驗次數。程式要把每個超參數做成命令列參數,並用 cloudml-hypertune 套件回報每次的指標。預設用貝氏最佳化,也可選格狀或隨機搜尋,還支援條件式超參數。BigQuery ML 的對應做法是 num_trials。
無伺服器訓練和訓練叢集差在哪?
無伺服器訓練是送出 CustomJob 後 Google 開機器、跑完收掉、用多少付多少,適合實驗和不需要保證馬上有機器的工作。訓練叢集是先保留一批專屬高階 GPU,用 Slurm 介面管工作、自動處理硬體故障、內建大模型訓練配方,適合大規模長時間的關鍵訓練,目前要聯絡業務申請。另有 Ray on Agent Platform 給用 Ray 框架的團隊。
訓練程式要存到哪裡?
Agent Platform 給三個環境變數:AIP_MODEL_DIR 存訓練完的模型(之後註冊到 Model Registry 直接用)、AIP_CHECKPOINT_DIR 存檢查點、AIP_TENSORBOARD_LOG_DIR 存 TensorBoard 紀錄,都是 Cloud Storage 路徑。訓練資料則掛在 /gcs/ 底下讀,要跟訓練同一個區域。
Vertex AI Training 改名了嗎?
是。Vertex AI 在 2026 年 4 月改名為 Gemini Enterprise Agent Platform,Vertex AI Training 改叫 Agent Platform Managed Training,底下分 Serverless Training(無伺服器訓練)和 Training Clusters(訓練叢集)。更早的 AI Platform Training 已在 2025 年 4 月 7 日關閉。舊題庫的 Vertex AI custom training 就是現在的 Agent Platform 自訂訓練,功能一樣。
重點整理
- 自訂訓練:自己寫程式、打包容器,Agent Platform 開機器、跑完收掉;舊名 Vertex AI Training,現在叫 Agent Platform Managed Training
- 容器:預建(TensorFlow、PyTorch、scikit-learn、XGBoost)夠用就不用自己做;框架不支援、特定版本、非 ML 相依、要更快啟動才做自訂容器,推到 Artifact Registry
- CustomJob:WorkerPoolSpec 設機型、GPU 種類與張數、台數、容器;程式用
AIP_MODEL_DIR、AIP_CHECKPOINT_DIR - 硬體:CPU 原型小模型;GPU 自訂運算、中大型;TPU 矩陣運算為主、訓練數週、大批次,不適合自訂運算與高精度。GPU 要配 A2/N1/G2 機型、張數有固定選項
- 分散式:資料平行(同步 all-reduce、非同步參數伺服器)vs 模型平行;工作池順序=角色(主要副本、工作者、參數伺服器/Reduction Server、評估者);
MultiWorkerMirroredStrategy、DDP - 算一次:4 張 GPU 效率 85% → 2.9 小時,多付 18% 換 3.4 倍快;開 Spot 再打折,但要存檢查點
- 超參數調校工作:命令列參數+
cloudml-hypertune回報指標,預設貝氏最佳化 - 兩種跑法:無伺服器訓練(計程車)vs 訓練叢集(包月租車,Slurm,要申請)
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 第 3 篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切
- 第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
- 第 6 篇:ROC 曲線和 AUC 怎麼看?門檻怎麼調、AUC-PR 差在哪
- 第 7 篇:過度擬合是什麼?正則化、Dropout、提前停止 3 招解決
- 第 8 篇:資料洩漏是什麼?模型考試作弊的 3 種常見情況
- 第 9 篇:類別不平衡怎麼辦?過取樣、欠取樣與 Upweighting
- 第 10 篇:資料前處理怎麼做?標準化、遺失值、高基數類別
- 第 11 篇:特徵工程是什麼?特徵交叉、詞嵌入、資料增強一次看懂
- 第 12 篇:機器學習的資料隱私怎麼保護?DLP、聯邦學習、VPC Service Controls
- 第 13 篇:訓練資料讀太慢?TFRecords、tf.data 與 prefetch 加速
- 第 14 篇:Vertex AI AutoML、BigQuery ML、自訂訓練怎麼選?
- 上一篇:第 15 篇:BigQuery ML 入門:只會 SQL 也能訓練模型
- 下一篇:第 17 篇:模型部署怎麼選?線上預測 vs 批次預測、流量分割
站上相關文章
- 如何在 GCP 上建立含 GPU 的 AI 開發環境
- 容器技術是什麼?從零開始看懂 Docker 與容器化應用
- Kubernetes 是什麼?白話解釋+判斷你是否真的需要它
- Google VM 平台 Compute Engine 是什麼?
- 很多人嫌 GCP 的主機價格很貴?真的貴嗎?
- GCP 帳單爆炸防護指南
機器選對、程式打包好,模型才跑得起來、錢才花得值。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。