MLOps 是把機器學習變成可重複的自動化管線:驗證、訓練、評估、部署寫成步驟,用 Vertex AI Pipelines 跑。
前面 17 篇把「一個模型從資料到上線」走完了。問題是:這些步驟你是手動做的。資料更新了要重訓、換了特徵要重跑、上線要再部署一次,每次都靠人記得順序、靠人按按鈕。模型一多、重訓一頻繁,就會出事。
MLOps 就是解決這件事的方法,管線(pipeline)是它的核心工具。這篇講 MLOps 是什麼、管線長什麼樣、Google Cloud 上的 Vertex AI Pipelines(現在叫 Agent Platform Pipelines)怎麼用、Kubeflow 和 TFX 這兩個框架差在哪。
一樣用有 2,000 間分店的連鎖飲料店當例子(教學假設):會員流失模型每週要用新資料重訓一次,推薦模型每天重訓。
為什麼你需要知道
- 模型上線後會壞:Google 的 MLOps 架構文件說得很直接,模型在真實世界常常壞掉,因為環境變了、資料變了,模型沒跟著變。解法是頻繁重訓,而頻繁重訓靠手動做不到
- 手動流程的隱形成本:飲料店兩個模型,一個每週、一個每天重訓,一年要手動跑 400 多次,每次十幾個步驟。漏一步、順序錯一步,上線的就是壞模型
- 筆記裡的名稱改了:Vertex AI Pipelines 現在叫 Agent Platform Pipelines,Cloud Composer 改名 Managed Service for Apache Airflow
- 證照必考:PMLE 考試指南第 5 區「自動化與編排 ML 管線」佔 18%,5.1 要你會「驗證資料和模型」「用代管或非代管服務、從範本或自訂方案建管線(Agent Platform Pipelines、Managed Service for Apache Airflow、Ray)」;第 2.3 節也考「選實驗環境(Experiments、Pipelines、Kubeflow Pipelines)」
先搞懂:MLOps 是什麼
白話是什麼
MLOps(Machine Learning Operations):把軟體工程界管程式的那套方法(DevOps)搬到機器學習上,讓模型的建立、測試、上線、重訓變成自動、可重複、可追蹤的流程。
DevOps 是「開發」(Development)和「維運」(Operations)合在一起的做法:程式一改,自動測試、自動部署,而不是工程師手動上傳檔案。
比喻
一間手搖飲店,老闆自己調配方、自己煮,口味靠經驗。要開到 2,000 間分店,就得把配方寫成 SOP(標準作業流程):第一步秤糖、第二步煮茶、第三步封膜,每間店照做、品質一樣,配方改了只要更新 SOP。
MLOps 就是把「做模型」寫成 SOP,而且是機器會自己照做的 SOP。
來龍去脈:跟 DevOps 差在哪
官方文件說 ML 系統跟一般軟體有幾個不同:團隊成員不是軟體工程師(資料科學家)、要做很多實驗、測試要多測資料和模型、部署的不只是程式而是一整條會自動重訓的管線、模型會因為資料變化而衰退。
所以 MLOps 比 DevOps 多了一個 CT(持續訓練,Continuous Training):程式沒改,但資料變了,就自動重訓。
三個成熟度等級
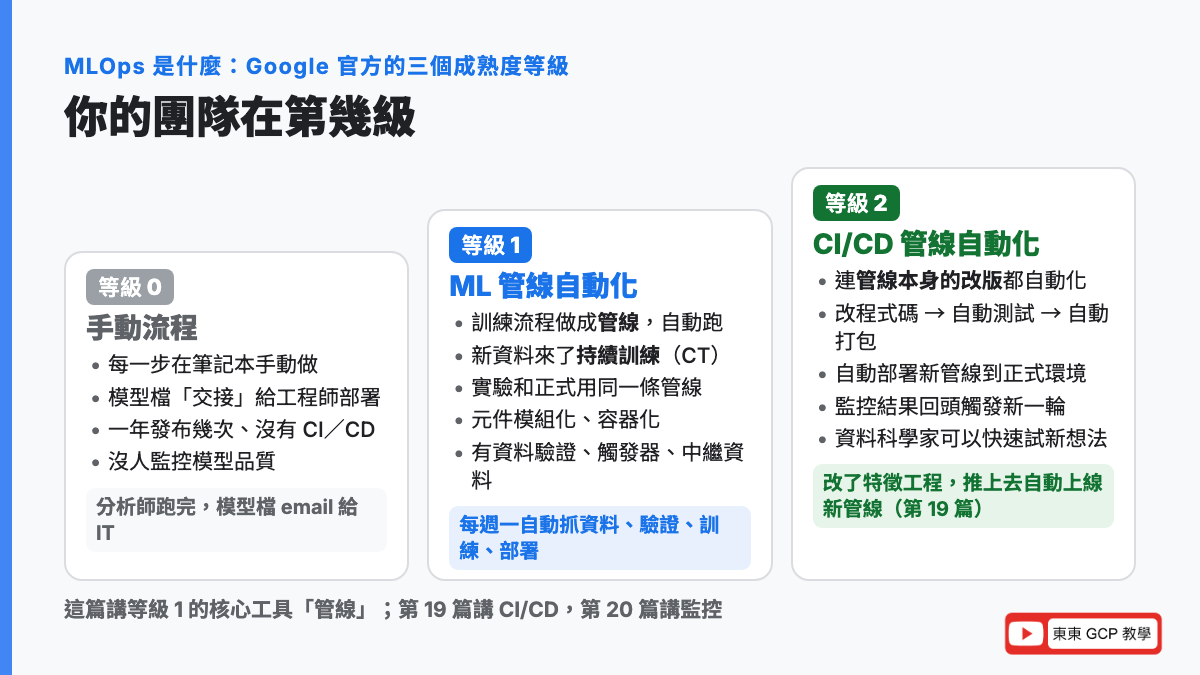
官方文件把 MLOps 分成三級,這是考題和實務都常用的框架:
| 等級 | 名稱 | 長什麼樣 | 飲料店 |
|---|---|---|---|
| 0 | 手動流程 | 每一步都在筆記本裡手動做;資料科學家做完模型「交接」給工程師部署;一年才發布幾次;沒有 CI/CD;沒有監控 | 分析師在筆記本跑完,把模型檔丟給 IT 上線 |
| 1 | ML 管線自動化 | 訓練流程做成管線,自動用新資料持續訓練;實驗環境和正式環境用同一條管線;元件模組化、容器化;有資料和模型驗證、觸發器、中繼資料 | 每週自動抓新資料、驗證、訓練、評估、部署 |
| 2 | CI/CD 管線自動化 | 連管線本身的改版都自動化:改了程式碼就自動測試、打包、部署新管線 | 分析師改了特徵工程,推上去自動測試、自動上線新管線 |
筆記本(notebook)是在網頁上邊寫程式邊看結果的工具,例如 Agent Platform Workbench、Colab。
等級 0 的最大問題,官方點出三個:模型沒人監控品質;沒有頻繁重訓;沒有持續實驗新做法。等級 1 解決前兩個,等級 2 解決第三個。這篇講等級 1 的核心工具(管線),第 19 篇講等級 2 的 CI/CD,第 20 篇講監控。
為什麼要學
考題會描述一個團隊的現狀(「資料科學家在筆記本訓練好交給工程師」「每季手動重訓」),問你「該怎麼改善」,答案幾乎都是「建管線」。認得出這是等級 0 的症狀,就能選對。
1. 管線:把步驟串成一張圖
白話是什麼
ML 管線(ML pipeline):把機器學習的工作流程寫成一連串的步驟,每一步做一件事(準備資料、訓練、評估、部署),步驟之間用「輸出接輸入」串起來。官方 Pipelines 簡介的定義:「一個可攜、可擴展的 MLOps 工作流程描述,由一系列叫做管線任務的步驟組成」。
比喻
工廠的生產線。原料進來,第一站洗、第二站切、第三站包裝,每一站只管自己的事,上一站的成品是下一站的原料。
兩個名詞
| 名詞 | 白話 | 比喻 |
|---|---|---|
| 元件(component) | 一段獨立的程式,做一件事,有輸入、有輸出,通常包成容器 | 一台機器(切菜機) |
| 任務(task) | 元件加上具體的輸入,變成管線裡的一步 | 這台切菜機今天切這批菜 |
官方說元件有三部分:輸入(參數或成品)、輸出、邏輯(程式碼,容器化的話還包含容器映像檔)。成品(artifact)是步驟產生的東西:資料集、模型檔、評估報告。
管線是一張圖:DAG
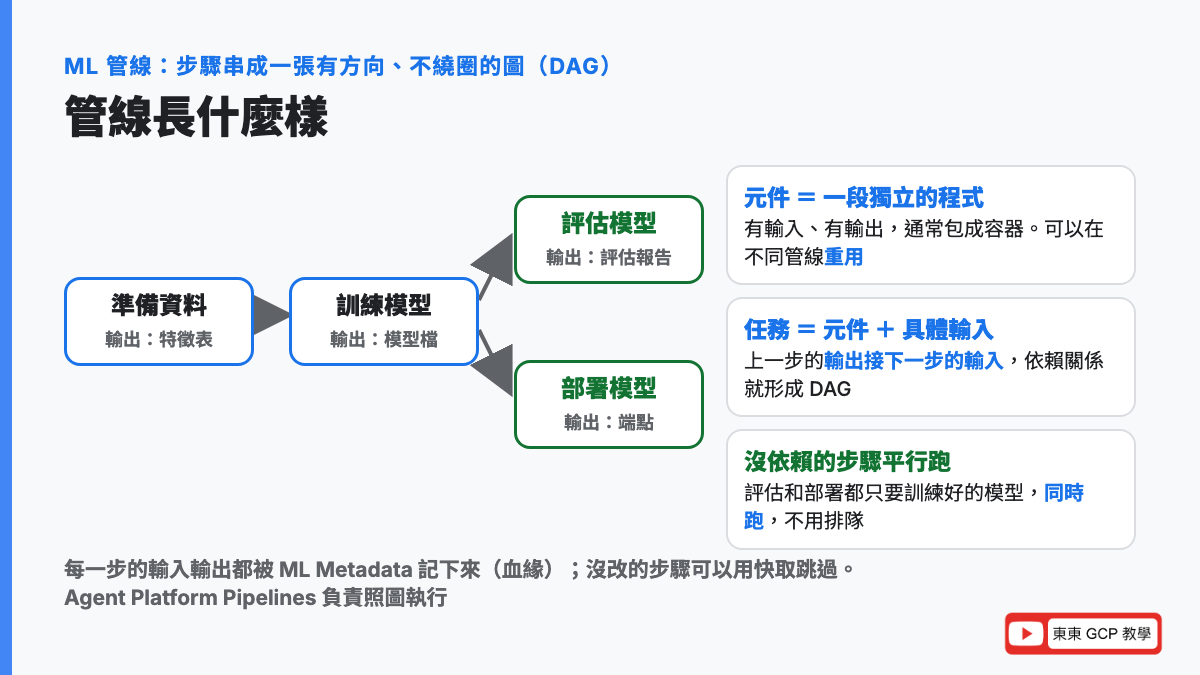
步驟之間的依賴關係形成一張 DAG(有向無環圖)。白話:箭頭有方向(A 做完才能做 B)、不會繞圈(B 不能又回頭等 A)。
官方的例子,四個步驟:
準備資料 → 訓練模型 → 評估模型
└→ 部署模型- 準備資料不依賴任何步驟,可以第一個跑(或跟別的平行)
- 訓練模型要等準備資料的輸出
- 評估和部署都只要訓練好的模型,所以可以同時跑
官方特別說:預設任務是平行跑的,有依賴才會串起來。這是管線比「照順序執行的腳本」快的原因。
為什麼要學
考試 5.1 的「建立和編排管線」就是在問這個。而且元件可以重用:飲料店的「從 BigQuery 抓資料並驗證」元件,流失模型和推薦模型都能用。
2. Vertex AI Pipelines:無伺服器地跑管線
白話是什麼
Vertex AI Pipelines(2026 年 4 月起叫 Gemini Enterprise Agent Platform Pipelines):Google 代管的管線執行服務。你定義好管線,它負責開機器、照 DAG 跑每一步、記錄每一步的輸入輸出。官方用語是「以無伺服器的方式自動化、監控、治理 ML 系統」,無伺服器就是你不用管機器(第 14 篇)。
比喻
你寫好 SOP,Google 提供工廠和工人,照 SOP 生產,每一批都有生產紀錄。
用哪個框架寫管線
Agent Platform Pipelines 可以跑兩種框架定義的管線:Kubeflow Pipelines(KFP) 和 TensorFlow Extended(TFX)。兩個下面會分別講。
一條管線的生命週期
官方分四個階段:
| 階段 | 做什麼 |
|---|---|
| 定義(Define) | 選框架(KFP 或 TFX),寫元件、組管線 |
| 編譯(Compile) | 把 Python 定義的管線編譯成一份 YAML 檔(一種設定檔格式)。這份 YAML 可以上傳成管線範本(pipeline template)放到 Artifact Registry 的 Kubeflow Pipelines 儲存庫,做版本控制、重複使用 |
| 執行(Run) | 用 YAML 或範本建一次管線執行(pipeline run)。可以跑一次、用排程 API 定期跑、或複製之前的執行 |
| 監控 | 看每次執行的狀態、效能、費用;看 DAG 圖;查每個成品的來源 |
任務在哪裡算:官方說任務可以用 Agent Platform 的隨需運算(底層是 Kubernetes),也可以委派給別的引擎:BigQuery、Dataflow、Managed Service for Apache Spark。例如「準備資料」那一步其實是一句 BigQuery SQL,管線只是去觸發它、等它做完。
預建元件:Google Cloud Pipeline Components
GCPC 是 Google 做好的一組 KFP 元件,官方列的功能:建資料集、匯出資料到 Cloud Storage、用 AutoML 訓練、跑自訂訓練工作、上傳模型做批次推論、建端點部署線上推論。
好處(官方列的):
- 好除錯:直接顯示元件底下啟動的資源
- 標準成品型態:輸入輸出用統一的型態,ML Metadata 自動追蹤血緣
- 帳單標籤自動傳遞:元件啟動的資源會帶上管線的標籤,配合帳單匯出到 BigQuery 就能算出一次管線執行花多少錢
- 省成本:它直接啟動 Google Cloud 資源,不用先開一個容器在那邊空等
中繼資料和血緣
每一次執行,Agent Platform ML Metadata 會記下每一步用了什麼輸入、產出什麼成品。所以你可以回答「上線的這個模型是用哪天的資料、哪個版本的程式訓練的」。這個第 22 篇會專門講。
為什麼要學
考題看到「無伺服器」「代管」「ML 專用的管線」「追蹤成品血緣」,就是 Agent Platform Pipelines。
3. Kubeflow Pipelines:框架中立的管線
白話是什麼
Kubeflow Pipelines(KFP):開源的管線框架,官方定義是「用容器在 Kubernetes 系統上建立和部署可攜、可擴展的 ML 工作流程的平台」。
Kubernetes 是管理大量容器的系統,站上有一篇Kubernetes 是什麼。可攜是「寫一次,換個地方也能跑」。
比喻
樂高積木。每個元件是一塊積木(一個容器),用 Python 把積木拼成管線,拼好的東西可以搬到任何支援 KFP 的地方跑。
來龍去脈
Kubeflow 原本是 Google 內部「在 Kubernetes 上跑 TensorFlow」的專案開源出來的,後來變成一整套 ML 平台,Pipelines 是其中最常用的一塊。2025 年 Kubeflow 成為 CNCF(雲端原生運算基金會)的畢業專案,代表它是業界標準等級的開源軟體。
Agent Platform Pipelines 跑的就是 KFP 格式的管線,差別是你不用自己架 Kubernetes。筆記裡的「Vertex AI Pipelines(KFP 託管服務)」就是這個意思。
怎麼寫:Python 函數就是元件
KFP 的 SDK 讓你用 Python 函數定義元件(叫 lightweight component),不用自己做容器:
from kfp import dsl

@dsl.component(packages_to_install=["google-cloud-bigquery"])
def prepare_data(project: str, out_table: str) -> str:
    # 用 SQL 從 BigQuery 整理出會員特徵表
    ...
    return out_table

@dsl.component(base_image="asia-docker.pkg.dev/vertex-ai/training/pytorch-gpu.2-4.py310:latest")
def train_model(table: str, model_dir: dsl.Output[dsl.Model]):
    # 訓練,把模型存到 model_dir.path
    ...

@dsl.pipeline(name="churn-weekly")
def churn_pipeline(project: str):
    data = prepare_data(project=project, out_table="drink.member_features")
train_model(table=data.output)@dsl.component:這個函數是一個元件,可以指定要裝的套件或用哪個容器映像檔@dsl.pipeline:這個函數描述管線,裡面呼叫元件、把輸出接到輸入,KFP 自動算出 DAG- 編譯成 YAML 後,用 Agent Platform 的
PipelineJob執行
要用 Google 的服務(AutoML、自訂訓練、部署端點),直接拿 GCPC 的預建元件來接,不用自己寫。
為什麼要學
KFP 不綁框架:PyTorch、scikit-learn、XGBoost 的程式都能包成元件。飲料店的 PyTorch 推薦模型(第 16 篇)要做成管線,用 KFP。
4. TFX:TensorFlow 的全家桶管線
白話是什麼
TFX(TensorFlow Extended):Google 用來部署正式 ML 管線的平台,專為 TensorFlow 設計,附一整套標準元件,從讀資料到部署都幫你定義好。
比喻
KFP 是樂高積木,自己拼;TFX 是模型套件(已經切好的零件+組裝說明書),照著組就是一台完整的車,但零件是 TensorFlow 規格的。
標準元件:一條標準的管線長這樣
TFX 官方指南列的標準元件,照順序:
| 元件 | 做什麼 | 對應本系列 |
|---|---|---|
| ExampleGen | 把資料讀進管線(輸出 TFRecord 格式的樣本) | 第 13 篇 |
| StatisticsGen | 算資料的統計量(每欄的分布、遺失值比例) | 第 10 篇 |
| SchemaGen | 從統計量推出資料結構(schema):每欄什麼型態、值域多少 | |
| ExampleValidator | 用 schema 檢查新資料有沒有異常:遺失值、型態不對、分布跑掉 | 第 20 篇的偏差 |
| Transform | 特徵工程,而且訓練和服務用同一套轉換 | 第 10、11 篇 |
| Trainer | 訓練模型 | 第 16 篇 |
| Tuner | 調超參數 | 第 16 篇 |
| Evaluator | 深入分析訓練結果,驗證模型夠不夠好才能上線 | 第 5、6 篇 |
| InfraValidator | 確認模型真的能在服務環境載入、回應 | 第 17 篇 |
| Pusher | 把模型推到服務環境 | 第 17 篇 |
| BulkInferrer | 批次推論 | 第 17 篇 |
背後的四個函式庫
- TFDV(TensorFlow Data Validation):StatisticsGen、SchemaGen、ExampleValidator 用的,資料驗證。筆記裡的「TFX SDK(標準化組件,TFDV)」就是這個
- TFT(TensorFlow Transform):Transform 用的,前處理寫一次,訓練和服務都套用,解決訓練/服務偏差
- TFMA(TensorFlow Model Analysis):Evaluator 用的,可以切片評估(例如只看台北的會員、只看新會員),找出整體分數好但某群人很差的情況
- MLMD(ML Metadata):記錄每一步的成品和血緣
要搭配什麼
官方說 TFX 的資料處理靠 Apache Beam(Dataflow 跑的就是 Beam,第 23 篇),編排器可以選 Apache Airflow、Kubeflow Pipelines,或 Agent Platform Pipelines。
為什麼要學
考題看到「資料驗證」「schema」「偵測資料異常」「TensorFlow 全家桶」「標準化元件」,就是 TFX(或它的 TFDV)。考試指南 5.1 第一條「驗證資料和模型」,TFX 的 ExampleValidator 和 Evaluator 就是標準答案之一。
5. KFP、TFX、Airflow、Ray:怎麼選
| KFP | TFX | Managed Service for Apache Airflow | Ray on Agent Platform | |
|---|---|---|---|---|
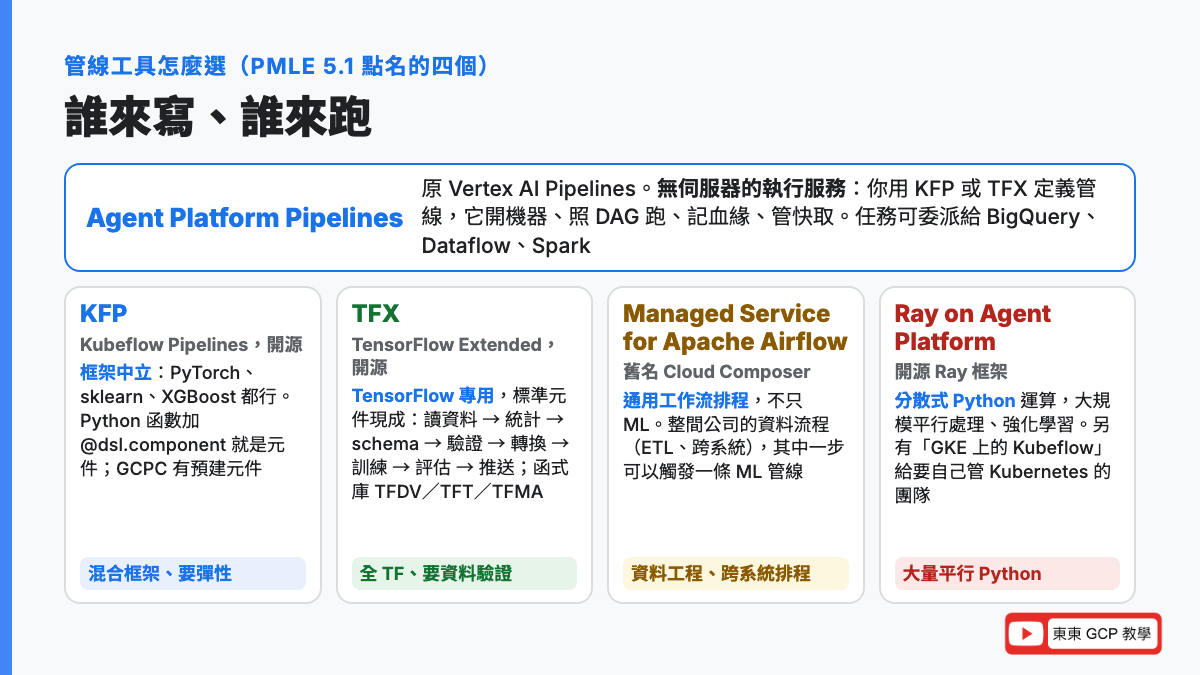
| 是什麼 | ML 管線框架 | TensorFlow 的管線框架+標準元件 | 通用的工作流排程服務,舊名 Cloud Composer | 分散式 Python 運算框架 |
| 框架 | 中立(PyTorch、sklearn、XGBoost 都行) | TensorFlow | 任何(它只是排程) | Python |
| 元件 | 自己寫(Python 函數)+GCPC 預建 | 標準元件現成 | Airflow 的 operator | Ray 的任務 |
| 強項 | 彈性、框架中立 | 資料驗證、訓練服務一致、切片評估 | 跨系統的資料工程流程(ETL、排程) | 大規模平行 Python |
| 在哪跑 | Agent Platform Pipelines、自管 Kubernetes 上的 Kubeflow | Agent Platform Pipelines、Airflow、KFP | 它自己是代管服務 | Agent Platform |
怎麼選:
- ML 流程、要血緣追蹤、無伺服器 → Agent Platform Pipelines(用 KFP 或 TFX 寫)
- 全 TensorFlow、要標準的資料驗證和評估 → TFX
- PyTorch 或混合框架 → KFP
- 整個公司的資料流程(每天從十個系統抓資料、清洗、再觸發 ML)→ Managed Service for Apache Airflow,它也可以在流程裡觸發一條 Agent Platform 管線
- 已經有自己的 Kubernetes 團隊、要完全控制 → GKE 上的 Kubeflow(考試指南 3.2 有列)
- 大量平行的 Python 運算(例如大規模資料處理或強化學習)→ Ray
Managed Service for Apache Airflow 是 Google 在 2026 年把 Cloud Composer 改的名字,官方文件寫「Cloud Composer 正演變為 Managed Service for Apache Airflow」。舊題庫看到 Cloud Composer 就是它。
6. 管線快取:沒改的步驟不要重跑
白話是什麼
管線快取:管線執行時,每一步先看 ML Metadata 裡有沒有「一模一樣的執行」,有就直接拿上次的輸出、跳過這一步。
快取鍵(判斷「一模一樣」的依據)是三樣東西的組合:
- 這一步的輸入:參數的值、輸入成品的 ID
- 這一步的輸出定義:輸出參數和成品的名稱
- 元件規格:映像檔、指令、參數、環境變數,連順序都算
而且只有同名的管線才共用快取。
算一次給你看
飲料店的流失模型管線五步(數字是教學假設):
| 步驟 | 時間 | 費用 |
|---|---|---|
| 準備資料(BigQuery) | 10 分鐘 | 5 元 |
| 驗證資料 | 5 分鐘 | 2 元 |
| 訓練(GPU) | 60 分鐘 | 100 元 |
| 評估 | 5 分鐘 | 2 元 |
| 部署 | 5 分鐘 | 1 元 |
| 全部 | 85 分鐘 | 110 元 |
分析師只改了評估那一步的門檻(第 6 篇),重跑管線:
前三步的輸入、輸出定義、元件規格都沒變 → 命中快取,跳過
只跑評估 + 部署 = 5 + 5 = 10 分鐘,2 + 1 = 3 元
省下 75 分鐘(88%)、107 元(97%)數字怎麼看:
- 越前面、越貴的步驟(訓練)越常被快取省掉,因為它的輸入通常沒變
- 反過來的陷阱:每週的新資料如果用同一個表名、同樣的參數,「準備資料」這一步的輸入看起來一樣,快取會跳過它,整條管線用上週的資料重訓,你還以為更新了。解法:抓資料那一步關掉快取(
task.set_caching_options(False)),或把日期當參數傳進去,讓快取鍵不一樣 - 整條管線關快取:
PipelineJob(..., enable_caching=False)
筆記裡的「管道快取(Pipeline Caching)減少重複運行時間/成本」就是這個,考試會從正反兩面考。
在 GCP 上怎麼做
建第一條管線
- 把現有的筆記本程式拆成函數:抓資料、訓練、評估各一個
- 用 KFP 的
@dsl.component包成元件;要用 AutoML、自訂訓練、部署端點,直接接 GCPC 元件 @dsl.pipeline組起來,kfp.compiler.Compiler().compile()編成 YAML- 用
aiplatform.PipelineJob(template_path="pipeline.yaml", ...).run()跑一次,在主控台看 DAG 圖和每一步的日誌 - 跑順了,上傳 YAML 到 Artifact Registry 當範本,用排程 API 設每週一跑(第 19 篇講其他觸發方式)
- 抓資料那一步關快取
觸發方式
官方 MLOps 文件列的五種:手動、排程(每天/每週有新標好的資料)、新資料到了(不定期)、模型效能下降(第 20 篇的監控觸發)、資料分布明顯改變(概念漂移)。第 19 篇會講在 GCP 上各怎麼接。
費用
管線執行本身有執行費,加上每一步啟動的資源費(訓練的 GPU、BigQuery 的查詢)。用 GCPC 元件,資源會自動帶管線的標籤,帳單匯出到 BigQuery 就能算每一次執行的總花費。
改名對照
| 舊名稱(筆記、舊題庫) | 現在 |
|---|---|
| Vertex AI Pipelines | Gemini Enterprise Agent Platform Pipelines |
| Vertex ML Metadata | Gemini Enterprise Agent Platform ML Metadata |
| Vertex AI Experiments | Experiments on Gemini Enterprise Agent Platform |
| Cloud Composer | Managed Service for Apache Airflow |
| Dataproc Serverless(Spark) | Managed Service for Apache Spark |
| Kubeflow Pipelines(KFP)、TFX | 名稱沒變,都是開源專案 |
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這篇的內容對應到:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 2 區:跨團隊管理資料與模型(約 16%) | 2.3 依框架選開發和實驗環境(Experiments on Agent Platform、Agent Platform Pipelines、Kubeflow Pipelines) |
| 第 3 區:把原型放大成 ML 模型(約 21%) | 3.1 選產品(含 Agent Platform Pipelines);3.2 用不同 SDK 訓練(含 GKE 上的 Kubeflow) |
| 第 5 區:自動化與編排 ML 管線(約 18%) | 5.1 驗證資料和模型;用代管或非代管服務、從範本或自訂方案建立和編排管線(Agent Platform Pipelines、Managed Service for Apache Airflow、Ray on Agent Platform);確保訓練和服務的前處理一致。5.2 自動重訓(第 19 篇) |
看到這些字,就想到這個
| 題目出現的關鍵字 | 想到 |
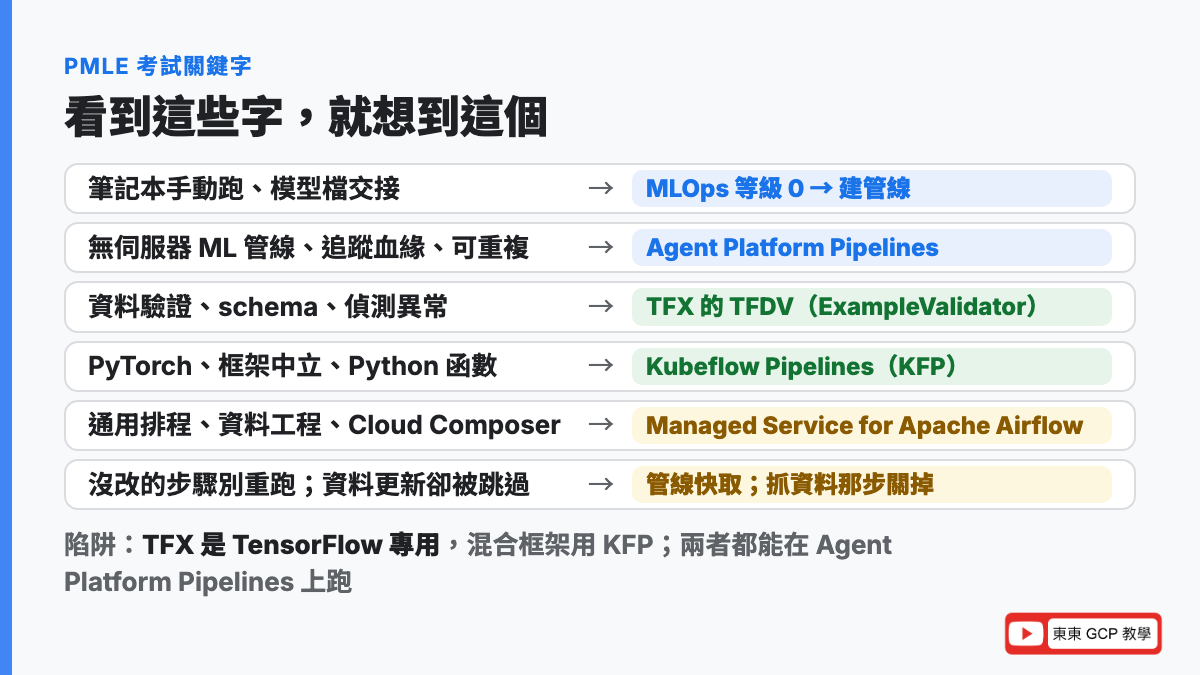
|---|---|
| 「資料科學家在筆記本訓練好交給工程師」「每季手動重訓」「沒有監控」 | MLOps 等級 0,要建管線(等級 1) |
| 「改了管線程式碼要自動測試、部署」 | 等級 2,CI/CD(第 19 篇) |
| 「無伺服器」「代管的 ML 管線」「追蹤成品血緣」「可重複」 | Agent Platform Pipelines |
| 「資料驗證」「schema」「偵測異常」「統計量」 | TFX 的 TFDV(ExampleValidator) |
| 「全 TensorFlow」「標準元件」「切片評估」 | TFX(TFMA) |
| 「PyTorch」「scikit-learn」「框架中立」「Python 函數當元件」 | KFP |
| 「用 AutoML/自訂訓練/部署的現成元件」 | Google Cloud Pipeline Components |
| 「通用工作流」「跨系統資料流程」「Airflow DAG」「Cloud Composer」 | Managed Service for Apache Airflow |
| 「自己管 Kubernetes」「完全控制」 | GKE 上的 Kubeflow |
| 「大規模平行 Python」 | Ray on Agent Platform |
| 「沒改的步驟不要重跑」「省時間省錢」 | 管線快取 |
| 「用了舊資料卻沒發現」「資料更新但管線跳過」 | 抓資料那步關快取,或把日期當參數 |
| 「訓練和服務的前處理一致」 | TFX Transform(TFT)、BigQuery ML TRANSFORM(第 15 篇) |
| 「這個模型用哪份資料訓練的」 | ML Metadata 血緣(第 22 篇) |
| 「管線定義要版本控制、重複使用」 | 管線範本放 Artifact Registry |
六個常見陷阱
- 把管線當成排程腳本:管線的重點是元件化、平行、血緣追蹤,不只是「定時跑」
- 抓資料的步驟沒關快取:每週重訓其實都用同一份舊資料
- PyTorch 專案選 TFX:TFX 是 TensorFlow 專用,混合框架用 KFP
- 整個公司的 ETL 流程硬塞進 Agent Platform Pipelines:那是 Airflow 的事,ML 管線可以被 Airflow 觸發
- 等級 1 就以為做完了:管線程式碼本身的改版還是手動部署,要到等級 2 才算完整
- 忘記 Cloud Composer 改名了:考題寫 Managed Service for Apache Airflow 就是它
練習情境(自己出的練習,不是真實考題)
飲料店的資料科學家每週一早上手動在筆記本跑完流失模型,把模型檔用 email 寄給工程師部署。上個月有兩次忘了跑,一次寄錯版本。應該怎麼改善?
判斷過程:
- 「手動」「筆記本」「寄檔案」「忘了跑」→ MLOps 等級 0 的典型症狀
- 解法:把步驟做成 Agent Platform Pipelines 管線(KFP 元件),排程每週一自動跑,評估通過就自動部署
- 模型進 Model Registry(第 17 篇)而不是 email
推薦模型用 PyTorch,流失模型用 XGBoost,團隊想用同一套方式管兩條管線,而且要知道每個上線的模型是用哪份資料訓練的。應該用什麼?
判斷過程:
- 「PyTorch+XGBoost」→ KFP(框架中立),不是 TFX
- 「同一套方式」「哪份資料」→ Agent Platform Pipelines,ML Metadata 自動記血緣
- 訓練、部署用 GCPC 預建元件
團隊全用 TensorFlow,最近兩次重訓後模型變差,追查發現上游系統改了欄位格式,但管線照樣訓練上線了。應該加什麼?
判斷過程:
- 「欄位格式變了沒被擋下」→ 缺資料驗證
- 「全 TensorFlow」→ TFX,加 StatisticsGen → SchemaGen → ExampleValidator,異常就停止管線
- 再加 Evaluator 比較新舊模型,沒變好不部署(第 19 篇)
常見問答
MLOps 是什麼?
把軟體工程的 DevOps 做法搬到機器學習上,讓模型的建立、測試、上線、重訓變成自動、可重複、可追蹤的流程。比 DevOps 多一個 CT(持續訓練):程式沒改但資料變了就自動重訓。Google 的 MLOps 文件分三級:等級 0 全手動在筆記本做,等級 1 訓練流程做成自動管線持續訓練,等級 2 連管線程式碼的改版都走 CI/CD。
ML 管線是什麼?跟寫一個腳本差在哪?
管線是把 ML 工作流程寫成一連串步驟(任務),每步是一個元件加具體輸入,步驟之間用輸出接輸入,形成一張 DAG。跟腳本的差別:沒有依賴的步驟自動平行跑;元件可以在不同管線重用;每一步的輸入輸出都被 ML Metadata 記下來可以追血緣;沒改的步驟可以用快取跳過。
Vertex AI Pipelines 是什麼?
Google 代管、無伺服器的管線執行服務,2026 年 4 月起叫 Gemini Enterprise Agent Platform Pipelines。它可以跑 Kubeflow Pipelines 或 TFX 定義的管線:你定義、編譯成 YAML、建一次執行或排程重複執行,它負責開機器、照 DAG 跑、記錄血緣。任務可以委派給 BigQuery、Dataflow、Spark 算。Google Cloud Pipeline Components 提供 AutoML、自訂訓練、部署等預建元件。
Kubeflow Pipelines 和 TFX 差在哪?
KFP 是框架中立的管線框架,用 Python 函數或容器當元件,PyTorch、scikit-learn、XGBoost 都能用,彈性高。TFX 是 TensorFlow 專用的管線平台,附一整套標準元件(ExampleGen、StatisticsGen、SchemaGen、ExampleValidator、Transform、Trainer、Evaluator、Pusher 等)和函式庫(TFDV 資料驗證、TFT 轉換、TFMA 評估),全 TensorFlow 的團隊照著組就有完整管線。兩種都能在 Agent Platform Pipelines 上跑。
TFDV 是什麼?
TensorFlow Data Validation,TFX 裡做資料驗證的函式庫。StatisticsGen 用它算統計量,SchemaGen 用它推出資料結構(每欄型態、值域),ExampleValidator 用它檢查新資料有沒有異常(遺失值、型態不對、分布跑掉)。考試看到資料驗證、schema、偵測異常,就是它。
Cloud Composer 和 Vertex AI Pipelines 怎麼選?
Cloud Composer 現在叫 Managed Service for Apache Airflow,是通用的工作流排程服務,適合整個公司的資料工程流程(每天從多個系統抓資料、清洗、觸發下游)。Agent Platform Pipelines 是 ML 專用,有元件、成品、血緣追蹤、快取。常見的組合是 Airflow 管整體流程,其中一步觸發一條 Agent Platform 管線。
管線快取是什麼?什麼時候要關?
管線執行時,每一步先查 ML Metadata 有沒有輸入、輸出定義、元件規格都一樣的執行,有就直接用上次的輸出、跳過這步,省時間和錢。要關的情況:抓資料那一步,因為資料更新了但表名和參數沒變,快取會跳過它、用舊資料重訓。用 task.set_caching_options(False) 關單步,或 PipelineJob 的 enable_caching=False 關整條。
管線怎麼定期自動跑?
編譯好的 YAML 上傳到 Artifact Registry 當管線範本,用 Agent Platform 的排程 API 設定每天或每週執行。其他觸發方式:新資料到了、模型效能下降、資料分布改變,第 19 篇講怎麼接 Cloud Build、Pub/Sub、Cloud Scheduler。
一定要用 Google 的管線服務嗎?
不一定。考試指南 5.1 寫「代管或非代管服務」:代管是 Agent Platform Pipelines、Managed Service for Apache Airflow;非代管是自己在 GKE 上架 Kubeflow,要完全控制或已經有 Kubernetes 團隊才值得。另有 Ray on Agent Platform 給大規模平行 Python 運算。
Vertex AI Pipelines 改名了嗎?
是。Vertex AI 在 2026 年 4 月改名為 Gemini Enterprise Agent Platform,Vertex AI Pipelines 改叫 Agent Platform Pipelines,Vertex ML Metadata 改叫 Agent Platform ML Metadata,Vertex AI Experiments 改叫 Experiments on Agent Platform。同時期 Cloud Composer 改名 Managed Service for Apache Airflow,Dataproc Serverless 改名 Managed Service for Apache Spark。KFP 和 TFX 是開源專案,名稱沒變。
重點整理
- MLOps:DevOps 搬到 ML,多了 CT 持續訓練;三級:0 手動筆記本、1 管線自動化、2 管線本身也 CI/CD
- 管線:元件(獨立程式)+輸入=任務,串成 DAG,沒依賴的平行跑;成品被 ML Metadata 記血緣
- Agent Platform Pipelines(原 Vertex AI Pipelines):無伺服器跑 KFP 或 TFX 管線;定義 → 編譯 YAML → 執行(一次/排程/範本)→ 監控;任務可委派 BigQuery、Dataflow、Spark;GCPC 預建元件
- KFP:框架中立,Python 函數當元件;TFX:TensorFlow 全家桶,標準元件 ExampleGen → StatisticsGen → SchemaGen → ExampleValidator → Transform → Trainer → Evaluator → Pusher,函式庫 TFDV/TFT/TFMA/MLMD
- 怎麼選:ML 管線 → Agent Platform Pipelines;TensorFlow+資料驗證 → TFX;混合框架 → KFP;通用資料流程 → Managed Service for Apache Airflow(舊名 Cloud Composer);自管 → GKE 上的 Kubeflow;平行 Python → Ray
- 快取:輸入+輸出定義+元件規格一樣就跳過;只改評估步驟可省近九成;抓資料那步要關
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 第 3 篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切
- 第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
- 第 6 篇:ROC 曲線和 AUC 怎麼看?門檻怎麼調、AUC-PR 差在哪
- 第 7 篇:過度擬合是什麼?正則化、Dropout、提前停止 3 招解決
- 第 8 篇:資料洩漏是什麼?模型考試作弊的 3 種常見情況
- 第 9 篇:類別不平衡怎麼辦?過取樣、欠取樣與 Upweighting
- 第 10 篇:資料前處理怎麼做?標準化、遺失值、高基數類別
- 第 11 篇:特徵工程是什麼?特徵交叉、詞嵌入、資料增強一次看懂
- 第 12 篇:機器學習的資料隱私怎麼保護?DLP、聯邦學習、VPC Service Controls
- 第 13 篇:訓練資料讀太慢?TFRecords、tf.data 與 prefetch 加速
- 第 14 篇:Vertex AI AutoML、BigQuery ML、自訂訓練怎麼選?
- 第 15 篇:BigQuery ML 入門:只會 SQL 也能訓練模型
- 第 16 篇:Vertex AI 自訂訓練:容器、分散式訓練、GPU 與 TPU
- 上一篇:第 17 篇:模型部署怎麼選?線上預測 vs 批次預測、流量分割
- 下一篇:第 19 篇:機器學習的 CI/CD:程式改了、資料來了,模型自動重訓
站上相關文章
- Kubernetes 是什麼?白話解釋+判斷你是否真的需要它
- 容器技術是什麼?從零開始看懂 Docker 與容器化應用
- Dataflow 是什麼?跟 Apache Beam 有什麼關係?
- 雲端職缺大解析:雲端工程師、架構師、SRE、DevOps、資料工程師差在哪?
- End-to-end Training 是什麼
- GCP 學習路徑 Roadmap
把做模型的步驟寫成機器會自己照做的 SOP,模型才能一直是新的。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。