可解釋 AI 是算出每個特徵對預測貢獻多少:樹模型用 Sampled Shapley,神經網路用 Integrated Gradients。
模型說 M002 會流失、說這張封膜有問題,為什麼? 老闆問、客戶問、法規問,你答不出來,模型就只是一個黑盒子。可解釋 AI 就是打開黑盒子的工具:它不改模型,而是算出「這次預測,每個特徵各出了多少力」。
這篇有一個重要的現況:Google 的 Vertex Explainable AI 已在 2026 年 3 月 16 日淘汰,2027 年 3 月 16 日停用。概念和方法沒變(考試還是考),但工具要換成 SHAP、LIME 這類開源套件,或 BigQuery ML 內建的解釋函數。文末會整理。
一樣用有 2,000 間分店、50 萬名會員的連鎖飲料店當例子(教學假設):流失模型(表格)和封膜檢查模型(影像)。
為什麼你需要知道
- 法規和信任:金融、醫療、保險的模型,被拒絕的人有權知道原因。BigQuery 的可解釋 AI 文件說,特徵歸因可以用來「確認模型行為符合預期、找出偏見、改進模型和訓練資料」
- 除錯:Vertex Explainable AI 總覽說,特徵歸因能抓到「標準評估方法通常會漏掉的資料問題」。第 8 篇的資料洩漏,常常是看到某個特徵貢獻大到不合理才發現的
- 監控要用:第 20 篇的特徵歸因漂移、偏見監控,底層就是這篇的方法
- 證照必考:PMLE 考試指南 6.1「Agent Platform 上的模型可解釋性」;3.1「依可解釋性需求選建模技術」;6.1「監控偏見」。筆記裡的採樣 Shapley、整合梯度、XRAI 三個名詞全在這篇
先搞懂:可解釋 AI 是什麼
白話是什麼
可解釋 AI(Explainable AI,XAI):讓人看懂模型為什麼做出某個預測的方法。最主要的做法是特徵歸因(feature attribution):算出每個特徵對這次預測的貢獻值,有正有負,加起來等於預測值和基準值的差。
比喻
一碗牛肉麵好吃,到底是湯、麵、肉、還是辣油的功勞?特徵歸因就是「給每樣材料打分數」:湯 +4、肉 +3、麵 +1、辣油 −1,加起來是這碗麵比「平均水準」好吃多少。
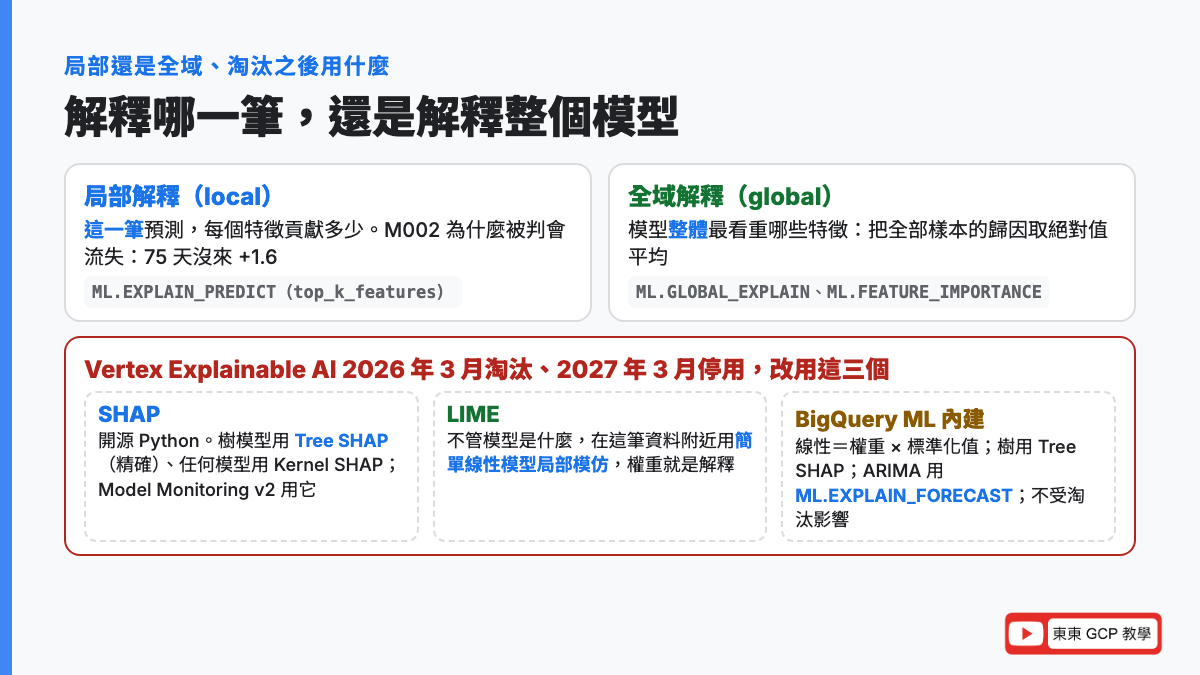
兩種解釋:局部和全域
BigQuery 的文件分得很清楚:
| 局部解釋(local) | 全域解釋(global) | |
|---|---|---|
| 白話 | 這一筆預測,每個特徵貢獻多少 | 模型整體最看重哪些特徵 |
| 怎麼算 | 對單一樣本算歸因 | 把全部樣本的歸因彙總(取絕對值平均) |
| 飲料店 | M002 為什麼被判會流失 | 流失模型整體最看「距上次消費天數」 |
| BigQuery ML | ML.EXPLAIN_PREDICT | ML.GLOBAL_EXPLAIN、ML.FEATURE_IMPORTANCE |
來龍去脈
模型越強越像黑盒子:線性迴歸(第 2 篇)的權重一看就懂,但 XGBoost 幾百棵樹、神經網路幾百萬個參數,沒人看得懂。2017 年前後,SHAP、Integrated Gradients 這些方法陸續出來,Google 把它們整合進 Vertex AI 叫 Vertex Explainable AI。現在 Google 把它淘汰,建議回頭用開源的 SHAP 和 LIME,BigQuery ML 則把解釋功能內建在 SQL 函數裡。
為什麼要學
考試 3.1 有一條「依可解釋性需求選建模技術」:題目說「法規要求能解釋每筆決定」,答案可能是選線性模型、樹模型這種本身就可解釋的,或是用特徵歸因。分不清就選錯。
1. Shapley 值:公平分功勞的數學
白話是什麼
Shapley 值(Shapley value):把每個特徵當成一個「玩家」,算它在所有可能的合作組合裡平均貢獻多少,當作它的功勞。Vertex Explainable AI 文件說,三種特徵歸因方法都是以 Shapley 值為基礎,它來自合作賽局理論(cooperative game theory),專門處理「一群人一起做出一個結果,功勞怎麼分」。
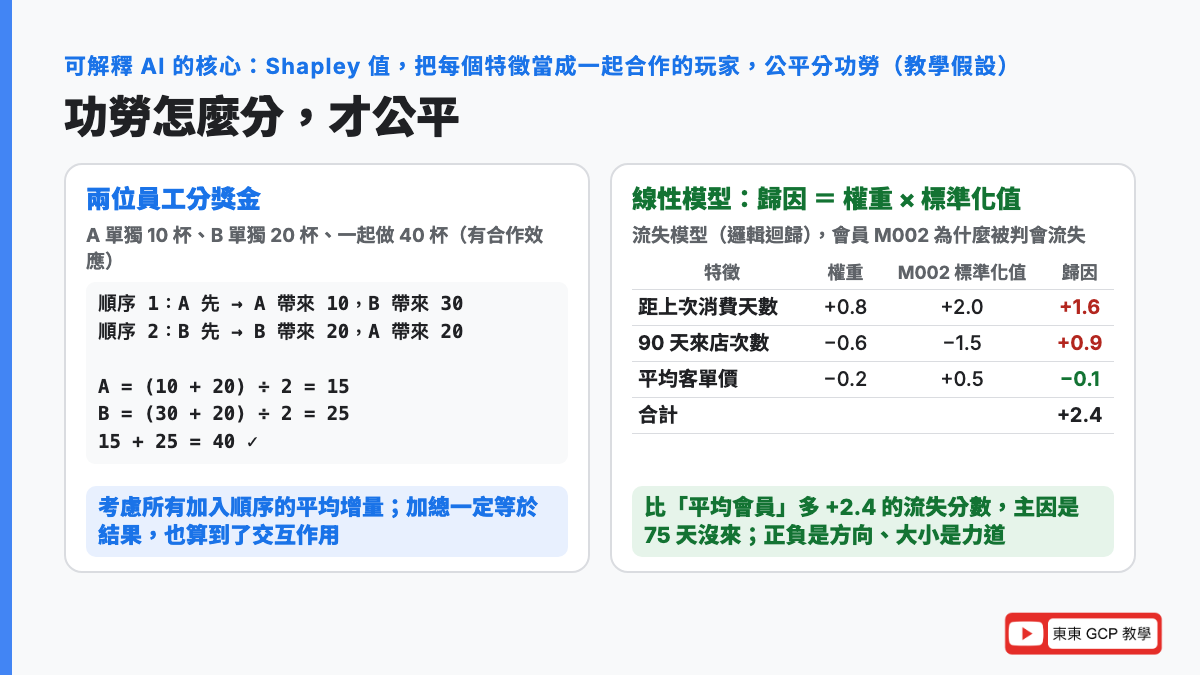
算一次給你看:兩個員工分獎金
飲料店兩位員工 A、B,單獨做一天業績 A 是 10 杯、B 是 20 杯,一起做是 40 杯(有合作效應)。獎金怎麼分才公平?
Shapley 的算法:考慮每種加入順序,看每個人「加入時多帶來多少」:
順序 1:A 先來,B 後來
  A 加入:0 → 10,帶來 10
  B 加入:10 → 40,帶來 30

順序 2:B 先來,A 後來
  B 加入:0 → 20,帶來 20
  A 加入:20 → 40,帶來 20

A 的 Shapley 值 = (10 + 20) ÷ 2 = 15
B 的 Shapley 值 = (30 + 20) ÷ 2 = 25
15 + 25 = 40 ✓(功勞加起來等於總業績)數字怎麼看:
- A 單獨只做 10,但分到 15,因為他跟 B 合作時貢獻更大。這就是 Shapley 值的優點:考慮了交互作用(第 11 篇的特徵交叉)
- 功勞一定加總等於結果,這是它被選為特徵歸因標準的原因
套到模型:每個「玩家」是一個特徵,「業績」是預測值減掉基準值。
線性模型的 Shapley 值:直接算
BigQuery 的文件給了一個簡單的公式:線性和邏輯迴歸的 Shapley 值=模型權重 × 標準化後的特徵值(權重是用標準化特徵訓練出來的)。
流失模型(邏輯迴歸,第 15 篇)的權重和會員 M002 的標準化特徵值(教學假設):
| 特徵 | 權重 | M002 標準化後的值 | 歸因=權重 × 值 |
|---|---|---|---|
| 距上次消費天數 | +0.8 | +2.0(比平均久很多) | +1.6 |
| 90 天來店次數 | −0.6 | −1.5(比平均少很多) | +0.9 |
| 平均客單價 | −0.2 | +0.5(略高) | −0.1 |
| 合計 | +2.4 |
標準化是第 10 篇講的:減平均、除以標準差,0 代表「平均的會員」。
怎麼讀:
- 基準是「平均的會員」,M002 比平均多了 +2.4 的流失分數(這是進 sigmoid 之前的分數,第 2 篇)
- +1.6 來自「太久沒來」,+0.9 來自「來得少」,客單價高一點點反而讓她稍微不像會流失(−0.1)
- 正負號是方向,絕對值是力道。給客服看就是:「M002 已經 75 天沒來,是主因」
特徵多了怎麼辦:Sampled Shapley
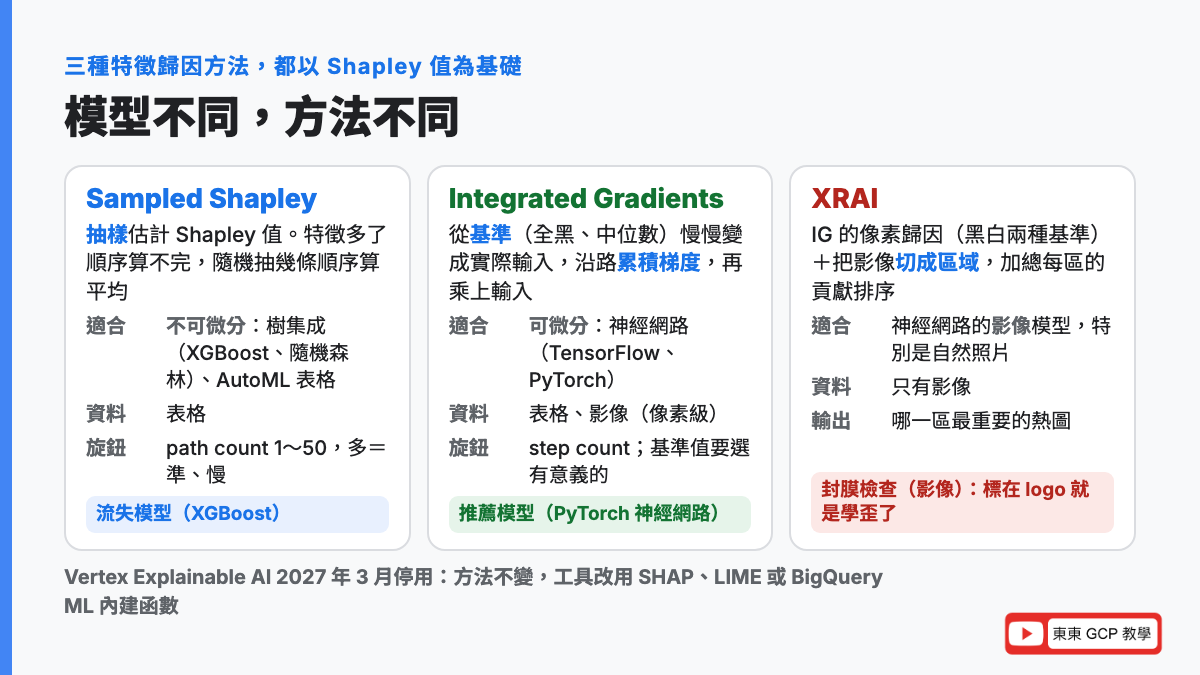
兩個玩家只有 2 種順序,10 個特徵有 10! = 3,628,800 種順序,20 個特徵算不完。Sampled Shapley(採樣 Shapley):隨機抽一些順序來算,用平均值估計真正的 Shapley 值。
官方設定裡的 path count(路徑數)就是「抽幾條順序」,範圍 1 到 50:越多近似誤差越小,但越慢越貴。
適合誰:官方說 Sampled Shapley 適合不可微分的模型,例如樹的集成(XGBoost、隨機森林)和 AutoML 表格模型(它是樹和神經網路的混合集成)。不可微分白話是「輸出對輸入沒有平滑的斜率」,樹模型是一堆 if-else,就是這種。
2. Integrated Gradients:沿著一條路累積斜率
白話是什麼
Integrated Gradients(整合梯度,IG):從一個基準輸入(例如全黑的圖、或全是中位數的表格)慢慢變成實際輸入,沿路每一步算「預測對每個特徵的斜率」(梯度),把斜率累積起來,就是每個特徵的貢獻。
比喻
把一張照片的亮度從全黑慢慢調到正常,看模型的「貓」分數在哪些像素變亮時跳最多,那些像素就是模型認貓的依據。官方文件的說法:想像一個滑桿,把所有像素往黑色縮放。
來龍去脈
官方描述的步驟:
- 在縮放參數的不同區間算梯度,區間大小用高斯求積法(一種數值積分技巧)決定
- 用加權平均近似積分
- 平均梯度逐元素乘上原始輸入
梯度是第 3 篇講過的「該往哪調、調多少」,神經網路訓練本來就在算它,所以 IG 對神經網路特別自然。
適合誰
可微分的模型:神經網路(TensorFlow、PyTorch)。表格和影像都能用。設定裡有 step count(步數),越多越準越慢,跟 Sampled Shapley 的路徑數是同樣的取捨。
基準值很重要
兩種方法都要一個基準(baseline):「沒有資訊」的輸入長什麼樣。官方說沒指定就用全零(影像是全黑)。但表格資料的全零常常不合理(客單價 0 元?),官方建議選有意義的基準,例如文件裡的腳踏車例子用「騎乘時間的中位數」。基準選錯,歸因的數字會跟著歪。
3. XRAI:影像看區域,不看像素
白話是什麼
XRAI:IG 算出來的是每個像素的貢獻,很碎、人看不懂。XRAI 把影像先切成一塊一塊的區域,把區域內像素的貢獻加總,排出「哪幾塊最重要」。
比喻
IG 像拿著放大鏡看每一顆沙子,XRAI 像退後一步看「這片沙灘的哪一區」。
官方的三步
- 像素級歸因:用 IG,而且用黑色和白色兩種基準各算一次
- 過度分割:用 Felzenszwalb 的圖論方法把影像切成很多小區塊(跟歸因無關,獨立做)
- 選區域:把每個區塊裡的像素歸因加總算密度,排序,從最正的排到最不正的
輸出是一張疊在原圖上的熱圖,標出模型「看哪裡」。封膜檢查模型判「有問題」,XRAI 會標出封膜邊緣那一圈。如果它標的是杯子上的 logo,就知道模型學歪了(第 8 篇的洩漏:也許有問題的那批照片都是某家分店拍的)。
適合誰
影像,而且官方說特別適合自然影像(照片)。表格資料不適用。
三種方法一張表
| Sampled Shapley | Integrated Gradients | XRAI | |
|---|---|---|---|
| 原理 | 抽樣估計 Shapley 值 | 從基準到輸入累積梯度 | IG+區域分割 |
| 適合的模型 | 不可微分:樹集成、AutoML 表格 | 可微分:神經網路 | 神經網路的影像模型 |
| 資料 | 表格 | 表格、影像 | 影像(自然照片) |
| 輸出 | 每個特徵一個分數 | 每個特徵或像素一個分數 | 每個區域的重要性熱圖 |
| 旋鈕 | path count(1~50) | step count | 同 IG |
| 飲料店 | 流失模型(XGBoost) | 推薦模型(PyTorch 神經網路) | 封膜檢查(影像) |
4. 範例式解釋:找最像的訓練樣本
Vertex Explainable AI 還有第二類:範例式解釋(example-based explanations)。做法是用最近鄰搜尋,從訓練集找出跟這筆輸入最像的幾個樣本。邏輯是「相似的輸入應該有相似的預測」。
官方列的四個用途:
- 改進資料或模型:鳥被判成飛機,找出最像的訓練樣本,發現全是飛機的黑色剪影 → 要多加鳥的剪影;如果最像的都是鳥卻還判錯 → 模型太簡單,要加層
- 解讀新類型的資料:訓練時只有鳥和飛機,上線遇到無人機,看它最像哪些已標記的樣本
- 找異常值:跟所有訓練資料都不像的,就是離群值。神經網路對錯誤常常很有信心,這招能抓出來
- 主動學習:最像的樣本一半是感冒一半是流感,代表這筆很難判,值得送給醫生標記
限制:只支援能輸出嵌入(embedding,第 11 篇)的 TensorFlow 模型,樹模型、PyTorch、XGBoost 不支援。
5. 淘汰之後怎麼辦:SHAP、LIME、BigQuery ML
Vertex Explainable AI 的時程
官方淘汰清單:2026 年 3 月 16 日起不再加新功能,2027 年 3 月 16 日完全停用、API 不再提供。替代方案官方點名:SHAP 和 LIME。
SHAP
SHAP(SHapley Additive exPlanations):開源 Python 套件,Shapley 值的工業級實作。對樹模型有 Tree SHAP(算精確的 Shapley 值,不用抽樣),對任何模型有 Kernel SHAP(抽樣近似),對神經網路也有對應的版本。第 20 篇 Model Monitoring v2 的特徵歸因用的就是 SHAP 值。
LIME
LIME(Local Interpretable Model-agnostic Explanations):開源套件,不管模型是什麼(model-agnostic),只要它能吐出機率就能解釋。做法是在這筆資料附近製造很多擾動過的樣本,用一個簡單的線性模型去「局部模仿」黑盒子,線性模型的權重就是解釋。支援文字、表格、影像。官方範例:把「Host」和「NNTP」兩個字拿掉,分類器判「無神論」的機率從 0.58 降到 0.31。
BigQuery ML:解釋內建在 SQL 裡
BigQuery ML 的解釋功能不受淘汰影響,文件列的方法:
| 模型 | 方法 | 局部 | 全域 |
|---|---|---|---|
| 線性/邏輯迴歸 | Shapley 值(權重 × 標準化值);另有標準誤和 p 值做顯著性檢定 | ML.EXPLAIN_PREDICT | ML.GLOBAL_EXPLAIN、ML.ADVANCED_WEIGHTS |
| 提升樹、隨機森林 | Tree SHAP(精確);或近似特徵貢獻(更快);Gini 重要性(訓練時每個特徵多有用) | ML.EXPLAIN_PREDICT | ML.GLOBAL_EXPLAIN、ML.FEATURE_IMPORTANCE |
| 時間序列 ARIMA_PLUS | 拆解趨勢、季節、假日 | ML.EXPLAIN_FORECAST |
第 15 篇示範過 ML.EXPLAIN_PREDICT 的 top_k_features,訓練時開 enable_global_explain = TRUE 才能用 ML.GLOBAL_EXPLAIN。
本身就可解釋的模型
考試 3.1「依可解釋性需求選建模技術」的另一個答案:直接選看得懂的模型。
| 模型 | 可解釋性 | 代價 |
|---|---|---|
| 線性/邏輯迴歸 | 權重直接讀 | 抓不到複雜關係 |
| 單棵決策樹 | 規則一路看下來 | 準確度通常較低 |
| 樹集成(XGBoost) | 要靠 SHAP | 準 |
| 神經網路 | 要靠 IG、SHAP | 最準、最黑 |
法規嚴、解釋比準確度重要 → 前兩種;要準又要解釋 → 後兩種加特徵歸因。
在 GCP 上怎麼做
現在(2026 年 10 月)的建議路線
- 表格模型在 BigQuery ML:訓練時
enable_global_explain = TRUE,用ML.EXPLAIN_PREDICT看單筆、ML.GLOBAL_EXPLAIN看整體,最省事 - 自訂訓練的模型:在訓練或推論程式裡裝
shap(樹模型用 TreeExplainer,神經網路用 DeepExplainer 或 GradientExplainer),把歸因跟預測一起存到 BigQuery,方便第 20 篇的監控和第 22 篇的追蹤 - 影像模型:SHAP 有影像的解釋器,或用開源的 XRAI 實作(Google 的 saliency 套件),輸出熱圖
- 還在用 Vertex Explainable AI 的:2027 年 3 月前遷移。Model Registry 裡模型的 explanation 設定(方法、path count、基準)要改成在程式裡做
- Model Monitoring v2 的特徵歸因目標用 SHAP,第 20 篇講過
基準值怎麼選
- 表格:用訓練資料的中位數或平均當基準,代表「一個典型的會員」
- 影像:黑圖是預設,XRAI 黑白各算一次
- 基準不同,歸因的絕對值會不同,比較歸因時要用同一個基準
改名對照
| 舊名稱(筆記、舊題庫) | 現在 |
|---|---|
| Vertex Explainable AI(採樣 Shapley、整合梯度、XRAI) | 2026 年 3 月淘汰、2027 年 3 月停用;方法概念不變,工具改 SHAP、LIME |
| AI Explanations(AI Platform 時代) | 更早的名字,已隨 AI Platform 關閉 |
| BQML.EXPLAIN_PREDICT(筆記寫法) | ML.EXPLAIN_PREDICT,不受淘汰影響 |
| Vertex AI Model Monitoring 的特徵歸因 | Model Monitoring v2,用 SHAP 值 |
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這篇的內容對應到:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 3 區:把原型放大成 ML 模型(約 21%) | 3.1 依可解釋性需求選建模技術 |
| 第 6 區:監控 AI 方案(約 13%) | 6.1 符合負責任 AI 實務(監控偏見);Agent Platform 上的模型可解釋性(例如 Agent Platform Inference) |
考試指南寫的還是「Agent Platform 上的模型可解釋性」,淘汰公告是 2026 年 3 月、指南是 6 月,題目可能還會出現舊功能的名字。方法名稱(Sampled Shapley、Integrated Gradients、XRAI)和適用情境是重點,不會變。
看到這些字,就想到這個
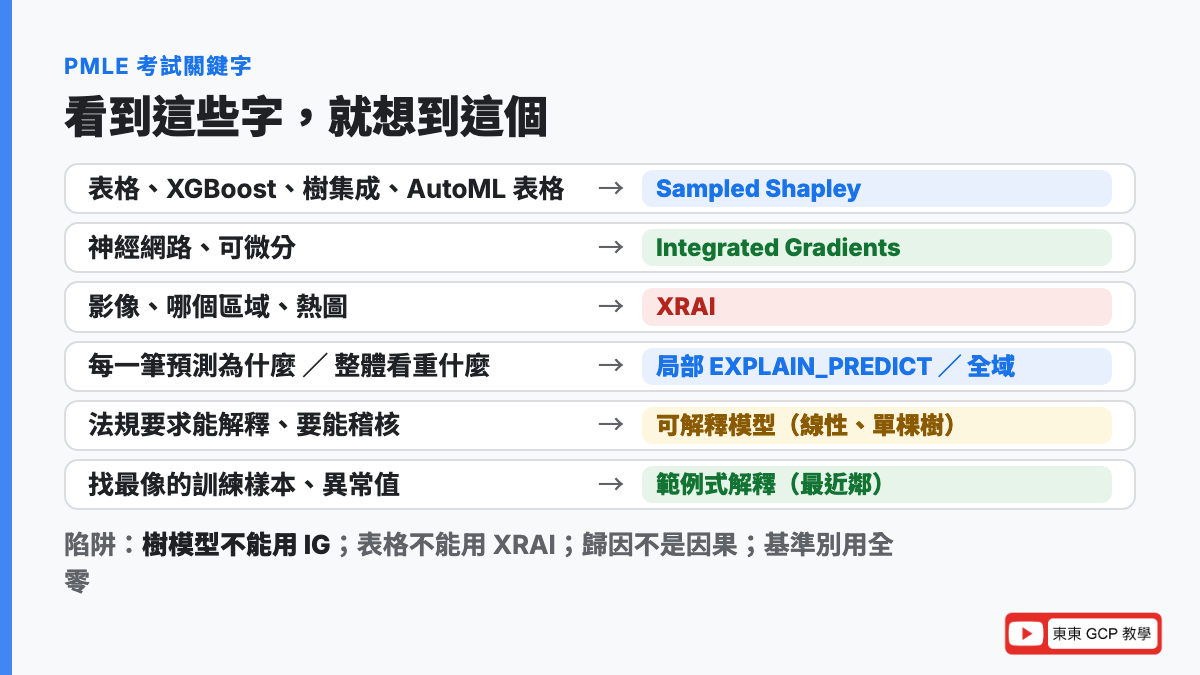
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「表格」「XGBoost」「樹集成」「AutoML 表格」「不可微分」 | Sampled Shapley |
| 「神經網路」「可微分」「TensorFlow 模型的特徵歸因」 | Integrated Gradients |
| 「影像」「哪個區域」「熱圖」「自然照片」 | XRAI |
| 「每一筆預測為什麼」「客戶問原因」 | 局部解釋,ML.EXPLAIN_PREDICT |
| 「模型整體最看重什麼」「哪些特徵可以拿掉」 | 全域解釋,ML.GLOBAL_EXPLAIN、ML.FEATURE_IMPORTANCE |
| 「法規要求能解釋」「解釋比準確重要」 | 選可解釋模型(線性、單棵樹),或加特徵歸因 |
| 「歸因太慢」「近似誤差」 | 調 path count/step count(少=快、多=準) |
| 「歸因數字怪怪的」「全零不合理」 | 基準值選錯,改用中位數 |
| 「找出最像的訓練樣本」「異常值」「哪些該人工標記」 | 範例式解釋(最近鄰) |
| 「某個特徵貢獻大到不合理」 | 可能是資料洩漏(第 8 篇) |
| 「敏感特徵(性別、年齡)貢獻很大」 | 偏見,6.1 |
| 「Vertex Explainable AI 要停用了」 | SHAP、LIME,BigQuery ML 內建函數 |
六個常見陷阱
- 樹模型選 Integrated Gradients:IG 要可微分,樹模型用 Sampled Shapley(或 Tree SHAP)
- 表格資料選 XRAI:XRAI 只給影像
- 用全零當表格的基準:客單價 0 元不是「典型會員」,歸因會歪
- 把歸因當因果:歸因是「模型怎麼想」,不是「世界怎麼運作」。模型看重「城市」可能是訓練資料的偏見
- 以為解釋功能都沒了:淘汰的是 Vertex Explainable AI 這個服務,方法還在,SHAP 和 BigQuery ML 都能做
- path count 設 50 跑正式推論:每筆預測都要抽 50 條路徑,延遲和費用暴增,線上用小一點、離線分析再開大
練習情境(自己出的練習,不是真實考題)
飲料店的流失模型是 XGBoost,客服部門要求每一筆「會流失」的判斷都要附三個主要原因。應該怎麼做?
判斷過程:
- 「XGBoost」「每一筆」→ 局部解釋,樹模型用 Sampled Shapley(或 SHAP 的 Tree SHAP)
- 在 BigQuery ML 的話,
ML.EXPLAIN_PREDICT加top_k_features = 3 - 自訂訓練的話,推論程式裡用
shap.TreeExplainer,把前三名存進結果表
封膜檢查模型(神經網路)把一批正常的杯子判成有問題。工程師想知道模型到底在看照片的哪裡。應該用什麼?
判斷過程:
- 「影像」「看哪裡」→ XRAI(區域熱圖);如果要到像素級細節用 Integrated Gradients
- 熱圖標在 logo 而不是封膜 → 訓練資料有洩漏,回頭查(第 8 篇)
- 也可以用範例式解釋找出最像的訓練照片,看是不是某家分店的拍法特殊
保險公司要用機器學習審核理賠,法規要求每個拒絕都能用人看得懂的規則解釋,而且模型要能被稽核。該怎麼選模型?
判斷過程:
- 「人看得懂的規則」「稽核」→ 3.1 的可解釋性需求,優先選本身可解釋的模型:邏輯迴歸(權重直接讀)或單棵決策樹(規則一路看)
- 準確度不夠才升級到樹集成+SHAP,但要能證明歸因方法
- 敏感特徵(年齡、性別)的歸因要監控(6.1 偏見)
常見問答
可解釋 AI 是什麼?
讓人看懂模型為什麼做出某個預測的方法,主要做法是特徵歸因:算出每個特徵對這次預測的貢獻值,有正有負,加起來等於預測值和基準值的差。分局部解釋(這一筆每個特徵貢獻多少)和全域解釋(模型整體最看重什麼)。用途是確認模型行為合理、找偏見、除錯、改進資料,也是法規要求的解釋依據。
Shapley 值是什麼?
來自合作賽局理論的分功勞方法:把每個特徵當玩家,算它在所有加入順序裡平均帶來多少增量,當作它的貢獻。好處是考慮交互作用,而且所有特徵的貢獻加總一定等於結果。兩位員工單獨做 10 和 20 杯、合作做 40 杯,Shapley 值是 15 和 25。線性模型的 Shapley 值等於權重乘標準化後的特徵值。
Sampled Shapley、Integrated Gradients、XRAI 怎麼選?
Sampled Shapley 抽樣估計 Shapley 值,適合不可微分的模型:樹集成(XGBoost、隨機森林)、AutoML 表格。Integrated Gradients 從基準到輸入累積梯度,適合可微分的神經網路,表格和影像都能用。XRAI 在 IG 之上做區域分割,只適合影像,輸出哪一區最重要的熱圖。三種都以 Shapley 值為基礎。
基準值(baseline)是什麼?為什麼重要?
「沒有資訊」的輸入長什麼樣,歸因算的是「從基準變成實際輸入,每個特徵帶來多少變化」。預設是全零(影像是全黑),但表格資料全零常不合理(客單價 0 元),官方建議選有意義的基準,例如中位數。基準不同歸因的絕對值不同,比較時要用同一個基準。
什麼是範例式解釋?
用最近鄰搜尋從訓練集找出跟這筆輸入最像的幾個樣本,邏輯是相似輸入應有相似預測。用途:找出模型判錯的原因(最像的樣本都是另一類代表資料不夠)、解讀訓練時沒見過的新類型資料、找異常值、挑出值得人工標記的困難樣本。只支援能輸出嵌入的 TensorFlow 模型。
Vertex Explainable AI 淘汰了,還能怎麼做解釋?
Vertex Explainable AI 2026 年 3 月 16 日淘汰、2027 年 3 月 16 日停用。官方建議改用開源的 SHAP(樹模型有精確的 Tree SHAP,任何模型有 Kernel SHAP)和 LIME(不管模型是什麼,在資料附近用線性模型局部模仿)。BigQuery ML 的 ML.EXPLAIN_PREDICT、ML.GLOBAL_EXPLAIN、ML.FEATURE_IMPORTANCE 不受影響。Model Monitoring v2 的特徵歸因也是用 SHAP。
BigQuery ML 怎麼做解釋?
線性和邏輯迴歸用 Shapley 值(權重乘標準化值),另有標準誤和 p 值;提升樹和隨機森林用 Tree SHAP(精確)或近似特徵貢獻(更快),還有 Gini 重要性;ARIMA_PLUS 用 ML.EXPLAIN_FORECAST 拆趨勢季節假日。局部用 ML.EXPLAIN_PREDICT,全域用 ML.GLOBAL_EXPLAIN(訓練時要開 enable_global_explain)和 ML.FEATURE_IMPORTANCE。
法規要求模型能解釋,該怎麼選模型?
考試指南 3.1 的「依可解釋性需求選建模技術」。解釋比準確度重要時,直接選本身可解釋的模型:邏輯迴歸的權重直接讀,單棵決策樹的規則一路看。要準又要解釋,用樹集成或神經網路加特徵歸因(SHAP、IG),但要能說明方法。敏感特徵的歸因要監控有沒有偏見。
特徵歸因可以當成因果關係嗎?
不行。歸因說的是「模型怎麼想」,不是「世界怎麼運作」。模型看重「城市」可能只是訓練資料裡某個城市的流失率剛好高。歸因大到不合理反而是警訊:可能是資料洩漏(答案混進特徵),或模型學到了偏見。
path count 和 step count 要設多少?
Sampled Shapley 的 path count 是抽幾條順序,1 到 50;Integrated Gradients 的 step count 是沿路算幾步。越多近似誤差越小但越慢越貴。線上推論每筆都要算,設小一點顧延遲;離線分析或除錯再開大。
重點整理
- 可解釋 AI=特徵歸因:每個特徵對這次預測的貢獻,加總等於預測值減基準值;局部(這一筆)vs 全域(整體)
- Shapley 值:合作賽局分功勞,考慮所有加入順序的平均增量,考慮交互作用、加總等於結果;線性模型=權重 × 標準化值
- 三種方法:Sampled Shapley(不可微分:樹集成、AutoML 表格)、Integrated Gradients(可微分:神經網路,表格與影像)、XRAI(影像區域熱圖);旋鈕 path count/step count;基準值要選有意義的
- 範例式解釋:最近鄰找最像的訓練樣本,除錯、新資料、異常值、主動學習;只支援 TensorFlow 嵌入
- Vertex Explainable AI 2027 年 3 月停用:改用 SHAP(Tree SHAP)、LIME;BigQuery ML 的
ML.EXPLAIN_PREDICT、ML.GLOBAL_EXPLAIN不受影響 - 選模型:法規要解釋 → 線性、單棵樹;要準 → 集成或神經網路+歸因。歸因不是因果
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 第 3 篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切
- 第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
- 第 6 篇:ROC 曲線和 AUC 怎麼看?門檻怎麼調、AUC-PR 差在哪
- 第 7 篇:過度擬合是什麼?正則化、Dropout、提前停止 3 招解決
- 第 8 篇:資料洩漏是什麼?模型考試作弊的 3 種常見情況
- 第 9 篇:類別不平衡怎麼辦?過取樣、欠取樣與 Upweighting
- 第 10 篇:資料前處理怎麼做?標準化、遺失值、高基數類別
- 第 11 篇:特徵工程是什麼?特徵交叉、詞嵌入、資料增強一次看懂
- 第 12 篇:機器學習的資料隱私怎麼保護?DLP、聯邦學習、VPC Service Controls
- 第 13 篇:訓練資料讀太慢?TFRecords、tf.data 與 prefetch 加速
- 第 14 篇:Vertex AI AutoML、BigQuery ML、自訂訓練怎麼選?
- 第 15 篇:BigQuery ML 入門:只會 SQL 也能訓練模型
- 第 16 篇:Vertex AI 自訂訓練:容器、分散式訓練、GPU 與 TPU
- 第 17 篇:模型部署怎麼選?線上預測 vs 批次預測、流量分割
- 第 18 篇:MLOps 是什麼?Vertex AI Pipelines、Kubeflow、TFX 介紹
- 第 19 篇:機器學習的 CI/CD:程式改了、資料來了,模型自動重訓
- 上一篇:第 20 篇:模型上線後會變笨?Drift 與 Training-Serving Skew 監控
- 下一篇:第 22 篇:實驗怎麼追蹤?Vertex AI Experiments、Metadata、TensorBoard
站上相關文章
- BigQuery 是資料庫嗎?跟資料庫差在哪
- Vertex AI 核心功能 Agent Builder、Model Builder 和 Model Garden 介紹
- End-to-end Training 是什麼
- GCP Organization Policy 完全攻略
- 不會寫程式,可以轉職雲端架構師嗎?
- GCP 學習路徑 Roadmap
模型說得出「為什麼」,才能被信任、被稽核、被改好。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。