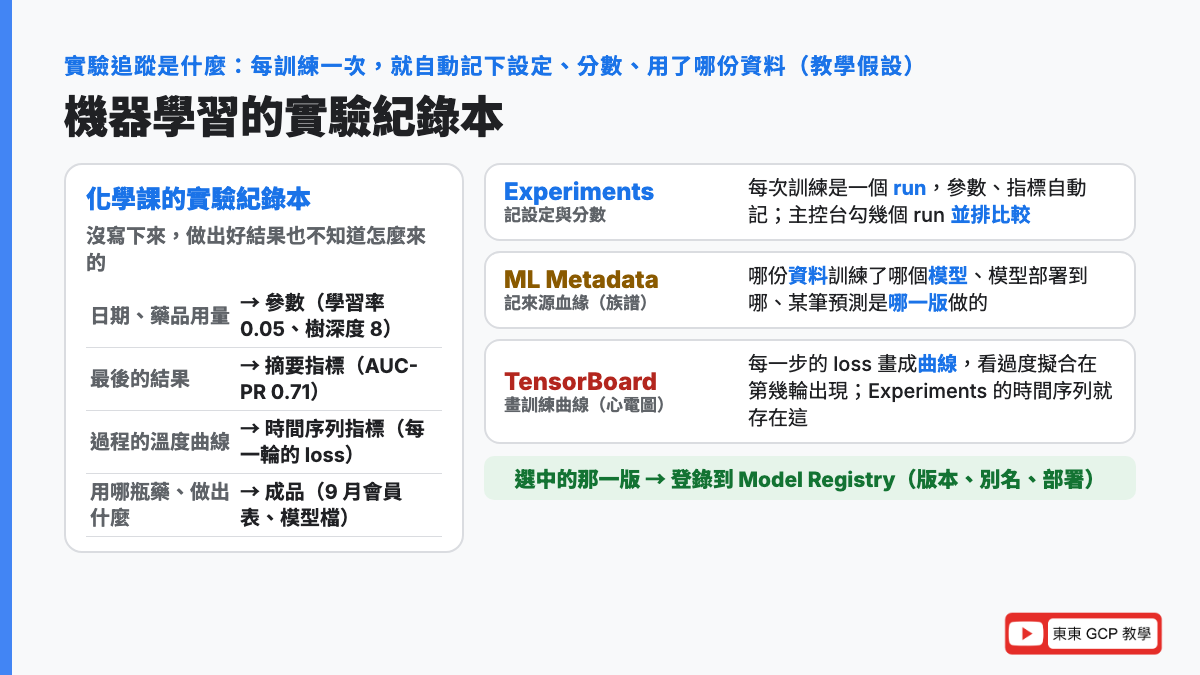
實驗怎麼追蹤?Experiments 記每次訓練的設定與分數、ML Metadata 記來源血緣、TensorBoard 畫訓練曲線。
做機器學習不是訓練一次就結束。同一個流失模型,你會換學習率、換樹的深度、加一個新特徵,一週下來跑了幾十次。三週後老闆問:「上線那個版本是用哪份資料、哪組設定訓練的?」答不出來,就得全部重做。實驗追蹤(experiment tracking)就是幫你把每一次嘗試記下來的那本筆記。
這篇講 Google Cloud 上做這件事的三個工具,和它們各管什麼:Experiments(記錄每次訓練的設定與分數)、ML Metadata(記錄資料、模型、步驟之間的來源關係)、TensorBoard(把訓練過程畫成圖)。還會講實驗在哪裡做(筆記本環境)、以及做完之後模型放哪裡(Model Registry)。
照系列慣例,先說名稱:這些工具原本都掛在 Vertex AI 底下,Vertex AI 在 2026 年 4 月起改名為 Gemini Enterprise Agent Platform(簡稱 Agent Platform),工具名也跟著改。標題用 Vertex AI 是因為大家還是這樣搜;文中第一次出現時會附新名稱,文末有對照表。
一樣用有 2,000 間分店、50 萬名會員的連鎖飲料店當例子(教學假設):資料團隊三個人,在調一個「會員會不會流失」的模型。
為什麼你需要知道
- 重現不了:三個人各自在筆記本裡跑,檔名叫
model_final_v3_真的最後.pkl。兩週後沒人記得 v3 的學習率是多少、用的是 9 月還是 10 月的資料。官方文件開頭就說:科學方法的關鍵是記下觀察和實驗的參數,資料科學也一樣 - 選錯模型:沒有並排比較,常常是「印象中那次比較好」。有追蹤才能把 24 次訓練排成一張表,照分數排序
- 稽核問不出來:金融、醫療會被問「這個預測是哪個模型版本做的?那個版本用什麼資料訓練?」這是 ML Metadata 的血緣(lineage)要回答的
- 證照必考:PMLE 考試指南 2.2「用筆記本做模型原型」、2.3「追蹤與執行 ML 實驗」直接點名 Experiments 和 ML Metadata;4.1 的 Model Registry 版本管理也在這篇
1. 先搞懂:實驗追蹤是什麼
白話是什麼
實驗(experiment)在機器學習裡指「換一組設定,訓練一次,看分數」。實驗追蹤就是每做一次,就把用了什麼設定、跑出什麼分數、用了哪份資料、產出哪個模型檔記下來,之後能查、能比、能重跑。
比喻
高中做化學實驗要寫實驗紀錄本:日期、藥品用量、溫度、觀察結果。沒寫的話,做出好結果也不知道怎麼做出來的。實驗追蹤就是機器學習的實驗紀錄本,差別是它由程式自動寫,不會漏。
來龍去脈
早期大家用 Excel 或檔名記:lr0.1_depth6_auc0.61.pkl。設定一多就亂掉,而且檔名記不了「用哪份資料」。開源社群陸續做出 MLflow、TensorBoard 這些工具;Google 把這套做法整合進 Vertex AI,分成 Experiments(記設定與分數)、ML Metadata(記關係)、TensorBoard(畫圖)三塊。它們底層是接在一起的:Experiments 的文件說,一個實驗就是 ML Metadata 裡的一個「情境」(context),時間序列指標則存在 TensorBoard。
為什麼要學
考試 2.3「追蹤與比較模型的成品、版本與血緣」整段都是這篇;實務上沒追蹤,模型上線出問題時,你連「要回滾到哪一版」都說不出來。
一次訓練要記四種東西
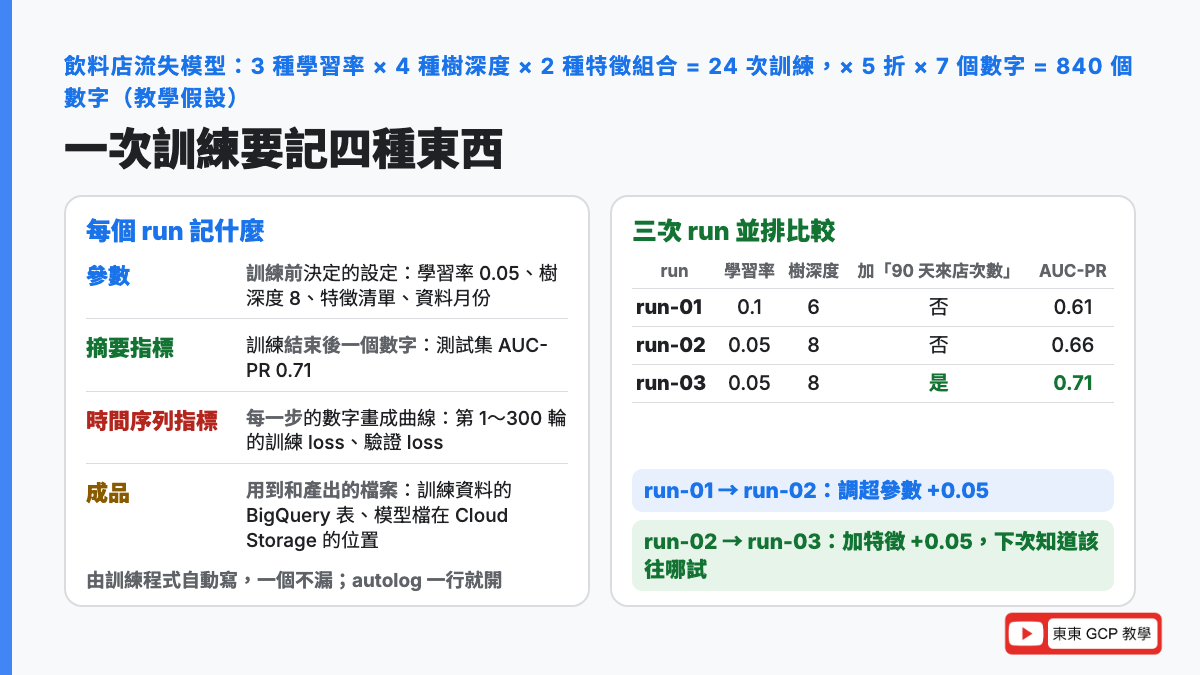
官方把一次執行(run)記的東西分成四類:
| 記什麼 | 白話 | 飲料店流失模型的例子 |
|---|---|---|
| 參數(parameters) | 這次訓練的設定,訓練前就決定好的 | 學習率 0.05、樹深度 8、用的特徵清單、資料日期 2026-09 |
| 摘要指標(summary metrics) | 訓練結束後一個數字的成績 | 測試集 AUC-PR 0.66、召回率 0.72 |
| 時間序列指標(time series metrics) | 訓練過程中每一步的數字,畫成曲線 | 第 1~300 輪的訓練 loss、驗證 loss |
| 成品(artifacts) | 訓練用到和產出的檔案 | 訓練資料的 BigQuery 表、模型檔在 Cloud Storage 的位置 |
參數和超參數是第 3 篇講的:模型自己學的叫參數(權重),人設定的叫超參數。Experiments 文件裡的「parameters」指的是後者,也就是你設定的東西。AUC-PR 是第 6 篇講的指標,流失是少數類,所以看 AUC-PR 不看 AUC-ROC。
算一次給你看:為什麼靠記憶一定記不住
團隊想試:3 種學習率(0.1、0.05、0.01)× 4 種樹深度(4、6、8、10)× 2 種特徵組合(有沒有加「90 天來店次數」)。
組合數 = 3 × 4 × 2 = 24 次訓練
每次做 5 折交叉驗證(第 4 篇):24 × 5 = 120 次模型訓練
每次要記 4 個參數 + 3 個指標 = 7 個數字
120 × 7 = 840 個數字
840 個數字,三個人分頭跑,靠 Excel 一定會漏、會打錯。這是追蹤工具存在的理由:它由訓練程式自動寫,一個不漏。數字變大的意義:組合數是相乘不是相加,多試一個維度就翻倍,所以第 16 篇的超參數調校會用 Vizier 這類演算法幫你挑,而不是全部跑過。
三次 run 並排比較
追蹤之後,比較就是一張表(教學假設):
| run | 學習率 | 樹深度 | 加「90 天來店次數」 | 測試集 AUC-PR | 訓練時間 |
|---|---|---|---|---|---|
| run-01 | 0.1 | 6 | 否 | 0.61 | 4 分 |
| run-02 | 0.05 | 8 | 否 | 0.66 | 9 分 |
| run-03 | 0.05 | 8 | 是 | 0.71 | 10 分 |
怎麼讀:run-02 比 run-01 多 0.05,是調超參數的功勞;run-03 又多 0.05,是加特徵的功勞(第 11 篇的特徵工程)。沒有這張表,你只知道「run-03 最好」,不知道好在哪,下次就不知道該往哪個方向試。
2. Experiments:記設定與分數
白話是什麼
Experiments on Gemini Enterprise Agent Platform(舊名 Vertex AI Experiments):Google 代管的實驗紀錄本。你在訓練程式裡呼叫幾行 SDK,它就把參數、指標、成品記到雲端,主控台上可以搜尋、排序、勾選幾個 run 並排比較。
SDK(software development kit)是「給程式用的工具包」,這裡指 Python 套件 google-cloud-aiplatform,你 import 進來就能呼叫。
比喻
Google 試算表版的實驗紀錄本:每個人的訓練程式都會自動在同一張表加一列,老闆打開就能看全隊的進度,不用收 Excel。
概念:實驗、run、pipeline run
官方文件的三個名詞:
| 名詞 | 白話 | 飲料店 |
|---|---|---|
| 實驗(experiment) | 一個資料夾,裝一組相關的 run | 「流失模型 2026-10」 |
| 實驗 run(experiment run) | 一次訓練的紀錄:參數、摘要指標、時間序列指標、成品 | run-01、run-02、run-03 |
| pipeline run | 第 18 篇的管線跑一次,也可以掛進實驗裡當一個 run,參數和指標從管線自動推出來 | 每週自動重訓那一次 |
所以手動在筆記本裡試的,和第 19 篇自動管線跑的,可以放在同一個實驗裡比。
自動記錄(autolog)
最省事的用法是 autolog:開一個開關,SDK 自動把參數和指標記下來,不用一個一個寫。官方說底層用的是 MLflow 的自動記錄,支援 Keras、scikit-learn、XGBoost、LightGBM、PyTorch Lightning、Spark、statsmodels、Fastai、Gluon。注意它只記參數和指標,成品要自己記。
from google.cloud import aiplatform

aiplatform.init(project="drink-shop", location="asia-east1",
                experiment="churn-2026-10",
                experiment_tensorboard="projects/.../tensorboards/123")
aiplatform.autolog()

aiplatform.start_run("run-03")
# ... 這裡放你平常的 XGBoost 訓練程式,參數和指標會自動被記下 ...
aiplatform.log_params({"features": "base+visits_90d", "data_month": "2026-09"})
aiplatform.log_metrics({"test_auc_pr": 0.71})
aiplatform.end_run()
start_run 到 end_run 之間發生的事都算這個 run 的。沒指定 run 名稱的話,SDK 會自動取名,格式是「框架名稱-時間戳記-亂碼」,例如 xgboost-2026-10-24-10-30-15-a1b2c。
比較
主控台的 Experiments 頁面勾幾個 run 按「比較」,會出時間序列的疊圖和參數、指標對照表。用程式的話,aiplatform.get_experiment_df() 把整個實驗抓成一張 pandas 表(DataFrame,白話是「程式裡的試算表」),自己排序畫圖都行。
費用
官方說明:實驗 run 本身不另外收費,只付你訓練用掉的運算資源,加上底下 ML Metadata 和 TensorBoard 的儲存費(下面會算)。
3. ML Metadata:記來源與血緣
白話是什麼
Agent Platform ML Metadata(舊名 Vertex ML Metadata):一個記「什麼東西從哪裡來、被用到哪裡去」的資料庫。Experiments 記的是「這次分數多少」,ML Metadata 記的是「這個模型是哪份資料、哪個步驟做出來的,後來又被部署到哪」。
中繼資料(metadata)白話是「關於資料的資料」:照片本身是資料,拍攝時間、地點、相機型號是中繼資料。
比喻
族譜。模型是一個人,族譜記它的爸媽(訓練資料、程式碼、超參數)、它的小孩(用它做出來的批次預測結果)。問「這個人的祖先裡有沒有 9 月那份有問題的資料?」,順著族譜往上查就知道。
來龍去脈
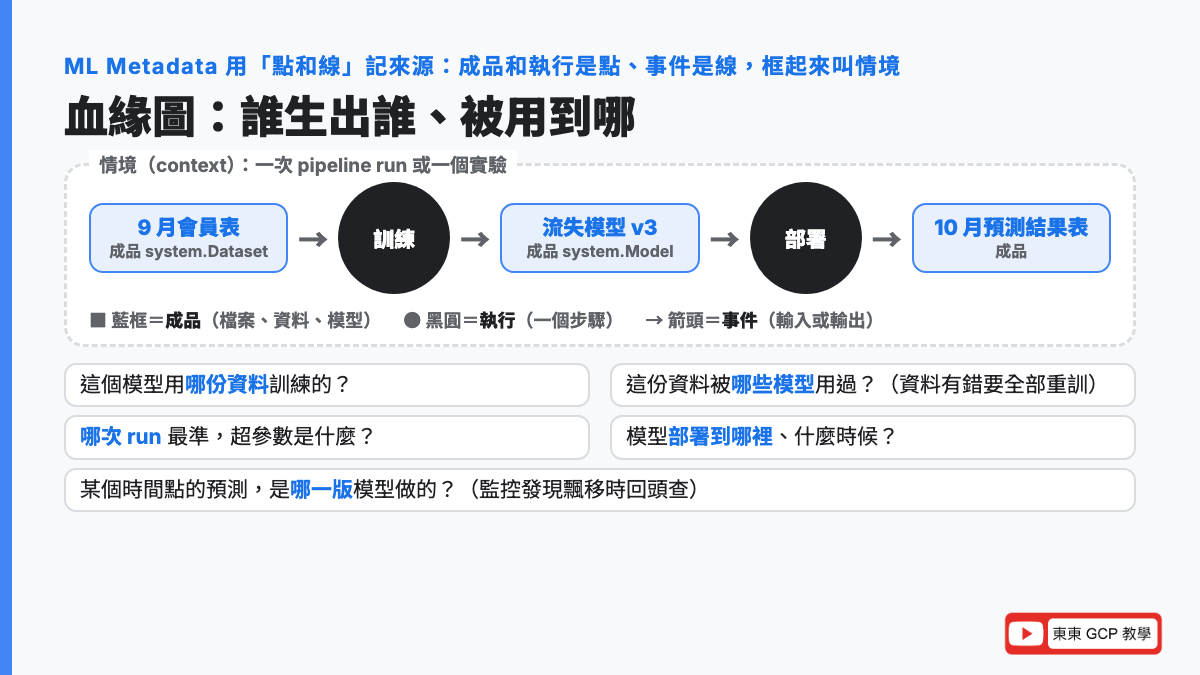
名字裡的 ML Metadata(MLMD) 是 TFX 團隊(第 18 篇)做的開源函式庫,Google 把它變成代管服務。它用圖(graph,白話是「點和線」)來存:
| 元素 | 是點還是線 | 白話 | 飲料店 |
|---|---|---|---|
| 成品(artifact) | 點 | 一個檔案或資料 | 9 月會員表、流失模型 v3、預測結果表 |
| 執行(execution) | 點 | 一個步驟 | 「前處理」「訓練」「評估」「部署」 |
| 事件(event) | 線 | 成品是某個執行的輸入或輸出 | 9 月會員表 → 訓練 → 模型 v3 |
| 情境(context) | 一個圈 | 把一群點和線框起來 | 一次 pipeline run、一個實驗 |
畫出來就是:資料(點)→ 訓練(點)→ 模型(點)→ 部署(點)→ 預測結果(點),箭頭是事件。這張圖就叫血緣圖(lineage graph)。
血緣能回答的問題
官方文件列的五個問題,每一個都是實際工作會被問的:
- 某個模型是用哪份資料集訓練的?
- 公司裡哪些模型用過某份資料集?(那份資料後來發現有錯,要全部重訓)
- 哪次 run 做出最準的模型,用了什麼超參數?
- 某個模型被部署到哪裡、什麼時候?
- 某個時間點的預測,是哪個版本的模型做的?
第 8 篇資料洩漏抓到了,問題 2 讓你一次找出所有受影響的模型;第 20 篇監控發現飄移,問題 5 讓你確認當時跑的是哪一版。
結構與費用
- 所有紀錄放在一個 MetadataStore(每個專案、每個區域一個,通常全公司共用一個)
- 成品有型別(schema),例如
system.Model(記框架、版本、格式)、system.Dataset;型別用 YAML 寫,也可以自訂 - 定價:每 GiB 每月 10 美元,按 MB 比例計費。中繼資料很小,官方舉例存 10 MB 一個月 0.1 美元
跟 Knowledge Catalog 的分工
Google 另有一個管全公司資料目錄的服務 Knowledge Catalog(之前叫 Dataplex Catalog、更早叫 Data Catalog),也能看血緣。Pipelines 血緣文件的比較:
| ML Metadata | Knowledge Catalog | |
|---|---|---|
| 記什麼 | 管線的所有輸入輸出成品 | 能對到正式資源名稱的成品(模型、資料集、BigQuery 表) |
| 範圍 | 單一區域、單一專案 | 跨區域、跨專案,全組織 |
| 接哪些服務 | Pipelines、Experiments、Model Registry、資料集 | Agent Platform、BigQuery、Managed Service for Apache Airflow、Managed Service for Apache Spark |
| 要不要開 | 永遠開著,不用設定 | 每個專案開 Data Lineage API |
白話:ML Metadata 是 ML 團隊自己的族譜;Knowledge Catalog 是全公司的戶政系統,連 BigQuery 表從哪張表算出來都記。
4. TensorBoard:把訓練過程畫成圖
白話是什麼
Vertex AI TensorBoard(現在文件寫 TensorBoard in Gemini platform):開源 TensorBoard 的代管版。TensorBoard 是 Google 開源的訓練視覺化工具,把訓練時每一步的 loss、準確率畫成曲線,還能看模型結構圖、權重分布、嵌入投影、影像和文字樣本。
比喻
心電圖。摘要指標是「最後血壓 120」,時間序列是「過程中每一秒的心跳」。心跳曲線才看得出中途有沒有異常:訓練 loss 一直降但驗證 loss 從第 150 輪開始往上,就是第 7 篇的過度擬合,要提前停止。
它能畫什麼
官方列的:
- 標量曲線:loss、準確率隨訓練步數變化(最常用)
- 計算圖:模型每一層怎麼接
- 直方圖:權重、偏差隨時間的分布,看有沒有爆掉或全變 0
- 嵌入投影:把第 11 篇的嵌入向量投影到 2D、3D 看聚不聚
- 樣本:影像、文字、音訊,看模型實際看到什麼
代管版多的東西:持久、可分享的連結(開源版要自己架伺服器,關掉就沒了)、跟 Experiments 整合(在主控台直接看時間序列)、企業級的權限控管。
跟 Experiments 的關係
Experiments 的時間序列指標就是存在 TensorBoard 裡,Experiments 只存一個指向它的參照。所以前面程式碼 aiplatform.init 要給 experiment_tensorboard,log_time_series_metrics() 記的每一步 loss 才有地方放。
費用:算一次給你看
定價頁寫得很清楚:2023 年 8 月起,TensorBoard 從每個使用者每月 300 美元的授權制,改成每 GiB 每月 10 美元的儲存制。舊題庫或舊文章還會看到 300 美元,現在不是。
飲料店那 24 次訓練(教學假設):
每次 run 的 TensorBoard 日誌約 50 MB
24 次 × 50 MB = 1,200 MB
1 GiB = 1,024 MB → 1,200 ÷ 1,024 ≈ 1.17 GiB
1.17 GiB × 10 美元 = 每月約 11.7 美元

ML Metadata:每次 run 約 200 KB
24 × 200 KB = 4,800 KB ≈ 4.7 MB → 每月約 0.05 美元數字怎麼看:中繼資料幾乎不花錢;花錢的是 TensorBoard 日誌,而且是每個月持續收。所以官方有一篇教你「刪除過期的 TensorBoard 實驗」。日誌量變大的原因通常是記太頻繁(每一步都記影像樣本)或實驗沒清,調低記錄頻率、定期清舊實驗就能壓下來。
5. 實驗在哪裡做:筆記本環境
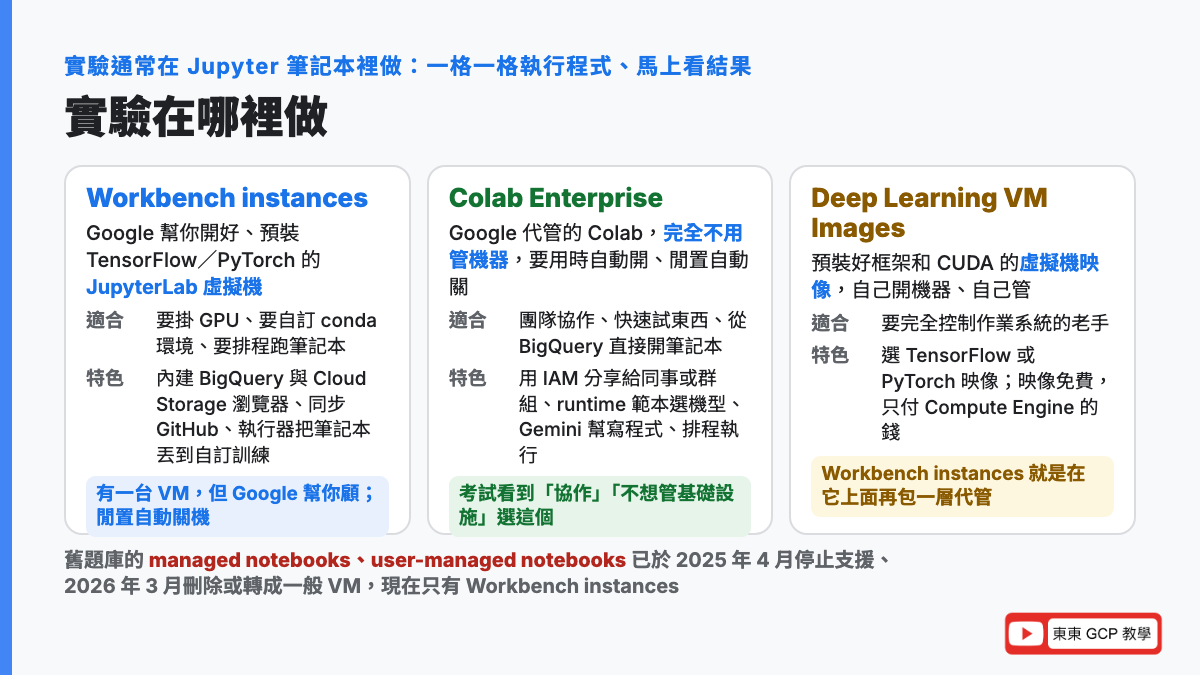
實驗通常在 Jupyter 筆記本(notebook)裡做:一種可以一格一格執行程式、馬上看結果的工具,資料科學家的標配。Google Cloud 上有三種地方:
| Workbench instances | Colab Enterprise | Deep Learning VM | |
|---|---|---|---|
| 白話 | Google 幫你開好的 JupyterLab 虛擬機 | Google 代管的 Colab,不用管機器 | 預裝好框架的虛擬機映像,自己開機器 |
| 管機器嗎 | 有一台 VM,但 Google 預裝、幫你顧 | 完全不用,要用時自動開、閒置自動關 | 全部自己管 |
| 適合 | 要掛 GPU、要裝自己的環境、要排程跑筆記本 | 團隊協作、快速試東西、從 BigQuery 直接開筆記本 | 要完全控制作業系統的老手 |
| 特色 | 內建 Cloud Storage 和 BigQuery 瀏覽器、GitHub 同步、執行器把筆記本丟到自訂訓練排程跑 | 用 IAM 分享給同事、runtime 範本、Gemini 幫寫程式、排程執行 | 選 TensorFlow 或 PyTorch 映像,映像本身免費,只付 VM 錢 |
| 閒置自動關機 | 有,預設開 | 有,預設開 | 要自己設 |
虛擬機(VM)白話是「雲端上租的一台電腦」;IAM 是 Google Cloud 的權限系統,決定誰能看、誰能改。
舊名稱注意
筆記裡寫的「Vertex AI Workbench」在淘汰清單有兩個舊版本已經停用:
- managed notebooks 和 user-managed notebooks:2025 年 4 月 14 日停止支援、不能再建;2026 年 3 月 30 日 managed 的全部刪除,user-managed 的轉成一般 Compute Engine VM
- 現在只有 Workbench instances 這一種
舊題庫看到「managed notebooks vs user-managed notebooks 怎麼選」,知道這是過去式就好。
協作與安全的最佳實務
考試 2.2 寫「設定筆記本環境時的協作與安全最佳實務」,從官方文件和Colab Enterprise 文件整理:
- 權限用 IAM,不要共用帳號;Colab Enterprise 可以分享給個人、Google 群組或整個網域
- 程式碼進 Git(Workbench 可以同步 GitHub),筆記本不是版本控制
- 不要把金鑰寫在筆記本裡:筆記本預設用你的身分或服務帳戶去呼叫其他服務
- 資料不出門:用第 12 篇的 VPC Service Controls 把筆記本放進服務邊界;要自己管金鑰就開 CMEK;資料在記憶體裡也要加密就開 Confidential Computing
- 省錢:閒置自動關機別關掉;正式訓練不要在筆記本裡跑,用執行器丟到自訂訓練(第 16 篇),筆記本只做試驗
6. 選好了放哪裡:Model Registry
實驗比完、選出 run-03,下一步是把它變成正式的模型版本。Model Registry on Gemini Enterprise Agent Platform(舊名 Vertex AI Model Registry)是官方說的「管理模型生命週期的中央倉庫」。
比喻
App Store 的版本列表:同一個 App 有 1.0、1.1、2.0,每版有說明、有上架狀態;使用者下載的永遠是標「最新」的那個。
它做什麼
- 一個模型底下有多個版本,每版有說明、標籤、評估指標
- 別名(alias):給版本貼標籤,例如
default(正式用)、candidate(候選)。第 17 篇的端點部署時指別名,換版本只要把別名移過去 - 從這裡直接部署到端點、跑批次推論、看評估
- BigQuery ML 訓練的模型可以直接登錄,不用匯出再匯入(第 15 篇)
- 可以用 Knowledge Catalog 跨專案搜尋模型
Model Registry 跟 ML Metadata 是接在一起的:登錄一個版本,血緣圖就多一個 system.Model 成品,從它往上能看到是哪個 run、哪份資料。
在 GCP 上怎麼做
完整流程(2026 年 10 月)
- 開環境:團隊協作、快速試驗用 Colab Enterprise;要 GPU 或自訂環境用 Workbench instances。開閒置自動關機
- 建實驗:
aiplatform.init(experiment="churn-2026-10", experiment_tensorboard=...),先建一個 TensorBoard 實例讓時間序列有地方放 - 記錄:
aiplatform.autolog()開自動記錄;成品用aiplatform.log_params補資料來源、特徵清單;每一步 loss 用log_time_series_metrics - 比較:主控台 Experiments 頁勾選 run 比較,或
get_experiment_df()拉成表排序 - 看血緣:主控台 Metadata 頁點任一成品看血緣圖;要跨專案就在 Knowledge Catalog 搜
- 登錄:選中的模型上傳到 Model Registry,別名設
candidate,第 17 篇的流量分割驗證過再改default - 自動化:第 18、19 篇的管線跑的每一次都掛進同一個實驗(pipeline run),手動和自動放在一起比
- 清理:定期刪舊的 TensorBoard 實驗,儲存費才不會每月累加
改名對照
| 舊名稱(筆記、舊題庫) | 現在 |
|---|---|
| Vertex AI Experiments | Experiments on Gemini Enterprise Agent Platform |
| Vertex ML Metadata | Agent Platform ML Metadata(定價頁寫 ML Metadata in Gemini platform) |
| Vertex AI TensorBoard | TensorBoard in Gemini platform;2023 年 8 月起改按儲存量計費(10 美元/GiB/月),不再是 300 美元/人/月 |
| Vertex AI Workbench(managed/user-managed notebooks) | Workbench instances;舊的兩種 2025 年 4 月停止支援、2026 年 3 月刪除或轉為一般 VM |
| Vertex AI Model Registry | Model Registry on Gemini Enterprise Agent Platform |
| Deep Learning VMs | Deep Learning VM Images,名稱沒變,掛在 Compute Engine 底下 |
| Data Catalog/Dataplex Catalog | Knowledge Catalog |
| Gen AI evaluation service(評估生成式模型) | Gemini Enterprise Agent Platform Evals |
考試會怎麼考
Google Cloud Professional Machine Learning Engineer(PMLE,專業機器學習工程師) 證照,2026 年 6 月 1 日起的官方考試指南裡,這篇對應到:
| 考試區塊 | 跟這篇有關的項目 |
|---|---|
| 第 2 區:跨團隊協作管理資料與模型(約 16%) | 2.2 用筆記本做模型原型(Workbench、Colab Enterprise):協作與安全最佳實務;2.3 追蹤與執行 ML 實驗:依框架選環境(Experiments、Pipelines、Kubeflow Pipelines)、評估預測式與生成式方案(含 LLM 當評審)、追蹤比較成品、版本與血緣(Experiments、ML Metadata) |
| 第 4 區:服務與擴展模型(約 20%) | 4.1 在 Model Registry 組織與版本化模型 |
| 第 5 區:自動化與協調 ML 管線(約 18%) | 5.1 管線的成品與血緣(跟第 18 篇重疊) |
2.3 有一條「評估生成式 AI 方案,例如 LLM 當評審(LLM-as-a-judge)」:讓一個大型語言模型幫你打另一個模型輸出的分數。這屬於生成式 AI 的評估,工具是 Agent Platform Evals,概念上也是「每次改提示詞就是一次實驗,分數要記下來比」。
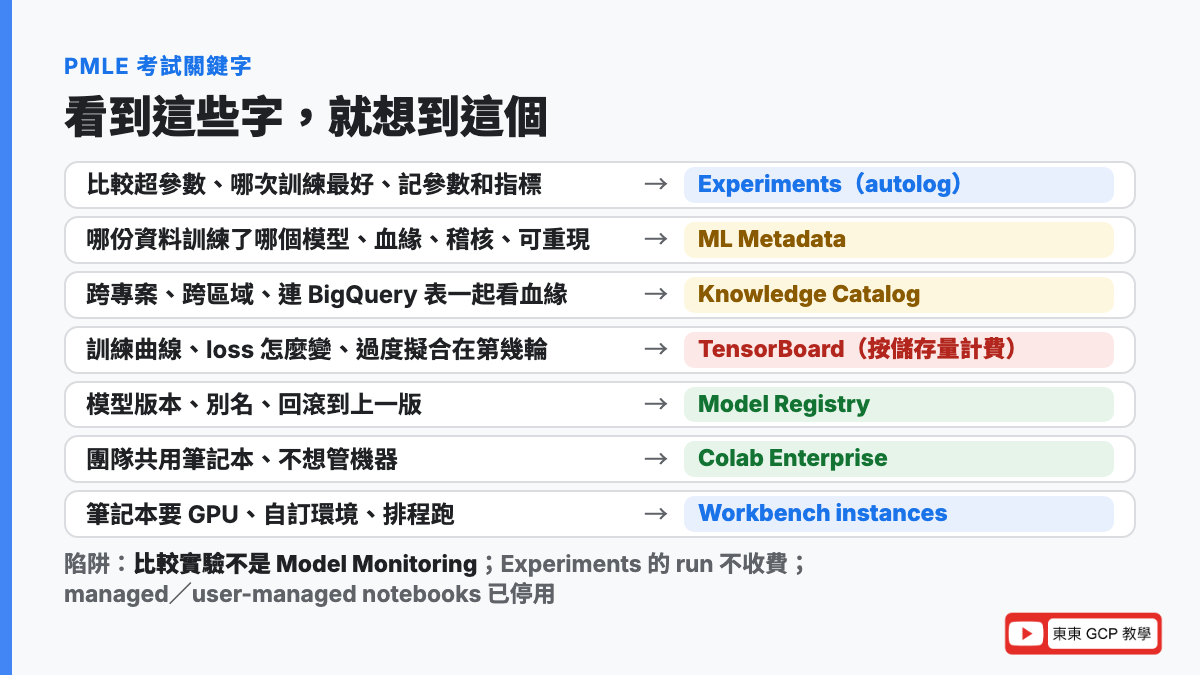
看到這些字,就想到這個
| 題目出現的關鍵字 | 想到 |
|---|---|
| 「比較不同超參數的結果」「哪次訓練最好」「追蹤參數和指標」 | Experiments |
| 「自動記錄」「不想改訓練程式」 | autolog |
| 「哪份資料訓練了這個模型」「這份資料被哪些模型用過」「血緣」「可重現」「稽核」 | ML Metadata |
| 「跨專案」「跨區域的血緣」「連 BigQuery 表一起看」 | Knowledge Catalog(Data Lineage API) |
| 「訓練曲線」「loss 隨步數變化」「視覺化」「過度擬合在第幾輪出現」 | TensorBoard |
| 「模型版本」「別名」「回滾到上一版」「BigQuery ML 模型要部署」 | Model Registry |
| 「團隊共用筆記本」「不想管基礎設施」「從 BigQuery 直接開筆記本」 | Colab Enterprise |
| 「筆記本要 GPU」「自訂 conda 環境」「排程跑筆記本」「同步 GitHub」 | Workbench instances |
| 「筆記本的安全」「資料不能外流」 | VPC Service Controls、CMEK、IAM 分權 |
| 「用 LLM 評分另一個模型的輸出」 | LLM-as-a-judge,Agent Platform Evals |
| 「TensorBoard 費用怎麼算」 | 按儲存量,10 美元/GiB/月 |
五個常見陷阱
- 用 Model Monitoring 來比較實驗:Monitoring 是第 20 篇上線後的監控,比較訓練結果是 Experiments
- 以為 Experiments 要另外付費:run 不收費,收的是 ML Metadata 和 TensorBoard 的儲存
- 選 managed notebooks 或 user-managed notebooks:這兩種已經停用,現在是 Workbench instances
- 血緣只想到 ML Metadata:題目說「跨專案、跨區域、包含 BigQuery 表」要選 Knowledge Catalog
- 把正式訓練跑在筆記本裡:筆記本是試驗用的,正式訓練用自訂訓練或管線,筆記本可以用執行器把工作丟出去
練習情境(自己出的練習,不是真實考題)
飲料店三位資料科學家各自在筆記本裡調流失模型,用 XGBoost 和 scikit-learn,老闆要一張表看出哪組設定最好,而且不想大家改太多程式。該用什麼?
判斷過程:
- 「哪組設定最好」「一張表」→ Experiments,比較 run
- 「不想改太多程式」「XGBoost、scikit-learn」→ autolog(支援這兩個框架),
aiplatform.autolog()一行 - 三個人記到同一個實驗名稱,主控台就是一張表
稽核單位要求:任一筆流失預測,都要能回答「是哪一版模型做的、那版用哪份資料訓練」。模型是用 Pipelines 每週重訓。要靠什麼?
判斷過程:
- 「哪一版」「哪份資料」→ 血緣,ML Metadata(Pipelines 的成品會自動記進去)
- 版本本身在 Model Registry,預測結果表是模型的下游成品
- 如果稽核要連 BigQuery 表的來源一起看、而且跨好幾個專案,加開 Knowledge Catalog
訓練一個神經網路,驗證分數很差。工程師想看訓練過程中 loss 怎麼變、權重有沒有異常。該用什麼?
判斷過程:
- 「訓練過程中」「loss 怎麼變」「權重分布」→ TensorBoard(標量曲線、直方圖)
- 訓練 loss 降、驗證 loss 升 → 第 7 篇過度擬合,加正則化或提前停止
- 權重直方圖全擠在 0 或爆到很大 → 學習率或初始化有問題
常見問答
實驗追蹤是什麼?為什麼需要?
每訓練一次模型,就把用的設定(參數)、跑出的分數(指標)、過程曲線、用到和產出的檔案(成品)自動記下來,之後能查、能並排比較、能重跑。沒有追蹤,幾十次訓練後就不知道哪組設定最好、上線的版本是用哪份資料做的,稽核問起來答不出來。Google Cloud 上分三個工具:Experiments 記設定與分數、ML Metadata 記血緣、TensorBoard 畫曲線。
Vertex AI Experiments 是什麼?
現在叫 Experiments on Gemini Enterprise Agent Platform,Google 代管的實驗紀錄本。一個實驗是一個資料夾,裡面每個 run 是一次訓練,記參數、摘要指標、時間序列指標和成品。用 Python SDK 的 aiplatform.init 指定實驗名稱,start_run 到 end_run 之間的紀錄都屬於那個 run;autolog 可以自動記常見框架的參數和指標。主控台能勾選多個 run 並排比較。run 本身不收費。
Vertex ML Metadata 是什麼?血緣是什麼?
ML Metadata 是記「什麼東西從哪來、被用到哪去」的資料庫,用圖來存:成品(資料、模型)和執行(訓練、部署)是點,事件是線,情境把一次 pipeline run 或一個實驗框起來。血緣就是一個成品的所有祖先和後代:模型的訓練資料、超參數、程式碼,以及它產出的預測結果。能回答哪份資料訓練了哪個模型、哪些模型用過某份資料、某筆預測是哪一版做的。每 GiB 每月 10 美元。
TensorBoard 是什麼?跟 Experiments 差在哪?
TensorBoard 是 Google 開源的訓練視覺化工具,畫 loss 和準確率隨訓練步數變化的曲線、模型結構圖、權重直方圖、嵌入投影、樣本。Vertex AI TensorBoard 是代管版,有持久可分享的連結和權限控管。Experiments 的時間序列指標就是存在 TensorBoard 裡,所以兩者是搭配用:Experiments 看「最後分數、哪組設定」,TensorBoard 看「過程中發生什麼」。
TensorBoard 怎麼收費?
2023 年 8 月起改成按儲存量計費,每 GiB 每月 10 美元,不再是過去每個使用者每月 300 美元的授權制。24 次訓練各留 50 MB 日誌大約 1.17 GiB,每月約 11.7 美元。費用每月持續收,要定期刪過期的 TensorBoard 實驗。
Workbench 和 Colab Enterprise 怎麼選?
Colab Enterprise 完全代管、不用管機器,用 IAM 分享給同事,可以從 BigQuery 直接開筆記本,適合協作和快速試驗。Workbench instances 是 Google 預裝好 JupyterLab 和深度學習套件的虛擬機,適合要掛 GPU、要自訂 conda 環境、要用執行器排程跑筆記本、要同步 GitHub 的情況。兩者都有閒置自動關機。舊的 managed notebooks 和 user-managed notebooks 已於 2025 年 4 月停止支援。
Model Registry 是什麼?
管理模型版本的中央倉庫。一個模型底下有多個版本,可以貼別名(例如 default、candidate),從這裡直接部署到端點、跑批次推論、看評估指標。BigQuery ML 訓練的模型可以直接登錄不用匯出。登錄的版本會出現在 ML Metadata 的血緣圖裡,往上能追到是哪個 run、哪份資料。
ML Metadata 和 Knowledge Catalog 的血緣差在哪?
ML Metadata 記管線的所有輸入輸出成品,但只限單一專案、單一區域,永遠開著不用設定,跟 Pipelines、Experiments、Model Registry 整合。Knowledge Catalog 是全公司的資料目錄,跨專案、跨區域,連 BigQuery、Managed Service for Apache Airflow、Managed Service for Apache Spark 的血緣都記,要每個專案開 Data Lineage API,只記能對到正式資源名稱的成品。
筆記本環境的安全最佳實務有哪些?
權限用 IAM 分給個人或群組,不共用帳號;程式碼同步到 Git,不把筆記本當版本控制;不在筆記本裡寫金鑰,用執行身分或服務帳戶;敏感資料用 VPC Service Controls 設服務邊界、需要自管金鑰就用 CMEK、要加密記憶體就開 Confidential Computing;閒置自動關機不要關;正式訓練丟到自訂訓練或管線跑,不在筆記本裡跑。
筆記寫的 Deep Learning VMs 還在嗎?
還在,現在叫 Deep Learning VM Images,是 Compute Engine 上預裝 TensorFlow、PyTorch、CUDA 的虛擬機映像,映像免費、只付 VM 錢。Workbench instances 就是在它上面再包一層代管。適合要完全控制作業系統的人;一般做實驗用 Workbench instances 或 Colab Enterprise 比較省事。
重點整理
- 實驗追蹤=每次訓練自動記四種東西:參數(設定)、摘要指標(最後分數)、時間序列指標(過程曲線)、成品(用到和產出的檔案);24 次訓練 × 5 折 × 7 個數字=840 個數字,靠記憶一定漏
- Experiments:實驗是資料夾、run 是一次訓練、pipeline run 也能掛進來;
autolog自動記常見框架;run 不收費 - ML Metadata:成品和執行是點、事件是線、情境是圈,畫成血緣圖;回答「哪份資料訓練了哪個模型」「某筆預測是哪一版做的」;10 美元/GiB/月;跨專案用 Knowledge Catalog
- TensorBoard:訓練曲線、直方圖、嵌入投影;Experiments 的時間序列就存在這;按儲存量計費(10 美元/GiB/月),不再是 300 美元/人/月
- 筆記本:Colab Enterprise(協作、不管機器)、Workbench instances(GPU、排程、自訂環境)、Deep Learning VM Images(自己管);managed/user-managed notebooks 已停用
- Model Registry:版本、別名、直接部署;BigQuery ML 模型可直接登錄;跟血緣圖相連
延伸閱讀
本系列
- 第 1 篇:機器學習有哪幾種?監督式、非監督式、強化學習一次看懂
- 第 2 篇:分類和迴歸差在哪?一個例子搞懂,附 MAE、RMSE 計算
- 第 3 篇:特徵、標籤、超參數是什麼?機器學習 5 個必懂名詞
- 第 4 篇:訓練集、驗證集、測試集怎麼切?時間序列為什麼不能亂切
- 第 5 篇:混淆矩陣是什麼?用快篩搞懂準確率、精確率、召回率、F1
- 第 6 篇:ROC 曲線和 AUC 怎麼看?門檻怎麼調、AUC-PR 差在哪
- 第 7 篇:過度擬合是什麼?正則化、Dropout、提前停止 3 招解決
- 第 8 篇:資料洩漏是什麼?模型考試作弊的 3 種常見情況
- 第 9 篇:類別不平衡怎麼辦?過取樣、欠取樣與 Upweighting
- 第 10 篇:資料前處理怎麼做?標準化、遺失值、高基數類別
- 第 11 篇:特徵工程是什麼?特徵交叉、詞嵌入、資料增強一次看懂
- 第 12 篇:機器學習的資料隱私怎麼保護?DLP、聯邦學習、VPC Service Controls
- 第 13 篇:訓練資料讀太慢?TFRecords、tf.data 與 prefetch 加速
- 第 14 篇:Vertex AI AutoML、BigQuery ML、自訂訓練怎麼選?
- 第 15 篇:BigQuery ML 入門:只會 SQL 也能訓練模型
- 第 16 篇:Vertex AI 自訂訓練:容器、分散式訓練、GPU 與 TPU
- 第 17 篇:模型部署怎麼選?線上預測 vs 批次預測、流量分割
- 第 18 篇:MLOps 是什麼?Vertex AI Pipelines、Kubeflow、TFX 介紹
- 第 19 篇:機器學習的 CI/CD:程式改了、資料來了,模型自動重訓
- 第 20 篇:模型上線後會變笨?Drift 與 Training-Serving Skew 監控
- 上一篇:第 21 篇:可解釋 AI 是什麼?Shapley、Integrated Gradients、XRAI
- 下一篇:第 23 篇:ML 用哪個資料服務?BigQuery、Cloud Storage、Feature Store、Bigtable 怎麼選
站上相關文章
- Vertex AI 核心功能 Agent Builder、Model Builder 和 Model Garden 介紹
- 如何在 GCP 建立含 GPU 的 AI 開發環境
- BigQuery 是資料庫嗎?跟資料庫差在哪
- End-to-end Training 是什麼
- GCP 帳單爆炸防護指南
- GCP 學習路徑 Roadmap
實驗有記下來,模型才不只是「印象中那次比較好」,而是說得出為什麼好、用什麼做的。如果你想有系統地從雲端基礎一路學到在 GCP 上動手做機器學習,可以看看東東的 GCP 課程,或加 LINE 聊聊你現在的狀況,一起找出最適合你的學習順序。